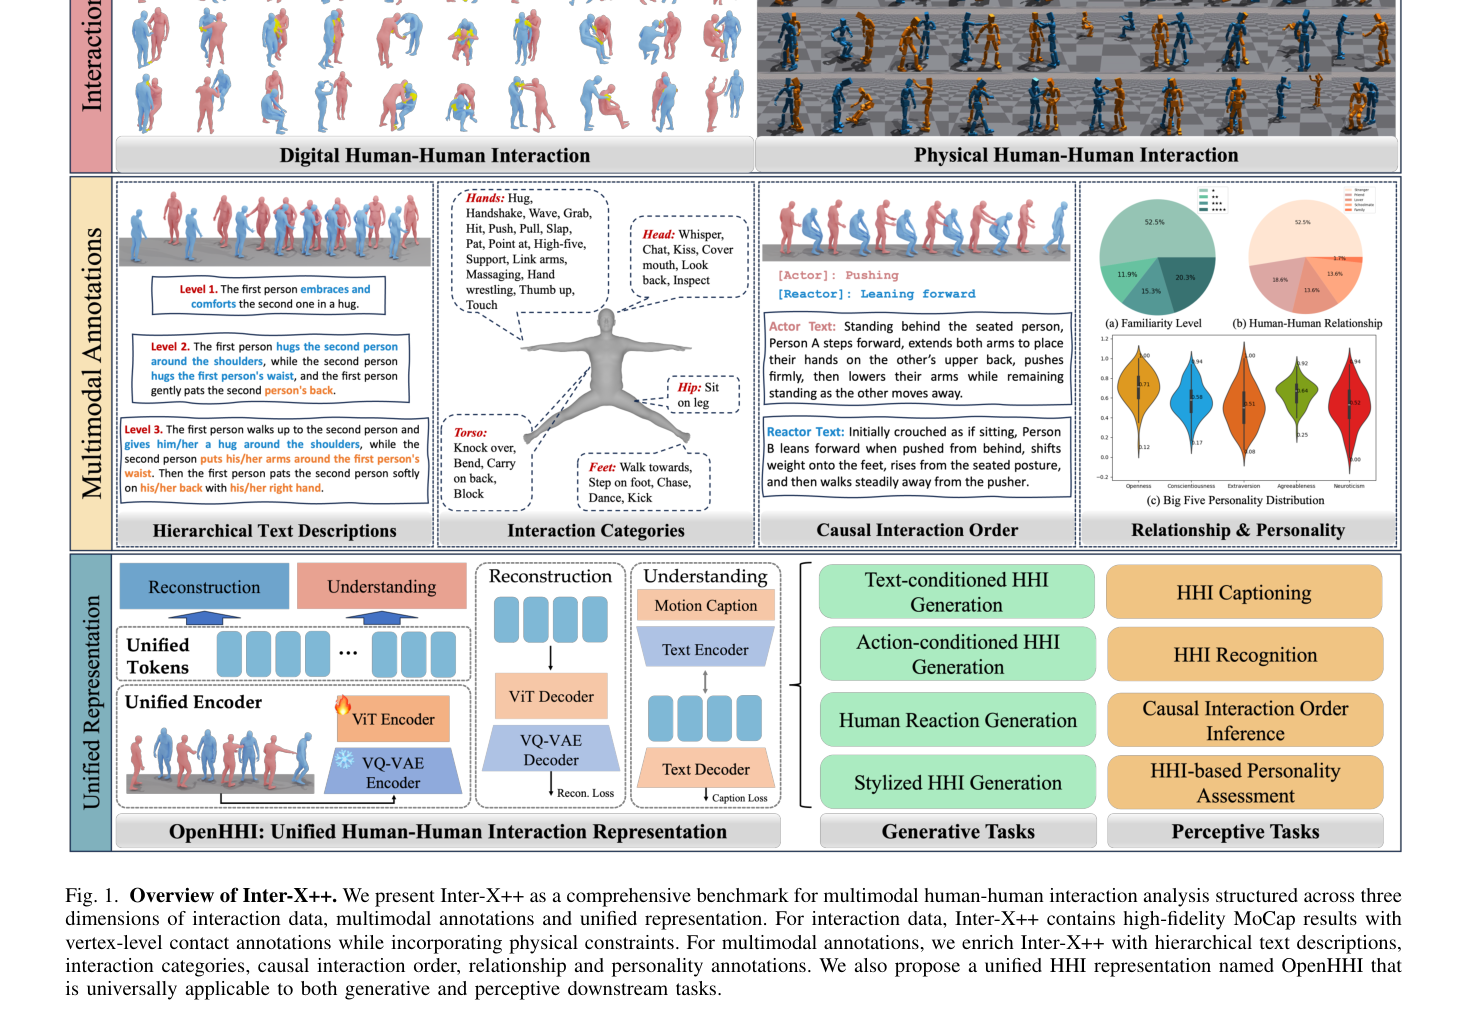
快速导读:Inter-X++ 构建了一个包含 11,388 条高保真交互序列、多模态标注和统一 OpenHHI 表示的大规模人人交互基准,系统性地解决了数据、标注、表示和评测协议碎片化的问题。
Inter-X++ 是一个面向多模态人人交互分析的综合基准,核心贡献在于同时解决数据保真度、标注丰富度和表示统一性三个层面的碎片化问题。论文构建了包含 11,388 条高保真交互序列的数据集,并提出 OpenHHI 统一表示,使生成与感知任务能在同一坐标系下公平评测。
本文的论证主线是:人人交互领域长期缺乏统一基准,不是因为模型不够强,而是因为数据、标注、表示和评测协议各自为政。Inter-X++ 通过混合采集系统、层次化标注和统一表示,系统性地填补了这一空白,并通过八个下游任务的标准化评测验证了统一框架的有效性。
英文题目:Inter-X++: A Comprehensive Benchmark for Multimodal Human-Human Interaction Analysis
论文出处:arXiv 每日论文精选 · arXiv:2608.20312
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有人人交互数据集多基于多视角 RGB 估计,存在遮挡、穿透和手部细节缺失等问题。以 InterHuman 为例,虽然提供了 6,022 条序列和文本标注,但缺少手部细节和物理约束,难以支撑精细的交互建模。
交互表示的碎片化是另一个核心问题。不同方法采用 axis-angle、quaternion、rotation matrix、6D rotation 或 non-canonical 等不同参数化方式,导致同一模型在不同表示下性能差异巨大,跨论文比较几乎不可能。
评测协议的不一致进一步加剧了问题。各方法采用不同的数据集划分、评测指标和采样次数,使得文献中的数字缺乏可比性。Inter-X++ 的出发点正是:在解决数据和标注问题的同时,必须统一表示和评测协议,否则任何单点改进都会被系统性噪声淹没。
核心创新
- 构建了包含 11,388 条序列、8.1M 帧、89 名受试者的大规模高保真人人交互数据集,具备顶点级接触标注和物理约束
- 提供层次化文本描述(102,492 条)、交互类别、因果交互顺序、人际关系与人格等多模态标注
- 提出 OpenHHI 统一 HHI 表示,通过 VQ-VAE 量化 + ViT 编码 + 重建与字幕双分支联合优化,同时服务生成与感知任务
- 系统分析并统一了五种交互表示(axis-angle、quaternion、rotation matrix、6D rotation、non-canonical),确立 6D rotation 为标准表示
- 定义了四类共八个下游任务(文本/动作/反应/风格化生成 + 字幕/识别/因果推断/人格评估),并标准化评测协议
方法概览
采用光学 MoCap 与惯性手套混合采集系统获取全身高保真运动;通过 SMPL-X 拟合、PHC 物理仿真修正得到物理合理序列;构建 VQ-VAE + ViT 编码器 + 重建/字幕双分支联合优化的 OpenHHI 统一表示,支持生成与感知任务。
- 混合采集系统:采用光学 MoCap 与惯性手套(IMU-based gloves)混合采集,通过刚性三角支架实现空间对齐,并在统一系统中完成时间同步,从而获得全身高保真运动数据。
- 物理合理性修正:通过 SMPL-X 拟合获得参数化人体模型,再使用 PHC 物理仿真策略进行修正。论文在单智能体环境中微调 PHC,得到 PHC*,在 Inter-X++ 上 Succ 达 81.30%,优于 PHC-Base 的 76.79%(第 10 页)。
- 顶点级接触标注:采用距离阈值方法(0.05 m)标注接触,为近距离交互提供精确的接触信息。
- 层次化文本标注:提供三级文本描述,Level-1 为简洁动作摘要,Level-2 描述整体交互,Level-3 指定参与者特定动作、身体部位和空间关系,共 102,492 条。
- 多模态标注扩展:除文本外,还提供交互类别、因果交互顺序、人际关系和基于 Big-Five 的人格标注。
- OpenHHI 统一表示:采用 VQ-VAE 量化加 ViT 编码器,以重建和字幕双分支联合优化,使同一表示同时服务生成与感知任务。
- 表示标准化:系统对比五种旋转表示,在统一协议下训练同一文本条件生成模型,确立 6D rotation 为标准表示,其 Top-1 R-Precision 达 0.389,优于 axis-angle 的 0.302 和 rotation matrix 的 0.105(第 10 页)。
- 任务分类体系:定义四类共八个下游任务,包括文本/动作/反应/风格化生成,以及字幕生成、识别、因果推断和人格评估,并标准化评测协议。
逐图理解论文
失败案例与直觉
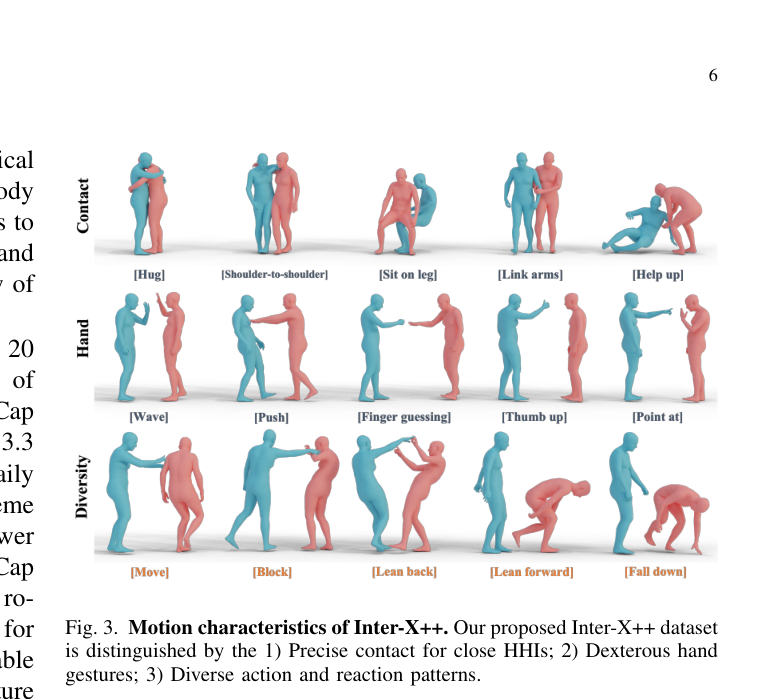
该图展示了 Inter-X++ 的三大运动特征:精确接触、灵巧手部手势和多样化动作-反应模式。对比此图与现有数据集的视觉差异,可以直观理解数据保真度的提升。
研究缺口
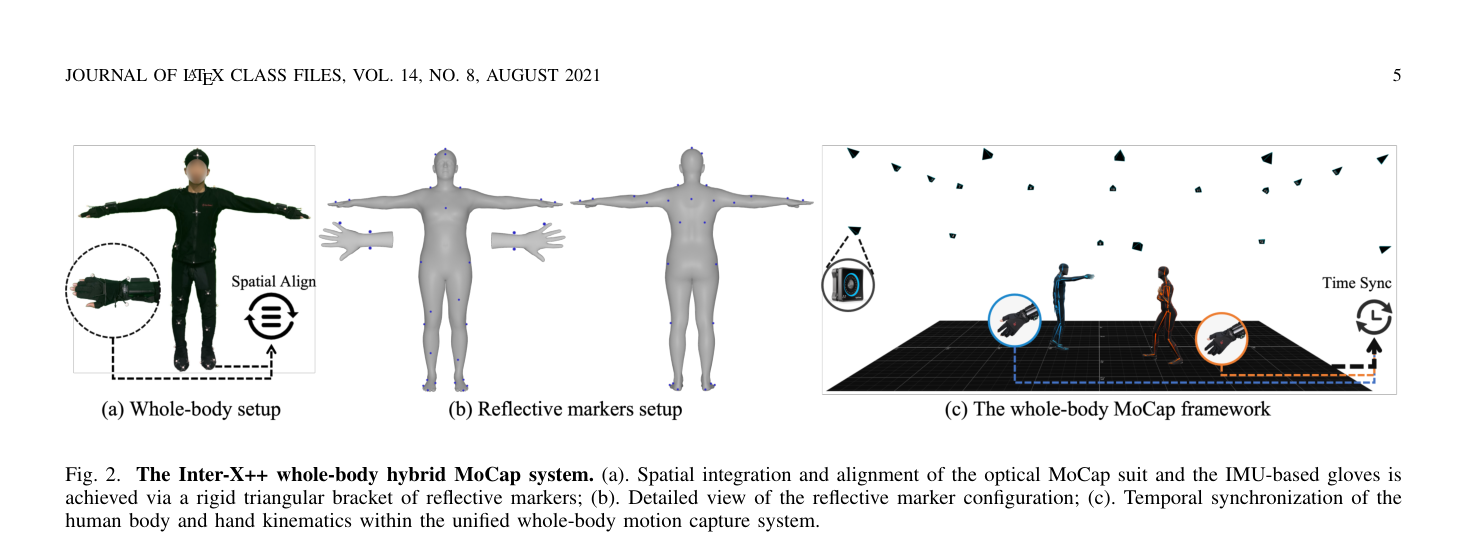
该图展示了混合 MoCap 系统的空间对齐和时间同步机制。注意刚性三角支架的设计,它解决了光学 MoCap 与惯性手套之间的空间配准问题。
最强结论
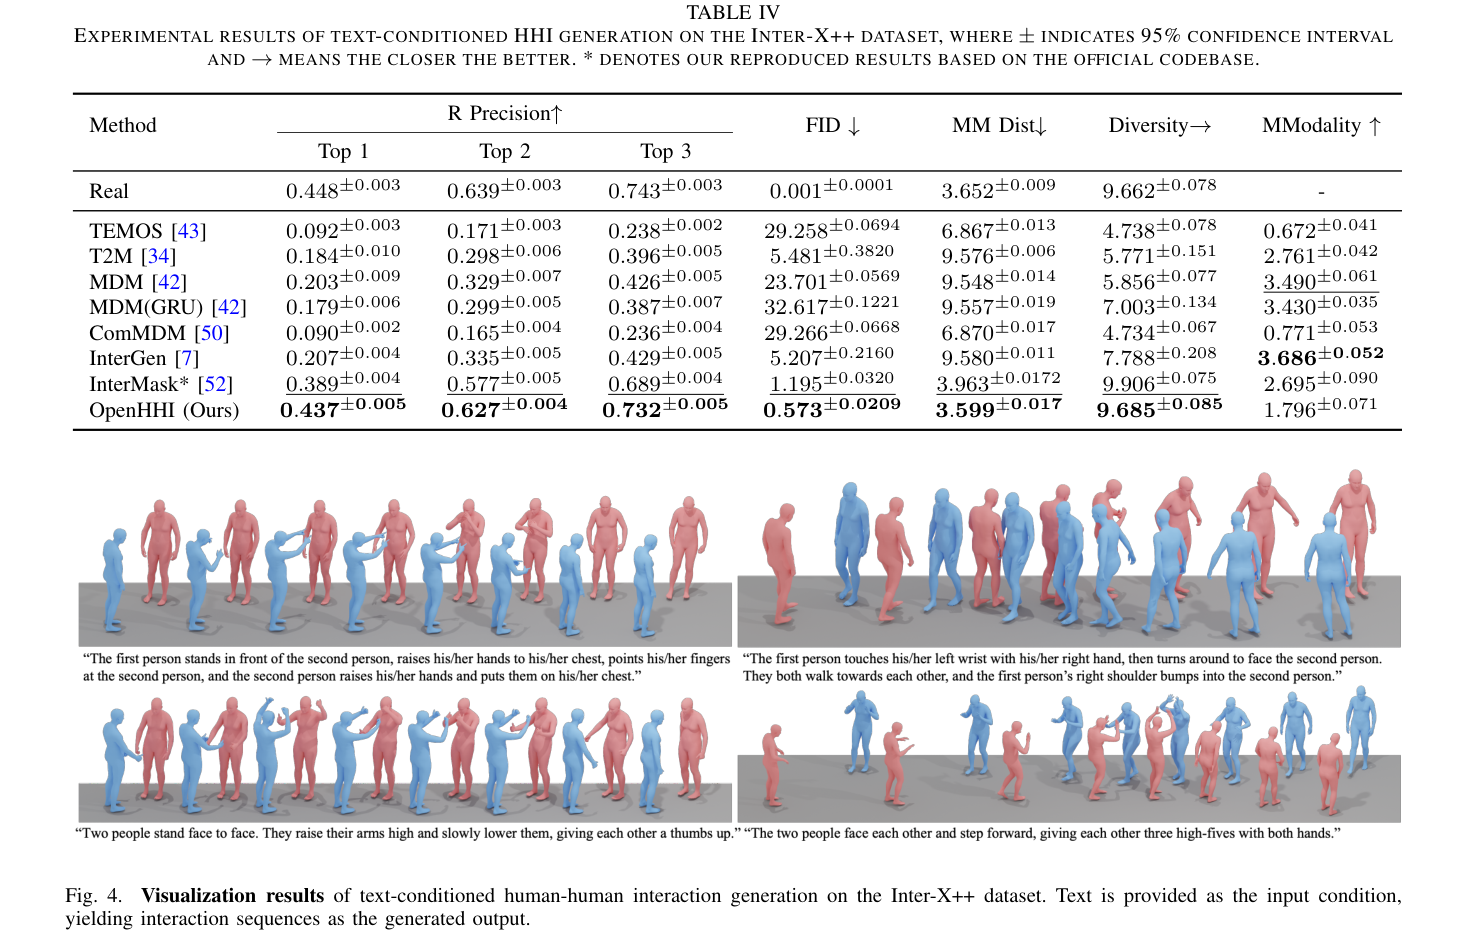
该图展示了文本条件 HHI 生成的可视化结果。观察生成序列与输入文本的对齐程度,可以评估 OpenHHI 在文本条件生成上的表现。
意义与局限
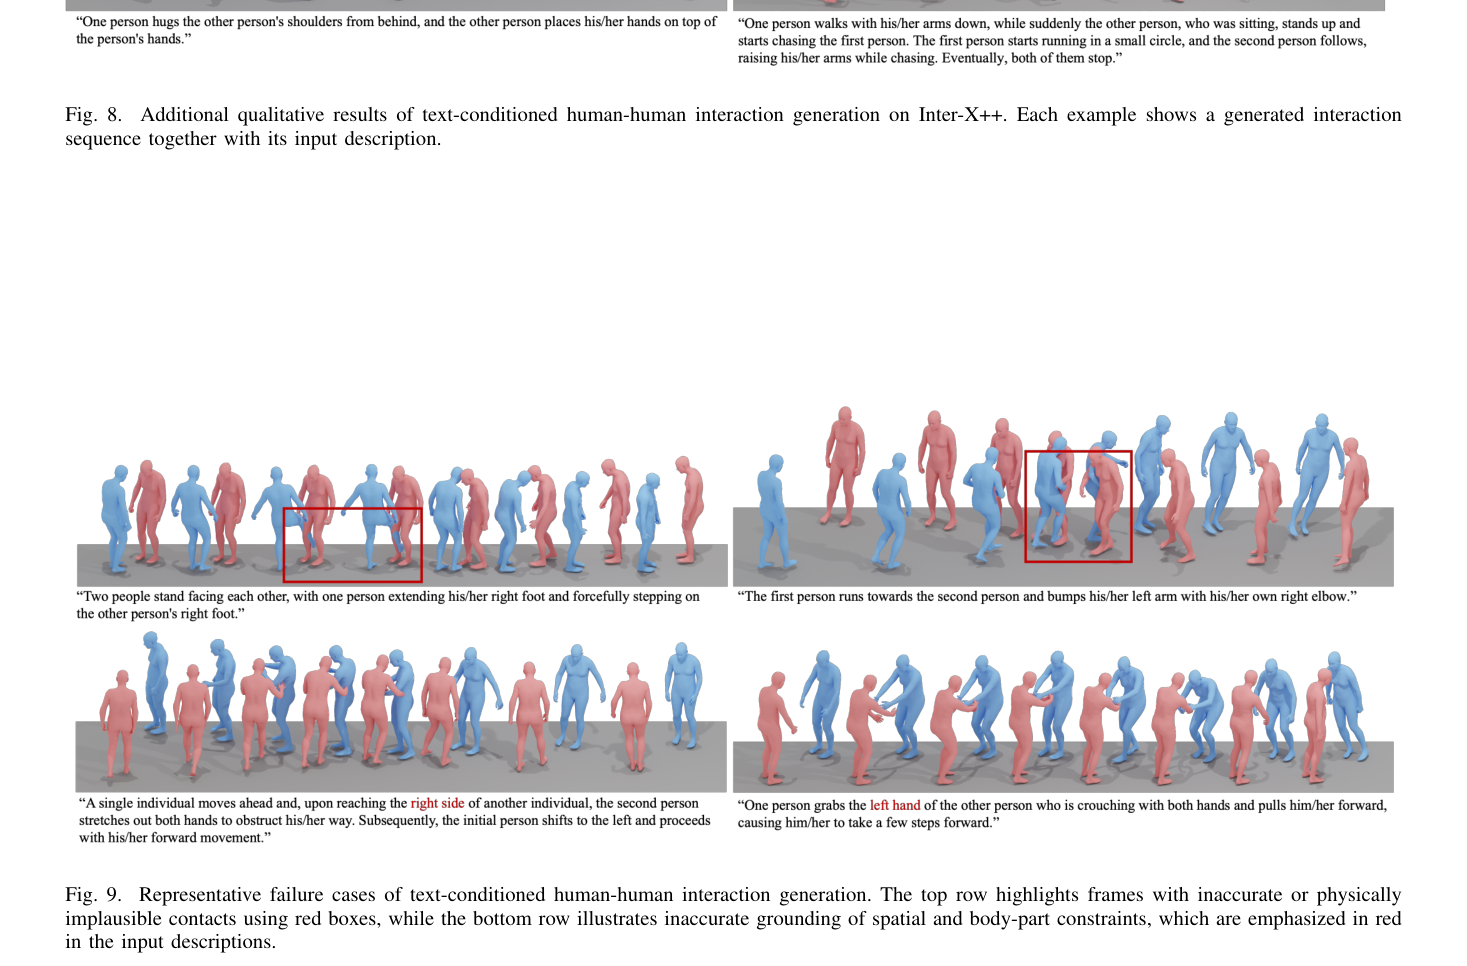
该图展示了文本条件生成的典型失败案例。红色框标注了不准确或物理不合理的接触,以及空间和身体部位约束的错误接地,这揭示了当前方法的局限性。
实验如何设计?
- 数据集划分比例为 0.8/0.15/0.05,与部分已有基准的划分方式不同,需注意跨数据集比较时的差异。
- 评测指标沿用 HumanML3D 的 R-Precision、FID、MM Dist、Diversity 和 MModality,保证与单人生成基准的可比性。
- 文本条件生成对比了 TEMOS、T2M、MDM、MDM(GRU)、ComMDM、InterGen、InterMask 和 OpenHHI 等方法。
- 动作条件生成、反应生成、识别、字幕生成、因果推断和人格评估均设置了对应的基线对比实验。
- 层次化文本粒度消融研究考察了不同文本粒度对生成质量的影响。
- 物理模仿实验对比 PHC-Base 与在 Inter-X++ 上微调的 PHC*,验证物理约束的有效性。
关键结果与论文证据
- 6D rotation 表示在 Top-1 R-Precision 达 0.389,显著优于其他四种表示,确立了统一表示的必要性(第 10 页)。
- PHC* 在 Inter-X++ 上 Succ 达 81.30%,优于 PHC-Base 的 76.79%,证明物理仿真修正有效(第 10 页)。
- OpenHHI 在文本条件生成上 Top-1 R-Precision 达 0.437,FID 降至 0.573,显著优于 InterMask 的 0.389/1.195 和 InterGen 的 0.207/5.207(第 11 页)。
- OpenHHI 在动作条件生成上 FID 达 4.215,识别准确率 0.969,优于 Actformer 的 8.067/0.945(第 12 页)。
- OpenHHI 在反应生成上 FID 达 3.172,准确率 0.947,优于 AGRoL 的 4.386/0.925(第 12 页)。
- OpenHHI 在 HHI 识别上 Top-1 达 84.88%,优于 MS-G3D 的 83.30%(第 12 页)。
- OpenHHI 在 HHI 字幕生成上 Bleu@4 达 35.4,优于 TM2T 的 21.6(第 12 页)。
- 层次化文本粒度消融显示,更细粒度的描述提供更精确的控制,而更粗粒度的提示允许更广泛的运动变化(第 15 页)。
阅读时需要注意
- 数据集采集于受控封闭 MoCap 工作室环境,与真实开放场景存在分布差异,模型的泛化能力有待验证。
- 物理仿真修正采用单智能体环境微调 PHC,多智能体共享仿真环境的物理约束仅在评估阶段应用,训练阶段的物理合理性保障不足。
- OpenHHI 的 MModality 在文本条件生成中为 1.796,低于 InterMask 的 2.695,生成多样性有所下降。
- 接触标注采用简单的距离阈值方法(0.05 m),未考虑接触力或压力信息,限制了精细接触建模的能力。
- 人格评估使用 NEO Five-Factor Inventory 自评量表,存在主观偏差。
关联工作
- InterHuman 是大规模 HHI 数据集,提供 6,022 条序列和文本标注,但缺少手部细节和物理约束,是 Inter-X++ 的直接对比对象。
- Inter-X 是本文的 CVPR 2024 会议版本,提供 11,388 条序列和细粒度文本,本文在此基础上扩展层次化文本、接触标注和物理约束。
- InterGen 基于 InterHuman 的文本条件 HHI 生成方法,采用 non-canonical 表示,本文将其作为表示对比和生成基线。
- InterMask 是基于 VQ-VAE 的 HHI 生成方法,在文本条件生成基线中表现最佳,本文将其作为主要对比对象。
- PHC 是基于强化学习的物理模仿策略,本文在其基础上微调以实现 Inter-X++ 的物理合理性修正。
- HumanML3D 是单人生成基准,本文沿用其评测指标,保证与单人生成任务的可比性。