快速导读:DreamHand将预训练视频扩散模型改造为确定性干净潜变量编码器,配合双向时空解码器和基于射线的相机求解器,在单次前向传播中恢复遮挡及视野外双手的度量3D轨迹。
以自我为中心视频中的3D手部运动恢复面临一个根本性困境:手部频繁被物体遮挡或完全移出视野,而现有方法要么依赖逐帧检测器在遮挡处失效,要么依赖窗口化时序回归器在视野外间隙中误差累积。DreamHand提出了一条不同的路径——不再把视频扩散模型当作生成像素的采样器,而是把它当作一个已经学会理解手部几何与运动的特征编码器,在单次前向传播中直接读出双手的MANO参数和度量3D轨迹。
论文的核心论点是:视频扩散模型在去噪训练中习得的干净潜变量表征,本身就蕴含了足够的几何与运动先验,足以支撑遮挡鲁棒的手部运动恢复,而不需要多步生成采样。DreamHand通过三个关键设计验证了这一论点:确定性干净潜变量编码器、双向时空解码器、以及基于射线的相机求解器。
英文题目:DreamHand: Repurposing Video Diffusion Models for Occlusion-Robust Egocentric 3D Hand Motion Recovery
论文出处:arXiv 每日论文精选 · arXiv:2608.20308
原始论文:PDF / 论文页面
这篇论文解决什么问题?
以自我为中心的手部运动恢复是AR/VR、机器人示教和具身智能的基础任务。然而,第一人称视角下,手部经常被操作物体遮挡,或者在自然交互中完全离开相机视场。以ARCTIC数据集为例,约6.9%的手部帧处于视野外;在HOT3D中这一比例高达17.6%。这些间隙对现有方法构成了严峻挑战。
现有方法大致分为两类。单帧方法如WildHands逐帧回归手部姿态,在遮挡帧上容易产生漏检或错误检测,且无法利用时序信息填补视野外间隙。窗口化时序方法如EgoForce和HaWoR虽然利用了时间上下文,但依赖外部检测器或SLAM锚定,在遮挡和视野外间隙中误差会累积并传播。
近期,生成式方法ViDiHand尝试用视频扩散模型通过多步采样合成几何叠加图,再从中回归MANO参数。这种方法在遮挡场景下表现出色,但存在两个根本问题:一是多步采样推理速度极慢,二是生成过程可能引入与真实手部运动不一致的伪影。这引出了一个关键问题:我们是否真的需要生成像素,还是可以直接从扩散模型的内部表征中读取手部运动?
核心创新
- 将视频扩散模型改造为确定性干净潜变量编码器,单次前向传播替代多步生成采样,推理速度提升33倍
- 双向时空解码器以空间锚定关节查询和旋转相对位置编码实现整段视频的双向推理,重建视野外双手
- 基于射线的相机求解器预测连续视线场,解耦手部运动与相机动态,支持测试时无内参推理
- 混合PnP平移求解:仅回归光轴深度,通过预测的2D关节锚点闭式求解平面内平移
方法概览
DreamHand将Wan视频扩散模型用作确定性干净潜变量编码器(σ=0,截断至第15个DiT块),通过LoRA端到端适配提取几何感知特征;双向时空解码器以空间锚定查询(手部token、关节token、寄存器token)交替进行空间交叉注意力和时序自注意力,输出MANO参数;基于射线的相机求解器预测连续视线场,通过混合PnP求解度量平移,支持无内参(K-free)配置。
- 确定性干净潜变量编码器:DreamHand将Wan视频扩散模型用作特征提取器,在σ=0的噪声水平下进行单次前向传播,截断至第15个DiT块。这意味着模型不需要迭代去噪,而是直接读取干净潜变量对应的中间特征。通过LoRA进行端到端适配,使预训练特征适应手部运动恢复任务。
- 双向时空解码器:解码器以空间锚定查询为核心,包括手部token、关节token和寄存器token。四层结构交替进行空间交叉注意力和时序自注意力,使模型能够同时利用单帧的空间信息和整段视频的时序上下文。旋转位置编码(rotary PE)为时序自注意力提供相对位置信息,使模型能够双向推理整段视频。
- 基于射线的相机求解器:Ray Head从DiT特征中预测连续视线场,即每个像素对应的3D方向向量。这一设计将手部运动与相机动态解耦——手部在世界坐标系中的运动不再依赖于相机内参的精确标定。在测试时,模型可以完全丢弃内参(K-free配置),或者仅将内参用作平移求解中的方位来源(标准配置)。
- 混合PnP平移求解:与直接回归3D平移不同,DreamHand仅回归光轴方向的深度,然后利用预测的2D关节锚点通过闭式PnP求解平面内平移。这种混合策略避免了直接回归平移时的不稳定性,同时保持了度量精度。
- 训练策略:训练时使用相机内参监督Ray Head,使视线场学习到与真实相机几何一致的映射。测试时丢弃内参,模型依靠学到的视线场先验进行推理。这种训练-测试的不对称设计是K-free能力的关键。
- 参数效率:只有patch embedding、LoRA、Ray Head和Decoder参与训练,Wan DiT的主体参数保持冻结。这使得DreamHand在保持预训练知识的同时,以较低的计算成本完成适配。
逐图理解论文
失败案例与直觉
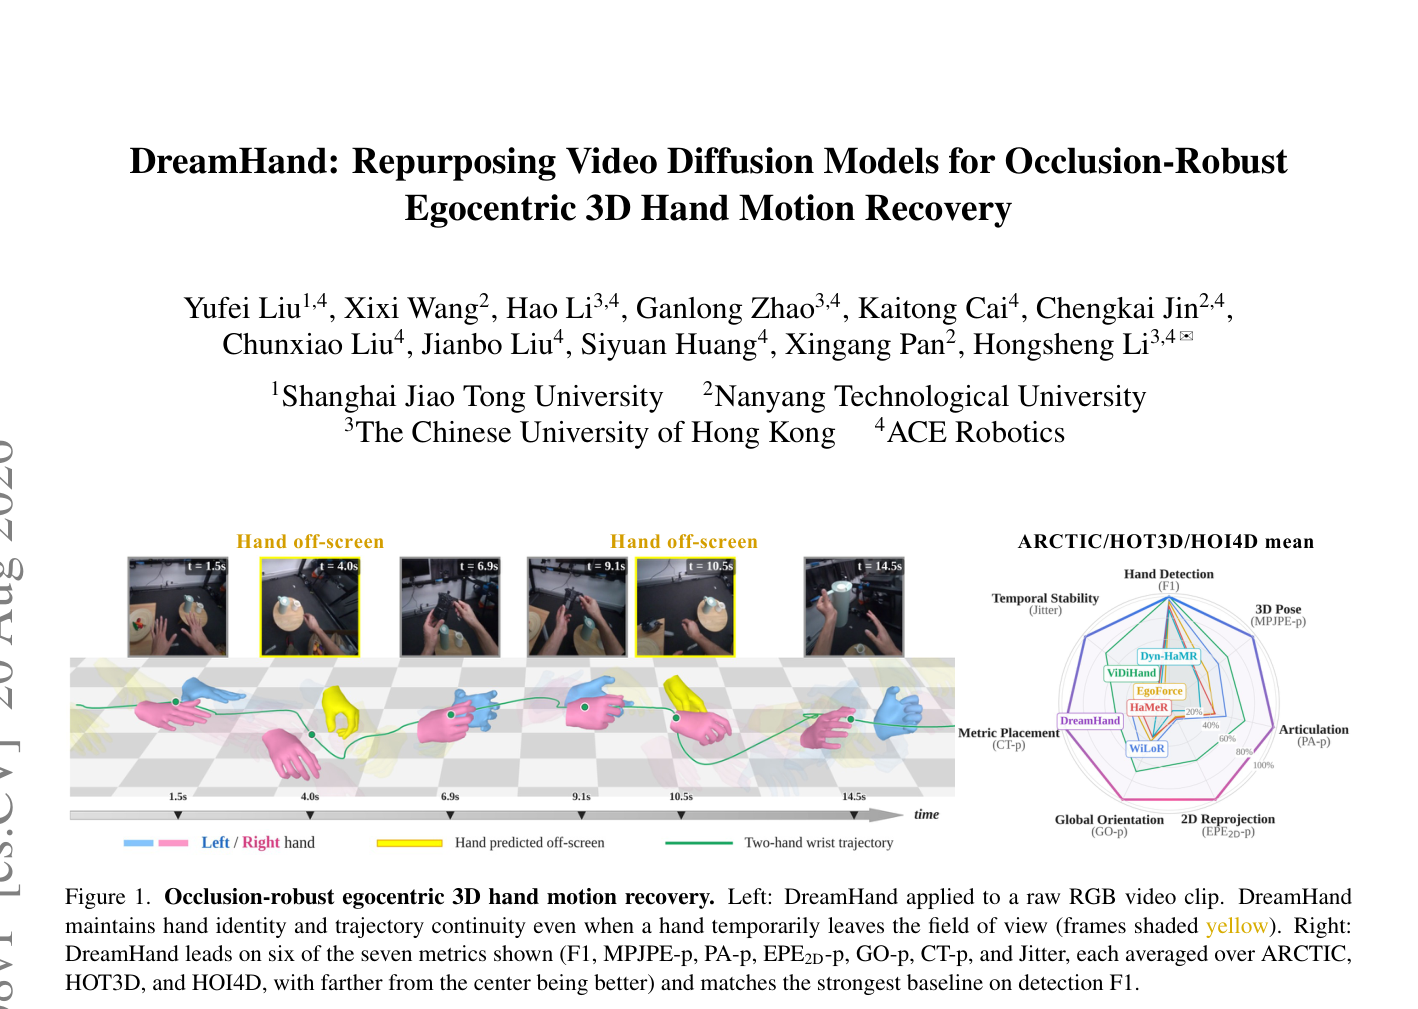
图1展示了DreamHand的核心能力:在原始RGB视频中,即使手部暂时离开视野(黄色阴影帧),模型仍能保持手部身份和轨迹连续性。右侧的雷达图显示DreamHand在七个指标中的六个上领先,且检测F1与最强基线持平。
核心区分:编码而非生成
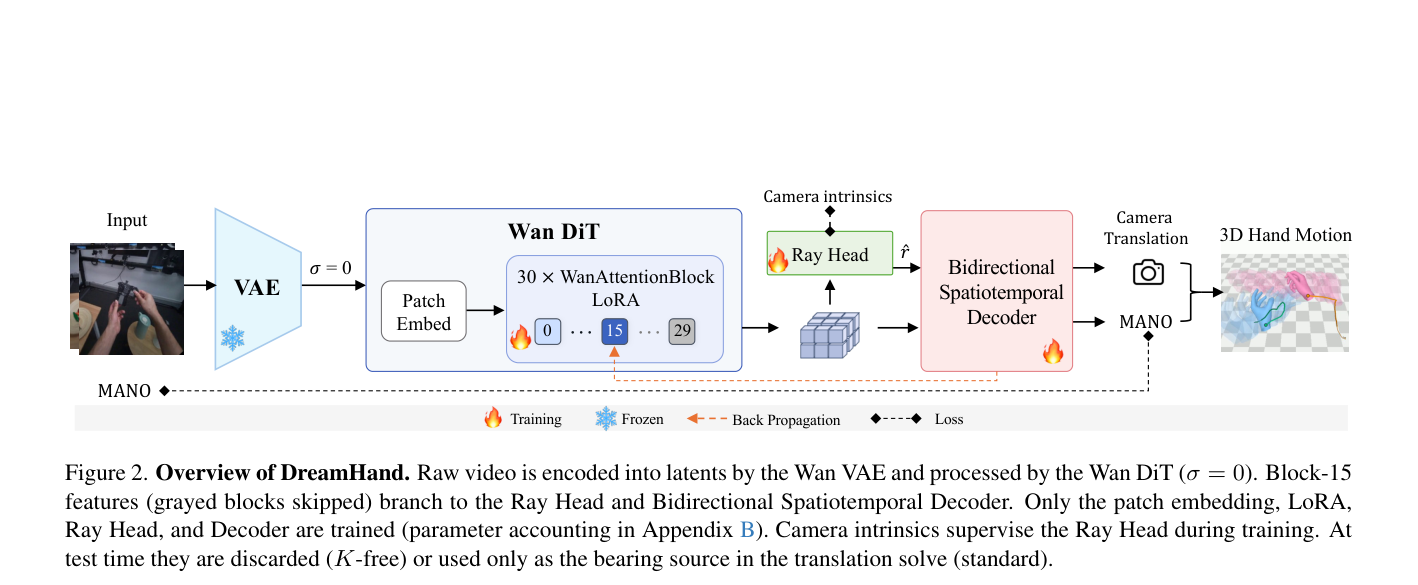
图2展示了整体架构:原始视频经Wan VAE编码后进入Wan DiT(σ=0),第15块的特征分支到Ray Head和双向时空解码器。灰色块表示被截断的部分,只有patch embedding、LoRA、Ray Head和Decoder参与训练。
最强结论
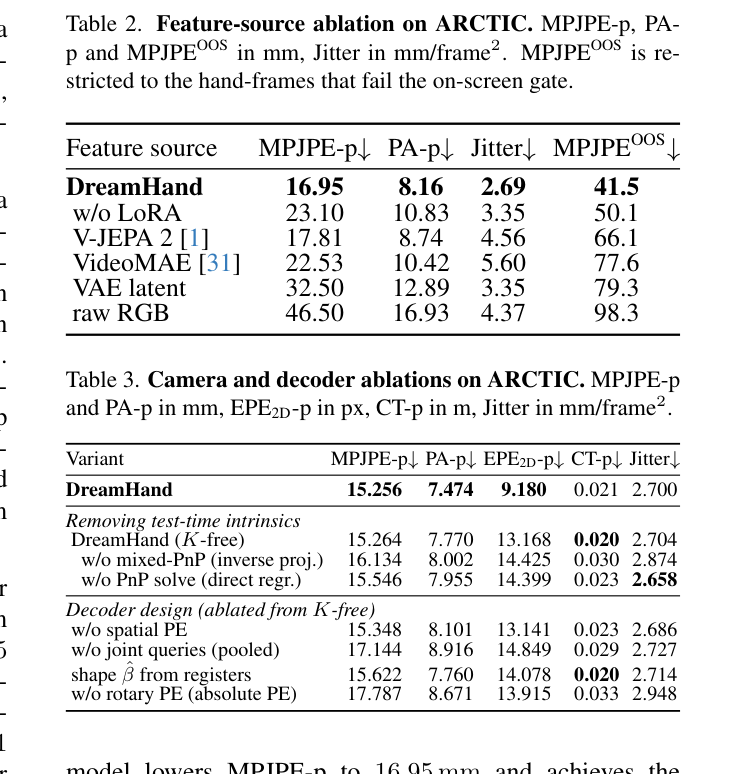
最有力的证据来自特征源消融:把Wan扩散模型特征换成V-JEPA 2、VideoMAE、VAE潜变量甚至原始RGB,性能全面下降。这说明扩散模型在去噪训练中习得的表征,对手部几何和运动的理解远超判别式预训练模型。DreamHand证明了扩散模型的价值不在生成,而在它已经学会的表示本身。
意义与局限
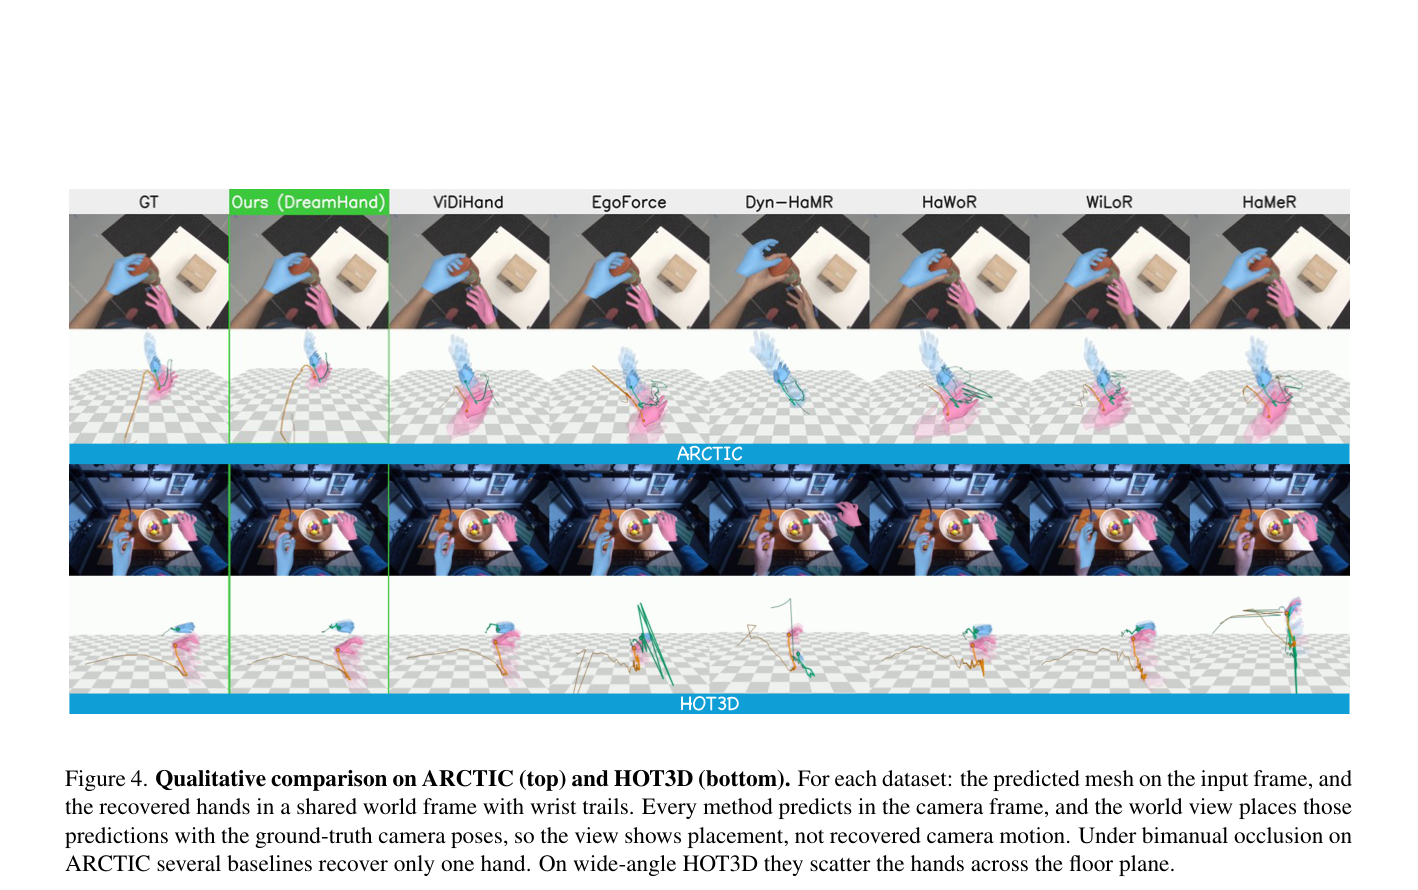
图4的定性对比揭示了关键差异:在ARCTIC双手遮挡场景中,多个基线只能恢复一只手,而DreamHand保持双手完整;在HOT3D广角场景中,基线将手散布在地面平面上,DreamHand保持正确的空间位置和轨迹。
实验如何设计?
- 在五个基准数据集上评估:ARCTIC、HOT3D、HOI4D、H2O和OakInk2,其中HOI4D为零样本评估,检验跨数据集泛化能力。
- 与10个基线方法对比,包括单帧方法WildHands、时序方法EgoForce和HaWoR、以及生成式方法ViDiHand。
- 特征源消融实验对比Wan VDM特征、V-JEPA 2、VideoMAE、VAE潜变量、原始RGB以及无LoRA变体,验证扩散模型特征的优势。
- 相机与解码器消融实验包括K-free配置、逆投影替代混合PnP、直接回归平移、移除空间位置编码、池化关节查询、绝对位置编码替代旋转位置编码。
- 评估指标包括MPJPE-p(带惩罚的腕对齐平均关节位置误差)、PA-p、EPE2D-p、GO-p、CT-p、Jitter和检测F1,其中带惩罚的指标对漏检手赋予规范MANO占位,避免漏检被忽略。
关键结果与论文证据
- 在ARCTIC上,DreamHand的MPJPE-p达到15.256 mm,较ViDiHand降低30%(第6页表1)。
- 在HOT3D上,MPJPE-p为12.888 mm,较ViDiHand降低40%(第6页表1)。
- 在HOI4D零样本评估中,MPJPE-p为23.031 mm,较ViDiHand降低23%,表明跨数据集泛化能力(第6页表1)。
- 在视野外手部帧上,ARCTIC的MPJPE+OOS为16.783 mm,较ViDiHand降低45.9%;HOT3D上降低61.1%,证明双向时序推理对视野外手部重建的关键作用(第6页表1)。
- 推理速度达到63.1 fps(单张A100),而ViDiHand仅为1.91 fps,速度提升33倍(第7页)。
- 特征源消融显示,Wan VDM特征显著优于V-JEPA 2、VideoMAE、VAE潜变量和原始RGB,验证了扩散模型干净潜变量中蕴含的几何先验(第7页表2)。
- 相机消融显示,混合PnP平移求解优于直接回归平移和逆投影方法,基于射线的视线场预测是K-free能力的基础(第7页表3)。
- 定性对比显示,在ARCTIC双手遮挡场景中,多个基线只能恢复一只手,而DreamHand保持双手身份和轨迹连续性;在HOT3D广角场景中,基线将手散布在地面平面上,DreamHand保持正确的空间位置(第8页图4)。
阅读时需要注意
- 预测的射线场在训练中见过的相机家族内泛化最好,对于训练分布之外的相机几何,视线场预测的准确性可能下降,需要更广泛的数据覆盖。
- HOI4D和H2O部分依赖伪真值标注,更高精度的真值标注有望进一步提升模型性能。
- DreamHand采用离线整段视频处理,不适合需要实时闭环控制的场景,需要蒸馏为因果流式变体以支持在线部署。
- K-free配置在HOT3D上检测覆盖率显著下降(FAcc从0.986降至0.752),归因于图像边缘处视线预测不可靠,表明K-free能力在广角场景下仍有局限。
关联工作
- ViDiHand是最直接的生成式基线,通过Wan+VACE多步采样合成几何叠加图并回归MANO参数。DreamHand在其基础上将多步生成采样替换为单步确定性编码,从根本上改变了扩散模型在手部运动恢复中的使用方式。
- V-JEPA 2和VideoMAE作为自监督判别式视频编码器,在特征源消融中作为替代编码器。它们的表现不如Wan VDM特征,说明扩散模型在去噪训练中习得的表征对手部几何和运动的理解优于判别式预训练。
- HaWoR是世界空间手部运动重建基线,评估时禁用了SLAM和填充阶段。DreamHand的基于射线相机求解器提供了一种不依赖SLAM的替代方案,通过视线场预测实现相机动态解耦。