快速导读:提出BeyondMasks配对基准与CORE评估协议,将视频物体移除从局部修复重构为因果干预问题,系统评估物体及其诱导物理效应(阴影、反射等)的消除。
视频物体移除长期以来被当作一个局部修复问题:给定掩码,把掩码内的像素填好就算成功。但物体在场景中不只是占据像素——它投下阴影、在镜面中留下反射、改变光照分布、扰动水面和空气。BeyondMasks这篇论文的核心论点是:如果只评估掩码区域的像素重建质量,就永远无法判断一个移除结果是否真正恢复了'物体从未存在过'的场景状态。
论文提出两个互补的贡献:一个名为BeyondMasks的配对基准,包含180个时间对齐的视频对(90个合成、90个真实),每个视频对都有物体存在版本和干净背景参考;以及一个名为CORE的评估协议,用视觉语言模型(VLM)对比编辑输出与干净参考,分别评估物体消失(CORE-OS)和后效应消除(CORE-AES)。
英文题目:BeyondMasks: Evaluating Causal and Physical Consistency in Video Object Removal
论文出处:arXiv 每日论文精选 · arXiv:2608.20107
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有视频物体移除基准存在一个根本性缺陷:缺乏配对干净背景。DAVIS和YouTube-VOS等数据集只提供掩码标注,没有'物体不存在时场景应该是什么样'的参考。因此评估只能退化为掩码区域内的重建保真度——PSNR、SSIM、LPIPS等指标衡量的是像素相似性,而非因果正确性。
ROSE-Bench是首个尝试引入合成配对数据研究物理副效应的基准,但其交互多样性有限,且不支持指令驱动的编辑。HQVI通过alpha合成构建配对真值,但假设不存在次级环境效应。这些工作都触及了同一个问题,却都没有把'物体诱导的物理效应'作为核心评估维度来系统建模。
论文将物体移除重新定义为因果干预:物体不仅占据像素,还通过阴影、反射、透光、体积效应和动态扰动影响环境。移除物体的正确结果应该是恢复物体从未存在时的场景状态,包括消除所有这些诱导效应。这个定义直接暴露了传统评估的盲区。
核心创新
- 将视频物体移除重构为因果干预问题,评估物体-环境一致性而非局部重建
- 构建BeyondMasks配对基准(180个视频),时间对齐的干净背景参考,覆盖合成与真实场景
- 提出CORE评估协议,分离物体消失(CORE-OS)与后效应消除(CORE-AES)两个维度
- 掩码仅覆盖物体本身、不覆盖后效应,迫使模型通过物理推理消除次级效应
方法概览
构建BeyondMasks:180个时间对齐的合成与真实配对视频(90+90),含干净背景参考、逐帧掩码和指令提示,覆盖6类后效应。提出CORE:基于VLM(Gemini 3.1)的结构化评估,分解为ObjectScore(物体消失)和AfterEffectScore(后效应消除),通过对比编辑输出与对齐干净参考进行干预验证。
- BeyondMasks的构建采用干预式生成管线:从干净背景视频出发,通过生成模型引入物体及其物理效应,得到物体存在版本。这样保证两个版本逐帧时间对齐,干净背景就是完美的ground truth参考。
- 数据集覆盖6类后效应:阴影、反射、光照变化、蒸汽/体积效应、透光、动态物理痕迹。类别分布遵循自然频率而非人工平衡——阴影出现127次,蒸汽仅20次,这使基准更接近真实场景的分布。
- 掩码设计有一个关键细节:掩码只覆盖物体本身,不覆盖后效应区域。这迫使模型通过物理推理来消除次级效应,而不是简单地填充被掩码的区域。
- CORE评估协议使用Gemini 3.1作为VLM评判者,对编辑输出和干净参考进行结构化对比。评估分解为两个维度:ObjectScore衡量物体是否完全消失,AfterEffectScore衡量阴影、反射等物理痕迹是否被消除。
- CORE的评分采用离散1-5量表,通过提示词引导VLM关注因果一致性而非像素相似性。评估条件化在对齐参考上,使语义推理有明确的对照基准。
- 论文还分析了掩码清零操作的信息损失问题:许多mask-based管线在推理前将掩码区域置零,这会丢失透光物体背后部分可见的背景信息,迫使模型幻觉缺失内容而非恢复可用信息。
逐图理解论文
失败案例:物体消失,影子还在
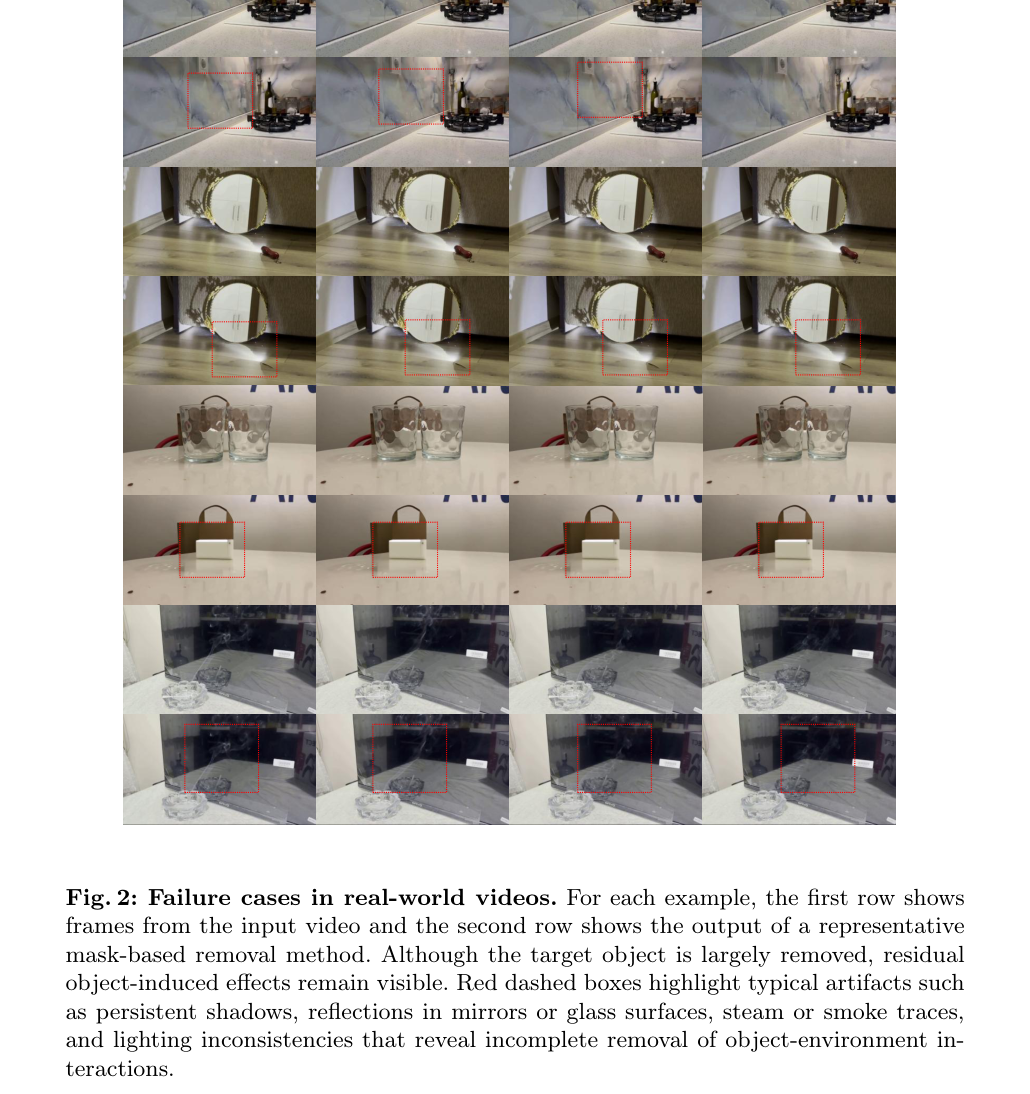
图2(第33页)展示了真实世界视频中的失败案例:红色虚线框标出残留的阴影、镜面反射、蒸汽痕迹和光照不一致。这些案例说明即使物体被移除,因果足迹仍然可见,验证了CORE-AES的必要性。
研究空白:从局部修复到因果干预
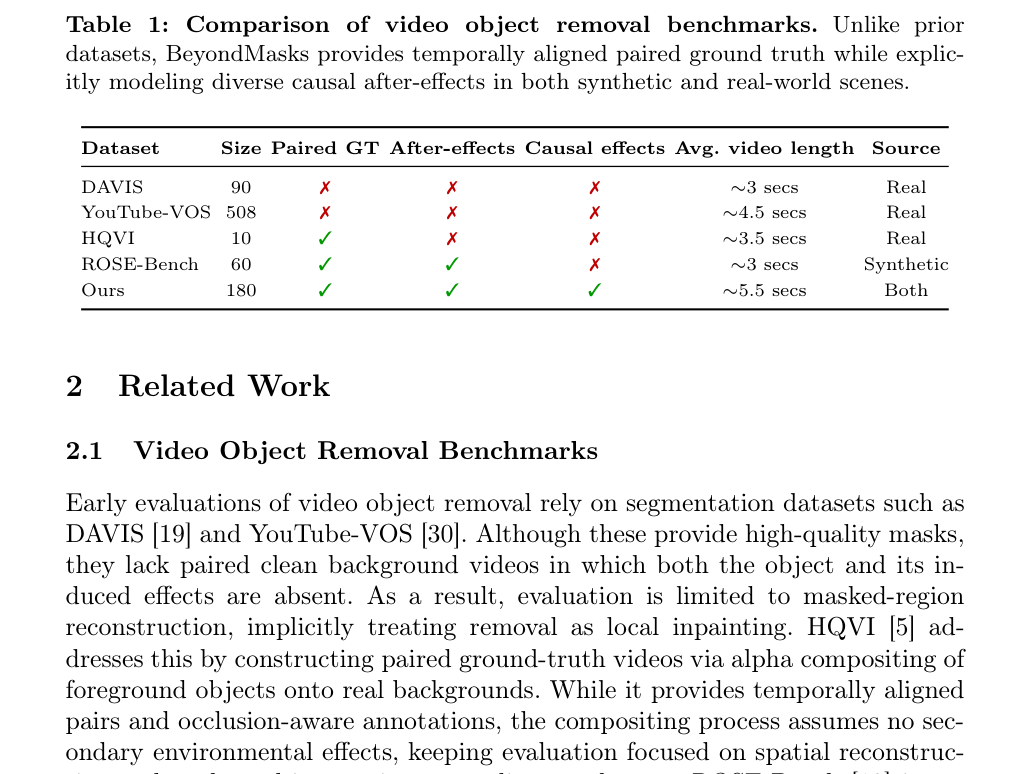
问题的根源在于,现有基准缺乏配对干净背景。DAVIS和YouTube-VOS只有掩码标注,没有'物体不存在时场景应该是什么样'的参考。ROSE-Bench虽然引入了合成配对数据,但效应类型有限。BeyondMasks的核心洞察是:物体移除本质上是因果干预——物体不仅占据像素,还通过阴影、反射、透光、体积效应和动态扰动影响环境。正确的移除结果,应该是恢复物体从未存在时的场景状态。
贡献:配对基准与CORE评估协议
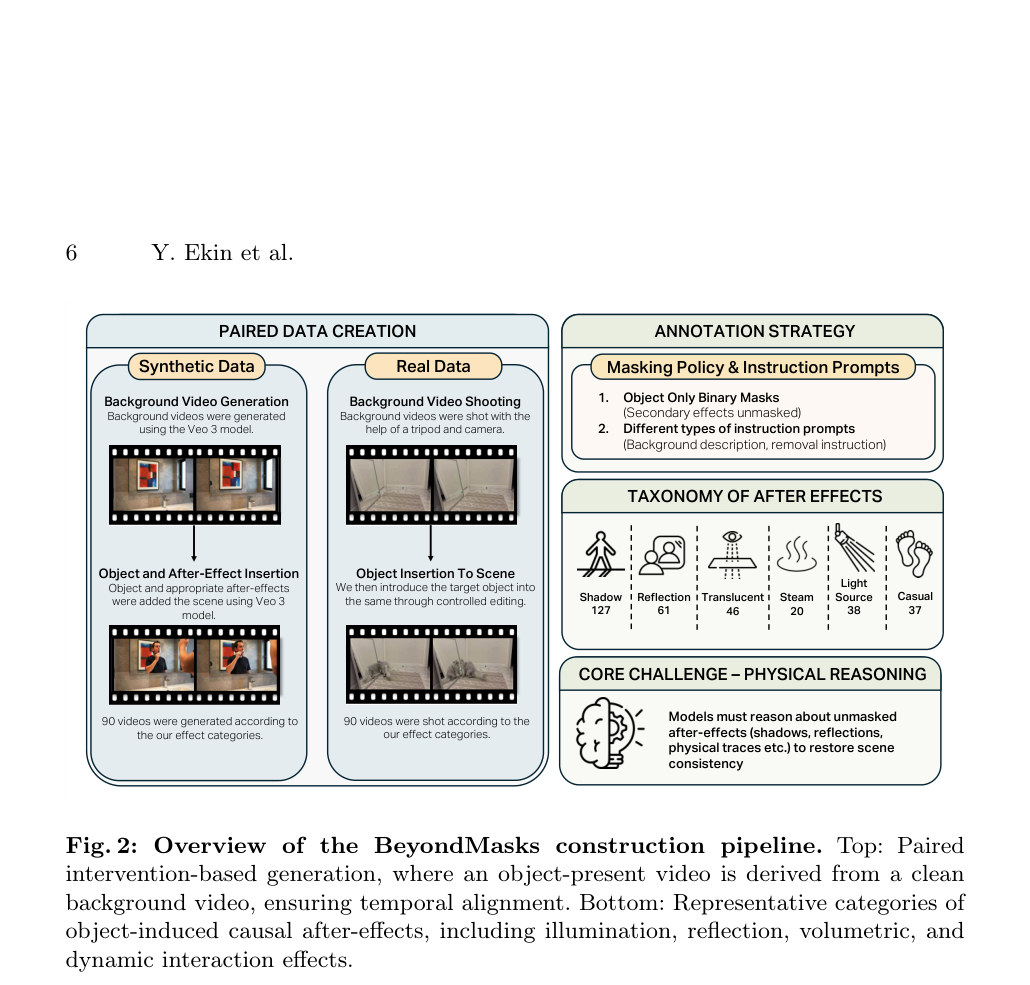
图2展示了BeyondMasks的构建管线:从干净背景视频出发,通过干预式生成引入物体及其效应,确保时间对齐。底部的类别示例展示了光照、反射、体积和动态交互等后效应类型,帮助理解数据集的覆盖范围。
核心发现:像素指标与因果正确性脱节
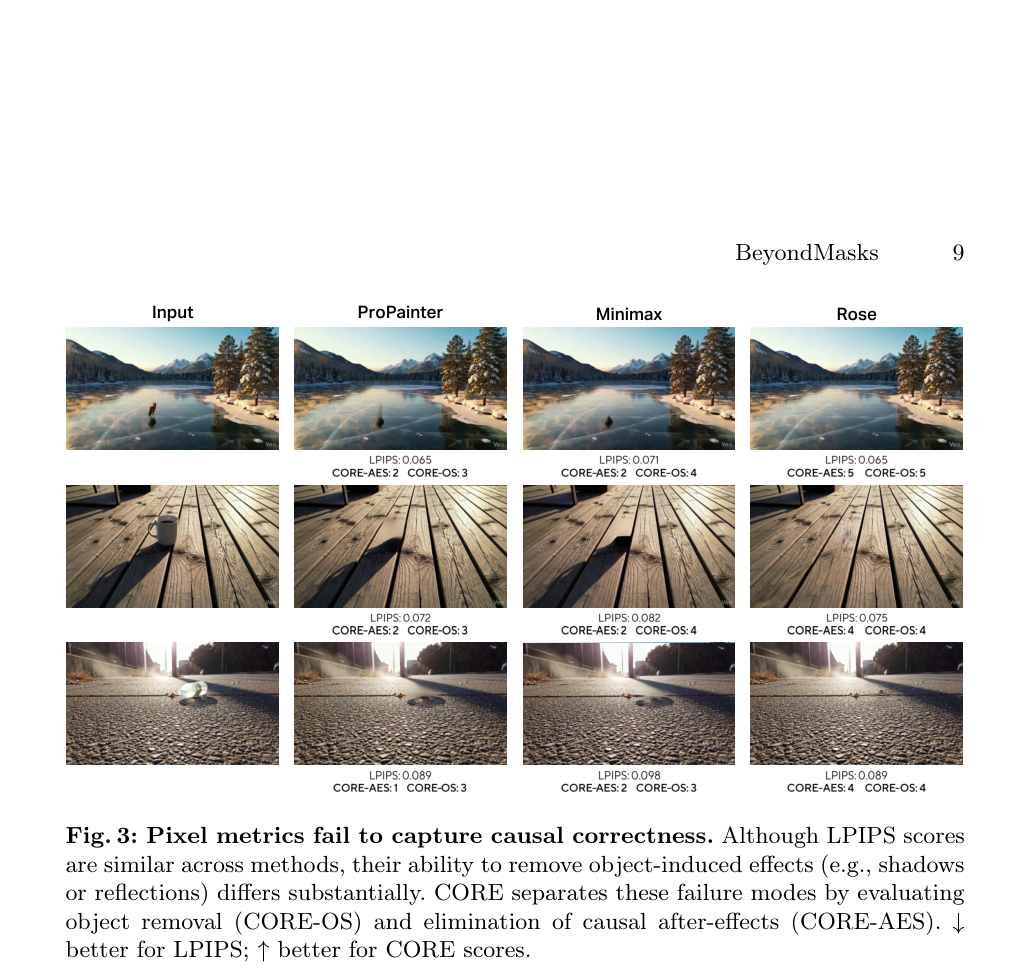
图3直观展示了像素指标与因果正确性的脱节:不同方法的LPIPS分数相似,但后效应消除能力差异显著。CORE通过分离CORE-OS和CORE-AES来捕捉这些像素指标无法区分的失败模式。
结论与意义
BeyondMasks最重要的贡献,是把视频物体移除的评估从'填得好不好'转向了'因果上对不对'。CORE的AfterEffectScore与人类判断的相关性接近人类标注者间的一致性水平,说明这条路是可行的。当然,数据集只有180个视频,类别分布也不均匀,蒸汽类样本偏少。但方向已经明确:评估物体移除,必须看它有没有把物体的物理足迹一起带走。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 在BeyondMasks上基准测试9种视频物体移除/编辑方法,包括ProPainter、DiffuEraser、ROSE、MiniMax、VACE等,覆盖mask-guided和text-instruction两种监督模式。
- 按后效应类别(阴影、反射、光源、蒸汽、透光、因果物理效应)分别分析性能差异,揭示不同方法在不同物理效应类型上的相对优劣。
- 合成与真实子集分开评估,检验受控环境下的趋势是否迁移到真实场景。图像方法(OmniPaint、ObjectClear)以逐帧方式处理作为参考基线。
- 通过8名标注者对5种方法、20个视频的人工评分,验证CORE与人类判断的Spearman相关性,并与像素级指标的相关性进行对比。
- 分析图像级指标ReMOVE与CFD在视频因果效应场景下的适用性,检验它们是否能区分后效应消除的差异。
关键结果与论文证据
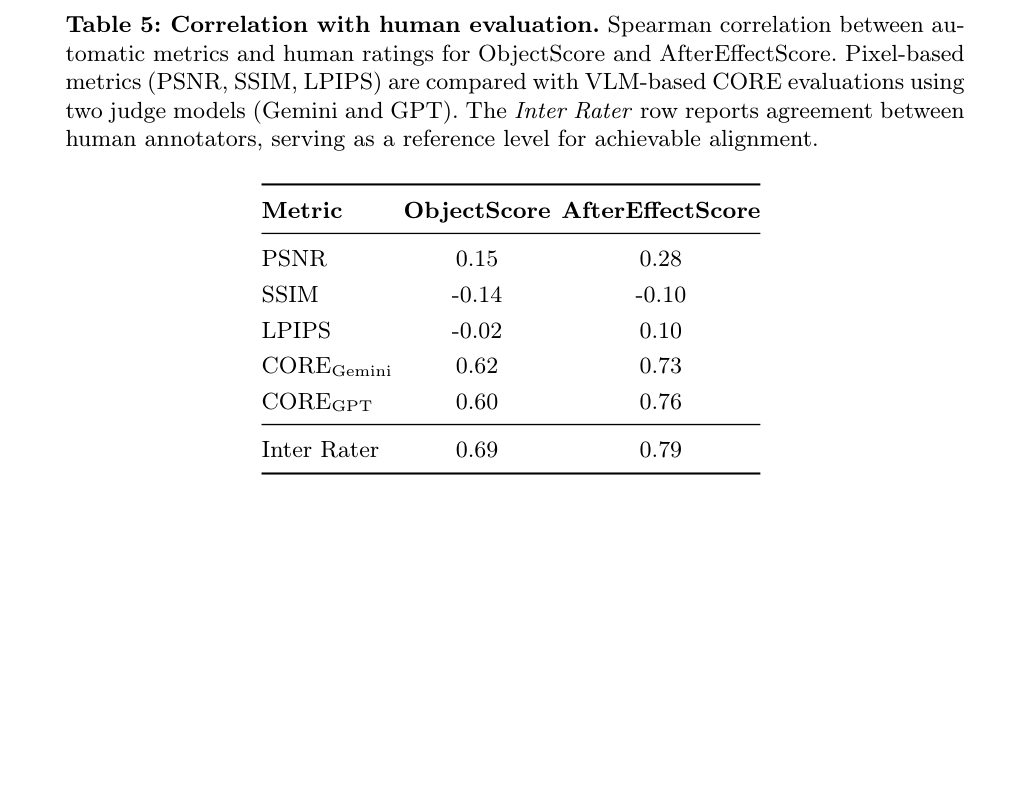
- 像素级指标与因果正确性严重脱节:PSNR与人类ObjectScore的Spearman相关性仅0.15,SSIM为-0.14,LPIPS为-0.02(第27页)。这意味着像素重建质量几乎无法预测物体移除的因果正确性。
- DiffuEraser取得最高PSNR 25.1880和SSIM 0.8769,但CORE-AES仅2.625,低于EffectErase的3.162(第11页)。高重建分数并不保证后效应消除。
- ROSE取得最高CORE-OS 3.784(合成子集4.068),但PSNR仅23.8062(第11页)。物体消失和像素保真度之间没有必然关联。
- EffectErase取得最高CORE-AES 3.162和CORE-OS 4.015(第11页),在因果一致性维度上表现最均衡。
- 蒸汽类后效应CORE-AES最低(2.032),阴影类最高(2.520)(第12页)。体积效应和动态痕迹对现有方法构成最大挑战。
- CORE_Gemini与人类评分的Spearman相关性:ObjectScore 0.62,AfterEffectScore 0.73;人类标注者间一致性为0.69和0.79(第27页)。CORE-AES的相关性接近人类标注者间一致性水平。
- ObjectClear(图像方法)在合成子集取得最高CORE-OS 4.325(第25页),但逐帧处理缺乏时间一致性,无法处理动态后效应。
- 掩码清零操作导致透光物体场景中的信息丢失,模型被迫幻觉缺失内容而非恢复可观察的背景信息(第14页,图6)。
阅读时需要注意
- 数据集规模较小(180个视频),类别分布不均(阴影127个 vs 蒸汽20个),可能影响稀有后效应类别的评估可靠性。
- CORE依赖VLM判断,离散1-5评分粒度较粗,无法捕捉细微的物理一致性差异。
- 合成数据由Veo 3生成,物理真实性受生成模型能力限制,合成子集的结论可能不完全迁移到真实物理场景。
- 图像方法逐帧处理缺乏时间一致性,无法处理动态后效应,这限制了图像方法在视频场景下的适用性结论。
关联工作
- ROSE-Bench是首个引入合成配对数据研究物理副效应的基准,但交互多样性有限且不支持指令驱动编辑。BeyondMasks在效应类别覆盖和评估协议上做了系统性扩展。
- Omnimatte和OmnimatteZero等分层视频分解方法显式分离物体及其效应,但未在标准化因果移除设置下评估。CORE协议为这类方法提供了更合适的评估框架。
- ReMOVE和CFD等图像级物体移除指标在视频因果效应场景下区分度不足,论文通过实验验证了它们在BeyondMasks上的局限性。
- VLM-as-a-judge的评估范式在多个领域得到应用,但BeyondMasks首次将其系统性地用于视频物体移除的因果一致性评估,并通过人类相关性验证了其有效性。