快速导读:提出 InfinityEdit,一个轻量级编辑适配器,使冻结的流式视频生成器能够对持续视频流进行无限轮次的指令编辑。
现有视频编辑方法几乎都建立在同一个隐含假设上:编辑是对一段固定时长的视频做原地重写,输出与源片段同时长、同时间跨度对齐。这个假设在短视频场景下成立,但一旦面对持续生成的视频流——比如直播画面、监控流、或正在实时续写的长视频——编辑指令需要作用于未来帧,而不是回头改写已经播出的内容。InfinityEdit 正是针对这一缺口提出的方法。
论文的核心贡献是定义了一个新任务——infinite video editing,并给出一个轻量级的解决方案:以冻结的 Helios-Distilled 流式生成模型为骨干,插入一个只在编辑到达时激活的 edit-ignition adapter。推理时,适配器在 ignition chunk 点火,把编辑指令注入去噪过程,随后冻结骨干继续生成,编辑效果自然延伸到后续所有帧。
英文题目:InfinityEdit: Infinite Video Editing with a Lightweight Edit-Ignition Adapter
论文出处:arXiv 每日论文精选 · arXiv:2608.20910
原始论文:PDF / 论文页面
这篇论文解决什么问题?
扩散 Transformer 已经在视频生成和指令编辑上取得了显著进展,但主流编辑方法(如 Lucy-Edit、SANA-Streaming)都遵循 in-place editing 范式:输入一段源视频和一条指令,输出一段同时长的编辑后视频。这种范式天然无法处理开放式视频流,因为流没有固定的终点,编辑必须向前延伸而非向后覆盖。
另一方面,流式生成模型(如 Helios)已经能够实时生成长视频,但它们缺乏指令注入机制。用户无法在生成过程中说“把天空变成黄昏”并让后续所有帧都遵循这个指令。InfinityEdit 要填补的正是这个空白:把编辑能力嫁接到流式生成器上,同时保持生成器的实时性和长程稳定性。
这个问题的难点在于:编辑指令到达时,模型必须同时做到三件事——保持与历史帧的视觉一致性、把编辑效果向前传播到未来帧、并且不能因为适配器的介入而破坏冻结骨干原有的生成质量。任何一点失败都会导致内容漂移、编辑丢失或画面闪烁。
核心创新
- 定义无限视频编辑任务:编辑指令反复作用于持续视频流,输出为时间上后续的片段而非原地重写
- 设计编辑类型感知的数据采集管线,合成(前序视频, 编辑指令, 目标视频)三元组
- 提出三模块编辑点火适配器:历史交叉注意力锚定、时序因果自注意力前向传播、编辑交叉注意力注入指令
- 训练中采用历史腐蚀与混合高斯噪声采样,配合两阶段课程学习提升多轮编辑稳定性
- 推理采用点火-继续策略:适配器仅在编辑到达chunk激活,冻结骨干携带编辑内容前向延续
方法概览
以冻结的Helios-Distilled为骨干,插入轻量编辑适配器,包含历史交叉注意力、时序因果自注意力和编辑交叉注意力三个模块;推理时仅在编辑指令到达的chunk激活适配器(点火),后续chunk由冻结骨干继续生成,配合滑动历史窗口与锚帧重置实现无限编辑。
- 骨干选择:InfinityEdit 使用冻结的 Helios-Distilled 作为流式生成骨干。Helios 是一个 14B 参数的实时长视频生成模型,本身支持流式续写,但不支持编辑指令注入。冻结骨干保证了生成质量和推理效率不被适配器拖累。
- 适配器架构:edit-ignition adapter 由三个注意力模块组成。history cross-attention 将当前去噪 chunk 锚定到输入的历史帧,确保编辑后的内容与源视频在视觉上保持一致;temporal causal self-attention 保证时间信息只从早帧流向晚帧,避免未来信息泄漏;edit cross-attention 将编辑指令注入去噪过程,驱动内容变化。
- 点火-继续推理策略:推理时,适配器并非全程激活。每个编辑轮次开始时,第一个 chunk 作为 ignition chunk 激活适配器,完成指令注入;后续 chunk 由冻结骨干继续生成,编辑效果通过骨干自身的时序机制自然延续。这种设计大幅降低了推理开销,同时避免了适配器持续介入导致的累积误差。
- 历史腐蚀训练:为了缓解 exposure bias——训练时用干净历史帧、推理时用自身生成的历史帧之间的不匹配——论文在训练时对历史帧加噪,使模型学会在历史信息不完美的情况下仍然稳定生成。这一策略参考了 Diffusion Forcing 的思路。
- 混合高斯采样:训练时采用 mixture-Gaussian sampling,将噪声水平采样集中在推理时实际使用的 σ 附近,减少训练与推理之间的分布偏移。
- 两阶段课程学习:先训练单轮编辑能力,再逐步引入多轮编辑链,提升模型在连续编辑下的稳定性。
- 锚帧重置:在长视频编辑中,编辑完成后重置 anchor frame,以稳定长程外观,防止内容在数百帧后逐渐漂移。
逐图理解论文
失败案例与直觉
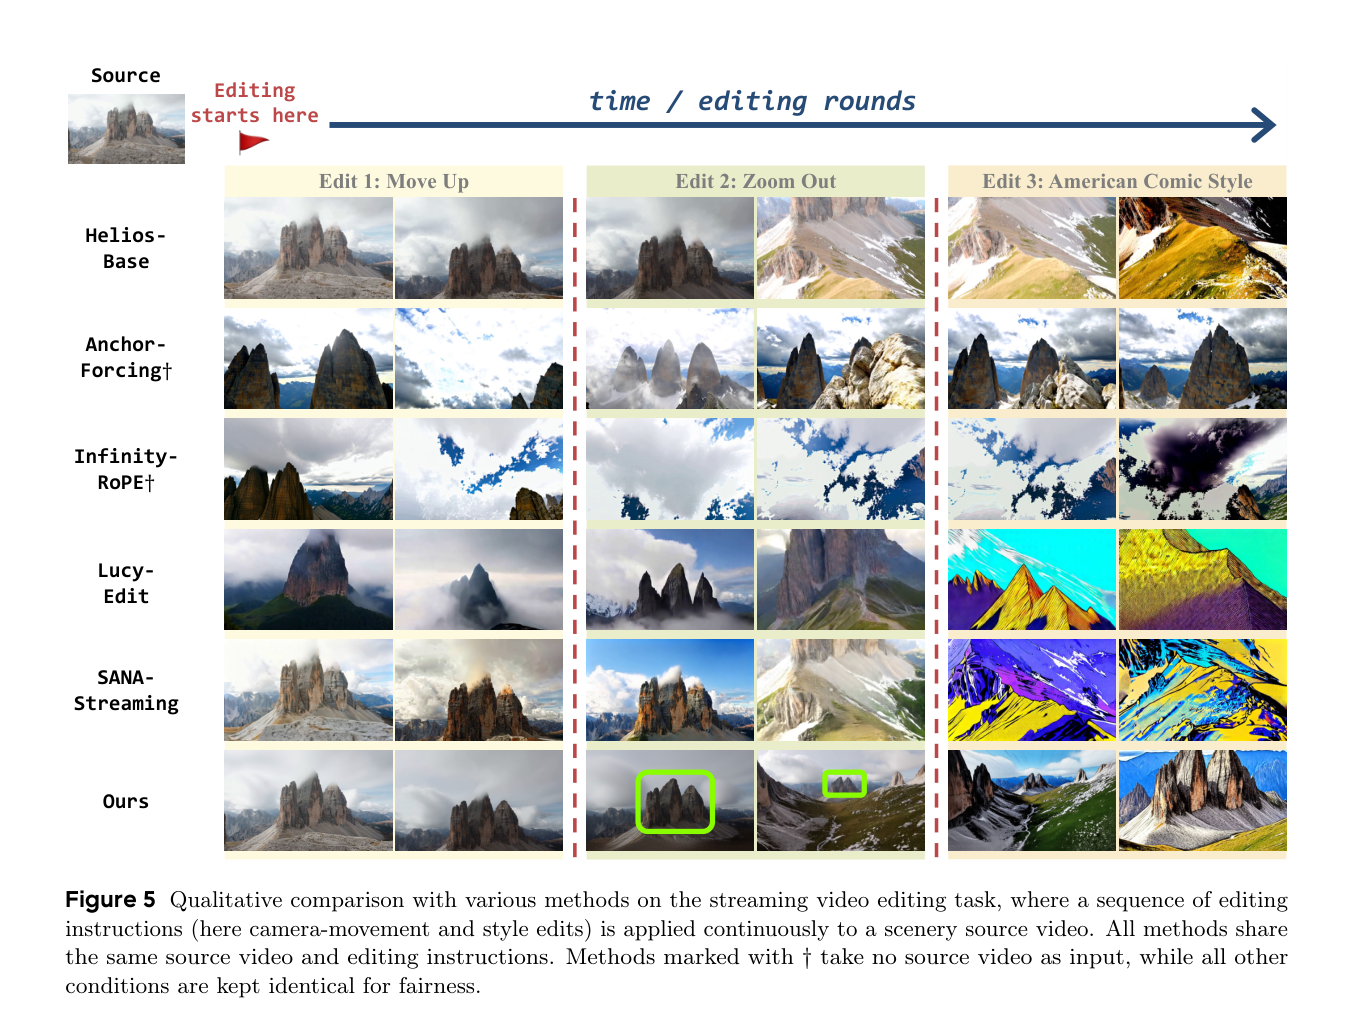
图 5 对比了各方法在风景视频上的连续编辑效果。重点观察 InfinityEdit 如何在保持场景身份的同时实现风格和镜头运动的连续编辑,而 prompt 切换类基线丢失了源视频内容。
方法贡献
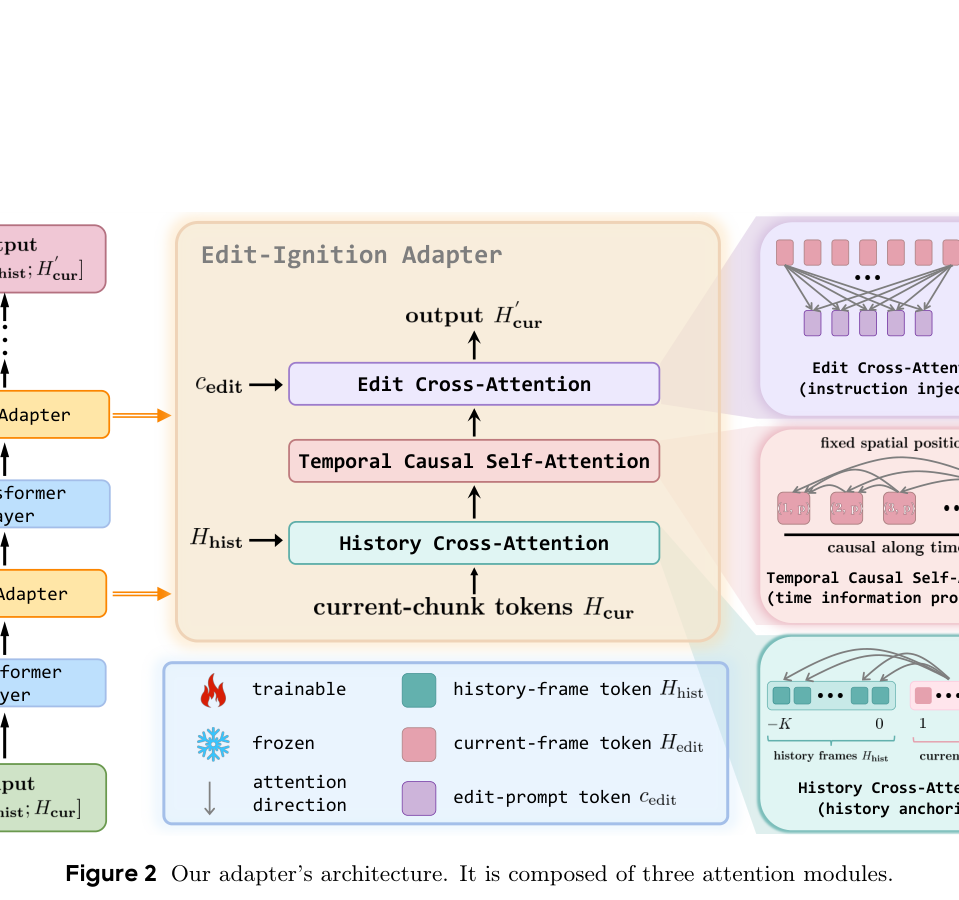
图 2 展示了适配器的三个注意力模块结构。重点观察 history cross-attention 如何将去噪 chunk 锚定到历史帧,以及 temporal causal self-attention 如何保证时间信息单向流动。
验证方式
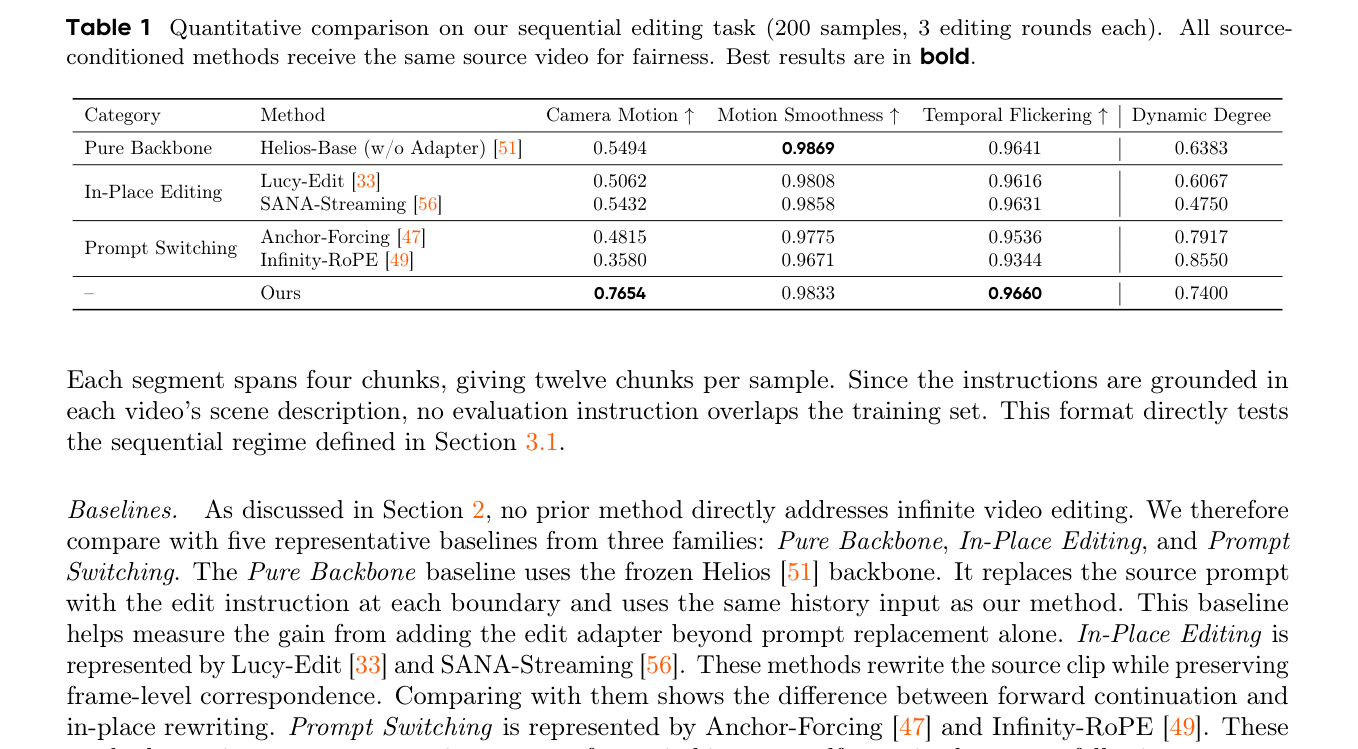
论文构建了一个包含 200 个源视频、15 种编辑类型、3 轮编辑链的顺序编辑基准,与五个基线对比。自动指标用 VBench,语义质量用 VLM-as-Judge 评估编辑忠实度、视觉质量、场景保持和跨编辑连贯性。
最强结论
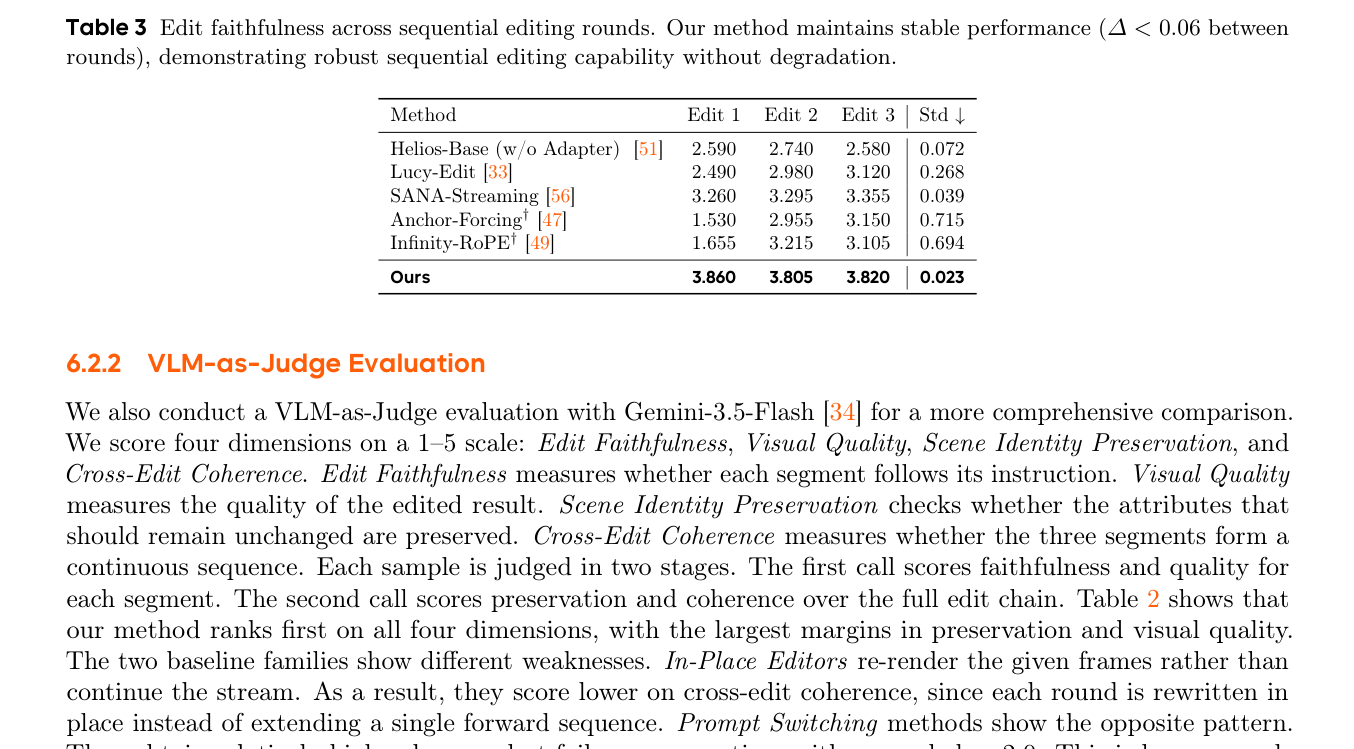
最有力的证据来自多轮编辑稳定性:InfinityEdit 的编辑忠实度跨轮标准差是所有方法中最低的,三轮分数几乎持平,而基线方法在连续编辑下要么内容漂移,要么画面质量逐轮下降。这说明点火-继续策略真正做到了编辑效果的累积而非互相干扰。
意义与局限
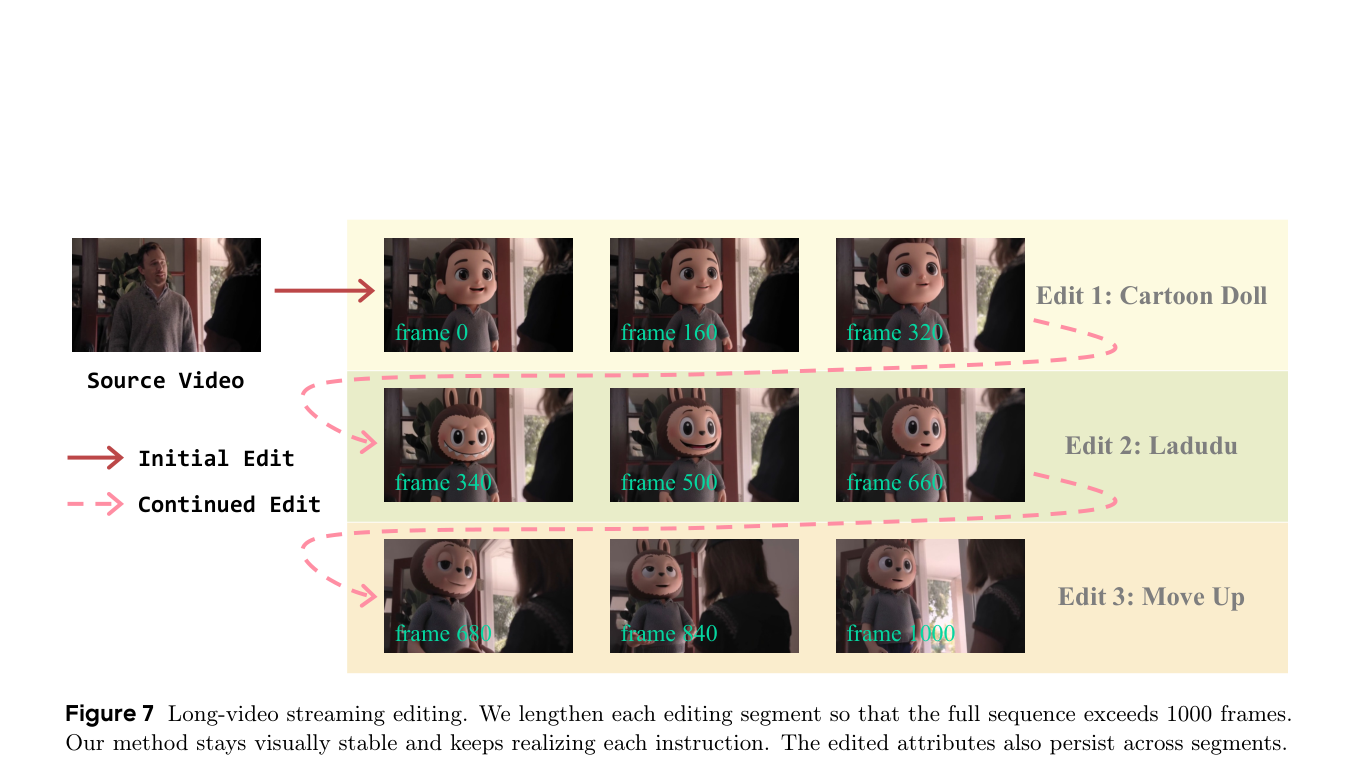
图 7 展示了超 1000 帧的长视频流式编辑。重点观察编辑属性如何跨段持续存在,以及画面在超长序列中保持视觉稳定。
实验如何设计?
- 构建 OOD 顺序编辑基准:200 个源视频,覆盖 5 类实体和 15 种编辑类型,每个视频进行 3 轮编辑链,形成 600 个编辑样本。
- 与 5 个基线对比:Helios-Base(无编辑能力)、Lucy-Edit(原地编辑)、SANA-Streaming(流式原地编辑)、Anchor-Forcing 和 Infinity-RoPE(均为 prompt 切换类方法,不接收源视频输入)。
- 自动评估采用 VBench 指标:Camera Motion、Motion Smoothness、Temporal Flickering、Dynamic Degree,评估生成视频的运动质量和时序稳定性。
- VLM-as-Judge 评估四项:编辑忠实度、视觉质量、场景身份保持、跨编辑连贯性,由视觉语言模型打分。
- 多轮编辑稳定性分析:记录每轮编辑后的编辑忠实度和美学质量,检验连续编辑下性能是否衰减。
- 超长视频测试:将每个编辑段拉长,使完整序列超过 1000 帧,验证方法在超长流上的稳定性。
关键结果与论文证据
- 在 VBench 自动指标上,InfinityEdit 在 Camera Motion 上取得 0.7654,领先第二名约 0.22,表明编辑后的视频保持了良好的镜头运动质量(第 10 页,表 1)。
- Temporal Flickering 达到 0.9660,为所有方法中最佳,说明编辑过程没有引入明显的时序闪烁(第 10 页,表 1)。
- Motion Smoothness 为 0.9833,接近最佳值 0.9869,编辑后的运动仍然流畅(第 10 页,表 1)。
- VLM-as-Judge 四项评估中,InfinityEdit 全部排名第一:Edit Faithfulness 3.828、Visual Quality 3.765、Preservation 3.815、Coherence 3.840(第 11 页,表 2)。
- 多轮编辑稳定性方面,编辑忠实度跨轮标准差仅 0.023,为所有方法中最低,三轮均约 3.8,说明连续编辑不会导致性能衰减(第 11 页,表 3)。
- 美学质量跨轮几乎不变(∆≈0),而基线方法下降 0.02–0.04,表明 InfinityEdit 在连续编辑下保持了画面质量(第 11 页,图 4)。
- 定性对比显示,prompt 切换类基线(Anchor-Forcing、Infinity-RoPE)虽然能切换风格,但无法保持源视频的场景身份;原地编辑基线在后续轮次分数上升具有误导性,因为反复重写导致内容漂移,使后续指令更易施加(第 12 页,图 5、图 6)。
- 超 1000 帧的长视频流式编辑测试中,InfinityEdit 保持视觉稳定,编辑属性跨段持续存在(第 14 页,图 7)。
阅读时需要注意
- 仅支持自然语言指令,不支持图像或视频参考作为编辑条件,限制了编辑表达的丰富性。
- 编辑边界处的切换可能仍然突兀,过渡不够平滑,在编辑指令到达的瞬间可能存在视觉跳变。
- Dynamic Degree 指标仅作参考,不反映编辑保真度,自动评估的全面性仍有待加强。
关联工作
- Helios 作为冻结骨干,提供了实时长视频生成能力,是 InfinityEdit 能够实现流式编辑的基础。
- VAP(Video-as-Prompt)提供了基础编辑类型集合,用于数据管线的指令设计。
- Wan2.2-I2V-A14B 在数据管线中用于合成目标视频,生成训练所需的三元组。
- Diffusion Forcing 的历史腐蚀策略被借鉴用于缓解 exposure bias。
- UltraVideo 作为源视频数据集,提供了多样化的视频素材。