快速导读:EchoWM 提出以相机意图为统一接口的可进入全模态世界模型,支持第一/第三人称连续导航并原生联合生成 720p 视频、环境声、音乐与语音。
EchoWM 的核心主张是:生成式视频模型与交互式世界模型之间的鸿沟,不在于模型规模,而在于缺少一个统一的、主体无关的交互接口。现有生成视频模型以提示词为主要交互方式,输出多为静音;世界模型虽然支持动作条件生成,但动作空间往往绑定特定主体或特定控制方案,难以跨域泛化。EchoWM 提出以相机意图(Camera Intent)作为统一接口,将离散命令与连续位姿都映射为共享的度量尺度相对 6-DoF 轨迹,从而让同一个模型支持第一人称与第三人称的连续导航。
更关键的是,EchoWM 把音频生成从附属功能提升为原生能力。模型不是先合成视频再配音,而是在生成过程中联合输出视频、环境声、音乐与语音,并通过渐进式训练策略保证跨模态同步。这使得 EchoWM 成为一个真正意义上的'可进入全模态世界模型'(Enterable Omnimodal World Model):用户可以持续遍历一个生成环境,同时获得视觉与听觉反馈。
英文题目:EchoWM: Open and Enterable Omnimodal World Models
论文出处:arXiv 每日论文精选 · arXiv:2608.23189
原始论文:PDF / 论文页面
这篇论文解决什么问题?
生成视频模型近年来迅速演变为音视频媒体引擎,但用户交互仍以提示词为主。用户输入一段文字,模型输出一段视频,交互是单向的、一次性的。这种范式无法支持'走进去'的体验:用户无法在生成的世界中持续导航、回头查看、改变视角。
世界模型试图反转这一关系:模型接收连续的动作输入,生成相应的未来状态。但现有世界模型面临两个突出问题。第一,交互接口不统一:有的系统绑定键盘离散命令,有的绑定特定主体的动作空间,有的依赖显式相机轨迹,用户在不同系统之间无法迁移操作经验。第二,大多数世界模型输出静音视觉,或者将音频作为后处理步骤,无法保证音视频在时间上的严格同步。
EchoWM 的研究动机正是填补这一空白:能否设计一个统一的交互接口,既支持离散命令又支持连续位姿,既支持第一人称又支持第三人称,同时原生生成同步音频?这不仅是工程问题,更是一个表示学习问题——如何让模型理解'相机意图'这一抽象概念。
核心创新
- 提出可进入全模态世界建模设定,联合连续导航与视频、环境声、语音的原生生成,支持第一/第三人称交互与多轮续写
- 提出统一相机意图接口,将异构离散命令与连续位姿映射为共享相对 6-DoF 轨迹,以数据集级度量校准与相对 UCPE 提供一致几何条件
- 构建能力对齐的世界数据引擎,融合内部游戏录屏、互联网游戏视频、UE 仿真与通用互联网视频,组织为 AV-rich、control-clean 与 balanced 三阶段混合数据
- 提出渐进式训练策略:AV-CPT 建立音视频先验,Action-SFT 冻结骨干仅训练轨迹分支,Joint-FT 低学习率联合微调,自回归后训练适配自生成历史
- 将音频-视觉 Teacher Forcing 与短/长时程 Self-Gradient Forcing 结合,实现因果流式生成与少步采样,并以 sink-plus-FIFO 缓存支持长时程推理
方法概览
将离散命令与连续位姿映射到共享的度量尺度相对 6-DoF 轨迹,经数据集级全局尺度校准后,通过相对 UCPE 分支注入视频自注意力;采用四阶段渐进训练(AV-CPT、Action-SFT、Joint-FT、自回归后训练)实现同步音视频生成与长时程交互。
- 相机意图接口(Camera Intent Interface):EchoWM 将用户输入统一为相机意图,包括离散命令(如前进、左转)和连续位姿(如 6-DoF 轨迹)。所有输入都被转换为以初始相机帧为参考的相对 6-DoF 轨迹,形成事件流。这一设计使模型无需区分输入来源,只需理解统一的几何条件。
- 数据集级全局尺度校准:不同数据源的位姿幅度差异巨大。论文发现 action-clean 子集的位移幅度 mode 为 4.5、median 为 12.7,而 AV-rich speech-present 子集 mode 仅 0.5、median 仅 3.9。如果对每个数据源独立归一化,会破坏跨源的一致性。EchoWM 采用数据集级稳健百分位尺度,将所有轨迹映射到统一的度量尺度。
- 相对 UCPE 注入:EchoWM 采用统一相机位置编码(UCPE)的相对射线分量,将相对相机几何直接引入视频自注意力。与 LingBot-World 使用 AdaLN 特征调制不同,UCPE 直接作用于注意力机制,提供更强的几何约束。音频流不接收直接轨迹条件,而是通过音视频交叉注意力间接获得空间信息。
- 四阶段渐进训练:第一阶段 AV-CPT 在 AV-rich 数据上建立联合音视频先验;第二阶段 Action-SFT 冻结骨干网络,仅训练轨迹条件分支,避免破坏已学到的音视频表示;第三阶段 Joint-FT 在平衡高质量子集上以低学习率联合微调全部参数;第四阶段自回归后训练适配自生成历史,使模型能够处理多轮续写。
- Self-Gradient Forcing 扩展:EchoWM 将 Self Gradient Forcing 从短时程扩展到长时程音视频流式生成。在自生成 rollout 上训练时,模型通过前向重建因果表示来恢复梯度,避免自回归误差累积导致的训练不稳定。
- Sink-plus-FIFO 缓存策略:长时程推理面临 KV 缓存无限增长的问题。EchoWM 采用注意力汇点(sink)加先进先出(FIFO)缓存,保留固定前缀与最近上下文,在有限内存下支持长时程生成。
- DMD 蒸馏:通过分布匹配蒸馏将多步扩散生成器蒸馏为少步采样器,EchoWM-Flash 实现四步因果流式生成,大幅降低推理成本。
- 世界数据引擎:融合四种数据源——内部游戏录屏(有原生游戏音频和动作日志)、互联网游戏视频(有自然音频和交互运动)、UE 仿真(有可靠位姿但无音频)、通用互联网视频(有跨域外观)。共享管线构建同步片段、过滤标注、恢复度量位姿,形成 AV-rich、control-clean 和 balanced 三种混合数据。
逐图理解论文
失败案例与直觉
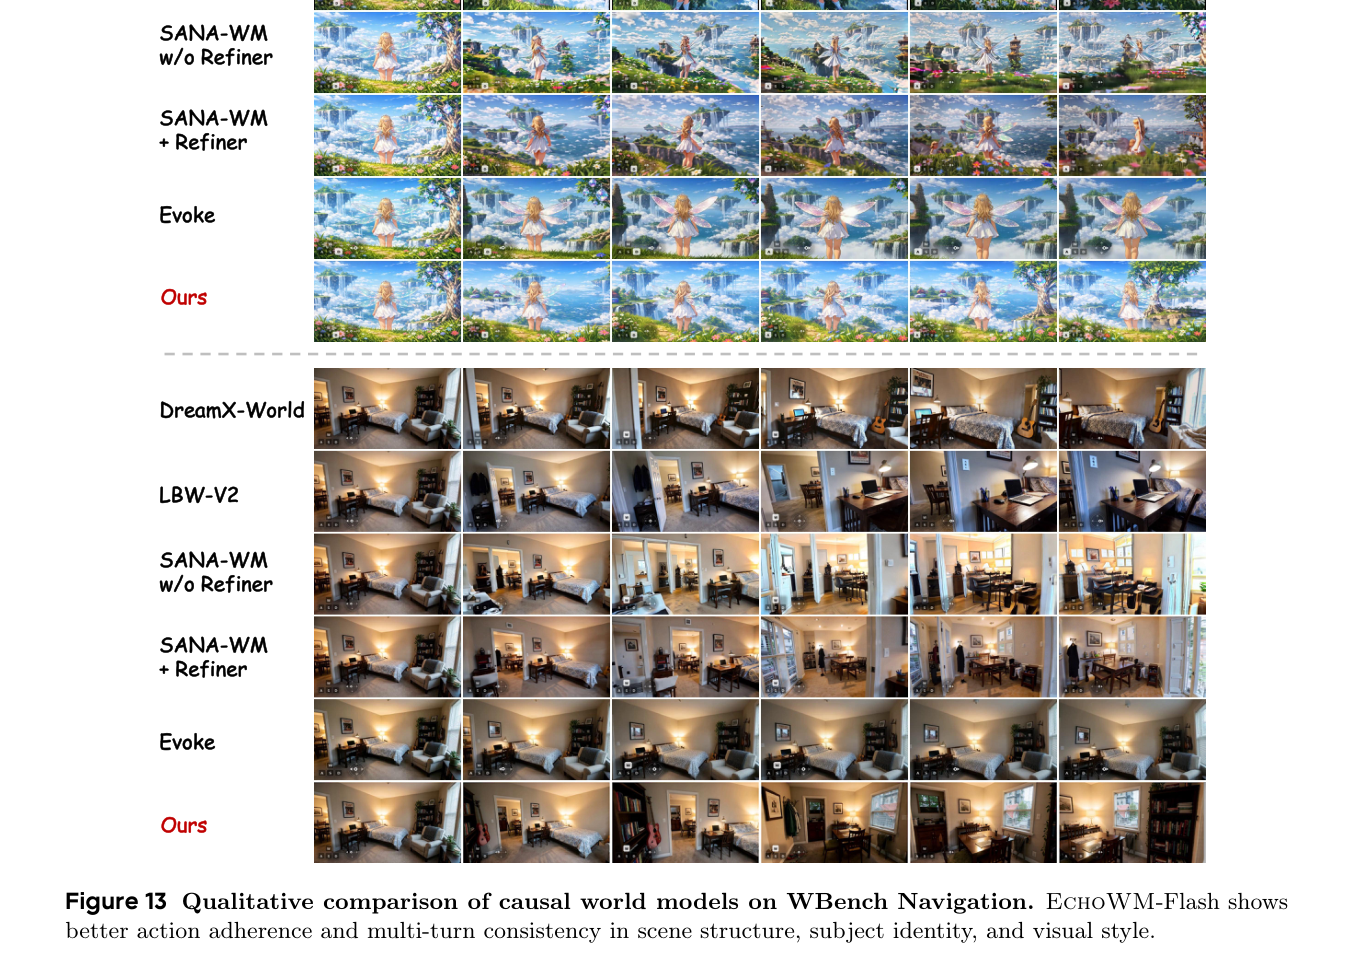
WBench Navigation 的定性对比展示了 EchoWM-Flash 在动作遵循与多轮一致性上的优势。注意观察场景结构、主体身份与视觉风格在多轮交互中的保持程度。
研究缺口
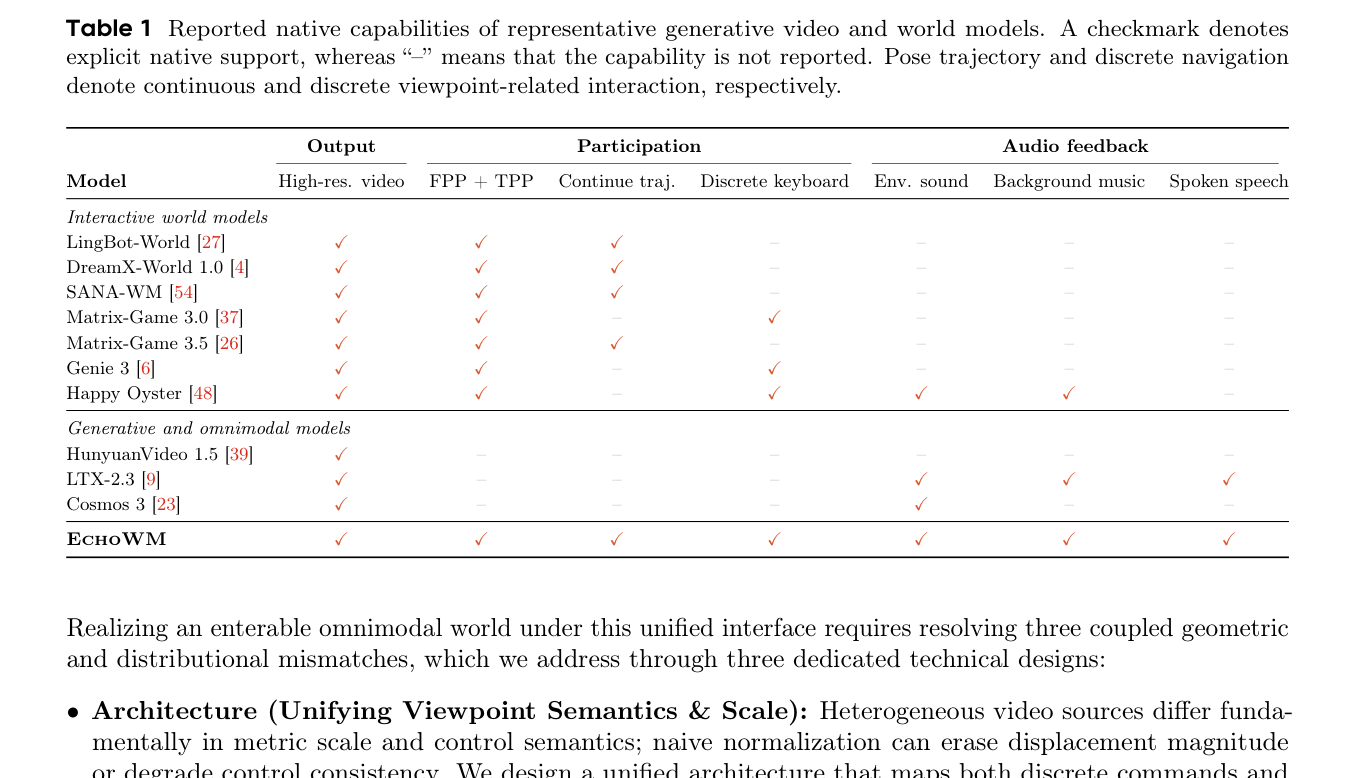
问题的根源在于交互接口。生成视频模型以提示词为主,世界模型虽然支持动作条件生成,但动作空间往往绑定特定主体或特定控制方案。更关键的是,大多数系统把音频当作后处理步骤,无法保证声音与画面在时间上严格同步。EchoWM 的核心判断是:缺少一个统一的、主体无关的交互接口,以及原生同步音频生成能力。
核心贡献与验证
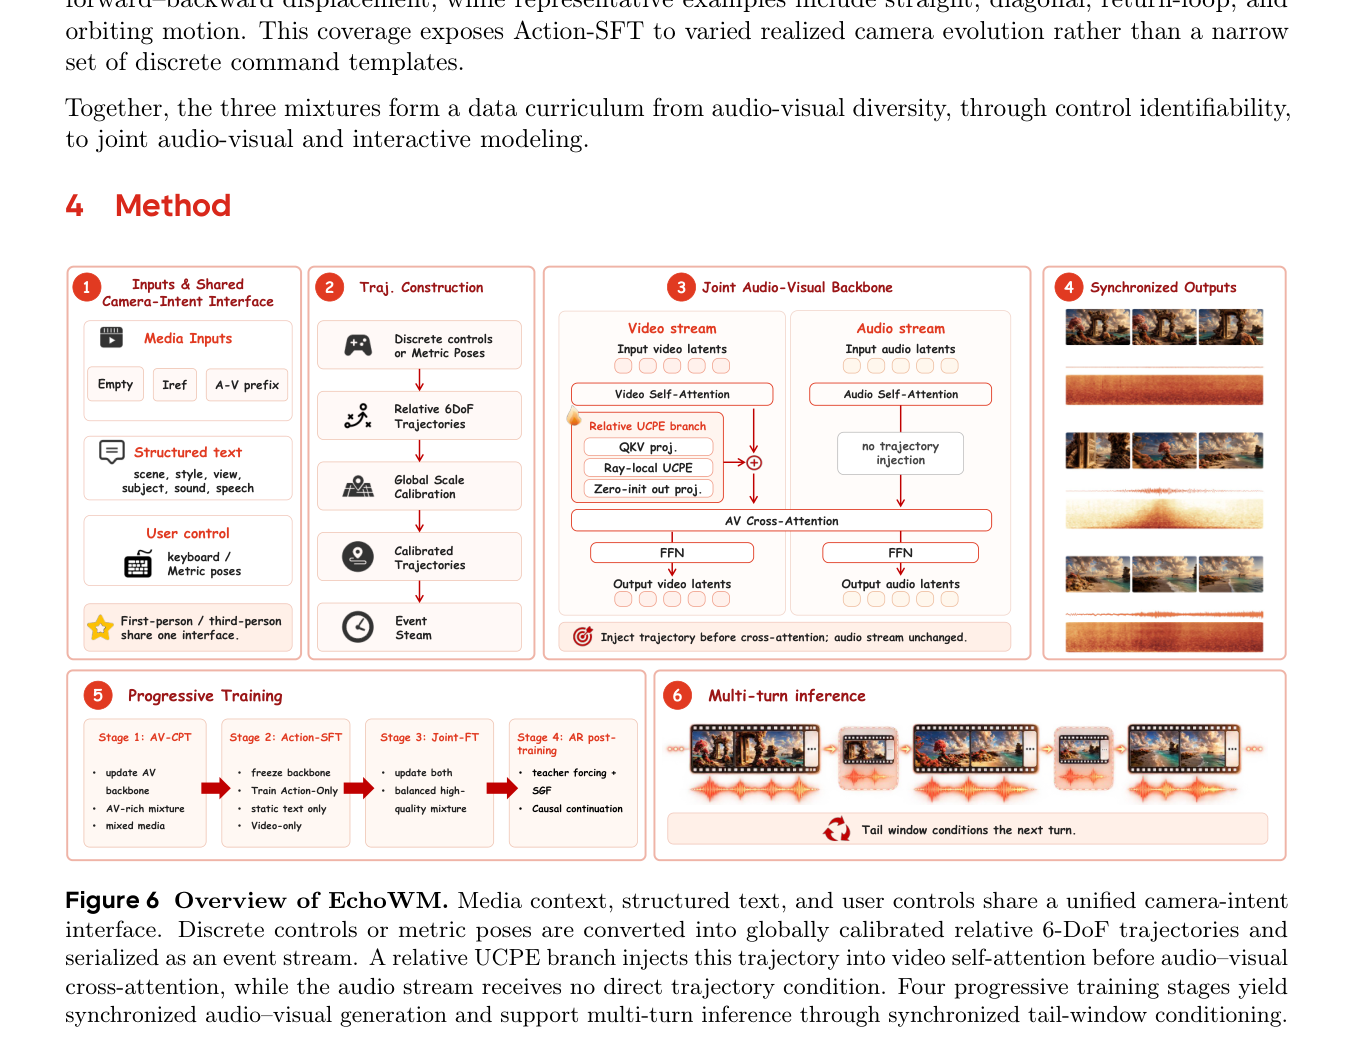
EchoWM 的架构总览图展示了相机意图接口的核心设计:离散控制或度量位姿被转换为全局校准的相对 6-DoF 轨迹,通过相对 UCPE 分支注入视频自注意力,音频流不接收直接轨迹条件。注意四个训练阶段的递进关系。
最强结论
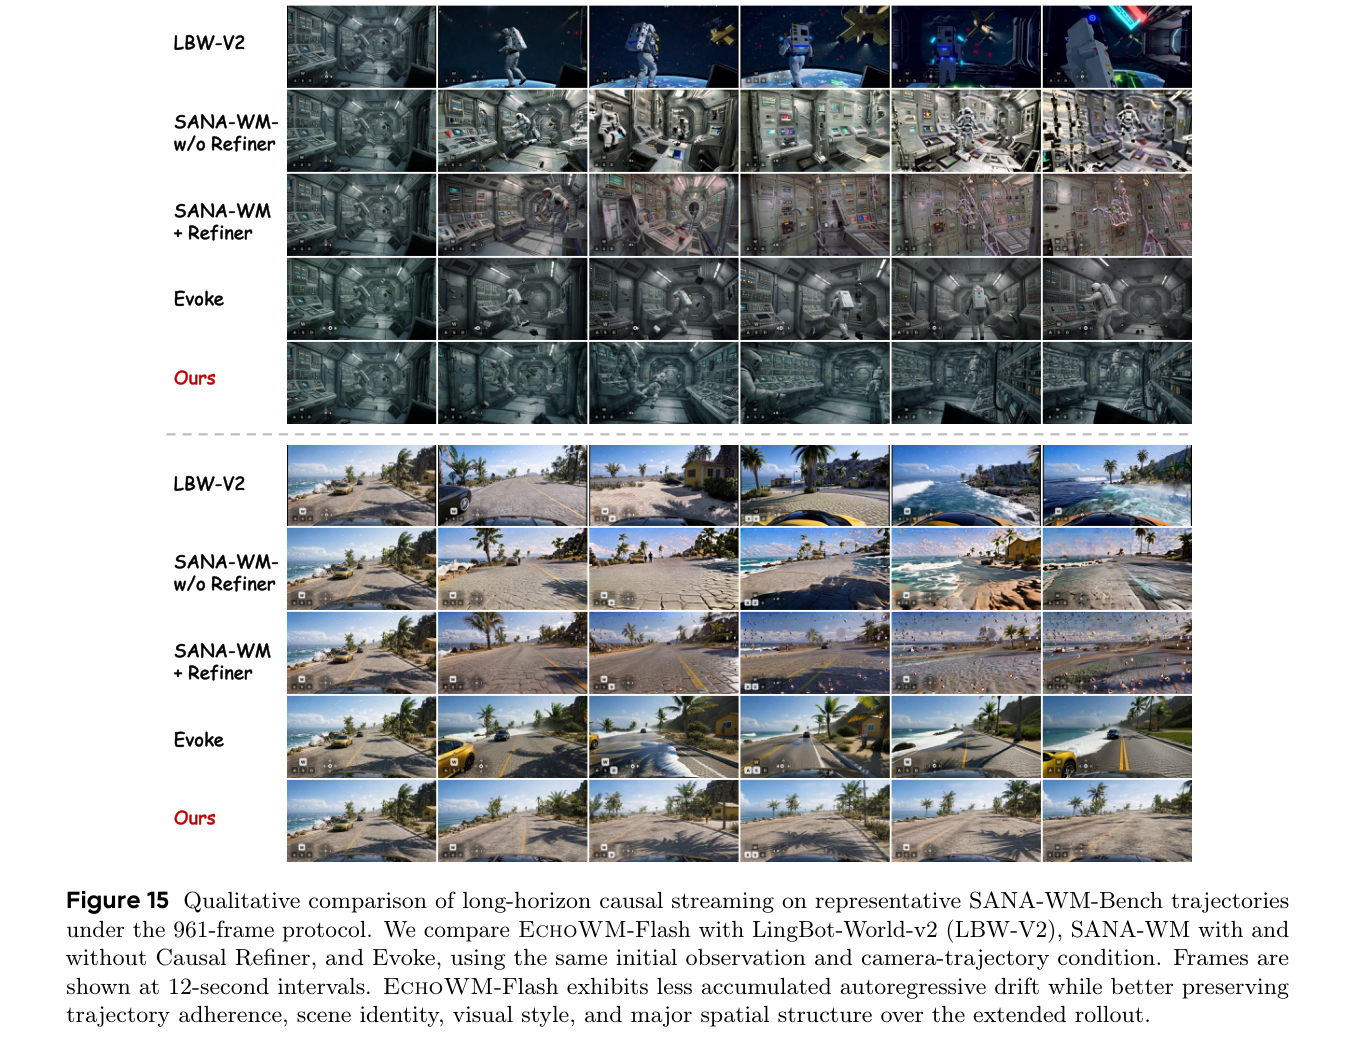
长时程因果流式生成的定性对比展示了 EchoWM-Flash 在 961 帧协议下的表现。注意观察累积自回归漂移的差异,以及轨迹遵循、场景身份与空间结构的保持。
实验如何设计?
- WBench Navigation 158 案例对比:评估导航能力,包括动作遵循、多轮一致性、场景结构保持等维度,与 LingBot-World-v2、HappyOyster 等因果世界模型对比。
- SANA-WM-Bench 短时程协议:使用每条轨迹前 241 帧,评估相机精度(旋转误差、相对平移误差、相机运动一致性误差)与视觉质量。
- SANA-WM-Bench 长时程协议:使用完整轨迹与 961 帧协议,评估重访一致性(same-pose pairs)与时间质量退化(∆IQ)。
- 200 案例成对用户研究:与 LingBot-World-v2 和 HappyOyster 进行成对比较,评估总体偏好、语义跟随、时空一致性、视觉美学、初始世界一致性与运动质量。
- 第一/第三人称跨域泛化定性评估:验证同一相机意图接口在不同视角和不同域之间的泛化能力。
- 3D 重建空间一致性验证:通过从生成视频重建 3D 结构,验证生成世界的空间一致性。
关键结果与论文证据
- EchoWM 在 WBench Navigation 上排名第一(Table 3, p.21),在动作遵循与多轮一致性方面优于对比方法。
- 用户研究中,EchoWM 对 LingBot-World-v2 的总体偏好为 46.50%,对 HappyOyster 为 63.13%(Table 7, p.29)。
- 对 HappyOyster 的时空一致性优势为 57.69%,视觉美学优势为 52.88%(Table 7, p.29)。
- 对 LingBot-World-v2 的初始世界一致性中,both-good 判断占 62.36%,说明两者在该维度质量相近;运动维度 both-bad 判断占 41.00%,说明运动质量是共同短板(Table 7, p.29)。
- 长时程生成中,EchoWM-Flash 的累积自回归漂移更小,轨迹遵循、场景身份与视觉风格保持更好(Figure 15, p.28)。
- 语义跟随在用户研究中仍为相对弱点,尤其在与 HappyOyster 的对比中(Table 7, p.29)。
- control-clean 混合数据的轨迹覆盖 P90 范围为 42.6(Figure 5, p.9),表明 Action-SFT 阶段接触到了多样化的相机运动模式。
- 游戏视频数据中第三人称占 79.7%,第一人称占 20.3%;语音存在子集仅占 12.2%(Figure 3, p.7),说明语音数据相对稀缺,是训练中的挑战。
阅读时需要注意
- 相机意图接口范围限于导航与视角相关控制,不支持攻击、跳跃、物体操作等语义动作。
- 语义跟随在用户研究中仍为相对弱点,模型对复杂语义指令的遵循能力有限。
- 动作日志与相机轨迹保留为不同信号,当前模型仅使用相机轨迹,原生动作流尚未用于交互建模,可能丢失了部分交互信息。
- UE 渲染数据无音频流,作为 missing-audio 示例处理而非语义静音,音频生成的泛化能力可能受限于数据覆盖。
关联工作
- LingBot-World 使用 Plücker 坐标作为相机条件,通过 AdaLN 特征调制注入;EchoWM 采用相对 UCPE 直接注入注意力,提供更强的几何约束。
- SANA-WM 的可控世界生成模型与稳健标注原则被 EchoWM 沿用,并在 SANA-WM-Bench 上进行对比。
- Genie 3 支持 720p 环境实时探索,但采用离散键盘导航;EchoWM 将离散命令与连续位姿统一为相机意图。
- Cosmos 3 是面向具身智能的全模态世界模型,融合视频、音频、语言与动作;EchoWM 的定位更偏向交互式媒体生成。
- OmniForcing 将联合音视频扩散转换为流式自回归生成器;EchoWM 在此基础上结合 Self Gradient Forcing 实现长时程流式生成。
- ViPE 被用作长序列度量位姿恢复的优化框架,结合 VGGT-Omega 与 MoGe-2 后端,为数据引擎提供可靠的位姿标注。