快速导读:通过合成几何图形数据集和线性探针,分析 Qwen3-VL-4B 在不同深度上如何编码视觉信息,揭示其结合真实视觉推理与语言捷径策略的混合行为。
视觉语言模型(VLM)在多模态任务上的表现日益强劲,但一个根本性问题始终悬而未决:当模型正确回答“红色圆在蓝色方块左边吗”这类问题时,它究竟是在真正理解视觉关系,还是在利用语言先验和统计捷径?本文以 Qwen3-VL-4B 为对象,通过受控合成几何图形数据集和逐层线性探针,系统拆解了这一黑箱。
研究的核心发现是:VLM 的关系推理行为呈现混合策略——对计数和箭头方向等任务,模型确实依赖视觉输入;但对隐式位置等任务,掩码掉关键视觉信息后准确率反而上升,暴露出模型在利用内部统计规律而非视觉内容作答。这一发现对当前以准确率为中心的评估范式提出了根本性质疑。
英文题目:Investigating Relational Reasoning in VLMs
论文出处:arXiv 每日论文精选 · arXiv:2608.23518
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视觉数据包含实体、属性及关系等基本属性。近年来,LLaVA、GPT-4V、Gemini 等 VLM 在多模态任务上表现优异,但 Hou et al. (2024) 指出 VLM 可能依赖捷径而非真正的关系理解。CLEVR(Johnson et al., 2017)、GQA(Ainslie et al., 2023)等诊断基准也揭示了模型在关系中心查询上的系统性弱点。
现有评估方法存在一个关键盲区:高准确率可能掩盖理解的脆弱性。模型可能通过语言线索、选项分布偏差或训练数据中的统计规律来“猜”答案,而非真正解析视觉场景中的关系结构。这使得我们需要一种能够区分“真理解”与“捷径依赖”的诊断工具。
本文的研究动机正是填补这一空白:通过精确控制视觉刺激的合成数据集,将识别任务与关系任务分离,并利用掩码消融制造分布偏移,从而暴露模型在视觉信息缺失时的真实行为。
核心创新
- 提出受控合成几何图形数据集,精确分离识别任务与关系任务,并生成掩码变体以进行因果视觉依赖测试。
- 结合线性分类器探针与掩码消融,在架构层面分析 VLM 内部信息编码的动态。
- 区分 Overall/Correct/False Accuracy 三类探针准确率,揭示正负样本解码的不对称性。
方法概览
构建包含 5424 张简单几何图形图像的合成 2D 基准,实体为 2–5 个几何形状,关系分为显式(箭头)和隐式(仅位置);对每张图生成掩码变体(随机移除一个实体或关系)以测试因果视觉依赖;使用多项选择提示评估 Qwen3-VL-4B;提取 36 层注意力图(5 步 × 32 头,均值池化后)训练逐层逻辑回归线性探针,分析各层可解码信息。
- 构建包含 5424 张简单几何图形图像的合成 2D 基准。实体为 2–5 个几何形状,关系分为显式(箭头)和隐式(仅位置)两类。实体放置采用 rejection sampling 避免重叠,确保视觉刺激的纯净性。
- 对每张图像生成掩码变体:随机移除一个实体或关系后重新渲染。这一操作制造了 distribution shift,使模型无法依赖完整的视觉线索,从而测试其因果视觉依赖。
- 使用多项选择提示评估 Qwen3-VL-4B,查询类型覆盖计数、形状、颜色、形状与颜色组合绑定、箭头存在性、箭头方向、隐式位置等七类任务。
- 提取模型 36 层注意力图(5 步 × 32 头,均值池化后),训练逐层逻辑回归线性探针,分析各层可解码信息。线性探针方法源自 Alain & Bengio (2018),用于诊断中间层表征的可线性解码性。
- 区分三类探针准确率:Overall Accuracy(所有样本)、Correct Accuracy(模型答对的样本)、False Accuracy(模型答错的样本),以揭示正负样本解码的不对称性。
- 对于复杂查询,将其分解为多个子标签分别训练探针,结果取平均。这一处理方式本身是一个局限,可能掩盖子任务间的差异。
逐图理解论文
研究空白与核心区分
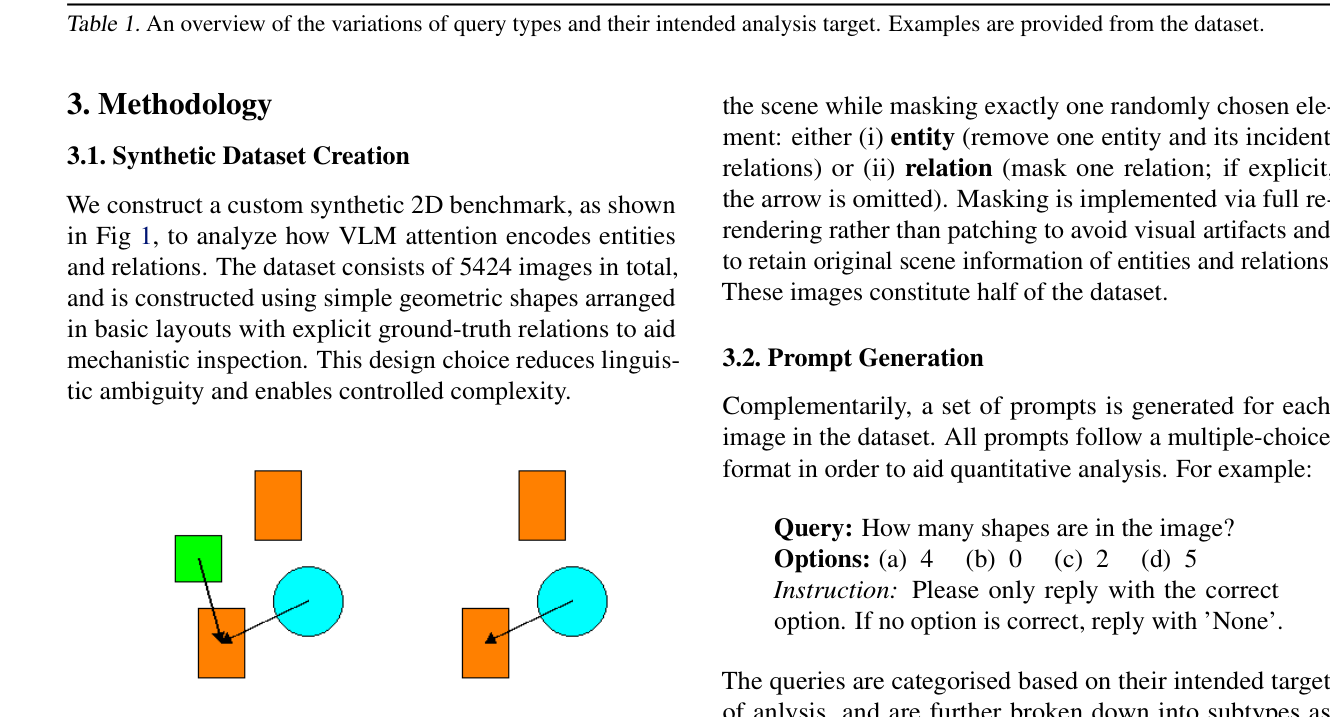
该表展示了七类查询类型的变体及其分析目标。注意显式关系(箭头)与隐式关系(仅位置)的区分,这是后续消融实验揭示捷径依赖的关键设计。
方法与贡献
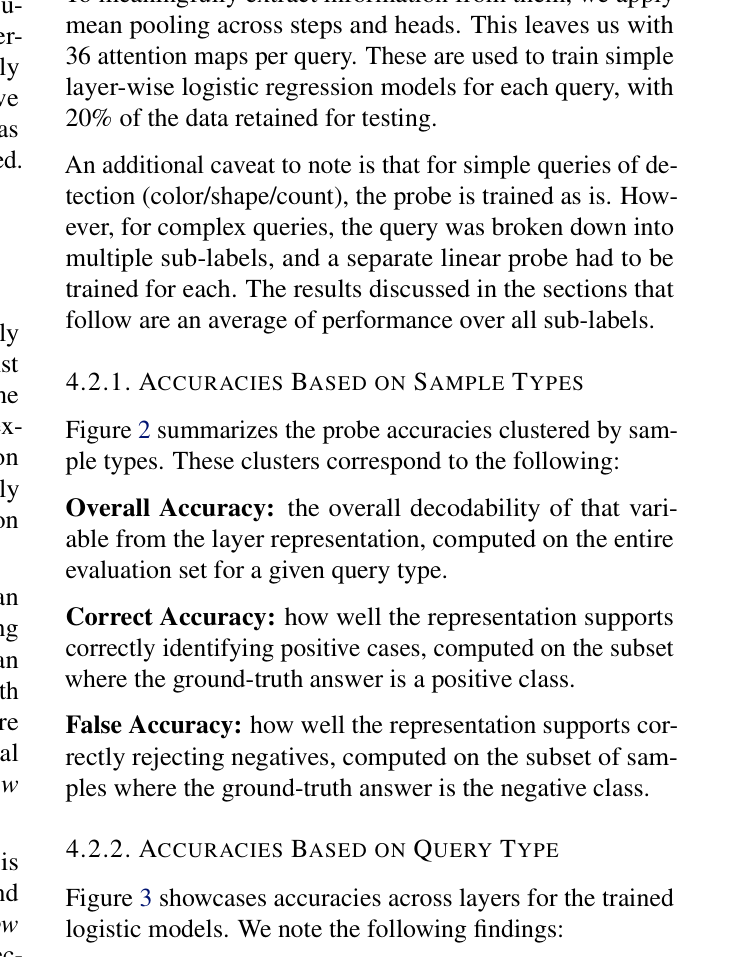
该图展示各查询类型探针准确率随层数的变化。箭头方向接近随机水平且跨层无变化,是语言捷径依赖的关键证据。
Figure 1
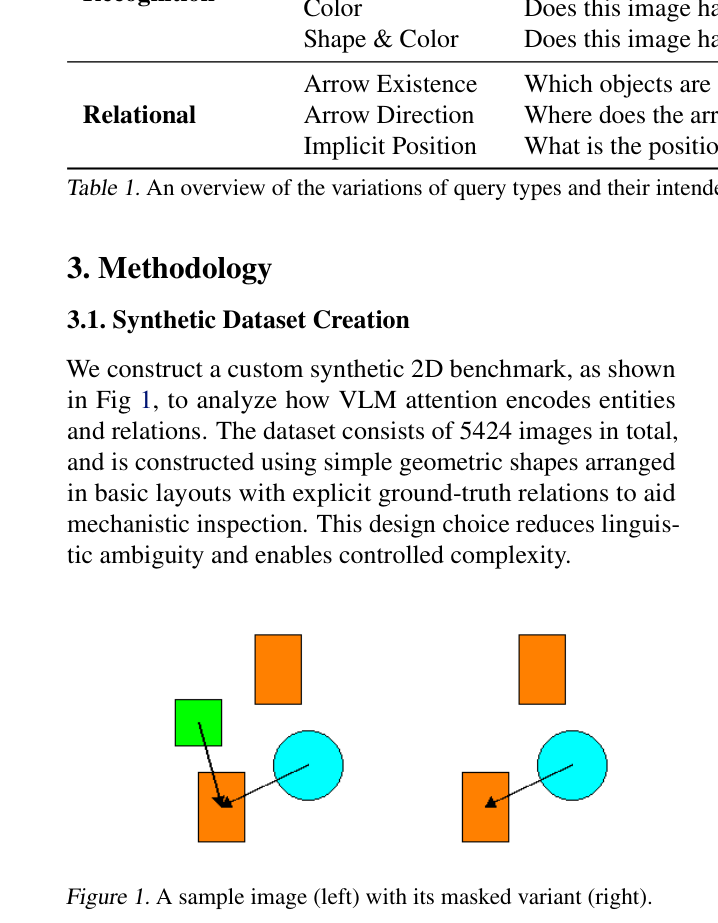
左侧为完整图像,右侧为掩码变体。对比两图可以直观理解掩码操作如何移除视觉信息,以及这种移除对模型推理路径的潜在影响。
实验如何设计?
- 整体查询准确率评估:在未掩码的完整图像上测试模型对七类查询的准确率,建立基线表现。
- 线性探针分析:基于样本类型(Overall/Correct/False)和查询类型两个维度,分析逐层探针准确率的变化趋势。
- 掩码消融实验:对每类查询,比较未掩码与掩码变体上的准确率差异,量化视觉依赖程度。
- 所有实验均在 Qwen3-VL-4B 单一模型上进行,未涉及跨模型验证。
关键结果与论文证据
- 未掩码准确率整体较高(80–99%),但掩码测试暴露了显著的脆弱性。计数任务在掩码后下降 23.4 个百分点,箭头方向下降 17.0 个百分点,表明这两类任务确实依赖视觉输入。
- 隐式位置任务在掩码后准确率反而上升 4.3 个百分点,直接与视觉推理的预期相矛盾。这表明模型在该任务上的答案可能来自内部统计规律而非视觉内容。
- 形状与颜色组合绑定任务在掩码后仅下降 0.2 个百分点,颜色任务甚至上升 0.6 个百分点,说明这些识别类任务对视觉缺失不敏感,模型可能依赖语言先验作答。
- 线性探针分析显示,形状正样本的探针准确率高于颜色,说明几何线索比色彩线索更易从注意力表征中提取。
- 箭头方向的探针准确率接近随机水平且跨层无变化,表明注意力特征无法为方向判断提供强信号,模型可能通过其他路径(如语言捷径)完成该任务。
- Correct 与 False 样本的探针准确率存在不对称性:模型答错的样本中,探针仍能解码出部分信息,说明错误并非源于表征缺失,而可能源于下游决策层的偏差。
- 计数和箭头方向的大幅下降揭示了一种混合策略:视觉与内部偏置结合,当分布偏移时偏置干扰感知,导致幻觉。
阅读时需要注意
- 合成数据集仅含简单几何图形,结论可能无法推广到自然图像或复杂场景。
- 线性探针只能捕获线性可解码信息,无法检测非线性依赖关系,可能低估模型的真实表征能力。
- 仅评估 Qwen3-VL-4B 单一模型,缺乏跨模型泛化性验证,无法判断该行为是模型特例还是 VLM 的普遍现象。
- 复杂查询需分解为多个子标签分别训练探针,结果取平均,可能掩盖子任务间的差异。
关联工作
- Hou et al. (2024) 指出 VLM 可能依赖捷径而非真正的关系理解,是本文动机的直接来源。
- CLEVR(Johnson et al., 2017)和 GQA(Ainslie et al., 2023)是关系推理诊断的经典基准,揭示了模型在关系中心查询上的系统性弱点。
- ChartQA(Masry et al., 2022)要求视觉与逻辑推理的结合,是关系推理在图表领域的延伸。
- Alain & Bengio (2018) 提出的线性分类器探针方法,为本文的逐层诊断提供了方法论基础。