快速导读:GaussVid将稀疏3DGS修复建模为帧条件重建问题,通过相机注入模块和渐进式训练策略,利用首尾帧条件的视频扩散模型恢复中间帧,消除伪影并提升多视图一致性。
稀疏视图下的3D Gaussian Splatting(3DGS)重建面临一个根本性困境:观测不足导致几何歧义,模型倾向于在欠约束区域生成浮动物(floaters)、模糊结构和几何失真。传统正则化方法对噪声敏感且提升有限,而现有扩散先验要么缺乏跨视图一致性(2D图像先验),要么依赖易错的几何估计(基于VGGT的视频先验)。GaussVid的核心洞察是:稀疏3DGS的伪影帧可以被视为一段视频中受损的中间帧,而首尾干净帧可以作为可靠的锚点条件。
论文将稀疏3DGS修复形式化为帧条件重建问题,以Wan2.1-VACE为骨干,引入Plücker Token Encoder提取几何先验、Dual-Stream Camera Injection注入3D上下文、以及Difficulty-Aware Curriculum Learning稳定训练。在DL3DV基准和Zip-NeRF跨数据集测试中,GaussVid一致地消除了浮动物和结构失真,同时保留了细粒度细节。
英文题目:GaussVid: Sparse-View Gaussian Splatting with 3D-Aware Video Diffusion Priors
论文出处:arXiv 每日论文精选 · arXiv:2608.21849
原始论文:PDF / 论文页面
这篇论文解决什么问题?
3DGS在稠密多视图监督下表现优异,但当输入视图数量减少到稀疏级别时,优化过程缺乏足够的几何约束。未被充分观测的区域会出现半透明浮动物、边缘模糊和结构扭曲,这些伪影不仅影响视觉质量,更破坏了场景的几何一致性。
现有解决方案大致分为三类。第一类是优化类正则化方法,如FSGS利用单目深度估计器提供额外约束,CoR-GS通过双3D高斯场联合训练实现共正则化。这些方法对深度估计噪声敏感,在复杂场景中提升有限。第二类是2D扩散先验方法,如DiFix3D逐帧增强渲染结果。虽然单帧感知质量较高,但缺乏跨视图一致性约束,容易引入几何错位和幻觉纹理。第三类是视频扩散先验方法,如4DSloMo和GSFIXER。视频模型天然具有时间一致性,但4DSloMo缺乏显式3D感知,而GSFIXER依赖VGGT估计的几何条件——在稀疏视图下,这种几何估计本身噪声大、不可靠,导致修复效果受限。
关键的研究空白在于:如何让视频扩散模型在保持时间一致性的同时,获得可靠的3D感知能力,而不依赖易错的外部几何估计。GaussVid的回答是:将相机射线信息直接注入视频扩散模型,让模型自己学习如何利用几何先验。
核心创新
- 将稀疏3DGS修复形式化为帧条件重建问题,并构建大规模配对数据集(约5000场景,受控3DGS优化模拟伪影)
- 提出Plücker Token Encoder,将Plücker坐标分解为moment和direction双流,通过cross-gating融合提取几何先验
- 提出Dual-Stream Camera Injection,采用噪声不变调制和非对称联合注意力,使视频token可查询3D上下文而相机token免受噪声污染
- 提出Difficulty-Aware Curriculum Learning,根据采样间隔n动态调整训练难度,结合渐进式latent重建损失稳定微调
方法概览
将稀疏3DGS修复形式化为帧条件重建问题:以首尾干净帧为锚点,中间伪影帧为待修复源。构建大规模配对数据集(约5000个DL3DV场景,通过受控3DGS优化模拟伪影)。基于Wan2.1-VACE,引入Plücker Token Encoder(分解moment和direction流并通过cross-gating融合)和Dual-Stream Camera Injection(噪声不变调制+非对称联合注意力),并采用Difficulty-Aware Curriculum Learning结合渐进式latent重建损失进行训练。
- 问题形式化:将稀疏3DGS修复建模为帧条件重建。以首尾干净帧为锚点条件,中间伪影帧为待修复源,利用视频扩散模型的帧插值能力恢复中间帧。这种形式化将3D修复问题转化为视频生成问题,充分利用了预训练视频模型的时间一致性先验。
- 数据集构建:从DL3DV数据集构建约5000个场景的配对数据。通过受控3DGS优化模拟稀疏视图下的伪影,生成'伪影帧-干净帧'配对。这种数据构建方式确保了训练数据的多样性和真实性。
- Plücker Token Encoder:将6维Plücker坐标分解为moment流和direction流,分别编码后通过cross-gating fusion交互。这种分解设计让模型能够分别学习射线的位置信息和方向信息,cross-gating机制则允许两流之间进行选择性信息交换,提取更鲁棒的几何先验。
- Dual-Stream Camera Injection:采用噪声不变调制和非对称联合注意力。视频token可以查询相机token获取3D上下文,但相机token不查询视频token,从而保护相机信息免受扩散噪声的污染。这种非对称设计参考了EasyControl的双流机制,但针对扩散模型的噪声特性进行了适配。
- Difficulty-Aware Curriculum Learning:根据采样间隔n动态调整训练难度。小间隔(易)样本先训练,大间隔(难)样本后训练,实现从易到难的课程学习。同时结合渐进式latent重建损失,在训练过程中逐步从latent空间监督过渡到感知质量监督。
- 参数高效微调:冻结Wan2.1-VACE的预训练权重,仅训练新增的相机注入模块和适配层。训练时限制timestep区间t∈[0.0, 0.48],与3DGS伪影的结构严重程度匹配。
逐图理解论文
失败案例与直觉
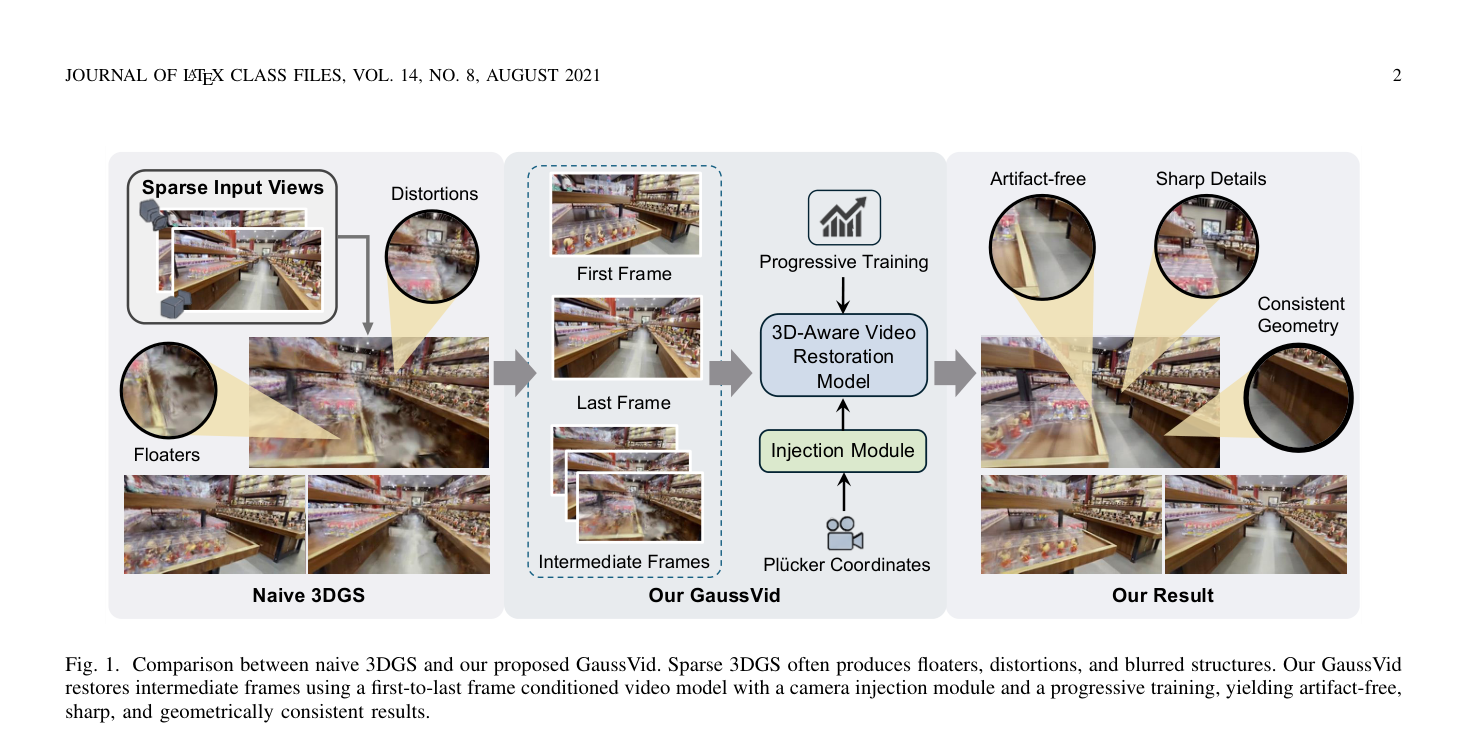
图1对比了朴素3DGS和GaussVid的结果。左侧稀疏3DGS渲染显示明显的浮动物、模糊结构和几何失真,右侧GaussVid修复后的结果干净锐利。重点观察绿色和红色标注区域,可以看到浮动物被完全去除,同时保留了细粒度纹理。
研究空白
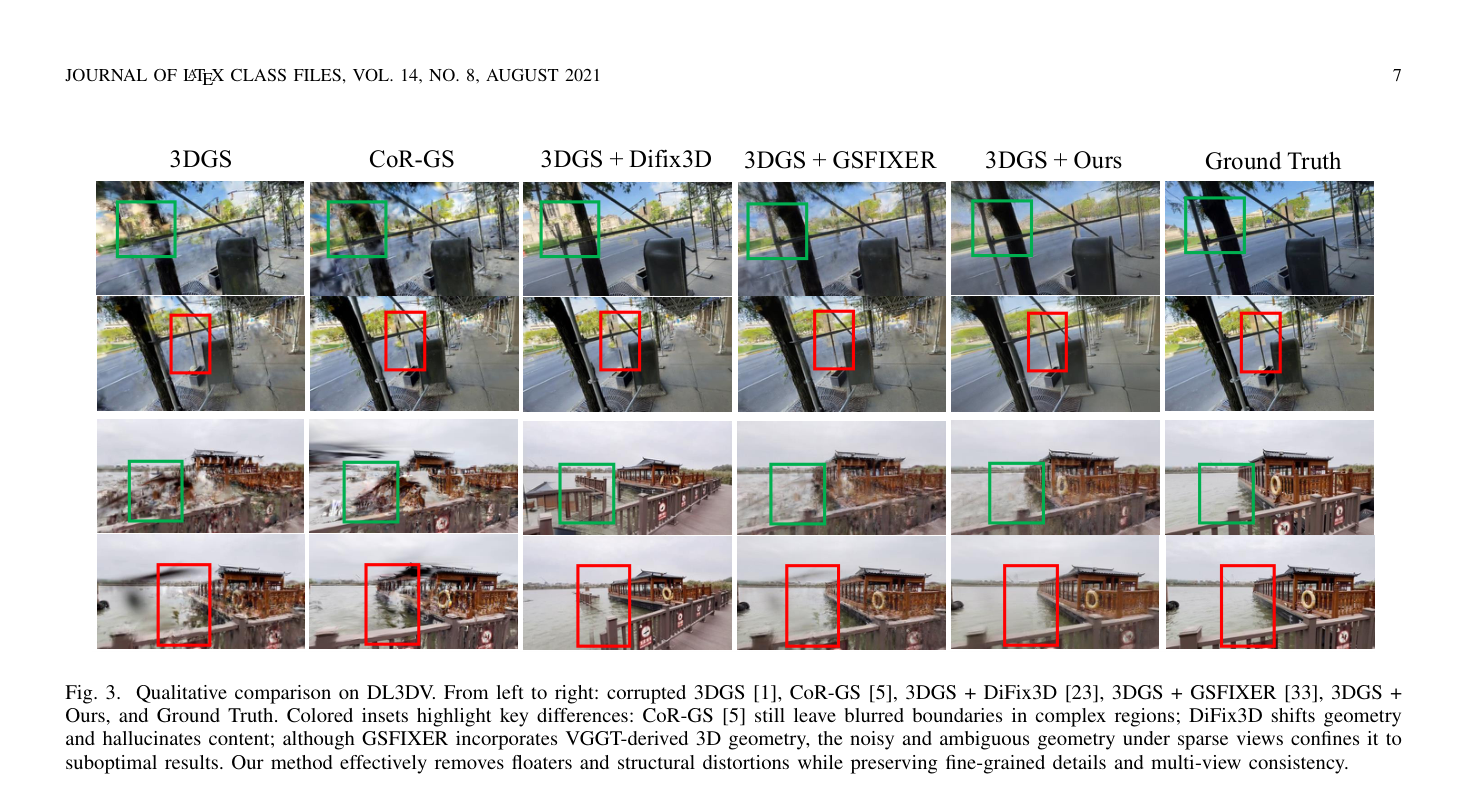
图3是DL3DV上的定性对比。从左到右依次为损坏的3DGS、CoR-GS、DiFix3D、GSFIXER、GaussVid和Ground Truth。注意DiFix3D引入了几何错位和幻觉纹理,GSFIXER受限于噪声几何,而GaussVid最接近真值。
核心贡献与方法
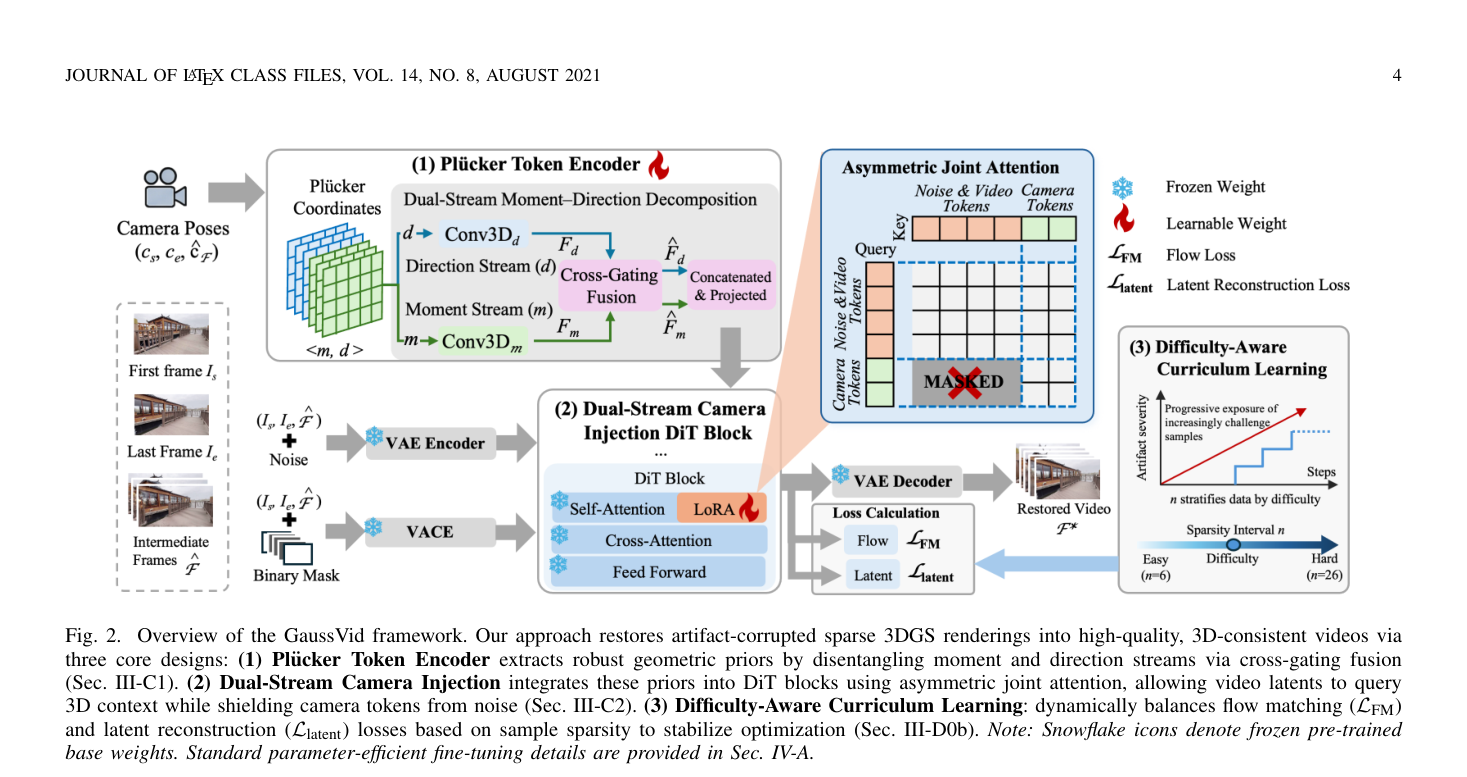
图2展示了GaussVid的完整框架。从伪影帧输入到干净帧输出,经过Plücker Token Encoder提取几何先验,Dual-Stream Camera Injection注入3D上下文,以及Difficulty-Aware Curriculum Learning控制训练。雪花图标表示冻结的预训练权重。
实验如何设计?
- DL3DV基准测试:500个评估片段,与FSGS、CoR-GS、DiFix3D、4DSloMo、GSFIXER五个基线对比。评估指标包括PSNR、SSIM和LPIPS。
- Zip-NeRF跨数据集泛化测试:4个室内场景,以Octree-GS为基础模型,在三个稀疏级别(n=6, 9, 12)上评估。
- 消融实验一:相机条件注入策略对比,包括无相机条件、早期latent融合、单体双流和分解交叉门控注入四种方案。
- 消融实验二:训练策略对比,包括shuffle基线、仅课程学习、仅渐进损失和两者结合。
- 消融实验三:适配策略对比,包括zero-shot骨干、vanilla LoRA和完整方法。
关键结果与论文证据
- 在DL3DV基准上,3DGS + GaussVid达到PSNR 22.74、SSIM 0.7291、LPIPS 0.3599(第7页),在PSNR和SSIM上优于所有基线。
- 在CoR-GS基础上应用GaussVid,PSNR达到22.80、SSIM 0.7474、LPIPS 0.3244(第7页),表明方法可以与不同基础模型组合。
- Zip-NeRF跨数据集测试中,在n=6/9/12三个稀疏级别上分别达到PSNR 21.99/21.84/21.16(第7页),一致优于对比方法。
- 相机条件消融显示,完整设计(PSNR 22.74)显著优于无相机条件(21.27)、早期latent融合(21.71)和单体双流(22.09)(第8页),验证了分解交叉门控注入的有效性。
- 训练策略消融显示,shuffle基线为21.50,加入课程学习提升至22.06,加入渐进损失提升至22.54,两者结合达到22.74(第9页),表明两个组件互补。
- 适配策略消融显示,zero-shot骨干仅20.56,vanilla LoRA为21.11,完整方法22.74(第9页),说明专门的适配设计至关重要。
- 定性结果(图3,第7页)显示,GaussVid有效去除浮动物和结构失真,而DiFix3D引入几何错位和幻觉纹理,GSFIXER受限于噪声几何估计。
- LPIPS指标上DiFix3D略优(0.2463 vs 0.3599),但这反映的是单帧感知锐度而非几何保真重建,论文对此有明确说明。
阅读时需要注意
- LPIPS略逊于DiFix3D,因为DiFix3D逐帧生成可以合成更锐利的感知纹理,但代价是几何一致性的损失。
- 训练数据仅从DL3DV构建,跨数据集泛化仅在Zip-NeRF室内场景验证,室外场景和更极端的稀疏级别尚未充分测试。
- 依赖Wan2.1-VACE-14B大模型,训练需要8块A800 GPU,计算资源需求高,限制了方法的可及性。
- GSFIXER仅发布推理代码,论文中的对比为忠实复现而非官方实现,可能影响对比的公平性。
关联工作
- FSGS和CoR-GS代表优化类正则化路线,通过深度估计或共正则化约束稀疏3DGS优化,但受限于深度估计的噪声。
- DiFix3D代表2D扩散先验路线,逐帧增强渲染结果,单帧质量高但缺乏跨视图一致性。
- 4DSloMo和GSFIXER代表视频扩散先验路线,具有时间一致性但缺乏可靠的3D感知。GSFIXER依赖VGGT几何估计,在稀疏视图下噪声大。
- Wan2.1-VACE作为骨干模型,提供了首尾帧条件视频生成能力,是GaussVid的基础。EasyControl的双流机制启发了非对称注意力设计。