快速导读:提出两阶段归一化仿射参数校正框架 SandwichQuant,在 PTQ 前后分别利用低维归一化仿射子空间进行预条件与残差校正,在不增加推理算子的情况下提升低比特量化模型性能。
低比特量化是 LLM 部署的核心手段,但在 W2A4KV4 这类极端设置下,PTQ 后的模型往往出现严重的精度崩塌。SandwichQuant 从一个看似简单的问题切入:在量化前后的可训练状态中,哪些参数子空间对校正最有效?作者将可训练状态分解为 Θ=(W,Φ,Ω),其中 Φ 是归一化仿射参数子空间(BN 的 γ,β 或 RMSNorm 的 γ),并通过匹配预算实验证明,这个极低维的子空间具有远超权重的校正杠杆。
基于这一观察,SandwichQuant 提出两阶段框架:先在一次性 PTQ 探针图上优化 Φpre,将仿射状态迁移回原始稠密 checkpoint 后从头重跑 PTQ;再冻结量化图,仅优化 Φpost 校正残差响应。整个过程不引入任何额外推理分支或算子,最终部署图与基座 PTQ 图完全一致。
英文题目:SandwichQuant: Which Parameters Matter Before and After Quantization?
论文出处:arXiv 每日论文精选 · arXiv:2608.24173
原始论文:PDF / 论文页面
这篇论文解决什么问题?
PTQ 是 LLM 部署的主流范式,因为它不需要重新训练,只需少量校准数据即可完成量化。但在权重 2 比特、激活 4 比特、KV 缓存 4 比特的联合量化下,现有 PTQ 方法的精度损失仍然严重。以 Qwen3-8B 为例,W2A4KV4 量化后 Avg6 准确率从全精度的约 70% 跌至 49.62,WikiText-2 困惑度飙升至 18.71。
现有校正方法大多关注权重本身、量化参数或重建目标。AWQ 通过激活感知缩放保护重要权重通道,GPTQ 用逐层重建补偿量化误差,GPTAQ 跨顺序量化层补偿误差,ResComp 则补偿残差误差。但这些方法都没有系统回答一个问题:在有限的校正预算下,哪些参数子空间最值得优化?
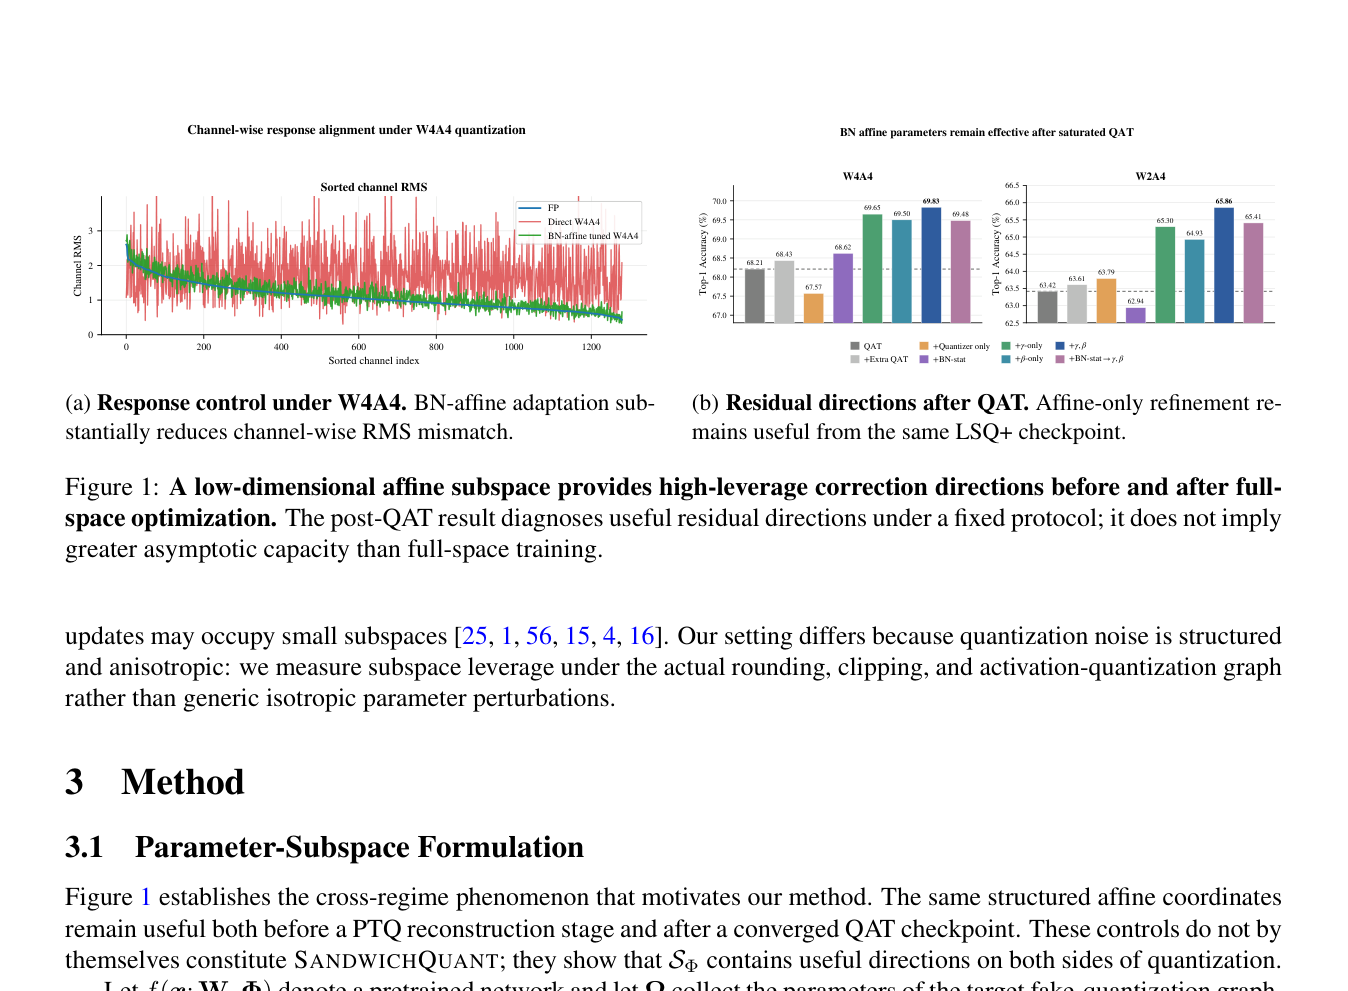
SandwichQuant 的关键洞察是:归一化仿射参数虽然数量极少,但具有通道级广播特性——一个标量 γ 或 β 可以同时影响该通道上所有 token 的响应。这意味着 Φ 子空间的控制范围覆盖整个序列的传播路径,而非单个权重元素。这种广播式响应控制使得极低维的 Φ 在匹配预算下具有不成比例的高杠杆。
核心创新
- 将量化校正形式化为参数子空间问题,分解 Θ=(W,Φ,Ω) 并在匹配预算下证明 Φ 子空间校正杠杆最高
- 提出两阶段 SandwichQuant 框架:Φpre→PTQ→Φpost,分离分布预条件与残差响应校正
- 通过响应传播、结构化源干预和任务感知误差几何分析解释仿射子空间高杠杆机制
- 不引入任何额外推理分支或算子,仅更新原生归一化仿射参数
方法概览
SandwichQuant 分两阶段:先在一次性 PTQ 探针图上优化 Φpre,仅将该仿射状态迁移回原始稠密 checkpoint 后从头重跑 PTQ 得到 G2;再冻结 G2 仅优化 Φpost 校正残差响应。目标函数为任务损失加全词表教师蒸馏 KL 散度。
- 参数子空间分解:将可训练状态分解为 Θ=(W,Φ,Ω),其中 W 是权重,Φ 是归一化仿射参数(BN 的 γ,β 或 RMSNorm 的 γ),Ω 是其他可训练参数。匹配预算实验在 Qwen3-8B W2A4KV4 上对比 RandomW、AttentionW、MLPW、TopGradW 与 Φ,所有方案使用完全相同的标量参数量、校准数据、优化步数和训练目标。
- Φpre 阶段:在一次性 PTQ 探针图上优化 Φpre,目标函数为任务损失加全词表教师蒸馏 KL 散度。优化完成后,仅将仿射状态迁移回原始稠密 checkpoint,然后从头重跑 PTQ 得到量化图 G2。这一阶段的作用是预条件分布,使后续 PTQ 重建在更友好的激活分布上进行。
- Φpost 阶段:冻结量化图 G2 的所有量化权重,仅优化 Φpost 校正残差响应。同样使用任务损失加蒸馏 KL 散度作为目标。这一阶段的作用是修正量化引入的响应传播偏差,而非重建局部权重。
- 无推理开销:两个仿射阶段只更新原生归一化参数,最终部署图与基座 PTQ 图在结构上完全一致,不引入任何额外参数或推理算子。
- 机制探针:通过四状态干预(分别对 W/K/V/FULL 结构源施加校正)、任务感知误差几何和结构化源恢复分析,证明 Φpost 的主要效果来自传播与交互控制,而非均匀的局部重建。
- 顺序消融:对比 PTQ、PTQ→Φpost、Φpre→PTQ 和完整 SandwichQuant,证明两阶段缺一不可。单侧 Φpre→PTQ 在 Llama3-8B W3A16 上 Avg6 几乎无提升,完整两阶段才稳定有效。
逐图理解论文
失败案例与直觉
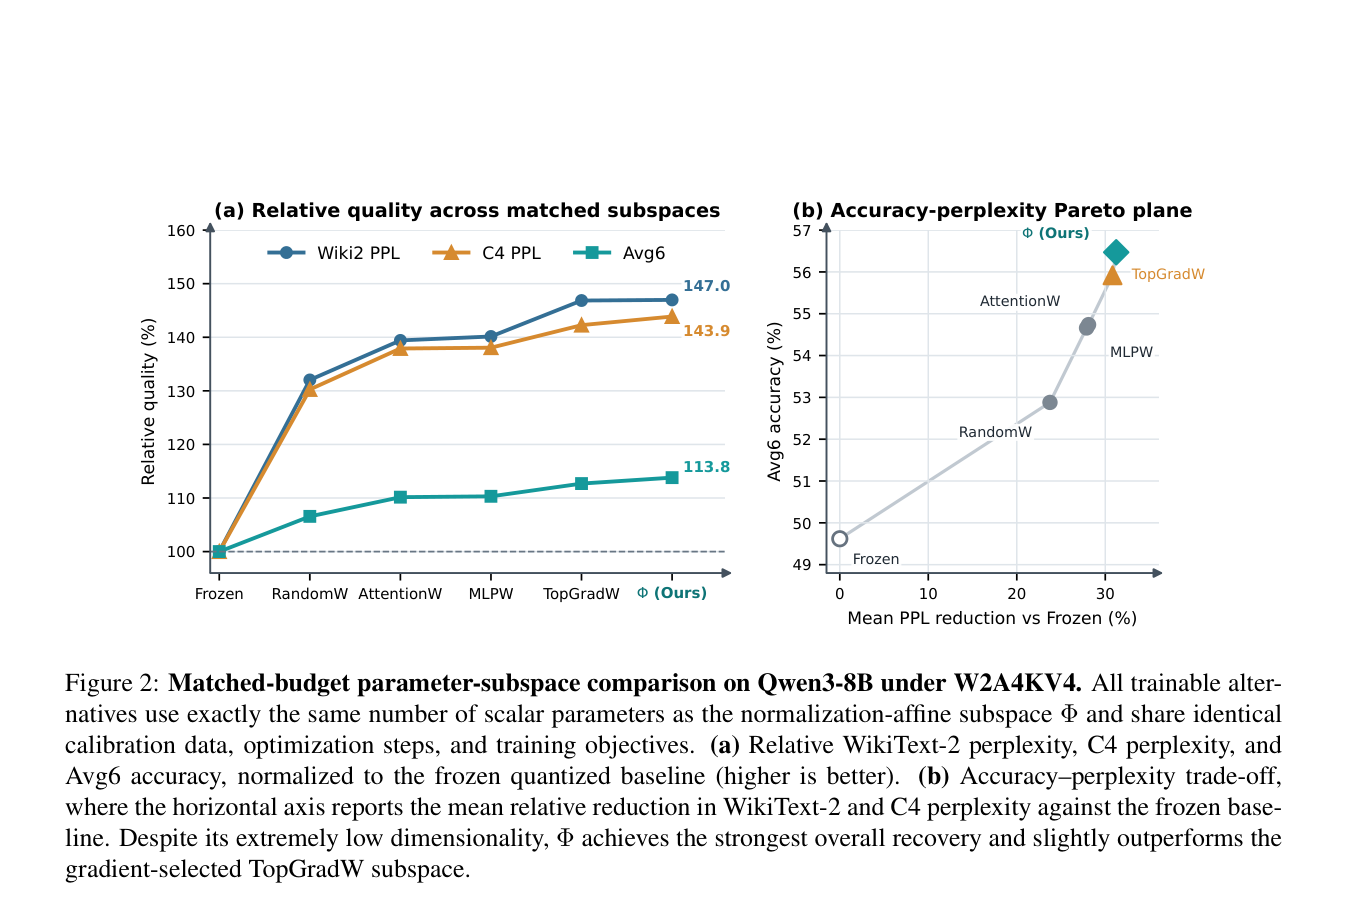
图 2 的匹配预算对比排除了'任意等量可训练标量足够'的解释。Φ 在相同参数量下取得最强的联合困惑度-准确率恢复,且略优于梯度选择的 TopGradW 子空间。
核心区分:参数子空间
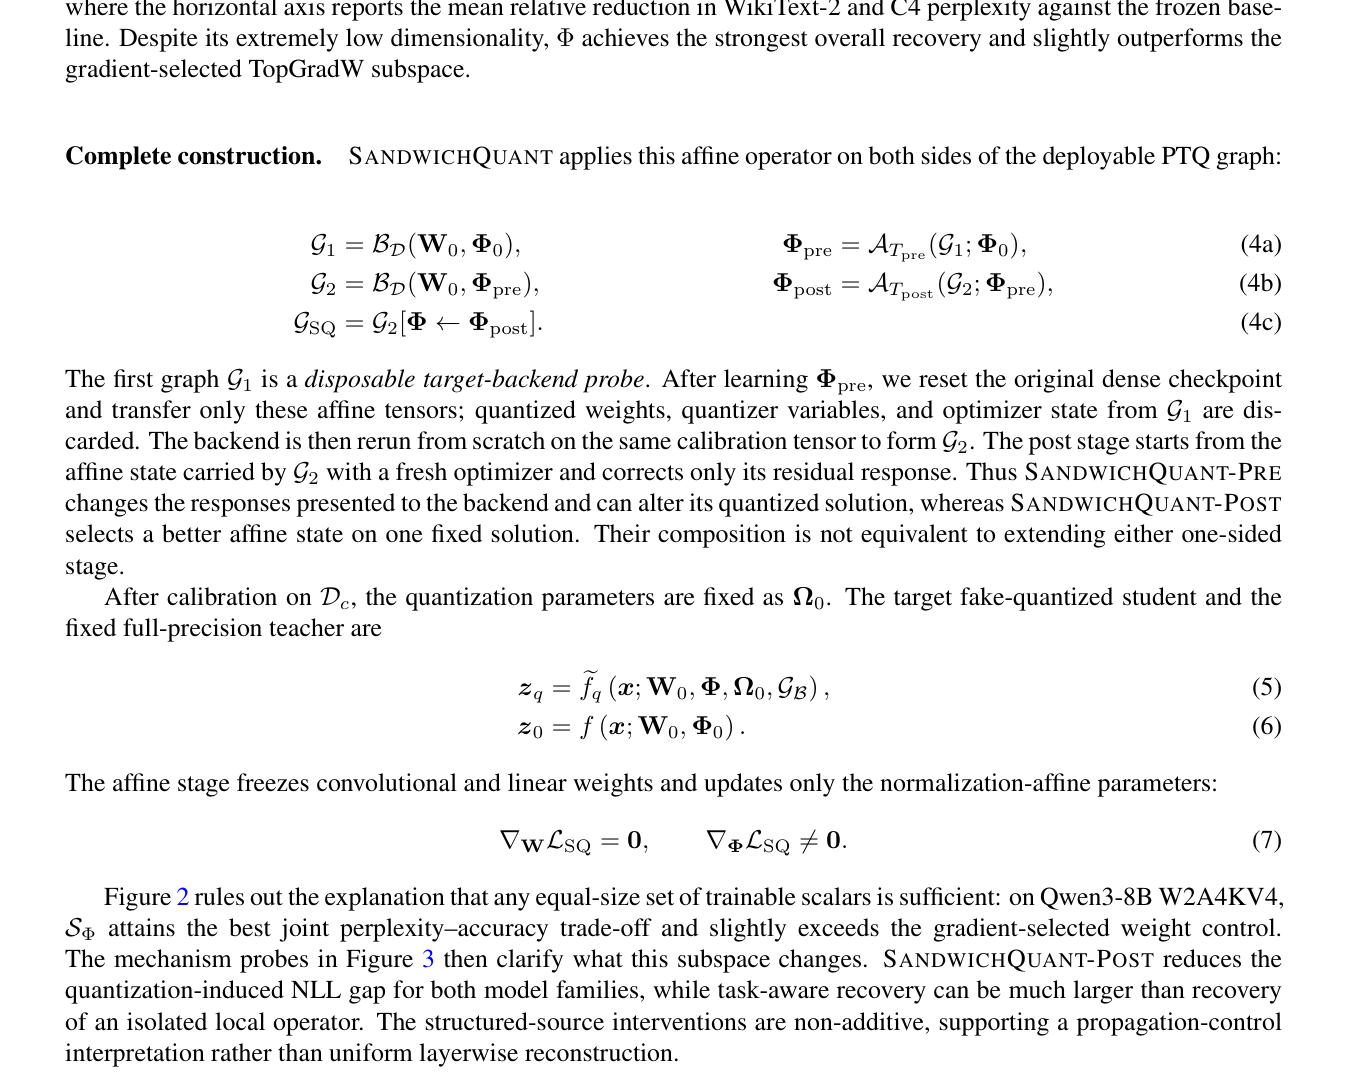
作者把可训练状态分解成三部分:权重 W、归一化仿射参数 Φ,以及其他参数 Ω。关键发现是:Φ 虽然维度极低,但具有通道级广播特性——一个标量就能影响该通道上所有 token 的响应传播。匹配预算实验显示,在完全相同的参数量、校准数据和优化步数下,Φ 的校正杠杆远超随机权重、注意力权重甚至梯度选择的权重子空间。这说明问题不在参数量,而在参数的位置。
SandwichQuant 的两阶段框架
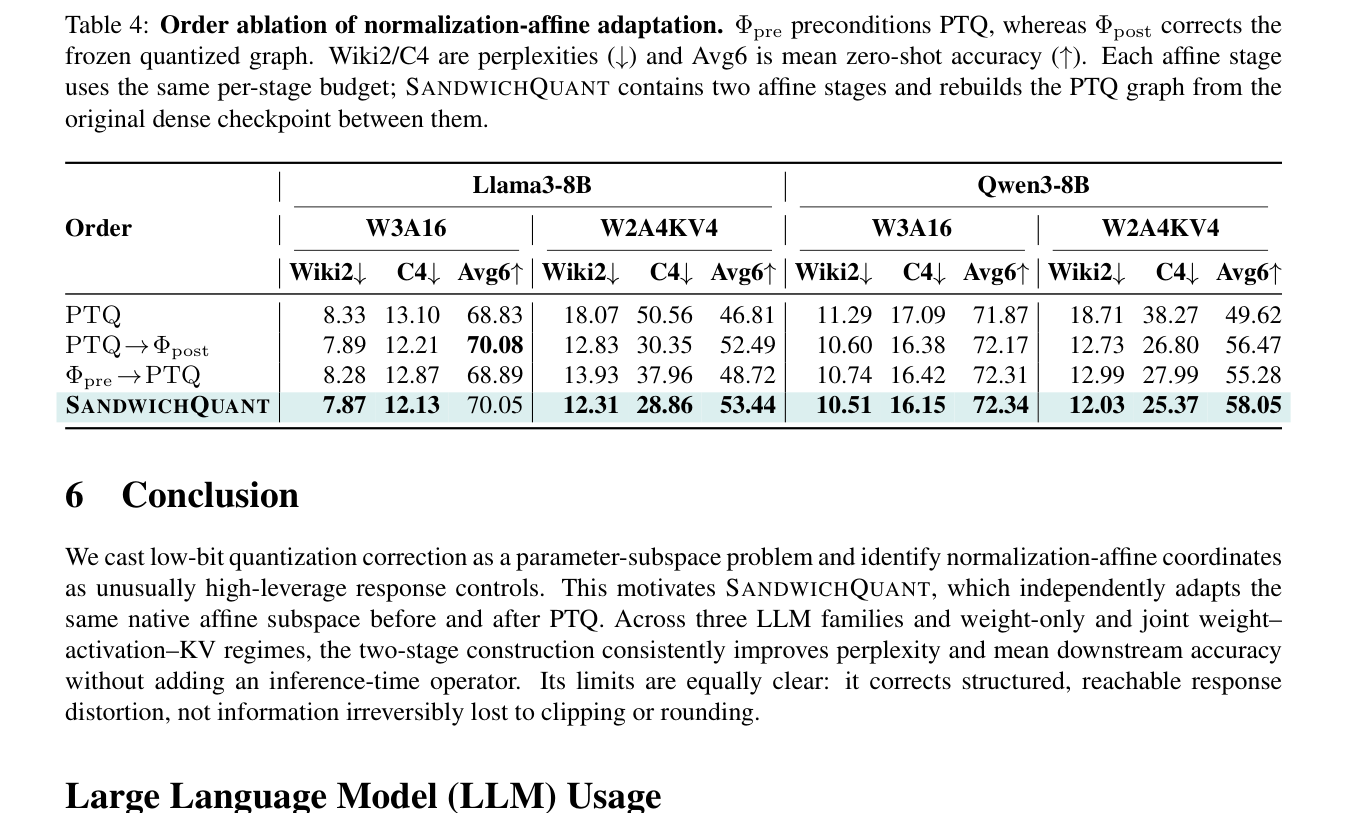
表 4 的顺序消融证明两阶段缺一不可。单侧 Φpre→PTQ 在 Llama3-8B W3A16 上 Avg6 几乎无提升,完整 SandwichQuant 才稳定有效。
证据与机制
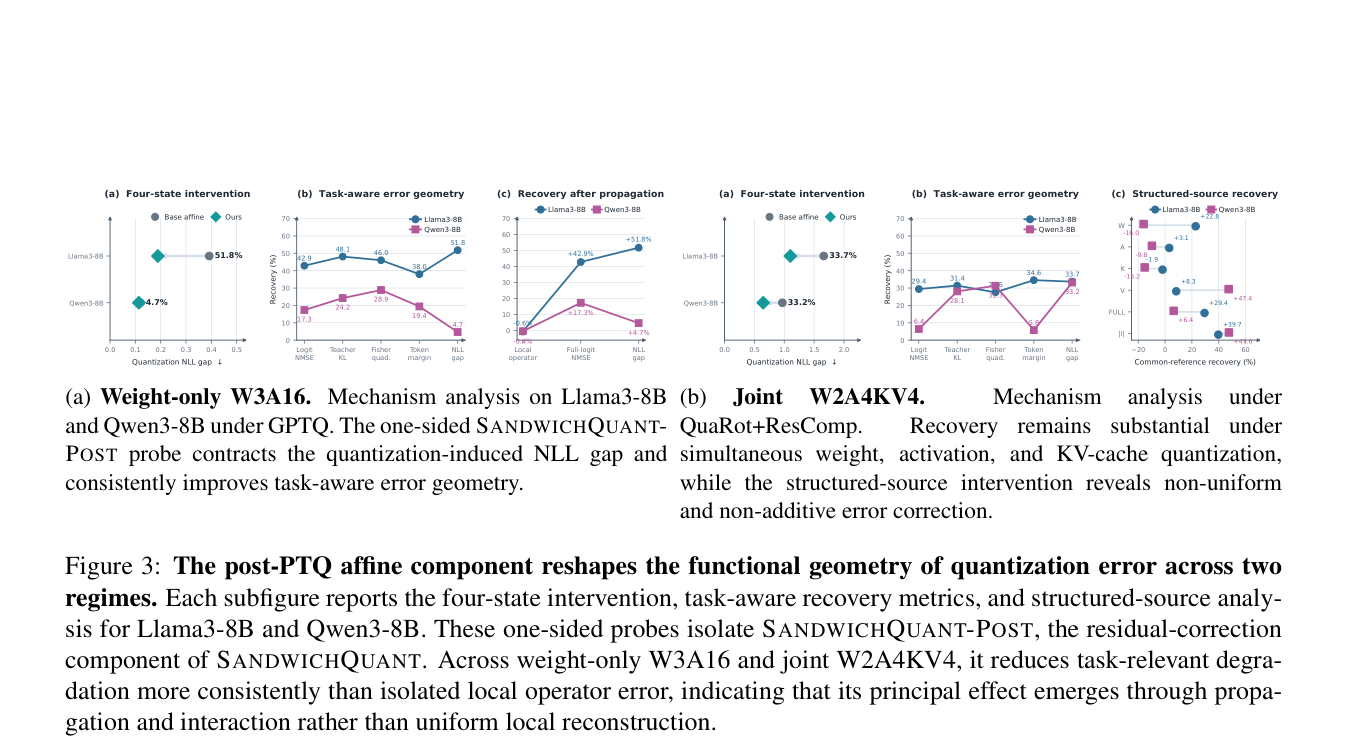
图 3 的机制探针显示 Φpost 减少的是任务相关的 NLL 差距,而非孤立的局部算子误差。结构化源干预的非加性结果支持传播控制解释,而非均匀逐层重建。
结论与局限
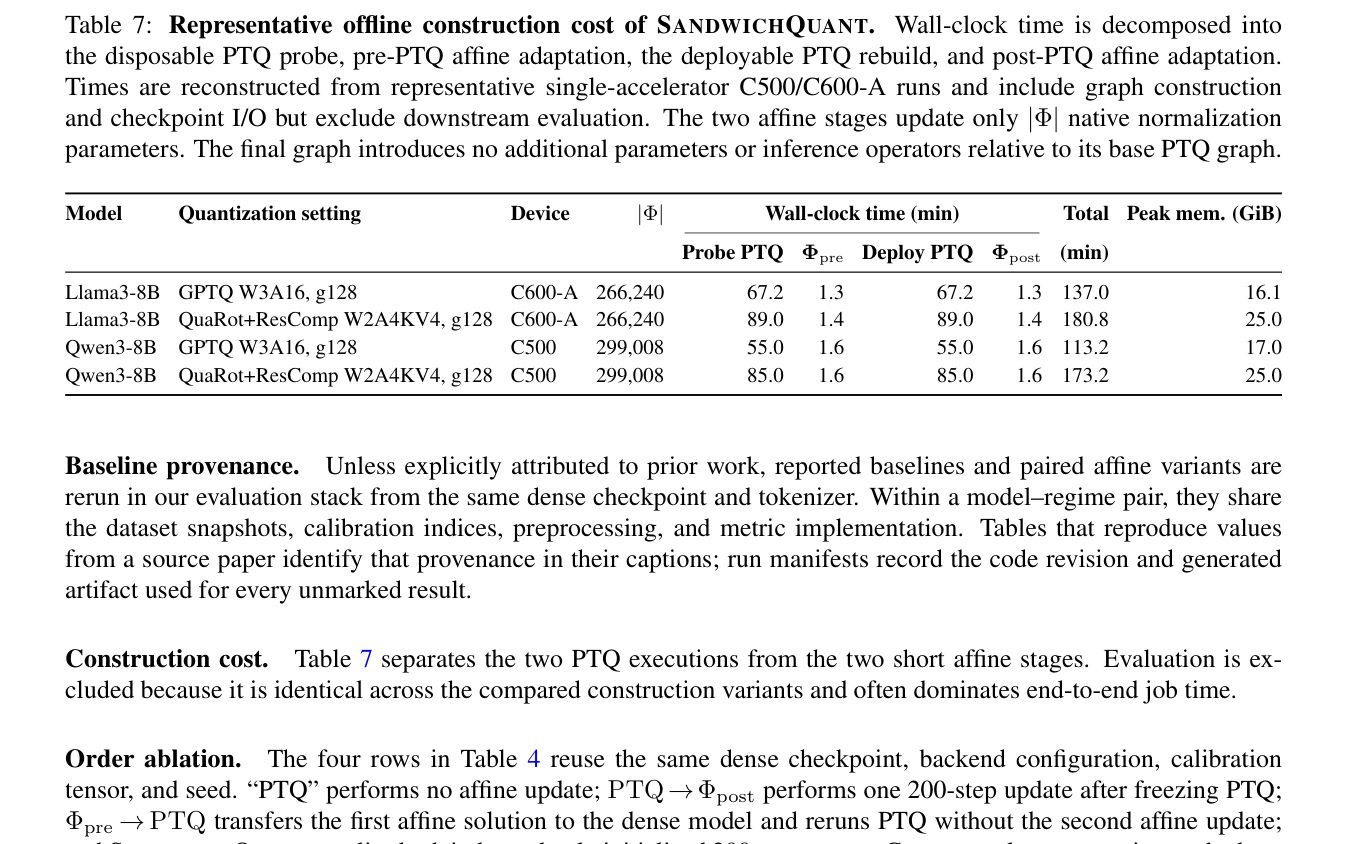
表 7 的构造成本分解显示两个仿射阶段各仅需约 1.3 分钟,占总墙钟时间的极小比例,且最终图不引入额外参数或推理算子。
实验如何设计?
- 视觉控制实验:CIFAR-100 MobileNetV2 上对 PACT/DSQ/LSQ/LSQ+/OOQ/StableQAT 等 QAT 算法做单侧 post-QAT 仿射校正;ImageNet-1K MobileNetV2 与 Cityscapes U-Net 上验证 W4A4/W3A4 低比特 PTQ 校正。
- LLM 权重仅量化 W3A16:Llama2-7B、Llama3-8B、Qwen3-8B 在 RTN/AWQ/GPTQ/GPTAQ/ResComp 后端上的完整两阶段管线,group size 128。
- LLM 联合量化 W2A4KV4:QuaRot+GPTAQ 与 QuaRot+ResComp 后端上的完整管线,group size 128,校准数据为 128 条 WikiText-2 序列(长度 2048,seed 0)。
- 匹配预算参数子空间对比:在 Qwen3-8B W2A4KV4 上对比 Φ 与 RandomW/AttentionW/MLPW/TopGradW,所有方案使用相同标量参数量。
- 构造成本分析:分解 PTQ 探针、仿射阶段、部署 PTQ 重建的墙钟时间,在代表性单加速器 C500/C600-A 上重建估计。
关键结果与论文证据
- Qwen3-8B W2A4KV4:SandwichQuant 将 Avg6 从 49.62 提升至 58.05,Wiki2 从 18.71 降至 12.03(第 8 页)。
- Llama3-8B W2A4KV4:SandwichQuant 将 Avg6 从 46.81 提升至 53.44,Wiki2 从 18.07 降至 12.31(第 8 页)。
- Llama2-7B W2A4KV4 QuaRot+GPTAQ:Avg6 从 48.5 提升至 54.3,Wiki2 从 11.7 降至 8.2(第 10 页)。
- 匹配预算对比:Φ 在 Qwen3-8B W2A4KV4 上相对 Wiki2/C4 PPL 降低约 147%,优于梯度选择的 TopGradW 子空间的 143.9%(第 4 页)。
- MobileNetV2 ImageNet W4A4:SQ-POST 将 RTN 从 0.33% 恢复至 66.11% top-1(第 8 页)。
- U-Net Cityscapes W4A4:SQ-POST 将 RTN 从 3.27% 恢复至 67.21% mIoU(第 8 页)。
- 构造成本:Llama3-8B W3A16 GPTQ 总墙钟时间 137.0 分钟,其中 Φpre/Φpost 各仅 1.3 分钟(第 14 页)。
- 顺序消融:单侧 Φpre→PTQ 在 Llama3-8B W3A16 上 Avg6 几乎无提升(68.83→68.89),完整两阶段才稳定有效(第 8 页)。
阅读时需要注意
- 证据限于稠密 7B–8B LLM 和单一确定性种子,缺乏更大模型、MoE 架构和多种子置信区间验证。
- 仿射状态是后端、位宽和校准数据特定的,不能跨后端迁移。
- 无法恢复由严重裁剪或舍入造成的不可逆信息损失。
- 需要两次短仿射优化和第二次离线 PTQ 通道,增加离线构造成本。
- 未评估部署延迟影响。
关联工作
- Norm Tweaking 更新归一化参数对齐量化与浮点 LLM 激活,但作为实用启发式而非子空间对比研究。
- GPTAQ 跨顺序量化层补偿误差,是 SandwichQuant 的基座后端之一。
- ResComp 补偿式 LLM 量化残差误差方法,作为基座后端被 SandwichQuant 增强。
- QuaRot 旋转式无异常值 4-bit 推理,W2A4KV4 实验的基座后端。
- SpinQuant 学习旋转的 LLM 量化方法,附录中作为后端验证 SandwichQuant 兼容性。
- PTQ4VM 使用全局仿射校准校正 BN 相关累积失真的视频抠图 PTQ 方法,与 SandwichQuant 的仿射校正思路有相似之处。