快速导读:LUCAID是一个经前瞻性临床验证的智能体多模态AI系统,通过LLM智能体协调九个定量分析模块,覆盖肺癌病理诊断全流程,在临床可操作决策上达到93.0%的一致性,显著优于五位资深胸科病理学家(68.3–81.1%)。
LUCAID(Lung Cancer Agent for Integrative Diagnostics)是一个面向肺癌精准病理的智能体多模态AI系统。它的核心设计思想是:LLM负责推理和编排,但所有定量测量必须来自经过独立验证的分析模块。这一分离解决了当前视觉语言模型在病理学中'能说不能测'的根本问题。
论文通过模块级标注基准、分子正交验证、AI报告验证和前瞻性多中心临床验证四个层次,系统性地证明了这一架构的可行性。在前瞻性验证中,LUCAID与专家小组裁决参考标准的一致性达到93.0%,而五位资深胸科病理学家的一致性仅为68.3–81.1%。
英文题目:LUCAID: Agentic Multimodal AI for Lung Cancer Precision Pathology
论文出处:arXiv 每日论文精选 · arXiv:2608.23803
原始论文:PDF / 论文页面
这篇论文解决什么问题?
肺癌精准治疗决策依赖多种评估的整合:肿瘤组织识别、组织学亚型分型、PD-L1等生物标志物定量评分、以及分子检测结果的综合解读。这些任务传统上由病理学家手工完成,不仅费时,而且存在显著的观察者间差异。
现有AI工具大多只覆盖单一任务,例如单独的肿瘤检测或单独的PD-L1评分。它们缺乏泛化能力,无法整合多模态信息,更重要的是缺乏前瞻性临床验证。这意味着即使模型在回顾性数据上表现良好,也无法证明其在真实临床流程中的可靠性。
近期出现的智能体系统尝试用LLM协调多个分析步骤,但存在一个关键缺陷:它们依赖视觉语言模型直接进行定性解释,而这些解释缺乏可验证的定量基础。病理学家无法信任一个'看起来合理'但无法追溯测量来源的AI报告。
核心创新
- 首个覆盖肺癌病理全流程的智能体多模态AI系统,将LLM推理与经验证的定量分析模块解耦
- 通过Model Context Protocol将九个诊断模块暴露为可调用工具,支持交互式查询和端到端编排
- 在独立前瞻性多中心队列中完成临床验证,超越五位资深胸科病理学家
- 模块化设计确保所有定量测量来自经过验证的分析模块,区别于不可靠的视觉语言模型方法
方法概览
LUCAID基于Atlas系列组织病理学基础模型,构建九个分析模块(QC、肿瘤检测与分割、亚型分型、TME分析、肿瘤细胞含量评估、IHC细胞表型分析、PD-L1评分、ADC靶点评分、结构化报告生成),由LLM智能体按需调用模块并整合定量结果生成报告。采用病理学家在环训练,使用1,620例多中心肺癌病例和105,227个专家标注进行开发验证。
- LUCAID基于Atlas系列组织病理学基础模型构建九个分析模块:质量控制、肿瘤检测与分割、亚型分型、肿瘤微环境分析、肿瘤细胞含量评估、IHC细胞表型分析、PD-L1评分、ADC靶点评分、结构化报告生成。
- LLM智能体通过Model Context Protocol将这些模块暴露为可调用工具。智能体根据病例需求决定调用哪些模块、以何种顺序调用,并整合各模块的定量结果生成结构化报告。
- 关键设计原则是'测量与推理分离':LLM不直接观察图像并给出定量判断,而是调用经过验证的模块获取测量值,再基于这些测量值进行推理和报告生成。
- 系统采用pathologist-in-the-loop训练方式,使用1,620例多中心肺癌病例和105,227个专家标注进行开发验证。病理学家在训练过程中持续参与标注和模型迭代。
- 肿瘤细胞含量评估模块通过KRAS变异等位基因频率(KRAS VAF)进行正交验证,在115例KRAS突变病例中验证了肿瘤细胞含量与分子测量的一致性。
- 报告生成模块接受声明级和报告级验证,评估维度包括groundedness(是否有依据)、interpretation(解读是否合理)、extent(范围是否恰当)、likelihood(可能性表述是否准确)、omission(是否有遗漏)和internal contradiction(内部矛盾)。
逐图理解论文
核心区分与研究空白
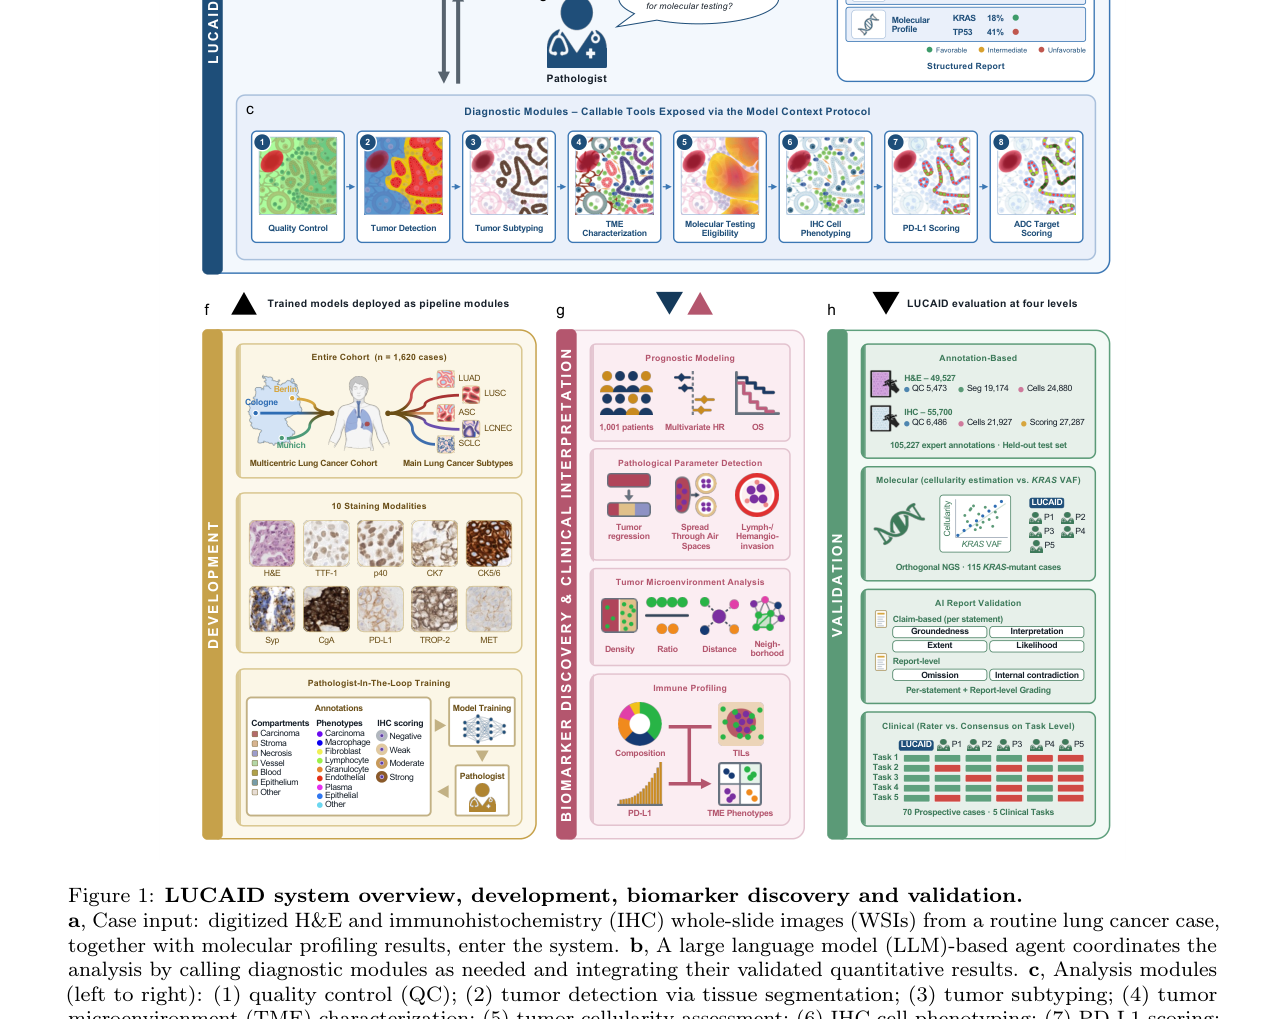
该图展示了LUCAID的系统架构:病例输入包括H&E和IHC全切片图像及分子检测结果,LLM智能体协调九个分析模块,最终生成结构化报告。重点观察模块间的数据流向和智能体的编排角色,理解'测量与推理分离'的设计如何体现在架构中。
最强结论
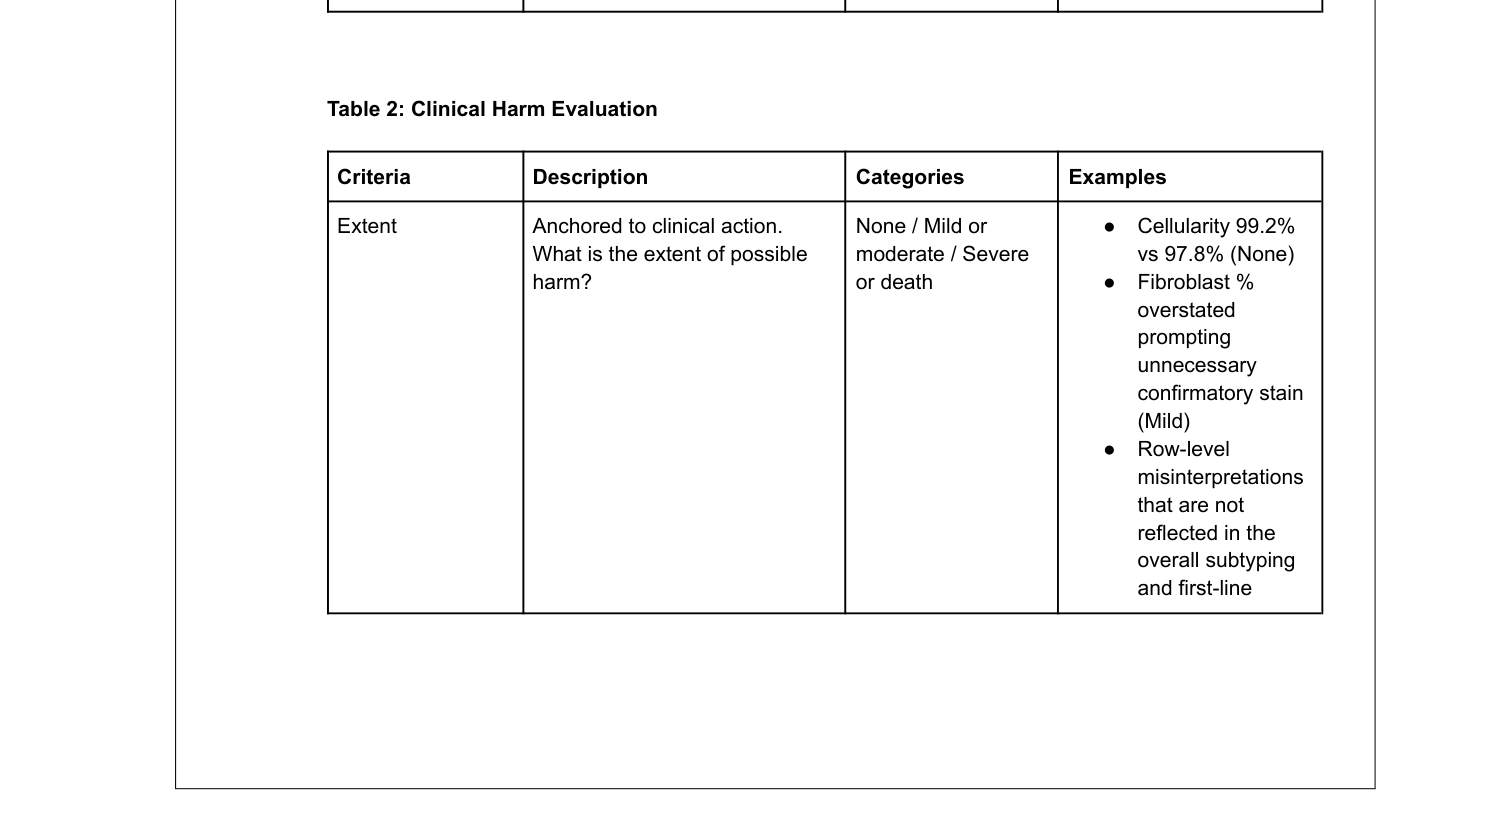
临床危害评估表展示了LUCAID在不同临床任务中的错误类型和严重程度。重点对比不同任务间的危害分布,理解系统在哪些决策场景中风险更高。
Figure 2a+d)
该图展示了五种主要肺癌亚型的细胞分类结果,平均F1分数为0.95。重点观察癌细胞分类的准确性,因为这是肿瘤细胞含量评估的基础,直接关系到分子检测的指导质量。
实验如何设计?
- 模块级标注基准测试:使用105,227个专家标注,在10个独立留出测试集上评估26个预测类别。
- 分子正交验证:115例KRAS突变病例,将肿瘤细胞含量评估结果与KRAS VAF进行交叉验证。
- AI报告验证:对生成的报告进行声明级和报告级评估,检查groundedness、interpretation、extent、likelihood、omission和internal contradiction六个维度。
- 前瞻性多中心临床验证:70例病例,5位资深胸科病理学家独立评估,5项临床可操作任务,以专家小组裁决为参考标准。
- 生物标志物发现:在1,001例患者队列上进行预后建模和肿瘤微环境特征分析。
关键结果与论文证据
- 前瞻性临床验证中,LUCAID与专家小组裁决参考标准的一致性达到93.0%,显著高于五位资深胸科病理学家的68.3–81.1%(第1页)。
- 细胞分类平均F1分数为0.95(范围0.90–0.98),其中癌细胞的F1分数在原发肿瘤中为0.95,在转移性肿瘤中为0.99(第8页)。
- 各分析模块的F1分数范围为0.82–0.95,表明模块间性能存在差异,部分模块可能低于整体水平(第1页)。
- 肿瘤细胞含量评估与KRAS VAF的正交验证结果支持该模块用于指导分子检测的可行性。
- 报告验证显示LUCAID生成的报告在groundedness和internal contradiction方面表现良好,但具体数值需查阅Table 3(第53页)。
- 临床危害评估(Table 2,第52页)表明系统在临床可操作决策中的错误率处于可接受范围,但需结合具体任务类型解读。
阅读时需要注意
- 论文未明确报告各模块在罕见亚型(如LCNEC、SCLC)上的独立性能细节,这限制了对其泛化能力的全面评估。
- 前瞻性验证队列规模相对有限(70例),虽然设计严谨,但更大规模的多中心验证仍有必要。
- 93.0%一致性基于专家小组裁决的参考标准,而非完全独立的金标准;五位病理学家的一致性范围(68.3–81.1%)表明任务本身存在较高主观性。
- 论文未详细讨论系统在资源受限环境下的部署可行性,包括计算资源需求和与现有实验室信息系统的集成成本。
关联工作
- Atlas系列组织病理学基础模型为LUCAID的各分析模块提供了视觉特征提取基础。这些模型在大规模异质组织病理数据上预训练,能够泛化到多种组织类型和染色方式。
- 现有智能体病理系统仅覆盖部分诊断流程,且依赖视觉语言模型进行定性解释。LUCAID的关键区别在于将定量测量委托给经过验证的专用模块,而非让LLM直接'看'图像。
- nNGM(National Network Genomic Medicine Lung Cancer)作为德国国家基因组医学肺癌网络,为LUCAID的开发提供了多中心病例来源和临床验证框架。