快速导读:LLaDA-Image 提出了一种统一框架,通过解耦视觉先验学习与语言对齐,结合 dLLM 理解模块、单流 DiT 生成器及 TwinFlow 蒸馏技术,在保持高真实感的同时实现了高效的文生图与图像编辑能力。
LLaDA-Image 提出了一种统一框架,通过解耦视觉先验学习与语言对齐,结合 dLLM 理解模块、单流 DiT 生成器及 TwinFlow 蒸馏技术,在保持高真实感的同时实现了高效的文生图与图像编辑能力。
该系统完全开放模型权重、训练代码和详细配方,支持可复现研究,在保持高真实感的同时实现了高效的文生图与图像编辑能力。
英文题目:LLaDA-Image: Building Strong Image Generators with Fully Open Training Recipes
论文出处:arXiv 每日论文精选 · arXiv:2609.03796
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有图像生成系统通常将视觉先验学习与语言对齐耦合,依赖大量配对图文数据,导致训练成本高且细节丢失。
同时,统一模型需在保持参考图像信息的同时支持复杂编辑,且部署需压缩扩散轨迹而不损失质量。
图像生成正从专用文生图模型演变为通用视觉创作系统,需理解复杂多语言指令、合成逼真内容、保留编辑参考信息并准确渲染文本。
专有系统进展显著但数据与配方不透明,开源模型需在数据预算、训练稳定性与部署效率间取得平衡。
核心创新
- 解耦视觉先验学习与语言对齐,使用图像-only 数据预训练和中期训练,避免早期大规模配对监督。
- 统一 dLLM 理解、生成与编辑架构,通过 RQA 和轻量 Transformer 连接器暴露生成相关隐状态。
- 采用无参数 RMSNorm 和 Muon 优化器提升训练稳定性。
- 使用 TwinFlow 蒸馏技术实现 2-4 步快速推理,保持生成质量。
- 完全开放模型权重、训练代码和详细配方,支持可复现研究。
方法概览
系统包含三个主要组件:基于 LLaDA 2.0 Mini dLLM 的视觉语言模型(VLM)用于多模态理解;理解-生成连接器(含 Residual Query Adapter 和 Transformer Connector)将 VLM 表征映射至 DiT 条件空间;纯单流 DiT 负责图像合成。训练流程分为图像-only 预训练、图像-only 中期训练、监督微调(SFT)及少步蒸馏。编辑任务通过 SigLIP-VQ 特征和干净 VAE 潜变量直接注入 DiT,绕过 VLM。
- 基于 LLaDA 2.0 Mini dLLM 的视觉语言模型(VLM)用于多模态理解。
- 理解-生成连接器(含 Residual Query Adapter 和 Transformer Connector)将 VLM 表征映射至 DiT 条件空间。
- 纯单流 DiT 负责图像合成。
- 训练流程分为图像-only 预训练、图像-only 中期训练、监督微调(SFT)及少步蒸馏。
- 编辑任务通过 SigLIP-VQ 特征和干净 VAE 潜变量直接注入 DiT,绕过 VLM。
- 采用无参数 RMSNorm 和 Muon 优化器提升训练稳定性。
- 使用 TwinFlow 蒸馏技术实现 2-4 步快速推理,保持生成质量。
逐图理解论文
解耦架构设计
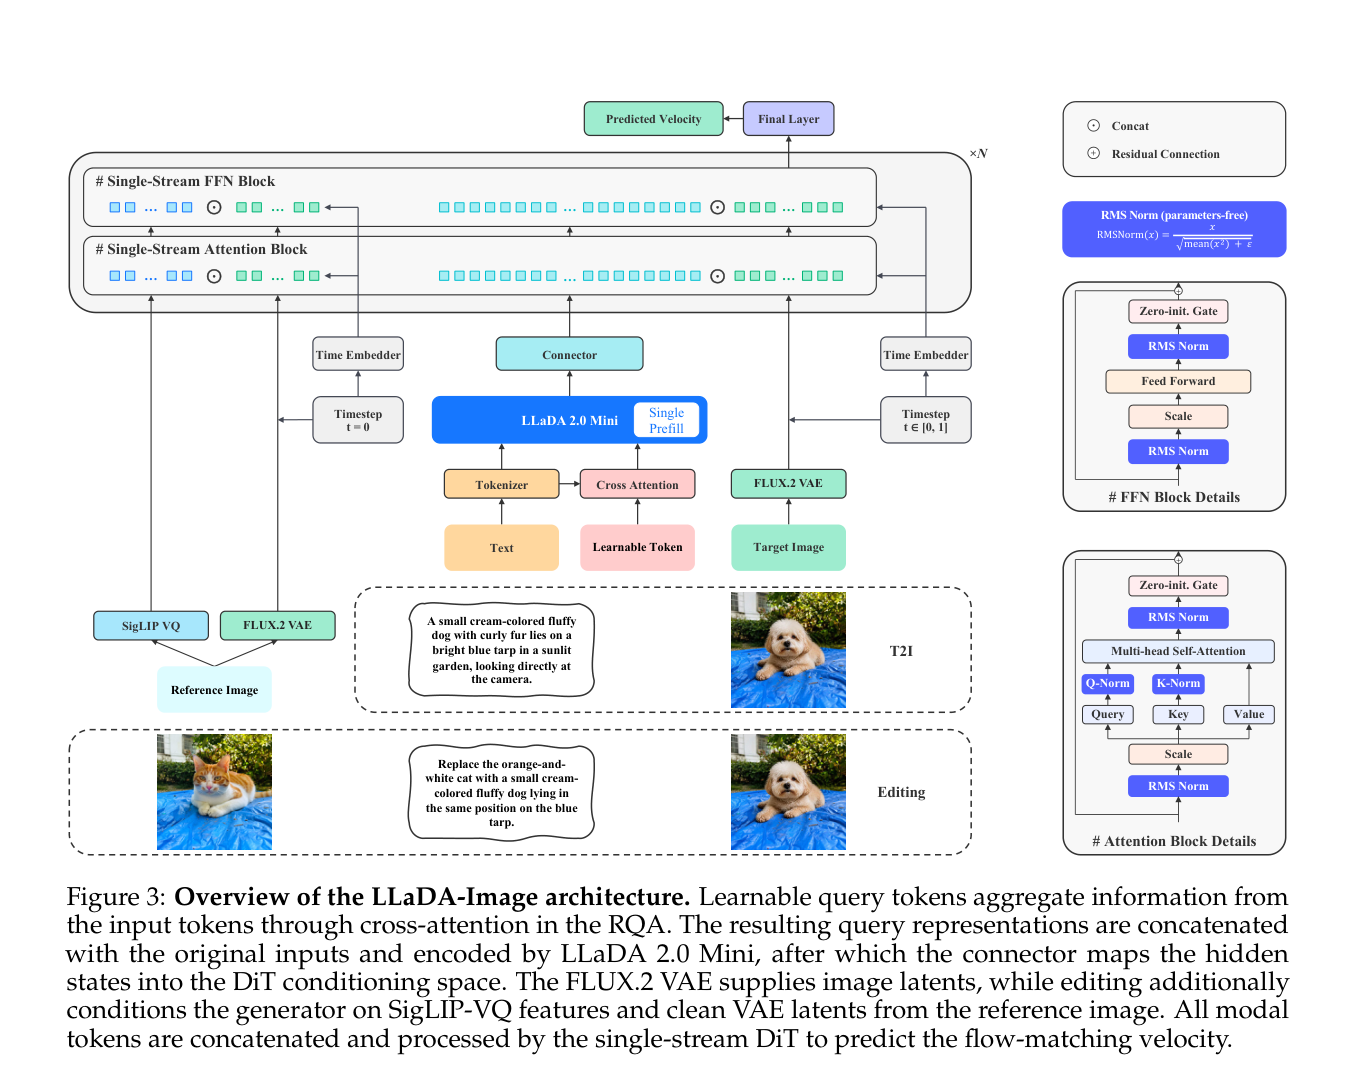
该图概述了 LLaDA-Image 架构,展示了 RQA 如何通过交叉注意力聚合信息,以及连接器如何将隐状态映射至 DiT 条件空间。这是理解统一架构如何融合理解与生成模块的关键视觉参考。
训练与蒸馏流程
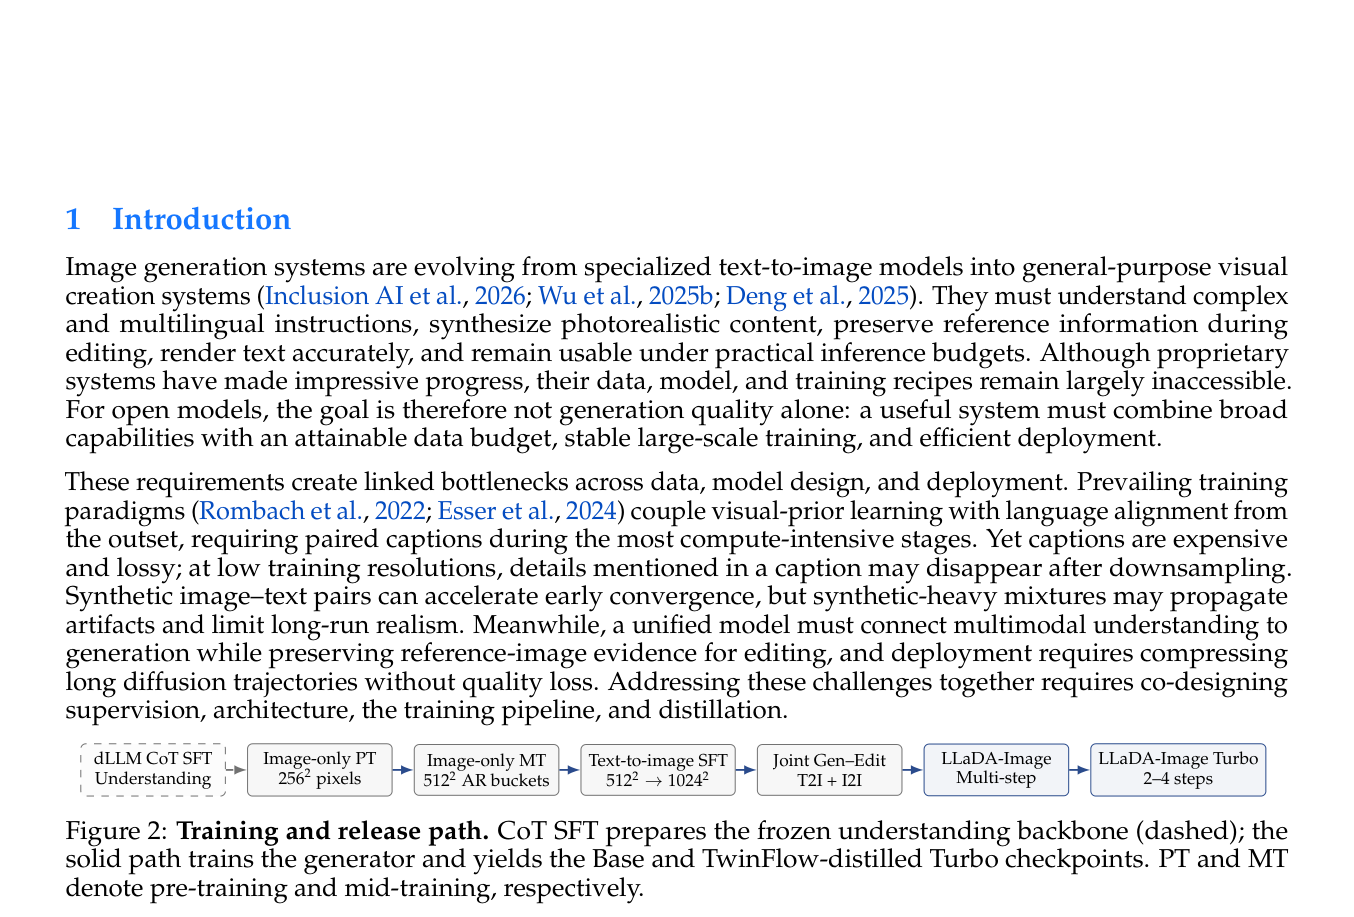
该图描绘了训练与发布路径,虚线表示 CoT SFT 准备冻结的理解骨干,实线表示训练生成器并产出 Base 和 TwinFlow 蒸馏后的 Turbo 检查点。理解此路径有助于把握解耦训练策略的具体实施流程。
性能验证
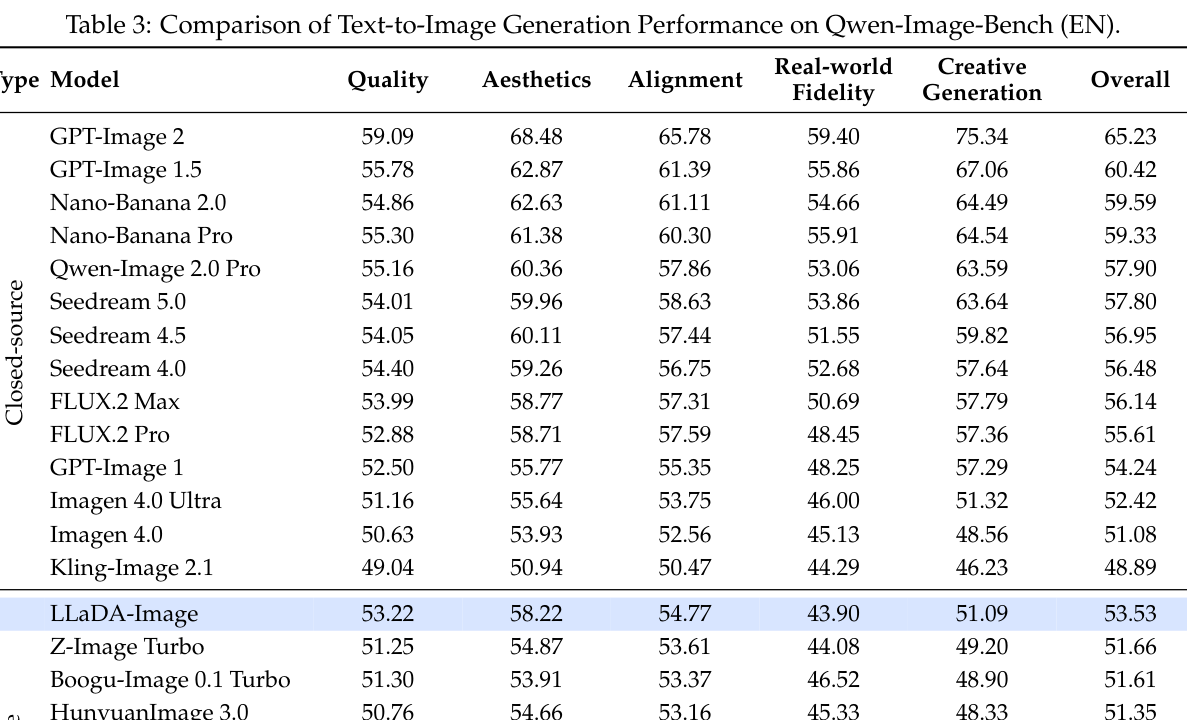
在 Qwen-Image-Bench 上,LLaDA-Image 在英文和中文赛道均达到开源 SOTA,验证了解耦策略在保持高真实感的同时实现高效生成的能力。
实验如何设计?
- 在 Qwen-Image-Bench 上评估文生图性能,涵盖英文和中文赛道。
- 在 LongText-Bench 和 CVTG-2K 上评估长文本渲染能力。
- 在 GenEval 和 DPG-Bench 上评估组合生成能力(作为补充参考)。
- 在 GEdit-Bench 上评估图像编辑性能。
关键结果与论文证据
- 在 Qwen-Image-Bench (EN) Overall 上取得 53.53 分(第 18 页)。
- 在 Qwen-Image-Bench (CN) Overall 上取得 53.38 分(第 19 页)。
- 在 LongText-Bench (EN) 上取得 0.923 分,(ZH) 上取得 0.913 分(第 20 页)。
- 在 CVTG-2K Average Word Accuracy 上取得 0.875 分,NED 上取得 0.945 分,CLIPScore 上取得 0.818 分(第 20 页)。
- 在 GenEval Overall 上取得 0.85 分,其中 Counting 子项得分较低(0.53)(第 21 页)。
阅读时需要注意
- 在 GenEval 上的 Counting 子项得分较低(0.53),暴露组合生成中的特定弱点。
- 长文本渲染得分低于部分专用文本渲染模型。
- 真实数据主导的训练配方在早期基准测试上收敛较慢。
关联工作
- IOMM (Sun et al., 2026c) 引入 Residual Query Adapter (RQA) 和图像-only 训练策略(第 9 页)。
- TwinFlow (Cheng et al., 2026) 用于少步蒸馏,基于分布匹配蒸馏和自对抗流训练(第 16 页)。
- DMD2 (Yin et al., 2024) 是 TwinFlow 的基础,最小化反向 KL 散度(第 16 页)。
- FLUX.2 (Black Forest Labs, 2026) 提供 VAE 用于图像潜变量编码(第 10 页)。
- SigLIP-VQ (Inclusion AI et al., 2026) 作为视觉编码器,用于提取参考图像语义特征(第 9 页)。