快速导读:SyncWorld 是一种基于视觉校准的动作条件世界模型,通过上下文中的校准片段解决特定场景下的动作-视觉映射问题,实现跨未见相机视角和机器人本体的零样本模拟及测试时策略改进。
SyncWorld 提出了一种基于视觉校准的动作条件世界模型,旨在解决现有世界模型在跨相机视角和机器人本体变化时的泛化难题。通过引入视觉校准片段,模型能够在推理时动态解析特定场景下的动作-视觉映射,从而实现零样本模拟。
该工作不仅提升了视频预测的时空一致性,还演示了利用世界模型进行测试时扩展(Test-time Scaling)的能力。通过想象 rollout 和 VLM 评分,SyncWorld 实现了无需训练的零样本策略改进,为构建通用机器人模拟器提供了新范式。
英文题目:SyncWorld: Visual Calibration Enables World Models as Zero-Shot Simulators
论文出处:arXiv 每日论文精选 · arXiv:2609.09155
原始论文:PDF / 论文页面
这篇论文解决什么问题?
动作条件世界模型被用作策略在环的想象环境,要求对低级机器人动作具有细粒度可控性。然而,数值动作在像素空间中并非通用语言,相机视角、机器人放置或本体变化会改变同一动作的视觉表现。
现有模型在跨异构数据源扩展时,因动作-视觉映射的场景依赖性而难以泛化到未见设置。混合训练中的监督冲突导致模型在部署时泛化脆弱,甚至无法准确 grounding 动作,限制了世界模型作为通用模拟器的应用。
核心研究缺口在于缺乏在推理时动态解析特定设置映射的机制。现有方法如 Ctrl-World 和 WorldGym 缺乏跨设置泛化能力,而 IRASim 等细粒度模型也难以适应新的相机视角或机器人本体。
核心创新
- 提出 SyncWorld,一种通过视觉校准实现跨未见相机视角和本体零样本模拟的动作条件世界模型。
- 引入校准蒸馏机制,使模型在无显式校准片段时也能从交互历史中近似 Action-Visual Mapping。
- 演示了利用世界模型进行测试时扩展(Test-time Scaling),通过想象 rollout 选择最佳动作候选,实现无需训练的零样本策略改进。
方法概览
SyncWorld 采用 Diffusion Transformer (DiT) 骨干,引入视觉校准片段(展示所有6个运动自由度的交互序列)作为上下文,以指定特定设置的 Action-Visual Mapping。训练中使用动作坐标增强和校准蒸馏,使模型能从交互历史中推断映射。测试时,利用世界模型生成候选动作的未来视频,由 VLM 评分选择最佳动作,实现零样本策略改进。
- SyncWorld 采用 Diffusion Transformer (DiT) 骨干,引入视觉校准片段作为上下文。该片段展示所有 6 个运动自由度的交互序列,用于指定特定设置的 Action-Visual Mapping。
- 训练中使用动作坐标增强和校准蒸馏,使模型能从交互历史中推断映射。校准蒸馏机制允许模型在无显式校准片段时,也能从历史交互中近似 Action-Visual Mapping。
- 测试时,利用世界模型生成候选动作的未来视频,由 VLM 评分选择最佳动作。这一过程实现了零样本策略改进,无需额外训练即可适应新环境。
- 架构中,视觉校准片段和交互历史被编码为 pose embeddings 和 video latents,使 DiT 能够生成时空一致的 future frames。
逐图理解论文
核心贡献
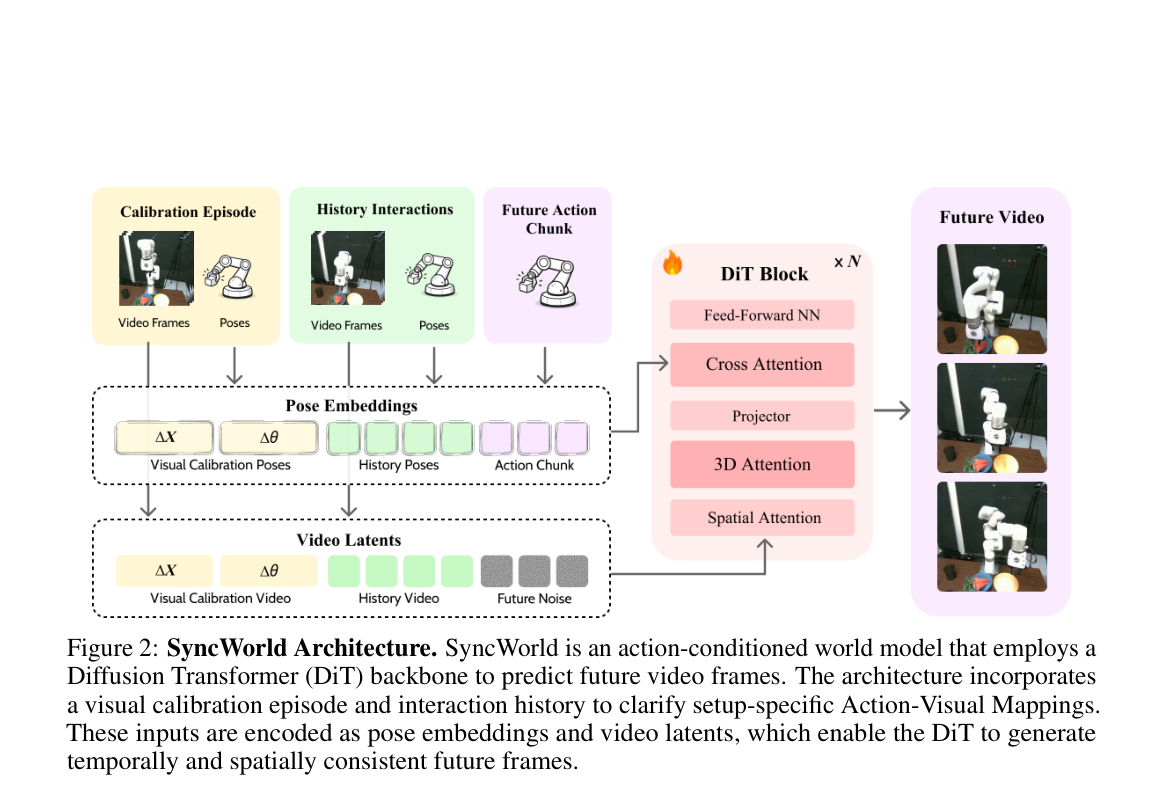
该图展示了 SyncWorld 的架构,包括 DiT 骨干、视觉校准片段和交互历史的编码方式。此图有助于理解模型如何整合不同输入以生成时空一致的 future frames。
最强结论
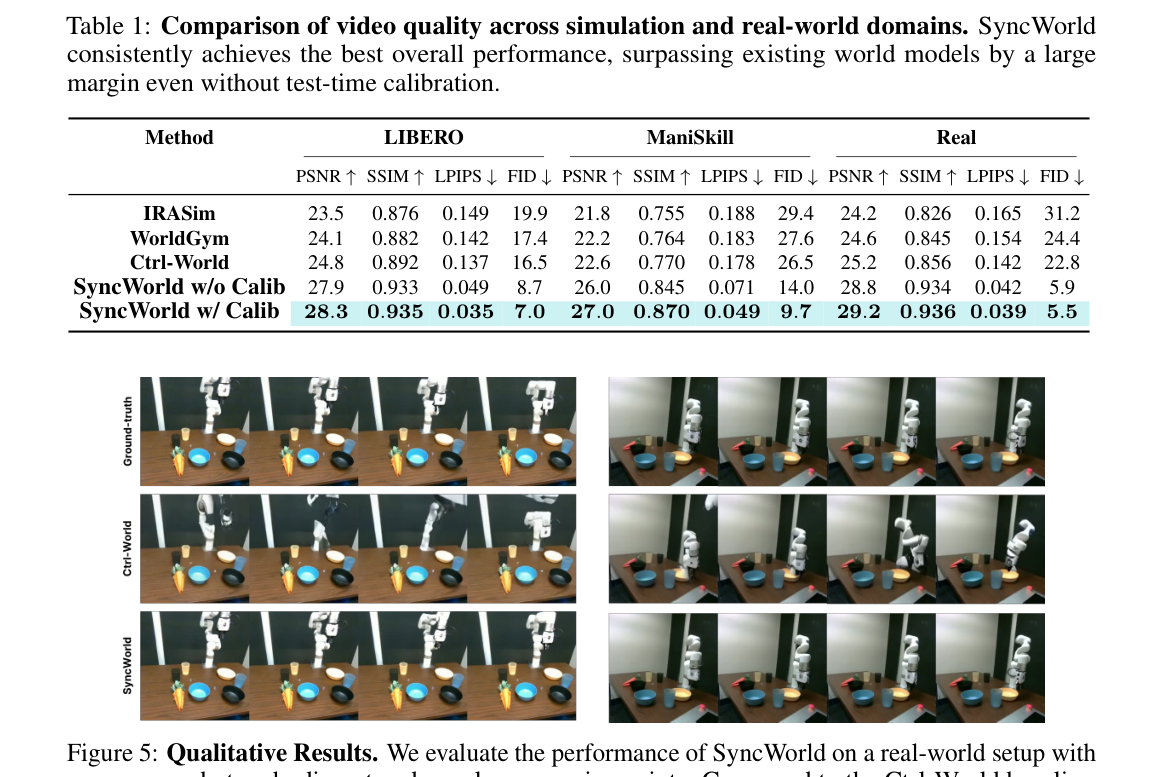
该表比较了不同世界模型在仿真和真实世界域上的视频质量。SyncWorld 在各项指标上均显著优于现有模型,验证了其视觉校准机制的有效性。
意义与局限
该工作为通用机器人模拟器提供了新路径,但 VLM 排序信号仍是策略改进的主要瓶颈。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 在 LIBERO、ManiSkill 和真实世界(xArm)数据集上评估视频预测质量,使用 PSNR, SSIM, LPIPS, FID 等指标。
- 使用 Met3r 指标评估跨视角的 3D 空间一致性,验证模型在不同相机视角下的表现。
- 在 LIBERO 子任务上评估零样本策略改进的成功率,对比直接策略、SyncWorld+GPC-Rank 和 Oracle 模拟器。
- 消融研究视觉校准和蒸馏组件对性能的影响,验证各设计的有效性。
关键结果与论文证据
- SyncWorld w/ Calib 在 LIBERO 上 PSNR 28.3, SSIM 0.935, LPIPS 0.035, FID 7.0,显著优于现有世界模型(Page 7)。
- SyncWorld w/ Calib 在 Real 域上 PSNR 29.2, SSIM 0.936, LPIPS 0.039, FID 5.5,表明其在真实世界数据上的强泛化能力(Page 7)。
- SyncWorld w/ Calib 在 LIBERO 上 Met3r 0.540,接近 Oracle 的 0.515,显示其跨视角 3D 一致性接近 ground-truth(Page 8)。
- 在 Orange Juice 任务上,SyncWorld w/ Calib 成功率为 0.72,Baseline 为 0.56,Oracle 为 0.80,验证了零样本策略改进的有效性(Page 8)。
- 移除校准训练导致 LIBERO PSNR 从 27.9 降至 25.0,表明视觉校准对性能的关键作用(Page 9)。
阅读时需要注意
- 在极端相机视角下,模型对夹爪轨迹的预测可能不稳定或模糊。
- 与训练分布外的未见物体交互时,物体状态转换建模存在挑战,可能出现模糊或错位。
- 在新本体(如 xArm)下进行细粒度动作预测时,夹爪周围可能出现轻微模糊。
- GPC-Rank 策略改进的效果受限于 VLM 的排序信号质量,部分任务中 Oracle 模拟器也无法带来一致提升。
关联工作
- Ctrl-World 是可控生成世界模型的 baseline,但缺乏跨设置泛化能力。
- WorldGym 将世界模型作为策略评估环境,但难以适应新的相机视角或机器人本体。
- IRASim 是细粒度机器人操作世界模型,但同样面临动作-视觉映射的场景依赖性挑战。
- GPC-Rank 是测试时扩展框架,用于策略改进的候选动作排序,其效果受限于 VLM 的排序信号质量。