快速导读:本文提出 MCPO 框架,通过离线 NCMI 步骤剪枝和在线非对称模态对比偏好优化,在保持精度的同时显著压缩多模态思维链长度并提升推理速度。
多模态大模型在复杂推理任务中依赖长思维链(M-CoT),但这带来了高昂的计算成本和内存开销。现有的压缩方法往往缺乏细粒度的跨模态约束,容易在压缩过程中引发视觉懒惰和幻觉问题。本文提出的 MCPO 框架旨在解决这一核心矛盾,在保持推理精度的同时显著压缩思维链长度。
MCPO 采用两阶段框架:离线阶段利用步骤级 NCMI 自适应剪除视觉无关步骤,构建紧凑轨迹;在线阶段通过非对称损失函数进行偏好对齐,强化视觉依赖并防止概率坍塌。该框架在多个基准测试中展现了卓越的压缩效率和推理速度提升,为多模态大模型的轻量化部署提供了新范式。
英文题目:MCPO: Modality-Contrastive Preference Optimization for Multimodal Chain-of-Thought Compression
论文出处:arXiv 每日论文精选 · arXiv:2609.04947
原始论文:PDF / 论文页面
这篇论文解决什么问题?
长思维链虽然能增强模型的推理能力,但其带来的显著延迟和内存开销在实际应用中难以承受。现有的基于规则或单一维度偏好的压缩方法难以在压缩率、跨模态一致性和训练成本之间取得平衡。
具体而言,缺乏跨模态约束的压缩方法容易让模型在推理中忽略图像内容,仅依赖语言先验,即“视觉懒惰”现象。这不仅降低了推理的可靠性,还可能导致严重的幻觉问题。因此,如何在压缩思维链的同时保持视觉接地,成为多模态推理优化的关键挑战。
此外,现有的压缩方法往往需要大量的训练数据或复杂的在线计算,增加了部署的复杂性。MCPO 框架通过高样本效率的设计,仅需少量训练样本即可实现有效对齐,进一步降低了数据门槛和计算开销。
核心创新
- 提出步骤级 NCMI 剪枝算法,通过比较有无图像上下文下的推理差异,定量识别并移除视觉无关步骤。
- 设计非对称多模态长度控制偏好损失(MCPO Loss),利用多模态 log-odds 与单模态 log-probability 之间的梯度速度差,强化视觉接地并防止文本先验捷径。
- 引入双通道视觉零化机制(Dual-Channel Visual Zero-Out),确保在 Qwen3-VL 等架构中彻底阻断视觉信息泄漏,构建纯净的单模态基线。
- 高样本效率:仅需少于 900 个训练样本即可实现有效对齐,降低数据门槛。
方法概览
两阶段框架:1. 离线阶段使用步骤级 NCMI(归一化跨模态互信息)自适应剪除视觉无关步骤,构建紧凑轨迹;2. 在线阶段先进行 SFT 预热,再通过非对称损失函数(多模态下陡峭 log-odds,单模态下平坦线性约束)进行偏好对齐,防止概率坍塌并保持视觉依赖。
- 离线阶段使用步骤级 NCMI(归一化跨模态互信息)自适应剪除视觉无关步骤,构建紧凑轨迹。NCMI 通过比较有无图像上下文下的推理差异,定量识别并移除视觉无关步骤。
- 在线阶段先进行 SFT 预热,再通过非对称损失函数(多模态下陡峭 log-odds,单模态下平坦线性约束)进行偏好对齐,防止概率坍塌并保持视觉依赖。
- 引入双通道视觉零化机制(Dual-Channel Visual Zero-Out),确保在 Qwen3-VL 等架构中彻底阻断视觉信息泄漏,构建纯净的单模态基线。
- 非对称损失函数利用多模态 log-odds 与单模态 log-probability 之间的梯度速度差,强化视觉接地并防止文本先验捷径。
- 高样本效率设计:仅需少于 900 个训练样本即可实现有效对齐,降低数据门槛。
逐图理解论文
具体失败案例
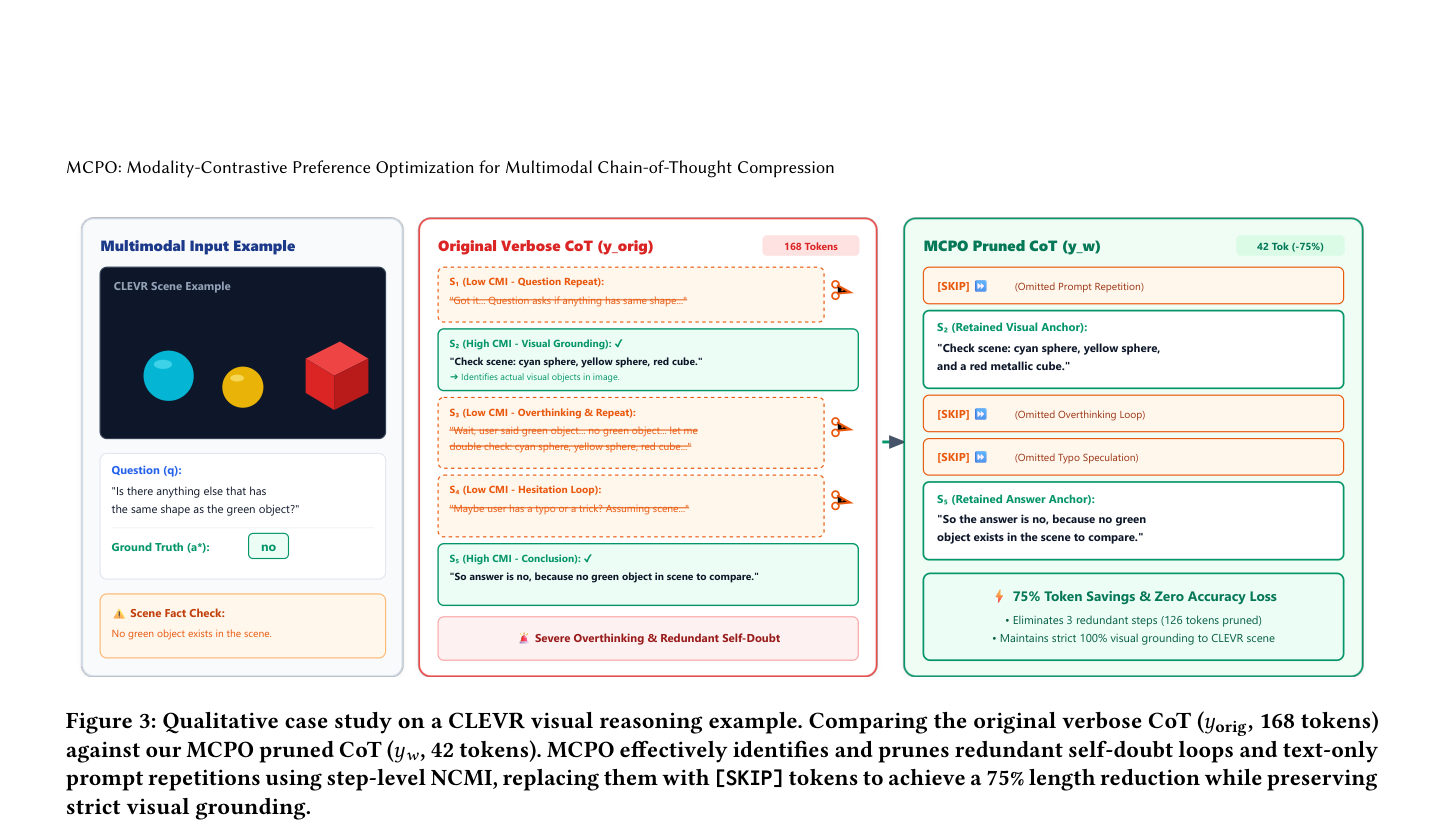
该图展示了 CLEVR 视觉推理示例的定性案例研究。比较了原始冗长的 CoT(168 tokens)和 MCPO 剪枝后的 CoT(42 tokens)。MCPO 有效地识别并剪除了冗余的自我怀疑循环和纯文本提示重复,使用 [SKIP] tokens 替代,实现了 75% 的长度减少,同时保持了严格的视觉接地。
核心区分与研究空白
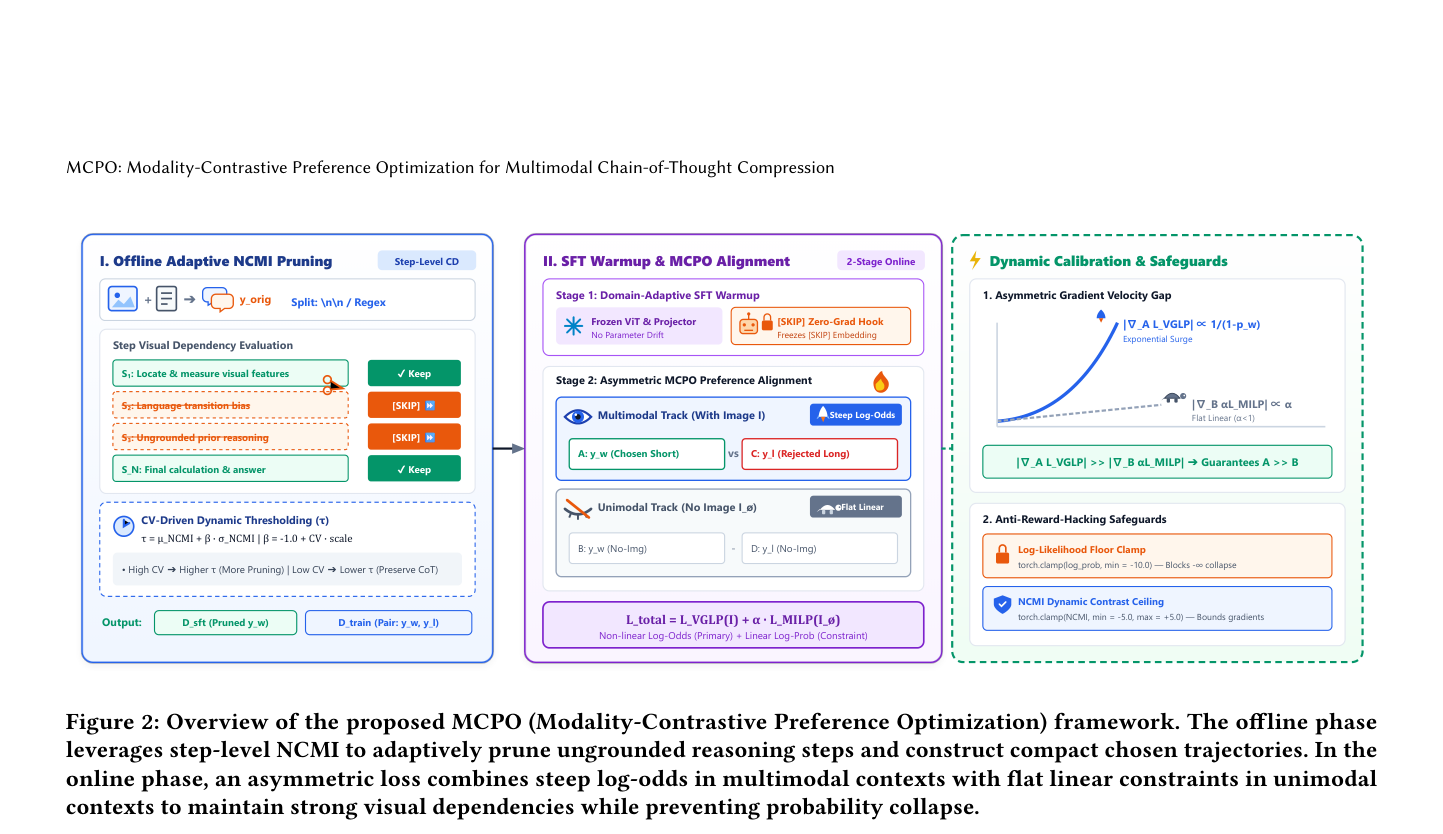
该图概述了提出的 MCPO 框架。离线阶段利用步骤级 NCMI 自适应剪除无根据的推理步骤,构建紧凑的 chosen 轨迹。在线阶段,非对称损失结合多模态上下文中的陡峭 log-odds 和单模态上下文中的平坦线性约束,以维持强大的视觉依赖关系,同时防止概率坍塌。
最强结论
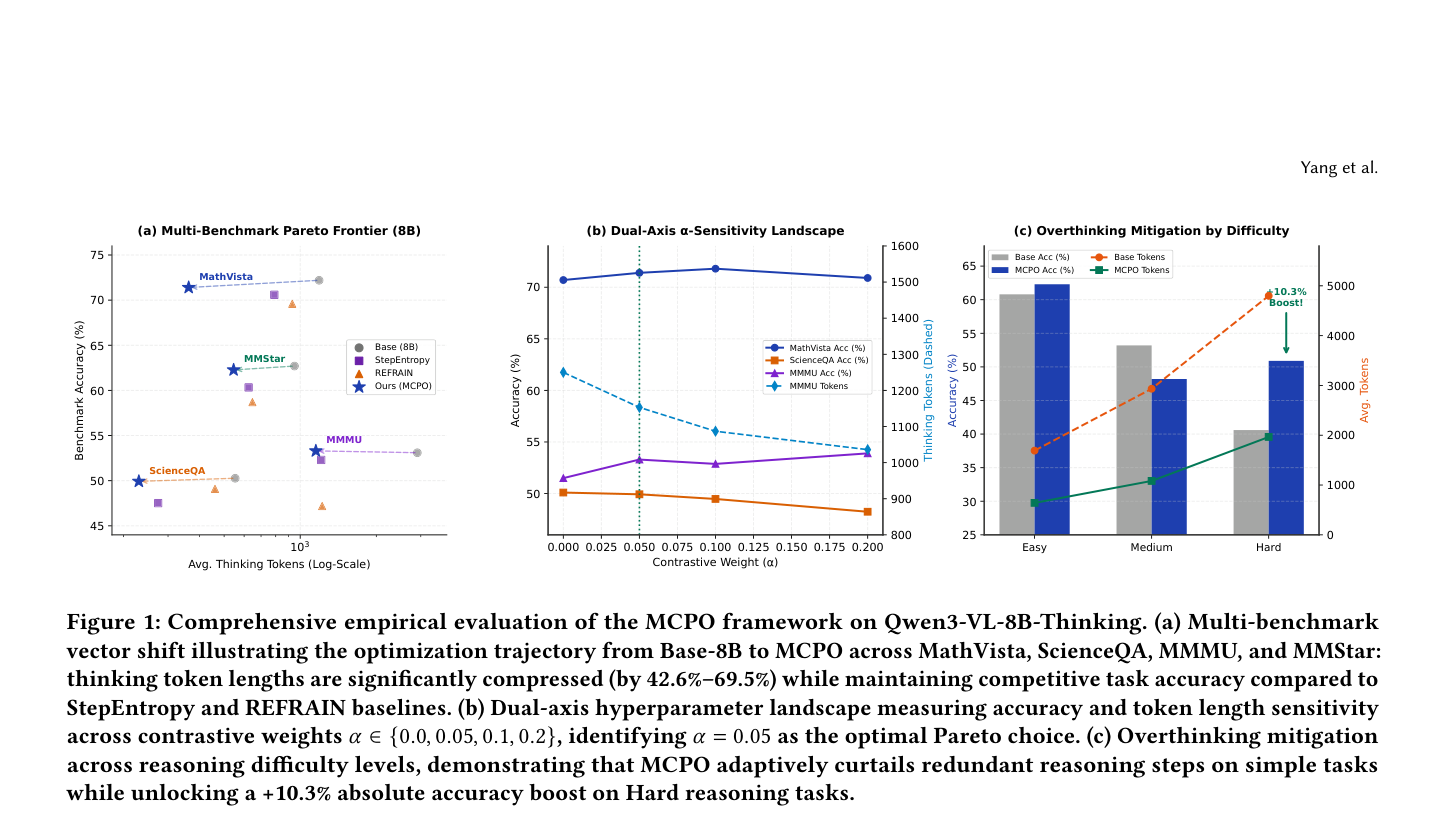
该图展示了 MCPO 框架在 Qwen3-VL-8B-Thinking 上的综合实证评估。图 (a) 展示了多基准向量偏移,说明从 Base-8B 到 MCPO 的优化轨迹,思维链长度显著压缩,同时保持竞争性任务准确率。图 (b) 展示了双轴超参数景观,测量准确率和 token 长度对对比权重 α 的敏感性,识别出 α=0.05 为最优帕累托选择。图 (c) 展示了不同推理难度级别的过度思考缓解,表明 MCPO 自适应地削减简单任务上的冗余推理步骤,同时在 Hard 推理任务上解锁了 +10.3% 的绝对准确率提升。
意义与局限
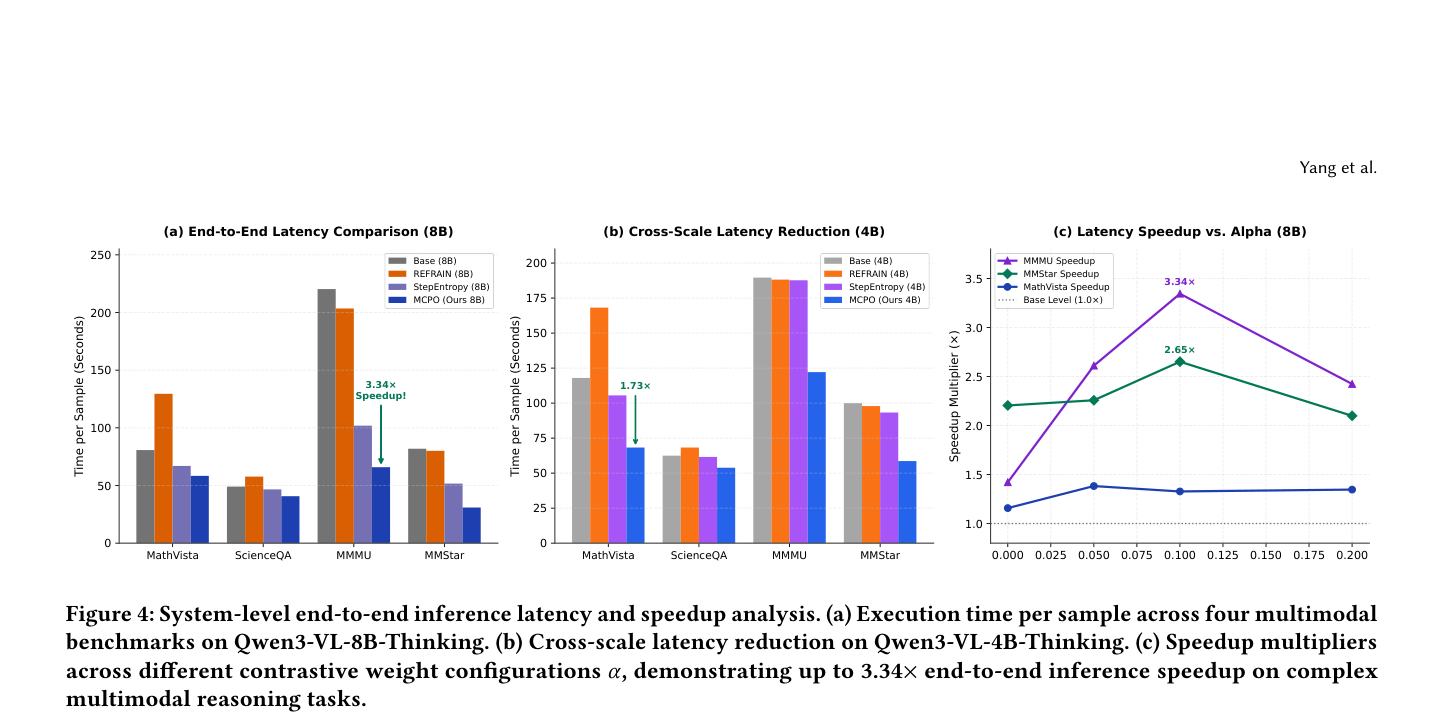
该图展示了系统级端到端推理延迟和加速比分析。图 (a) 展示了 Qwen3-VL-8B-Thinking 在四个多模态基准上的每个样本执行时间。图 (b) 展示了 Qwen3-VL-4B-Thinking 上的跨规模延迟减少。图 (c) 展示了不同对比权重配置 α 下的加速倍数,表明在复杂多模态推理任务上实现了高达 3.34× 的端到端推理加速。
实验如何设计?
- 在 Qwen3-VL-8B-Thinking 和 4B-Thinking 上,于 MathVista, ScienceQA, MMMU, MMStar 四个基准上进行主实验对比。
- 消融实验分析对比权重 α 和 [SKIP] token 嵌入冻结状态对性能的影响。
- 系统级推理延迟和加速比分析,涵盖不同难度级别(Easy/Medium/Hard)的 token 消耗和准确率变化。
关键结果与论文证据
- CoT 长度减少高达 69.5%,端到端推理加速高达 3.34×,Hard 任务准确率提升 +10.3%。(Page 1)
- 在 MathVista-mini 上,8B 模型 token 从 1188 降至 362 (↓69.5%),准确率仅降 0.80%。(Page 6)
- 在 MMMU Hard 难度下,α=0.2 时准确率从基线 40.6% 提升至 50.9%。(Page 8)
- 冻结 [SKIP] 嵌入导致 token 激增至 106.0 但准确率降至 52.00%;不冻结时保持 71.80% 准确率且 token 为 363.0。(Page 7)
阅读时需要注意
- 实验主要基于 Qwen3-VL 系列模型,对其他架构的泛化性未充分验证。
- NCMI 计算需要额外的前向传播(无图像上下文),增加了离线数据准备阶段的计算开销。
- 在 Medium 难度任务上,部分 α 设置(如 0.1, 0.2)导致准确率低于基线,表明压缩策略在中等难度任务上可能引入逻辑噪声。
关联工作
- StepEntropy:基线方法,基于步骤熵的静态剪枝,缺乏跨模态约束。(Page 3)
- REFRAIN:基线方法,无训练在线剪枝,通过滑动窗口 UCB 动态停止,但存在运行时开销。(Page 3)
- LCPO:相关工作,长度控制偏好优化,使用 Bradley-Terry 框架,但缺乏模态对比机制。(Page 3)
- V-Skip:相关工作,多模态推理中的视觉显著性保留,通过信息瓶颈实现加速。(Page 3)