快速导读:本文提出Spectral Tension作为诊断视频生成中时间注意力失衡的指标,并设计Spectral Transport Homeostasis这一无训练查询温度调节器,通过选择性纠正碎片化传输和过度混合热点来提升视频的时间一致性和视觉质量。
视频生成模型依赖时间注意力维持帧间一致性,但现有方法往往只关注增强跨帧交互,忽略了时间注意力本身可能处于碎片化或过度混合的失衡状态。本文提出Temporal State Transport视角,将时间注意力视为传输算子,强调其应保持在平衡传输区间。
基于此,作者定义了Spectral Tension指标,通过比较局部注意力扩散度与全局光谱多样性来诊断失衡方向,并设计了Spectral Transport Homeostasis这一无训练调节器,通过自适应调整查询温度来纠正失衡,从而在不修改模型权重的前提下提升视频质量。
英文题目:Temporal State Transport in Video Generation: Diagnosing and Correcting Spectral Imbalance
论文出处:arXiv 每日论文精选 · arXiv:2609.08505
原始论文:PDF / 论文页面
这篇论文解决什么问题?
当前视频生成模型如Wan2.2虽已引入时间注意力,但在复杂场景下仍频繁出现身份漂移、背景闪烁和运动不自然等问题。这些现象的根源在于时间注意力未能有效维持持久状态,即Temporal State Transport的失效。
现有training-free方法如Enhance-A-Video和FreeU主要通过放大注意力输出或增强跨帧交互来改善质量,但这类方法缺乏对注意力状态本身的诊断能力,无法区分是传输过弱导致的碎片化,还是传输过强导致的过度混合。
碎片化传输会导致帧间信息断裂,引发细节不稳定;而过度混合热点则会导致不同帧的特征相互污染,造成身份混淆。这两种相反的失败模式需要不同的干预策略,但现有方法往往采用统一的增强策略,导致次优结果。
因此,核心研究缺口在于缺乏一个能够量化时间注意力传输状态平衡性的诊断指标,以及一种能够根据失衡方向自适应调整干预强度的机制。
核心创新
- 提出Temporal State Transport视角,强调时间注意力应保持在平衡传输状态,而非单纯增强跨帧交互。
- 引入Spectral Tension作为简洁的诊断指标,量化局部扩散度与全局光谱多样性的差异。
- 设计Spectral Transport Homeostasis,一种无训练的查询温度调节器,能自适应地软化碎片化状态、锐化过度混合状态并保留平衡状态。
方法概览
1. 定义Spectral Tension $T(A) = \bar{H}_{row}(A) – \bar{H}_{vN}(A)$,比较局部注意力扩散度(行熵)与全局光谱多样性(von Neumann熵)。$T(A) < 0$表示碎片化,$T(A) > 0$表示过度混合,$T(A) \approx 0$表示平衡。2. 提出Spectral Transport Homeostasis,通过计算温度因子 $\gamma = \exp(\tau_{eff} T(A))$ 来调节查询向量 $Q' = \gamma Q$。3. 采用余弦调度策略 $\tau_{eff} = \tau \cdot w_l \cdot w_t$,在深层网络和早期去噪步骤施加更强的干预。
- Spectral Tension定义为行熵均值与von Neumann熵均值之差,即T(A) = H_row(A) – H_vN(A)。该指标捕捉了局部注意力分布的扩散程度与全局特征空间多样性的差异。
- 当T(A) < 0时,表示局部扩散度低于全局多样性,对应碎片化传输状态;当T(A) > 0时,表示局部扩散度高于全局多样性,对应过度混合状态;当T(A) ≈ 0时,表示传输处于平衡状态。
- Spectral Transport Homeostasis通过计算温度因子γ = exp(τ_eff * T(A))来调节查询向量Q' = γQ。当T(A)为负时,γ < 1,软化查询以增强碎片化状态的聚合;当T(A)为正时,γ > 1,锐化查询以抑制过度混合。
- τ_eff采用余弦调度策略,结合层权重w_l和时间步权重w_t,在深层网络和早期去噪步骤施加更强的干预,因为此时时间注意力对最终视频质量的影响更为显著。
- 该方法完全无训练,仅需在推理时计算注意力矩阵的熵和特征值,计算开销可控,且可无缝集成到现有视频生成管线中。
逐图理解论文
失败直觉
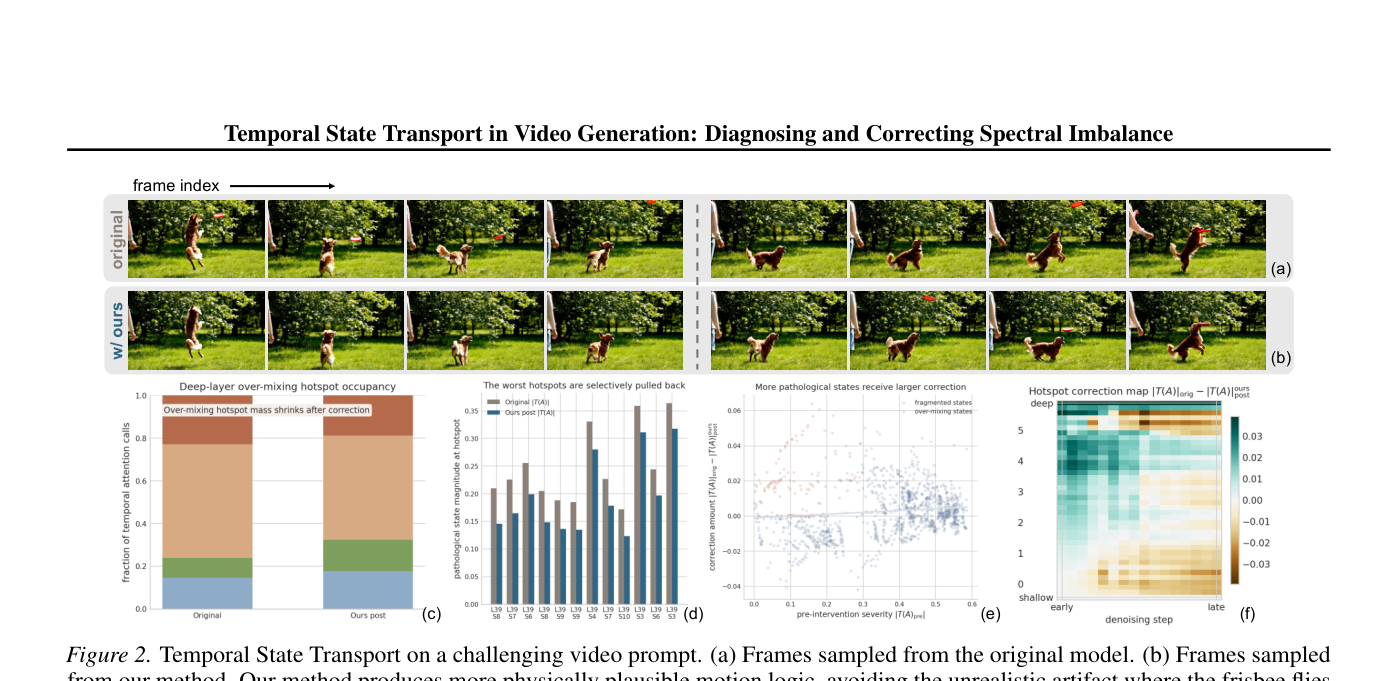
该图对比了原始模型与本文方法在挑战性提示词下的生成帧。重点观察原始模型中的身份漂移和背景闪烁现象,以及本文方法如何通过这些帧的稳定性体现时间一致性的提升。
核心贡献
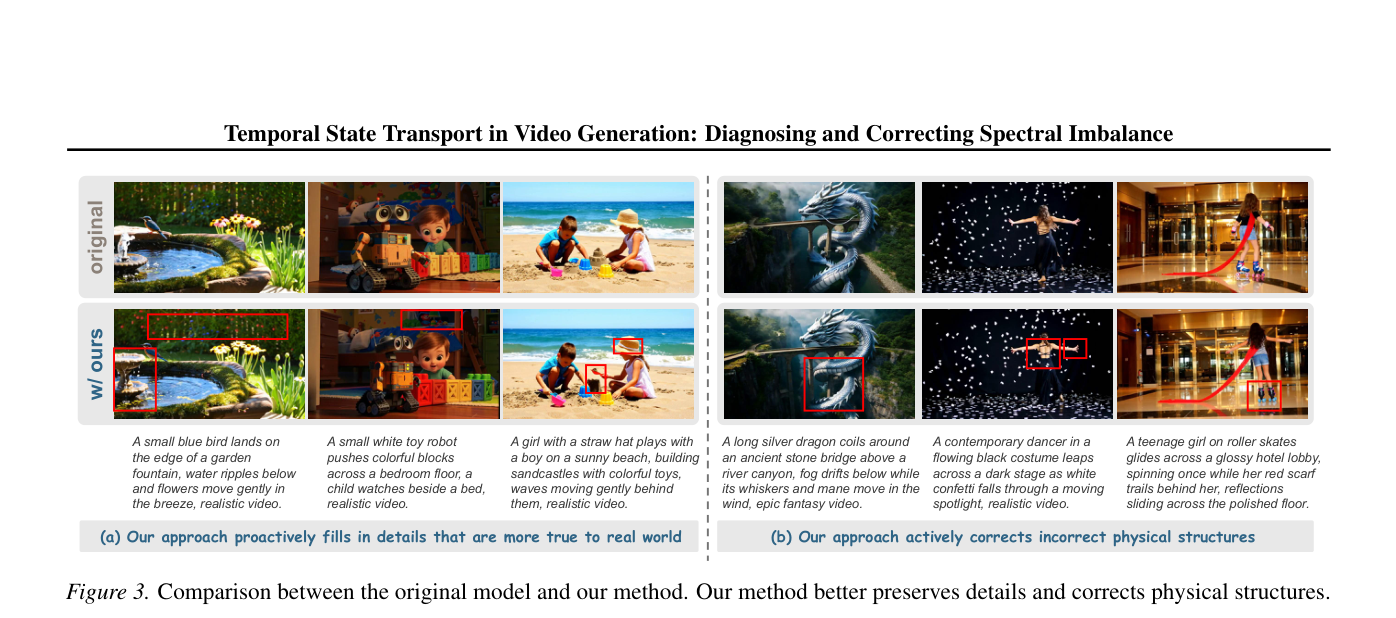
该图展示了细节保留和物理结构纠正的对比。检查本文方法如何在保持运动自然的同时,修复原始模型中的细节不稳定和结构错误,以验证方法对视觉质量的改善。
机制验证
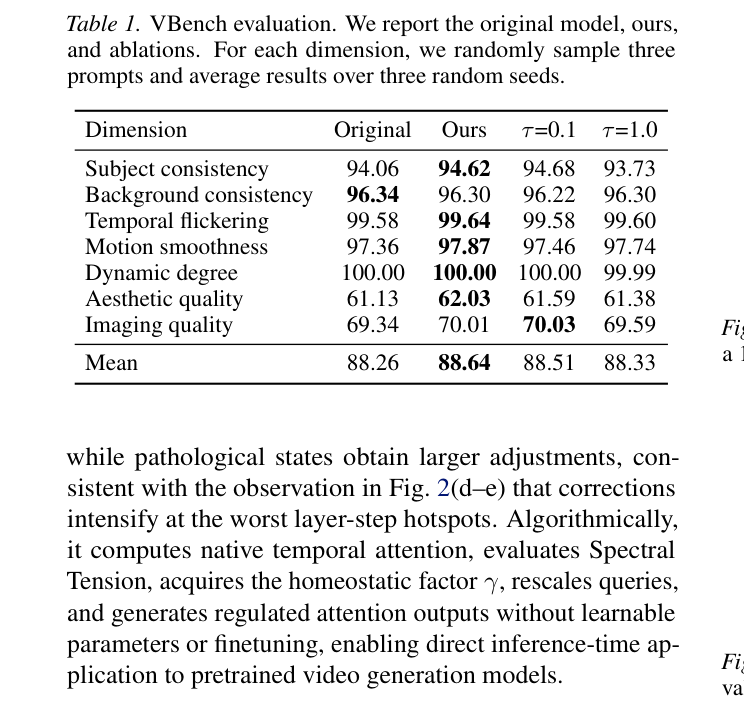
该表汇总了VBench评估结果。关注本文方法在各维度上相对于原始模型的提升幅度,特别是Aesthetic Quality和Imaging Quality的显著改善,以支持方法的有效性。
结论与局限
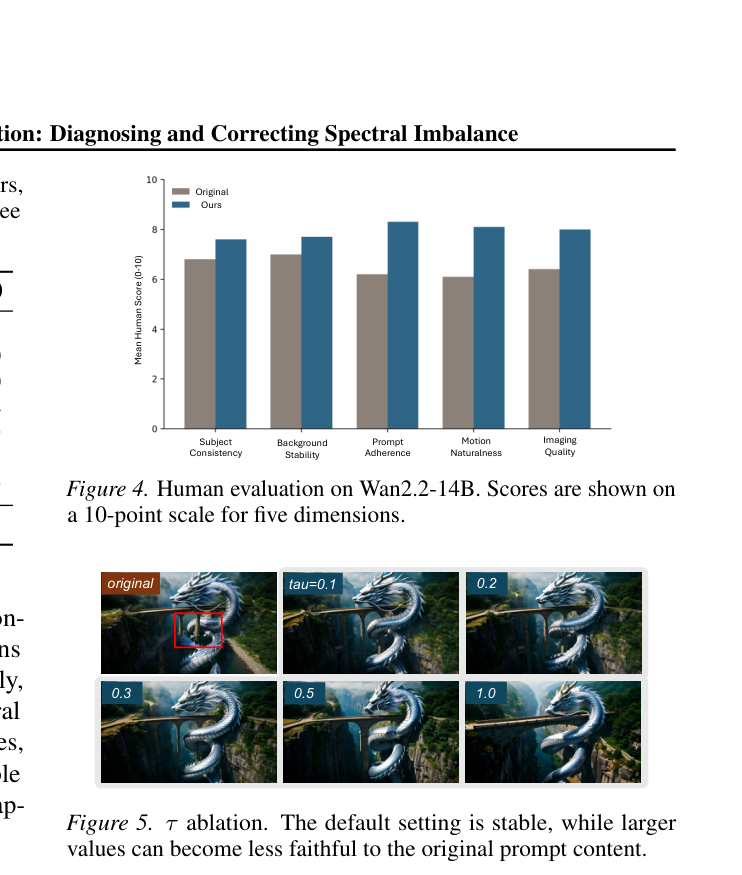
该图展示了τ消融实验结果。检查不同τ值对输出忠实度的影响,特别是较大τ值导致的内容偏离现象,以理解超参数选择的敏感性及默认设置的稳定性。
实验如何设计?
- 实验基于Wan2.2和Wan2.2-14B模型,使用VBench基准进行自动化评估,涵盖运动平滑度、美学质量、成像质量等多个维度。
- 人工评估在Wan2.2-14B上进行,选取30个多样化提示词,由50名评分者在5个维度上进行10分制打分,以验证方法的主观质量提升。
- 机制分析对30个随机采样提示词进行深度追踪,记录38,400个处理器调用,分析Spectral Tension变化、调节方向正确性及层-步调度效果。
- 消融实验测试不同τ值对输出忠实度的影响,验证默认设置的稳定性及过大τ值可能导致的内容偏离风险。
关键结果与论文证据
- VBench评估显示,本文方法在Overall Score、Motion Smoothness、Aesthetic Quality和Imaging Quality上均优于原始模型,其中Aesthetic Quality提升最为显著(第4页)。
- 人工评估结果与VBench趋势一致,本文方法在时间一致性和视觉质量维度上获得更高平均分,证实了自动化指标与主观感知的对齐(第4页)。
- 机制分析表明,在活跃调用中,Spectral Tension的绝对值平均降低6.4%,且100%的活跃调用显示出正确的调节方向,即γ的符号与T(A)的符号严格匹配(第7-8页)。
- 逐样本符号检验显示,Spectral Tension降低、Self-retention增加和Effective rank增加均具有统计显著性,Cohen's d效应量分别为-0.508、+0.402和+0.447(第9-10页)。
- 层-步调度分析证实,深层网络和早期去噪步骤的干预对最终质量贡献最大,支持了余弦调度策略的设计合理性(第11页)。
阅读时需要注意
- 实验主要局限于Wan2.2系列模型,对DiT变体或其他架构的泛化性未充分验证,可能受限于特定注意力实现。
- Spectral Tension计算涉及特征值分解,在极高帧数或长视频生成中可能引入额外计算开销,尽管论文声称轻量级,但实际部署需评估延迟影响。
- 人工评估样本量较小(30个提示词),统计显著性可能受限于样本多样性,未来需扩大评估规模以增强结论鲁棒性。
- 超参数τ对结果敏感,较大τ值可能导致输出偏离原始提示内容,实际应用中需根据内容类型精细调整。
关联工作
- 与Enhance-A-Video相比,本文方法不单纯增强跨帧交互,而是通过诊断失衡方向进行针对性调节,避免了盲目增强可能带来的过度混合风险。
- 与FreeU相比,本文方法通过调节查询温度改变注意力聚合方式,而非放大注意力输出,从而在保持特征多样性的同时纠正失衡。
- 与FreeLong的SpectralBlend时间注意力相比,本文关注时间状态传输的平衡性,而非长视频生成的特定挑战,提供了更通用的诊断框架。