快速导读:本文提出 ZDPShift 基准和轻量级修改方法,解决了现有立体匹配模型无法处理负视差(屏幕后内容)的问题,证明预训练特征已具备符号无关性,仅需调整输出约定即可恢复负视差估计能力。
立体匹配是三维视觉的核心任务,但现有模型普遍假设视差非负,导致无法处理位于屏幕后(recede)的内容。本文指出,这一限制并非源于特征学习能力不足,而是源于数据集、架构和评估协议中根深蒂固的非负几何假设。
作者提出 ZDPShift 基准和轻量级符号匹配方法,证明预训练特征已具备符号无关性。通过扩展 cost-volume 假设范围并调整输出约定,现有 SOTA 模型即可恢复负视差估计能力,且无需增加参数,同时保持正视差精度。
英文题目:Disparity Has a Sign: Stereo Matching Beyond the Zero-Disparity Plane
论文出处:arXiv 每日论文精选 · arXiv:2609.06809
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在 3D 电影和 VR 内容中,零视差平面(ZDP)是组织空间深度的关键参考。内容可位于屏幕前(pop-out)或屏幕后(recede)。然而,标准立体匹配流水线使用校正平行相机,将 ZDP 置于无穷远,导致所有有限深度产生非负视差。
现有 SOTA 模型如 FoundationStereo 和 Stereo-Any-Video 在视差跨越 ZDP 时失效。实验显示,当 ZDP 偏移增大时,EPE 急剧上升,模型完全无法表示屏幕后视差。
这一失效并非孤立现象,而是整个研究范式的系统性偏差。从 SceneFlow 到 KITTI,现有数据集均不包含负视差像素,导致模型在训练和评估中从未接触过屏幕后内容。
因此,问题不在于模型容量或特征质量,而在于输出约定和假设范围。解决这一问题需要重新定义视差的符号语义,并构建支持符号真值的基准。
核心创新
- 首个包含负视差像素的公开立体匹配基准 ZDPShift
- 证明预训练匹配特征已具备符号无关性,仅需调整输出约定
- 轻量级修改方法:无需增加参数即可恢复负视差估计能力
- 在保持正视差精度的同时实现全符号范围估计
方法概览
1. 提出 ZDPShift 基准:从 7 部开源电影渲染 21,375 对立体图像,每帧在 5 个 ZDP 位置渲染,提供密集符号真值。2. 符号监督:通过平移 SceneFlow 右图并重新标记视差生成符号监督数据。3. 符号假设范围:扩展 cost-volume 方法的假设范围至 [-d_neg, d_pos],无需增加参数。4. 冻结匹配特征:仅训练解码器,验证预训练特征已支持负视差。
- ZDPShift 基准:从 7 部开源电影渲染 21,375 对立体图像,每帧在 5 个 ZDP 位置渲染,提供密集符号真值。该基准是首个包含负视差像素的公开数据集。
- 符号监督生成:通过平移 SceneFlow 右图并重新标记视差,生成符号监督数据。这种方法无需重新渲染,即可为现有合成数据添加符号信息。
- 符号假设范围扩展:将 cost-volume 方法的假设范围从 [0, d_max] 扩展至 [-d_neg, d_pos]。这一修改不增加参数,仅改变搜索空间,使模型能够表达负视差。
- 冻结匹配特征:仅训练解码器,验证预训练特征已支持负视差。实验表明,冻结特征版本与全训练版本性能差异极小,证明特征本身已具备符号无关性。
- 输出约定调整:将视差输出从非负约定调整为符号约定,使模型能够正确区分屏幕前和屏幕后内容。这一调整是恢复负视差能力的关键步骤。
逐图理解论文
失效直觉
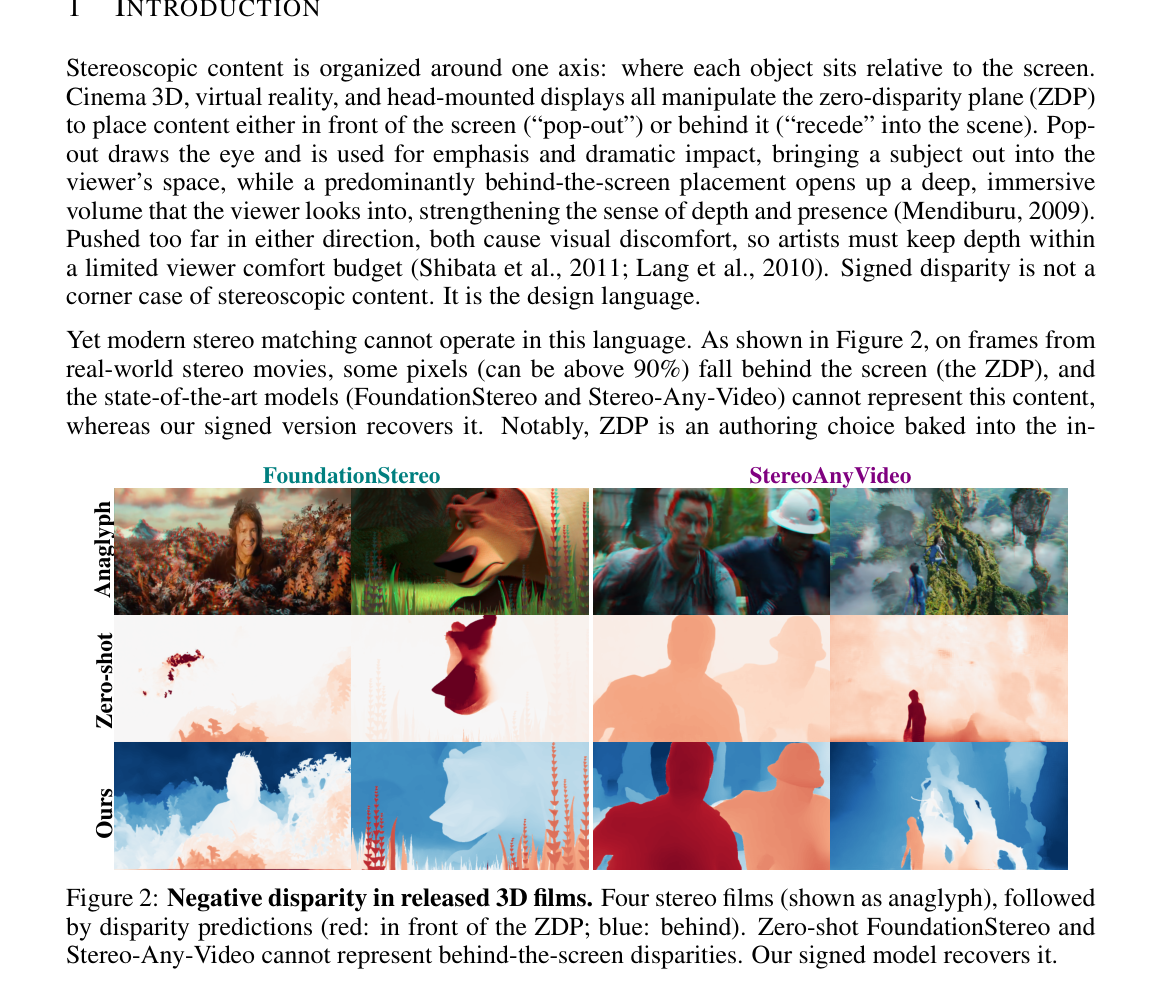
该图展示真实 3D 电影中的负视差区域。红色表示屏幕前,蓝色表示屏幕后。现有模型无法预测蓝色区域,而本文方法可正确恢复。此图直观说明了问题的重要性和方法的必要性。
研究缺口
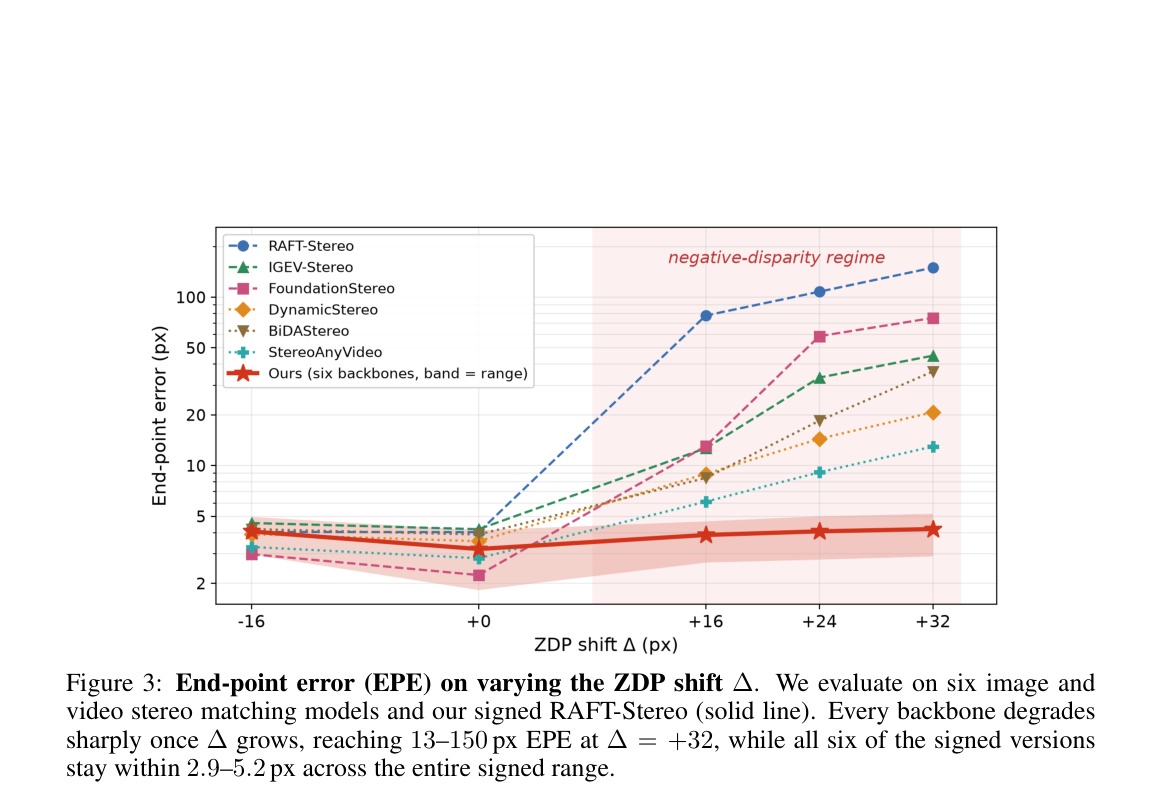
该图展示 EPE 随 ZDP 偏移的变化。现有模型在偏移增大时 EPE 急剧上升,而符号版本保持平稳。此图是核心证据,证明非负假设是失效主因。
核心贡献
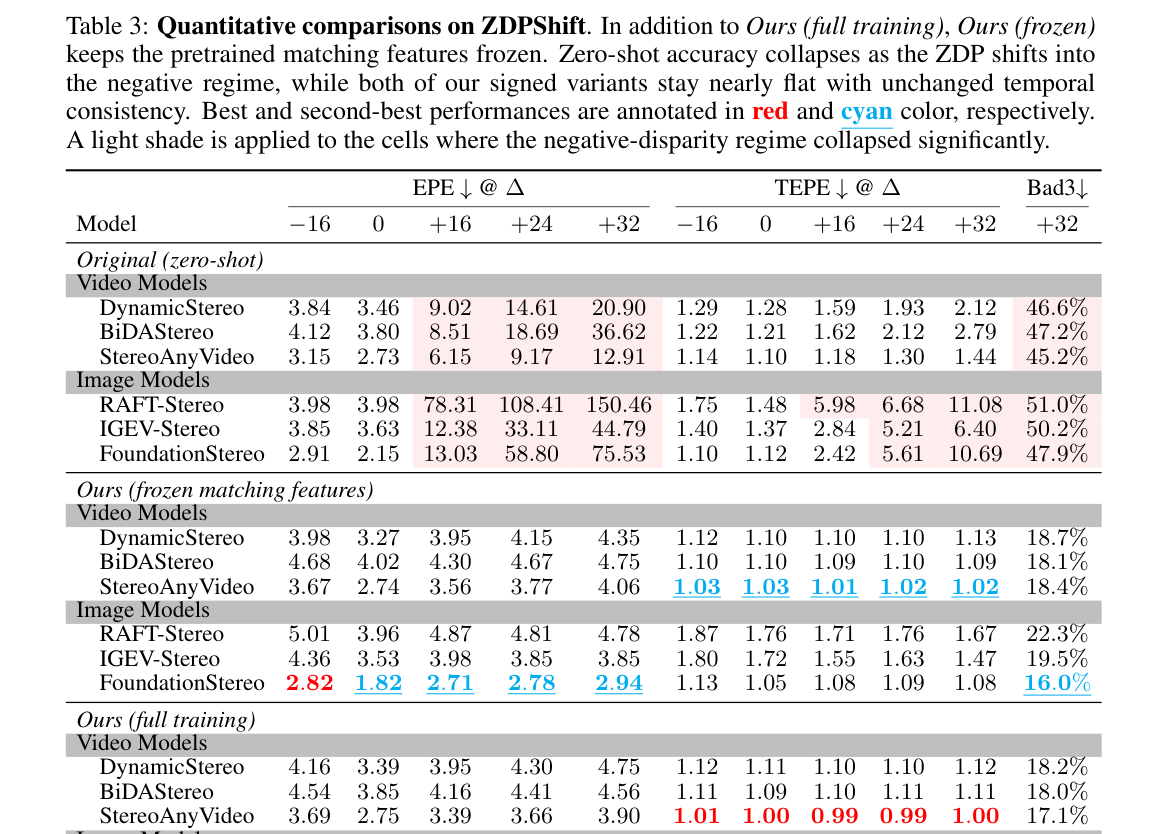
该表展示 ZDPShift 上的定量比较。零样本模型在负视差区域性能崩溃,而符号版本保持平稳。此表验证了方法的有效性和冻结特征的可行性。
最强结论
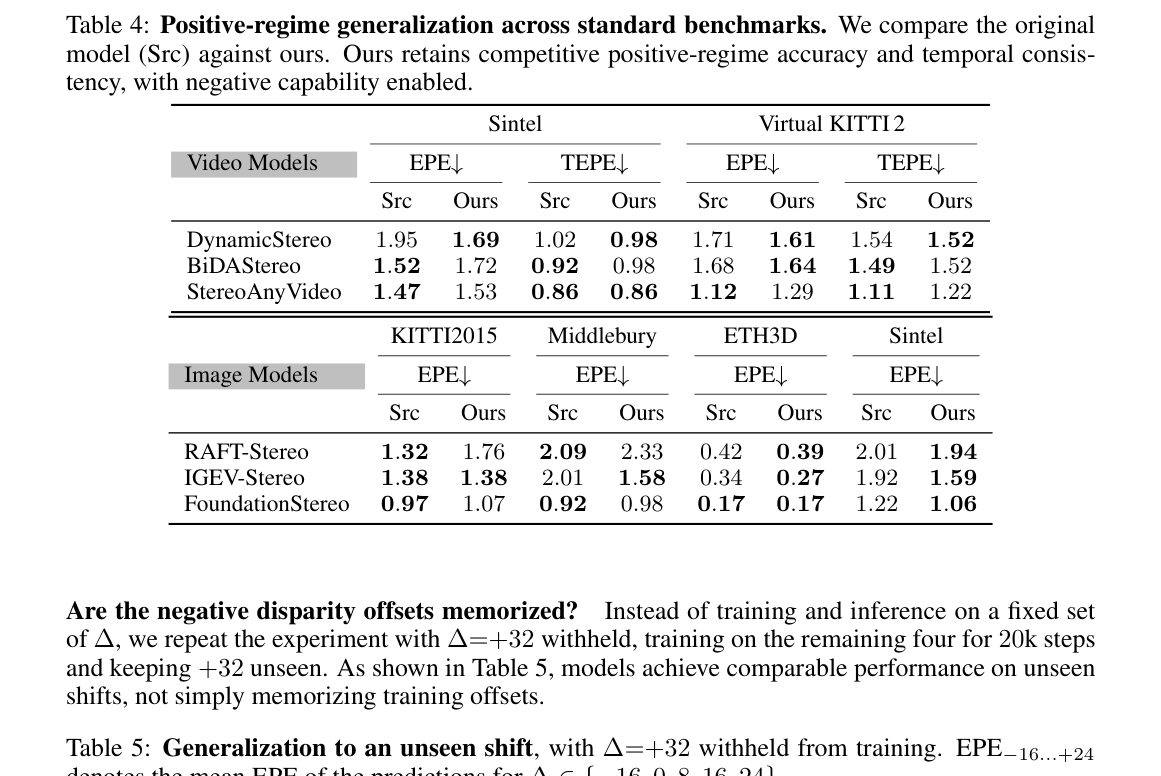
该表展示标准基准上的正视差精度保持。符号修改未损害原有性能,验证了方法的兼容性。此图消除了对性能退化的担忧。
意义与局限
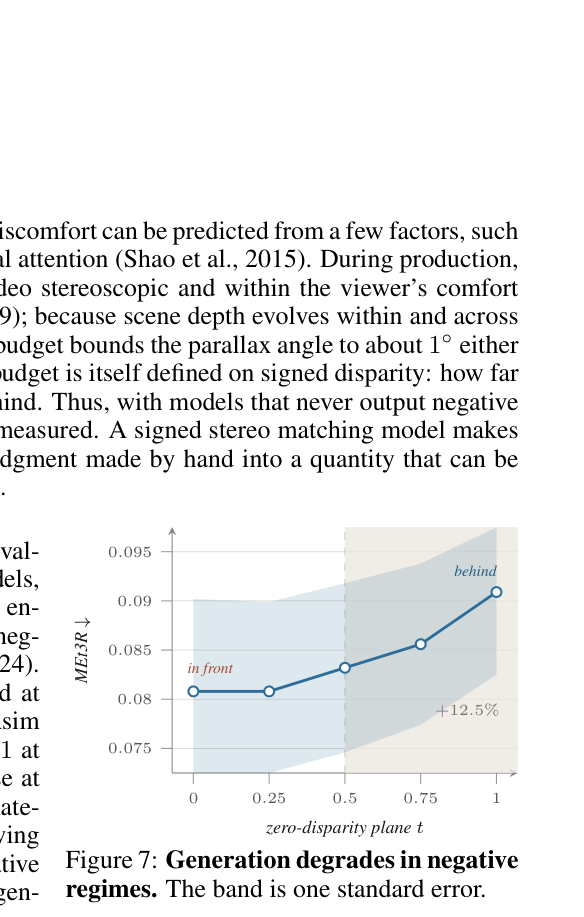
该图展示生成质量在负视差区域的退化。生成模型在屏幕后内容上性能下降,表明符号问题也影响生成任务。此图扩展了研究的影响范围。
实验如何设计?
- 在 ZDPShift 上评估 6 个 SOTA 模型(3 图像 + 3 视频),对比零样本、冻结特征、全训练三种设置。
- 在 KITTI、Middlebury、ETH3D、Sintel 等标准基准上验证正视差精度保持,确保符号修改不损害原有性能。
- 测试未见 ZDP 偏移的泛化能力,验证方法对未知偏移的鲁棒性。
- 评估立体生成模型在负视差区域的性能,分析生成质量在符号变化下的退化情况。
关键结果与论文证据
- 现有模型在 ZDP 偏移增大时 EPE 急剧上升,而符号版本保持平稳,证明非负假设是失效主因(第 3 页)。
- 冻结匹配特征版本与全训练版本性能差异极小,证明预训练特征已具备符号无关性(第 7 页)。
- 符号修改在标准基准上保持正视差精度,未引入性能退化(第 8 页)。
- 方法对未见 ZDP 偏移具有良好泛化能力,验证了假设范围扩展的鲁棒性(第 8 页)。
- 立体生成模型在负视差区域生成质量退化,表明符号问题也影响生成任务(第 9 页)。
阅读时需要注意
- 符号输出空间引入新失败模式:在模糊、低纹理内容中,模型可能翻转区域符号,导致视差抖动。
- 符号真值仅存在于渲染内容中,真实交付的立体电影无视差真值,只能定性验证。
- 需要未来工作开发包含负视差的真实世界捕获立体内容,以支持大规模验证。
关联工作
- FoundationStereo 和 Stereo-Any-Video 是现有 SOTA 模型,但均无法表示屏幕后视差,本文方法可将其升级为符号版本。
- RAFT-Stereo 和 IGEV-Stereo 是典型 cost-volume 方法,本文通过扩展其假设范围实现符号支持,无需修改核心架构。
- SceneFlow 是合成数据集,本文通过平移右图生成符号监督,扩展了其应用范围。
- DUSt3R/MASt3R/VGGT 是场景空间几何范式,对 ZDP 不敏感,但精度远低于立体匹配要求,本文方法在精度上更具优势。