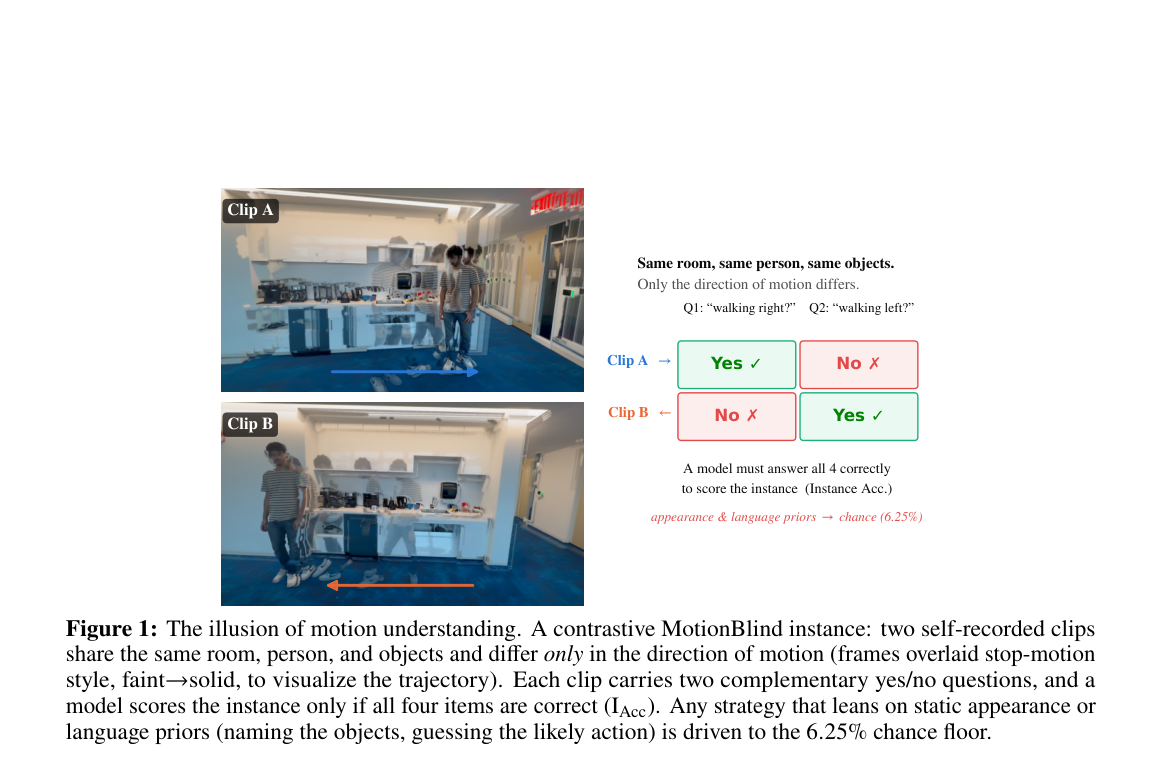
快速导读:本文提出 MotionBlind 基准,通过对比式自录制视频揭示当前 Video-LLM 在物理运动感知(速度、幅度、方向)上的根本缺陷,证明增加帧数或优化帧选择策略无法弥补这一感知瓶颈。
Video-LLM 常被用作 World Model 的感知前端,但现有基准往往高估其时间理解能力。MotionBlind 通过对比式自录视频,揭示了模型在物理运动感知上的根本缺陷。
该研究证明,当前模型常依赖静态外观或语言先验作答,而非真实运动信息。增加帧数或优化帧选择策略无法弥补这一感知瓶颈,模型未能真正编码运动信息。
英文题目:MotionBlind: Probing the Illusion of Motion Understanding in Video-LLMs
论文出处:arXiv 每日论文精选 · arXiv:2609.09528
原始论文:PDF / 论文页面
这篇论文解决什么问题?
World Model 需要预测环境演化,依赖多模态模型进行状态标注和奖励检测。然而,现有视频 QA 任务允许模型通过单帧或语言先验作答,掩盖了其对运动动力学的感知盲区。
MotionBlind 采用 2×2 对比协议,要求模型同时正确回答四个互补问题。通过控制变量,隔离运动感知,填补了 TimeBlind 在物理运动控制变量上的空白。
核心创新
- 提出 MotionBlind 基准,专注于物理运动属性(速度、幅度、方向)的对比式评估,填补了 TimeBlind 在物理运动控制变量上的空白。
- 揭示“运动理解幻觉”:模型在单项准确率(Acc)上表现良好(~50-60%),但在实例准确率(IAcc)上接近随机水平,表明其无法区分成对视频中的运动差异。
- 证明帧选择策略(包括 GRPO 训练的 HORNet 和无训练的 Frame2Clip)无法解决运动感知问题,因为问题在于模型未能编码运动信息,而非看到的帧不够多或不够好。
方法概览
构建 MotionBlind 基准(60 个对比实例,82 个自录制片段,240 个 QA 项),采用 2×2 对比协议,要求模型同时正确回答四个互补问题(IAcc 指标,随机基线 6.25%)。通过控制变量(相同场景、人物,仅运动属性不同)隔离运动感知。评估 6 个开源模型和 2 个前沿模型,测试不同帧预算(1-24 帧)和选择策略(Uniform, Random, HORNet, Frame2Clip),并进行完整性探针(无视频、乱序、逆序)。
- 构建 MotionBlind 基准,包含 60 个对比实例、82 个自录制片段和 240 个 QA 项。
- 采用 2×2 对比协议,要求模型同时正确回答四个互补问题,使用 IAcc 指标评估。
- 通过控制变量,相同场景、人物,仅运动属性不同,隔离运动感知。
- 评估 6 个开源模型和 2 个前沿模型,测试不同帧预算和选择策略。
- 进行完整性探针,包括无视频、乱序、逆序,验证任务依赖视频和时间顺序。
逐图理解论文
直觉与失败案例
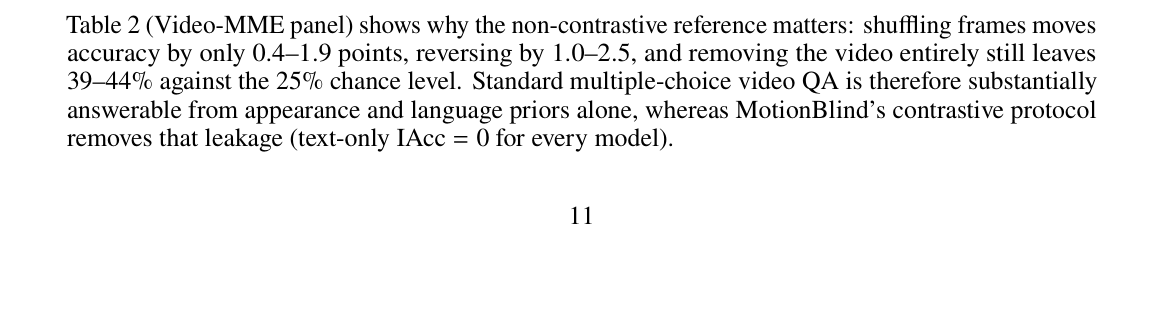
该表展示了 Video-MME 面板,打乱帧顺序仅使准确率下降 0.4-1.9 点,移除视频后仍保持 39-44% 准确率,远高于 25% 的随机基线,表明标准基准存在严重的语言/外观泄漏。
核心区分与研究空白
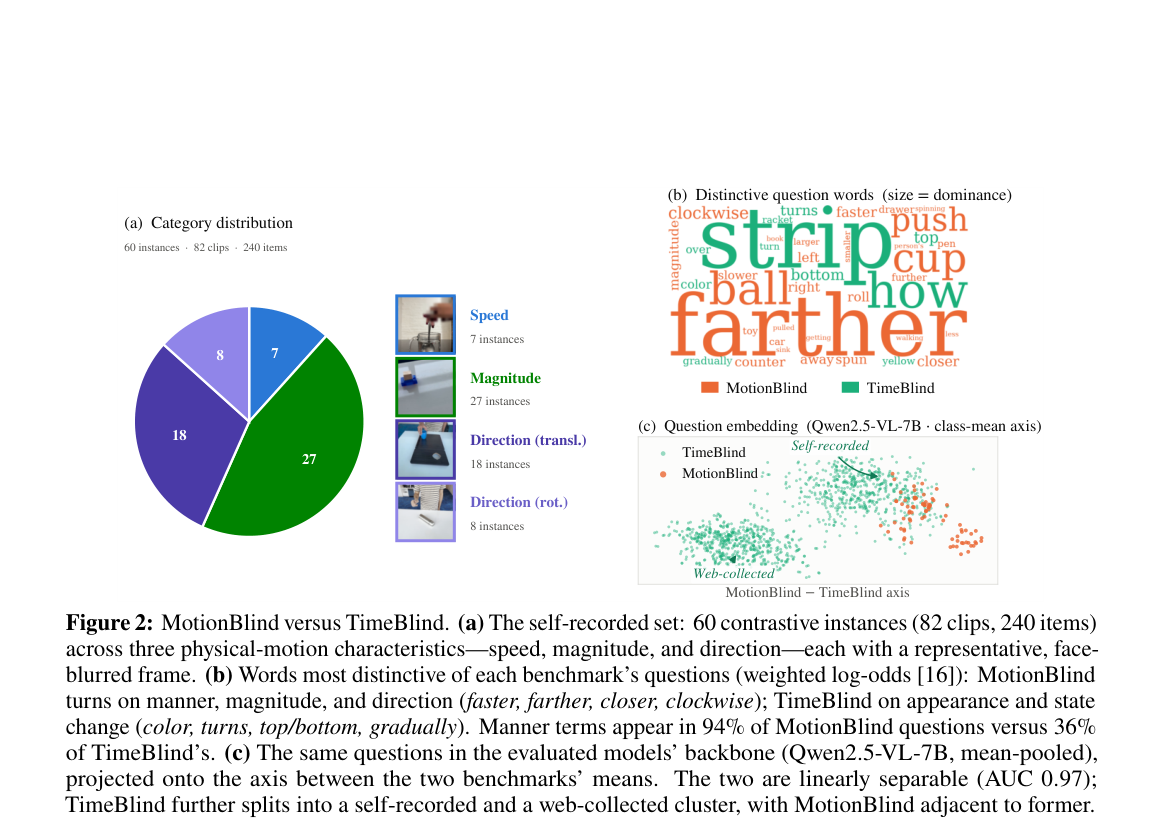
MotionBlind 通过对比式自录视频,隔离物理运动属性,填补了 TimeBlind 在速度、幅度、方向等运动动力学上的评估空白。
核心贡献与验证
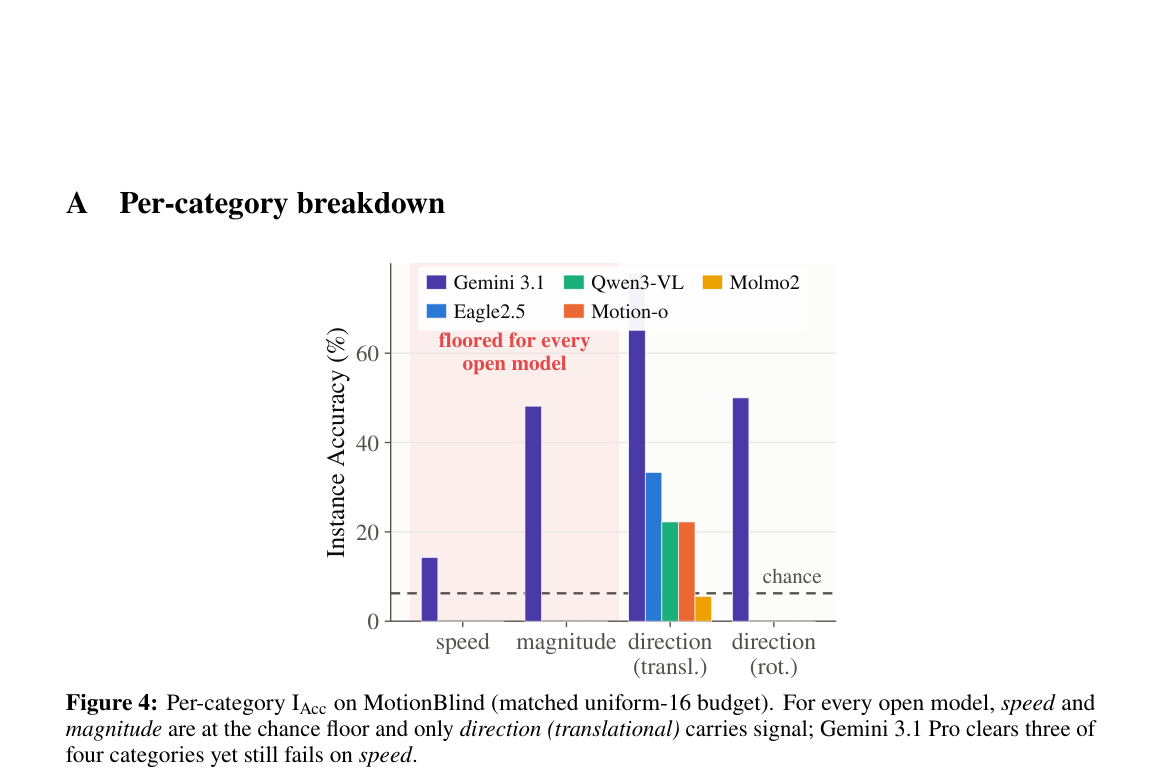
该图展示了不同类别的 IAcc,所有开源模型在速度和幅度类别上均处于随机基线,仅方向类别有信号。Gemini 3.1 Pro 在四个类别中三个超过基线,但在速度类别上仍失败。
最强结论
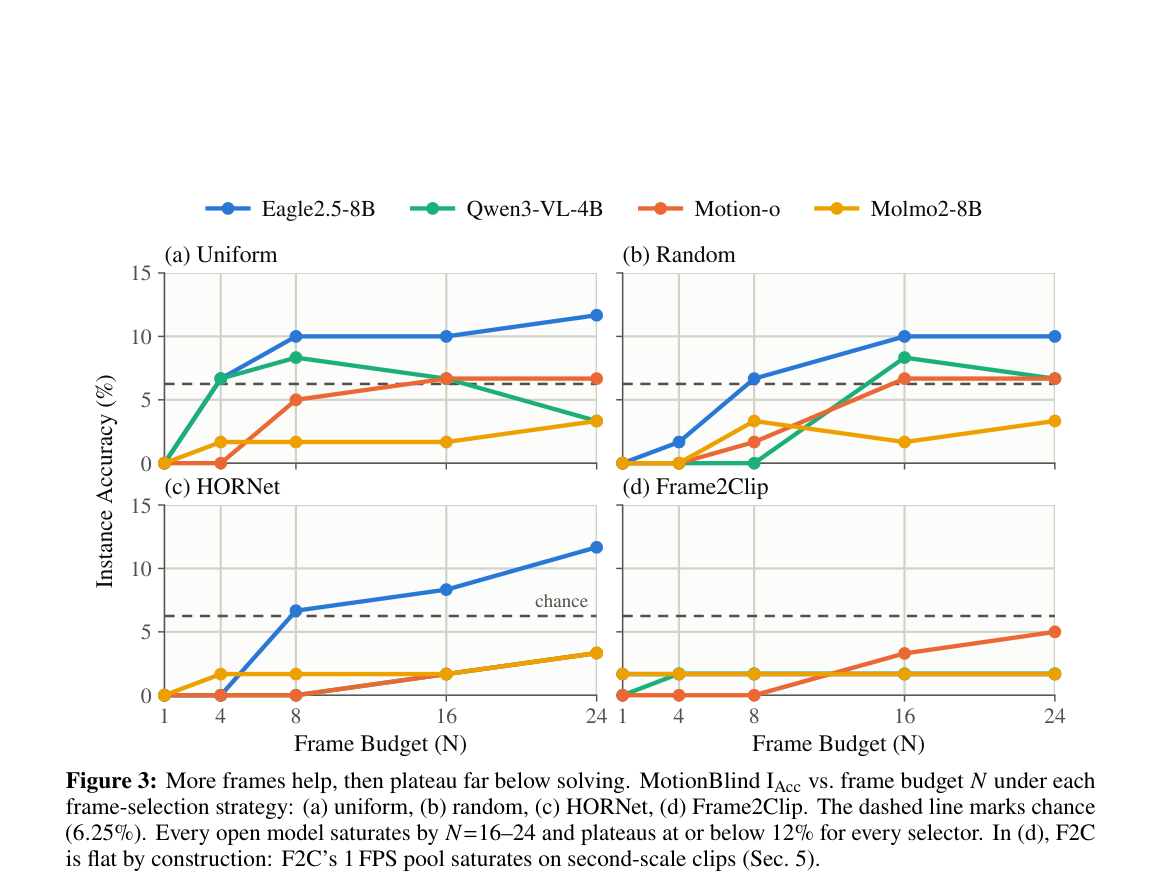
该图展示了不同帧选择策略下,MotionBlind IAcc 随帧预算 N 的变化。所有开源模型在 N=16-24 时饱和,且 IAcc 均低于 12%,证明增加帧数无法解决运动感知问题。
实验如何设计?
- 在 MotionBlind 上评估 6 个开源 Video-LLM 和 2 个前沿模型。
- 对比 TimeBlind 和 Video-MME,校准模型能力。
- 测试不同帧预算(N=1, 4, 8, 16, 24)和四种帧选择策略。
- 进行完整性探针,移除视频、打乱帧顺序、反转帧顺序。
关键结果与论文证据
- 开源模型在 MotionBlind 上的 IAcc 普遍低于 12%,最佳 Eagle2.5-8B 为 11.7%,而随机基线为 6.25%。
- Gemini 3.1 Pro 在 MotionBlind 上达到 60.0% IAcc,是唯一显著超过基线的模型,但在速度类别上仍失败。
- 移除视频或打乱帧顺序后,所有模型在 MotionBlind 上的 IAcc 降至 0% 或接近 0%,证明任务依赖视频和时间顺序。
- 在 Video-MME 上,移除视频后模型准确率仍保持在 39-44%,远高于 25% 的随机基线,表明标准基准存在严重的语言/外观泄漏。
- 人类在 MotionBlind 上的平均 IAcc 为 91.3%,单项 Acc 为 97.8%,证明任务对人类是容易解决的。
阅读时需要注意
- 样本量较小,可能存在小样本方差。
- 所有片段均为室内单人录制,缺乏野外和第一人称视角的泛化性。
- 受限于 Yes/No 解析,可能低估了模型无法以二元形式表达的推理能力。
- 开源模型参数规模 ≤12B,难以完全区分架构限制和规模限制。
关联工作
- TimeBlind 是互补基准,采用相同的 2×2 对比协议和 IAcc 指标,但侧重于语义时间推理。
- Video-MME 是非对比式标准视频 QA 基准,用于校准模型的一般视频理解能力。
- HORNet 是基于 GRPO 训练的帧选择器,本文评估其在运动感知任务上的有效性。
- Frame2Clip 是无训练的关键片段选择器,本文评估其在短片段运动感知上的表现。