快速导读:本文提出HEAL方法,通过因果噪声干预和反事实双重差分法解耦注意力头信息,发现幻觉源于协同头中视觉-语言信息分布偏离平衡态,并据此在推理时动态校准信息分布以有效抑制幻觉。
多模态大语言模型在视觉问答中常产生与图像内容不符的幻觉,现有缓解方法多依赖注意力权重等间接信号,缺乏对内部信息转移机制的准确刻画。本文提出HEAL框架,通过因果噪声干预和反事实双重差分法解耦注意力头内的视觉、语言与协同信息,发现幻觉的根本原因是协同头中信息分布偏离平衡态,并据此在推理时动态校准以抑制幻觉。
HEAL在LLaVA、Qwen-VL和InternVL等主流模型上验证了有效性,在POPE、CHAIR等基准上显著降低幻觉率,同时保持综合多模态能力。该方法无需重训练,计算开销低,为理解多模态模型内部机制提供了新视角,也为推理时干预提供了可解释、可预测的工具。
英文题目:MLLMs Hallucinate when Information Distribution Drifts in Synergy Heads
论文出处:arXiv 每日论文精选 · arXiv:2609.09206
原始论文:PDF / 论文页面
这篇论文解决什么问题?
多模态大语言模型通过视觉编码器、投影器和语言骨干实现图文理解,但在生成过程中常出现幻觉,即输出与视觉上下文不一致的内容。现有缓解方法分为宏观(重训练、架构扩展)和微观(解码优化、注意力增强)两类,但微观方法往往缺乏对内部机制的可解释性,且难以平衡视觉与语言依赖,易导致跷跷板效应。
注意力头是语言骨干中信息处理的基本单元,但现有研究多将其视为黑盒,或通过注意力权重间接推断其功能。本文指出,注意力头内部包含视觉、语言、先验和协同等多种信息成分,这些成分的分布状态直接影响生成质量。幻觉并非由单一模态头的异常引起,而是协同头中视觉与语言信息分布偏离健康平衡态的结果。
为准确解耦头内信息,本文借鉴部分信息分解理论,提出反事实双重差分法。通过独立掩码视觉和语言token,构建四种反事实输入,计算头内的纯视觉、纯语言、先验和协同信息,从而将头分类为冗余、视觉、语言和协同头。这一分类为后续动态校准提供了基础。
核心创新
- 提出HEAL框架,利用因果噪声干预和反事实DiD将注意力头细粒度分类为四种功能类型,提供可解释的MLLM内部机制视角。
- 发现幻觉的根本原因是协同头中视觉-语言信息分布偏离健康平衡态,而非模态特定头的数量或强度,并刻画了注意力头的“任务驱动相变”动态行为。
- 引入基于平衡因子α的动态校准策略,理论上证明value空间校准等价于信息分布校准,且平衡因子对视觉对齐具有单调方向性效应,实现可预测的幻觉抑制。
方法概览
HEAL包含三个核心步骤:1. 因果噪声干预:将注意力头输出替换为分布匹配的高斯噪声,计算信息贡献度,筛选出因果冗余头;2. 反事实双重差分(DiD):通过独立掩码视觉和语言token构建四种反事实输入,解耦头内的纯视觉、纯语言、先验和协同信息,将头分类为冗余、视觉、语言和协同头;3. 动态信息校准:引入平衡因子α,动态调整协同头中视觉和语言value向量的校准因子β和γ,使信息分布回归目标平衡态,从而抑制幻觉。
- 因果噪声干预:将注意力头输出替换为分布匹配的高斯噪声,计算信息贡献度,筛选出因果冗余头,确保后续分析基于实际因果贡献而非相关性。
- 反事实双重差分:通过独立掩码视觉和语言token,构建四种反事实输入,解耦头内的纯视觉、纯语言、先验和协同信息,实现细粒度信息分解。
- 头类型分类:根据解耦后的信息成分,将注意力头分为冗余、视觉、语言和协同头,其中协同头同时包含显著视觉和语言信息,且存在多模态协同效应。
- 信息漂移观测:对比幻觉token和正确token生成时协同头内的视觉与语言信息比例,发现幻觉token的协同头中视觉信息比例显著偏低,语言信息比例偏高,表明信息分布偏离平衡态。
- 动态信息校准:引入平衡因子α,动态调整协同头中视觉和语言value向量的校准因子β和γ,使信息分布回归目标平衡态,从而抑制幻觉。
- 理论证明:证明value空间校准等价于信息分布校准,且平衡因子α对视觉对齐具有单调方向性效应,α越大越依赖视觉信息,幻觉抑制效果越显著。
- 周期性更新策略:头类型分布具有时间局部性,短期窗口内变化微小,因此采用周期性更新策略,在精度和计算开销间取得平衡。
逐图理解论文
直觉与失败案例
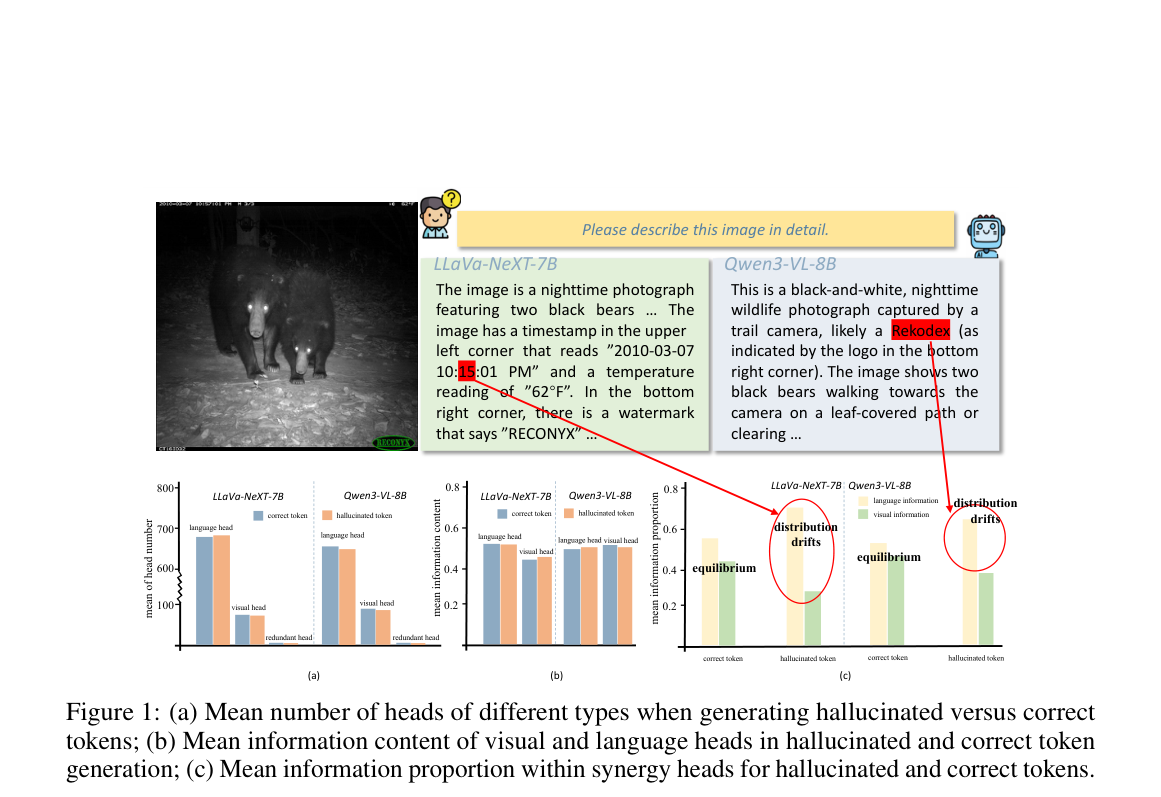
该图展示了幻觉token与正确token生成时不同类型头的平均数量、视觉和语言头的平均信息量,以及协同头内的平均信息比例。重点观察协同头内视觉与语言信息比例的差异,这是发现信息漂移的关键证据。
研究缺口与核心区分
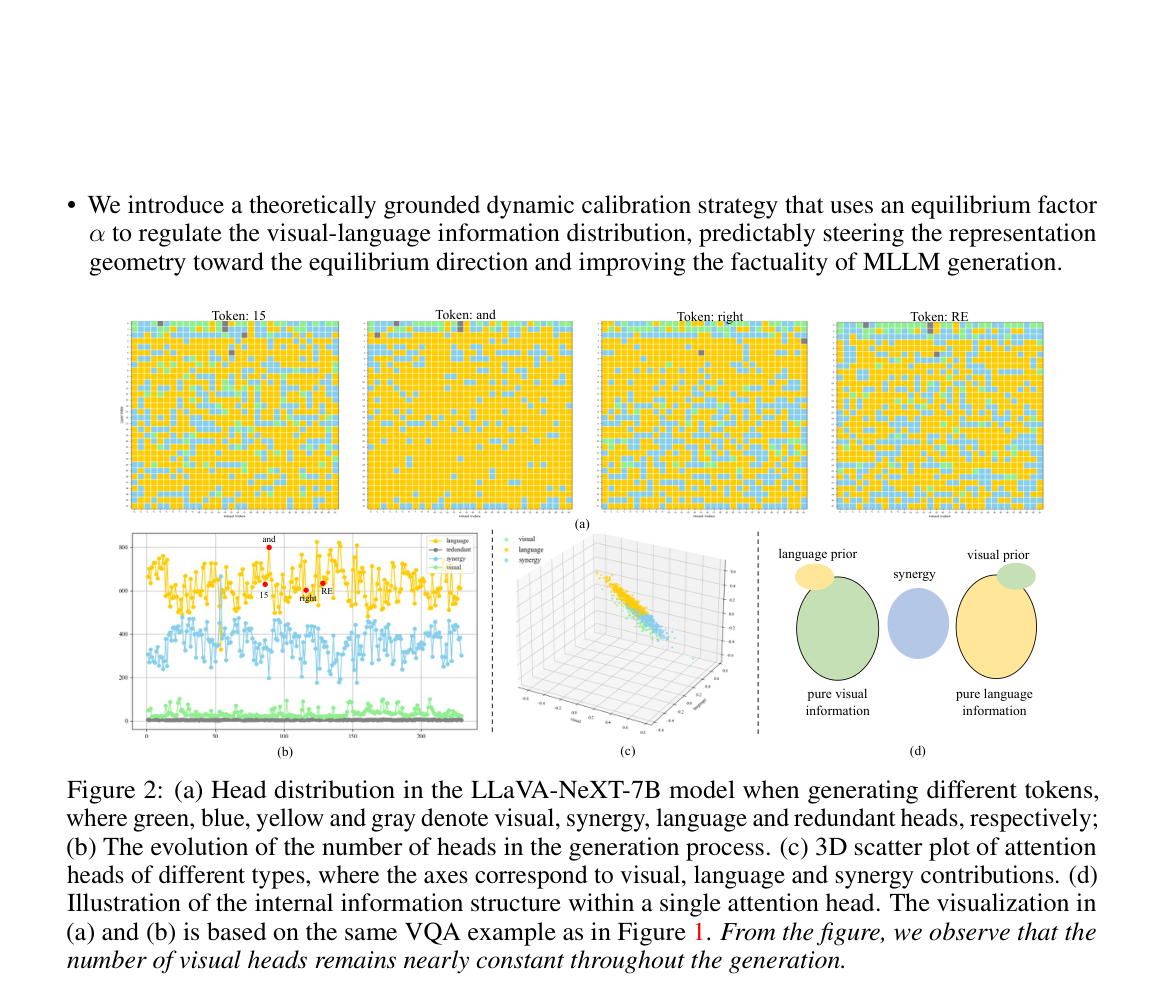
该图展示了LLaVA-NeXT-7B模型中不同token生成时的头分布、头数量演化、不同类型头的3D散点图,以及单个注意力头内的信息结构。重点观察协同头在3D散点图中的位置,以及头数量在生成过程中的动态变化,理解任务驱动相变。
HEAL方法与贡献
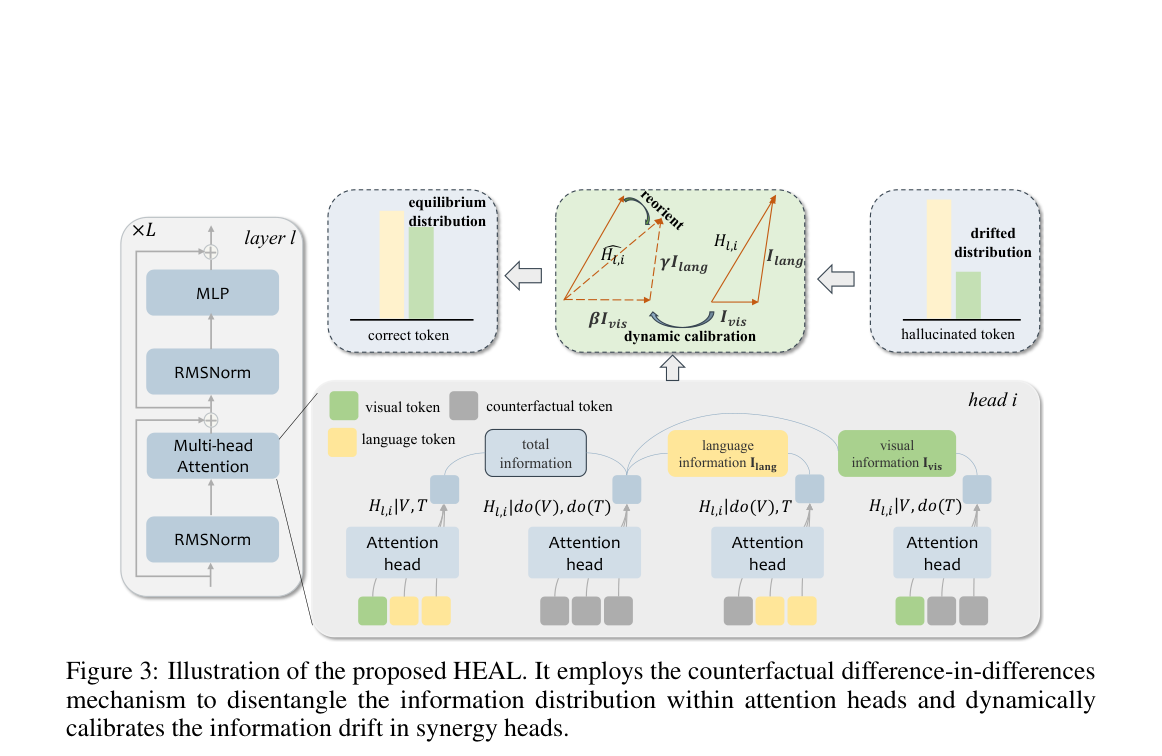
该图展示了HEAL框架的整体流程,包括反事实双重差分机制解耦注意力头信息,以及动态校准协同头信息漂移。重点观察反事实输入的构建方式和校准因子的应用位置,理解方法的核心逻辑。
最强结论
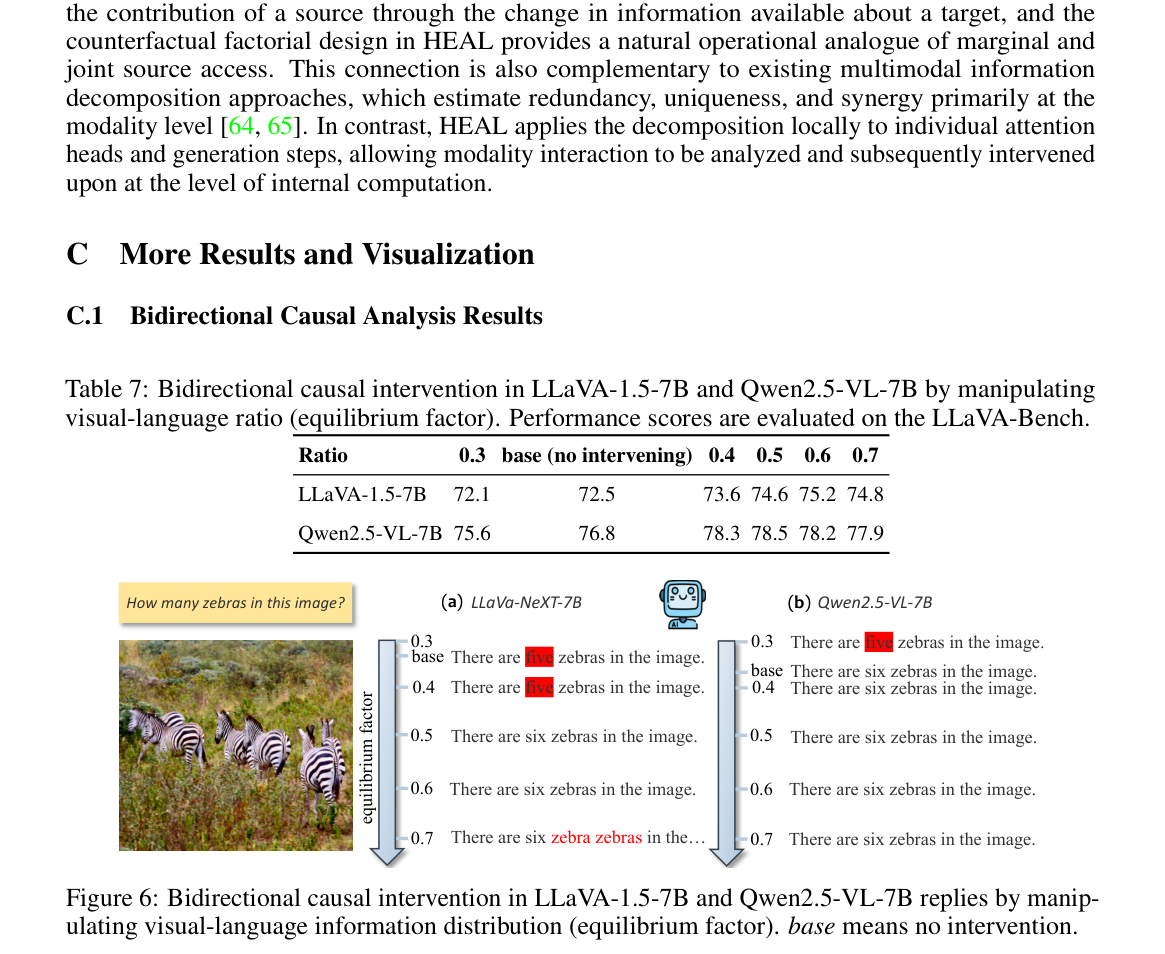
该图展示了双向因果干预下,操纵视觉-语言信息分布对模型回复的影响。重点观察干预如何改变模型输出,验证信息漂移与幻觉的因果关系。
意义与局限
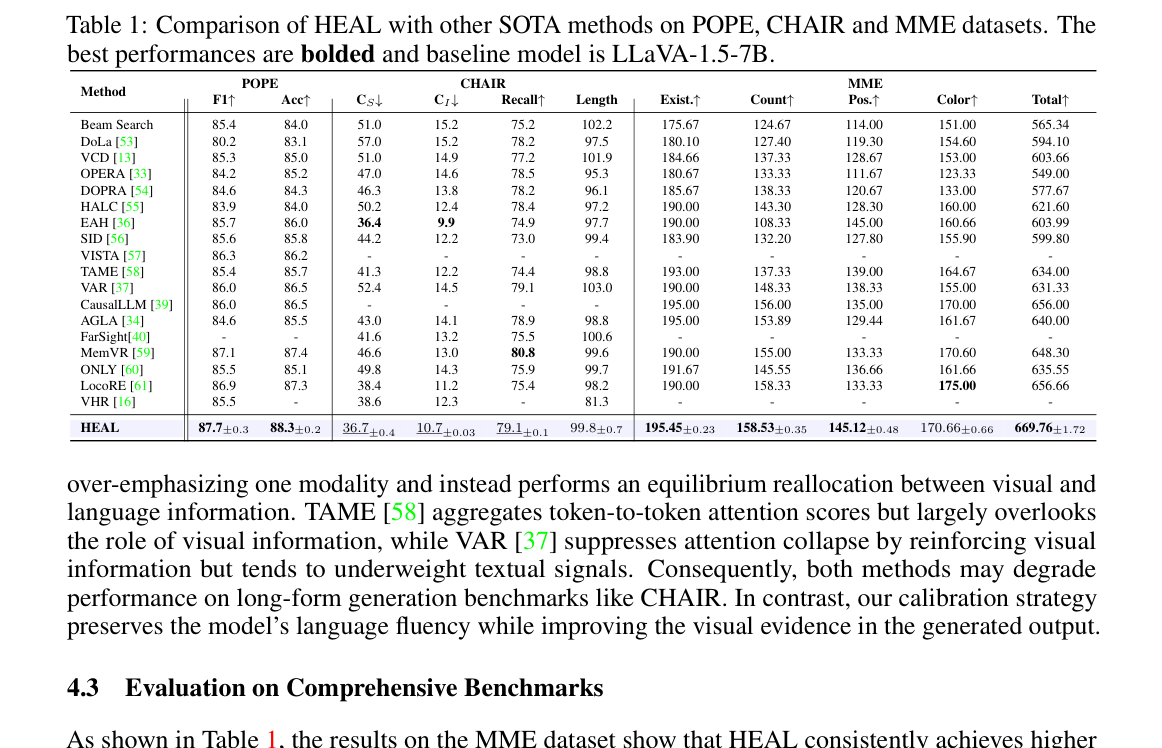
该表比较了HEAL与其他SOTA方法在POPE、CHAIR和MME数据集上的性能。重点观察HEAL在CHAIR CS上的表现,验证其避免单模态过强调的优势。
实验如何设计?
- 在LLaVA-1.5-7B、LLaVA-NeXT-7B、Qwen2-VL-7B、Qwen2.5-VL-7B、Qwen3-VL-8B、InternVL-7B和InternVL3.5-8B上评估,覆盖主流多模态大语言模型。
- 使用POPE、CHAIR、MME、LLaVA-Bench和MMHal-Bench等基准测试幻觉抑制和综合多模态能力,确保评估的全面性。
- 进行消融实验分析更新间隔和平衡因子α的影响,验证各组件的贡献。
- 通过双向因果干预验证信息分布漂移与幻觉之间的因果关系,增强结论的因果解释力。
- 鲁棒性分析验证不同掩码策略、阈值选择对头分类和信息漂移观测的稳定性,确保方法的可靠性。
关键结果与论文证据
- 在LLaVA-1.5-7B上,HEAL在POPE F1、CHAIR CS和MME Total上均取得显著提升,表明方法在幻觉抑制和综合能力上均有效(第8页)。
- 在LLaVA-NeXT-7B和Qwen2.5-VL-7B上,HEAL在LLaVA-Bench上分别取得82.2和78.5的分数,优于基线模型,验证了方法的泛化性(第8页)。
- 头类型分配在不同掩码策略下的一致性高达92.13%-95.36%,表明头分类的鲁棒性(第10页)。
- 不同掩码策略下,POPE F1分数在86.93-87.84之间波动,表明信息漂移观测的稳定性(第10页)。
- 平衡因子α对CHAIRs和BLEU的影响呈现单调趋势,α越大,CHAIRs越低,BLEU越高,验证了理论预测(第9页)。
- 更新间隔对模型性能的影响较小,表明周期性更新策略的合理性(第9页)。
- 双向因果干预显示,操纵视觉-语言信息分布可显著改变模型输出,验证了信息漂移与幻觉的因果关系(第19页)。
阅读时需要注意
- 平衡因子α和更新间隔S目前基于经验确定,可能因模型和任务而异,缺乏自适应机制。
- 对于早期视觉编码失败或缺失视觉证据导致的幻觉,仅靠注意力头校准无法完全解决,需结合模型架构或训练改进。
- 理论证明依赖于信息度量的局部加性、正齐次性和头表示的局部线性近似假设,实际应用中可能存在偏差。
关联工作
- VHR通过增强视觉注意力头缓解幻觉,但HEAL通过解耦信息分布并动态校准协同头,避免单模态过强调,在CHAIR上表现更优(第8页)。
- EAH主要增强特定层注意力头,HEAL则进行全头信息解耦和平衡校准,在POPE和MME上取得更高分数(第8页)。
- CausalMM使用结构因果模型处理模态先验混淆,HEAL则直接干预头输出并解耦信息分布,提供更细粒度的因果解释(第4页)。
- HEAL借鉴部分信息分解理论,将多模态信息分解为视觉、语言、冗余和协同成分,提供实际可行的分解实现(第5页)。