快速导读:FreeFlow提出了一种无需光流特定归纳偏置(如相关体、特征扭曲)的分层Transformer架构,通过窗口、移位窗口和全局注意力机制,在Sintel、KITTI-2015和Spring基准上实现了最先进的性能,同时保持了高分辨率推理的内存效率。
光流估计长期依赖相关体、特征扭曲等特定归纳偏置,导致架构复杂且难以扩展。FreeFlow提出了一种无偏置的分层Transformer架构,通过结合窗口、移位窗口和全局注意力,在保持高分辨率推理内存效率的同时,实现了最先进的性能。
英文题目:FreeFlow: A Bias-free Hierarchical Transformer for Optical Flow Estimation
论文出处:arXiv 每日论文精选 · arXiv:2609.11486
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有光流方法如WAFT、GeoViT等依赖迭代细化和特征扭曲,虽然有效但限制了模型的表达力和可扩展性。随着Vision Transformers在密集预测任务中的兴起,如何在不引入特定偏置的情况下处理高分辨率图像中的长程依赖和局部细节,成为关键挑战。
核心创新
- Bias-free架构:完全移除correlation volumes、feature warping和iterative refinement等光流特定模块。
- Hierarchical Local-Global Attention:结合Window(局部)、Shifted-Window(跨窗口交换)和Global(降采样全局)注意力,实现高分辨率下的局部细节与全局一致性。
- Dense Feature Fusion:在整个网络中进行跨tile和跨尺度的特征交换,优于Late Feature Fusion。
- Simple Flow Head:使用轻量级卷积头直接输出光流,避免复杂的DPT头或迭代更新。
方法概览
FreeFlow采用Siamese ViT编码器-解码器架构,输入图像被划分为8×8 patches。编码器使用共享权重的Window、Shifted-Window和Global注意力块。解码器结合自注意力和跨视图交叉注意力。Flow Head是一个简单的三层卷积头,直接预测光流和不确定性,无需迭代细化或凸上采样。
- FreeFlow采用Siamese ViT编码器-解码器架构,输入图像被划分为8×8 patches。
- 编码器使用共享权重的Window、Shifted-Window和Global注意力块,实现局部与全局信息的平衡。
- 解码器结合自注意力和跨视图交叉注意力,通过Dense Feature Fusion在全网络进行跨tile特征交换。
- Flow Head是一个简单的三层卷积头,直接预测光流和不确定性,无需迭代细化或凸上采样。
逐图理解论文
传统方法的局限
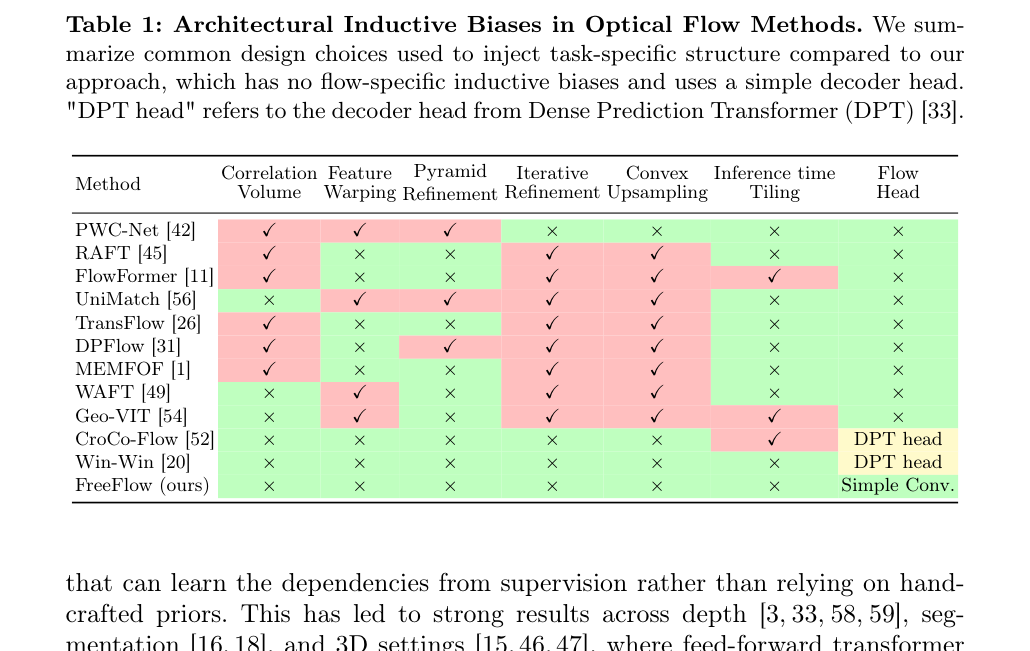
传统光流方法依赖相关体和特征扭曲,导致架构复杂且难以扩展。例如,WAFT保留warping偏置,限制了模型的表达力。
研究缺口
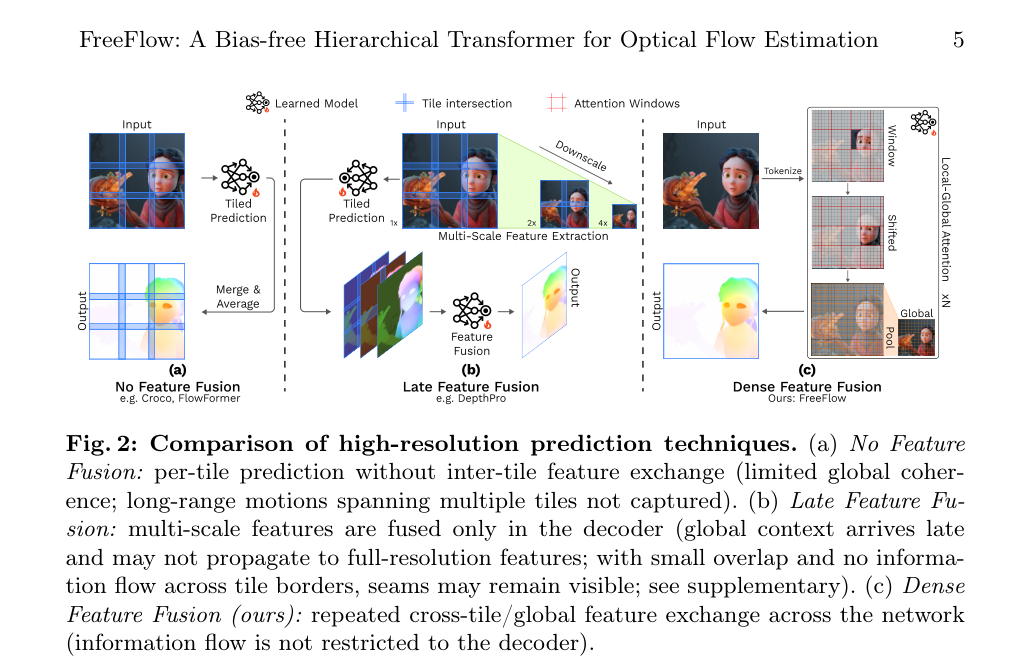
该图对比了无特征融合、Late Feature Fusion和Dense Feature Fusion三种高分辨率预测技术。重点观察Dense Feature Fusion如何在全网络进行跨tile特征交换,从而避免Late Fusion中的接缝问题。
FreeFlow的贡献
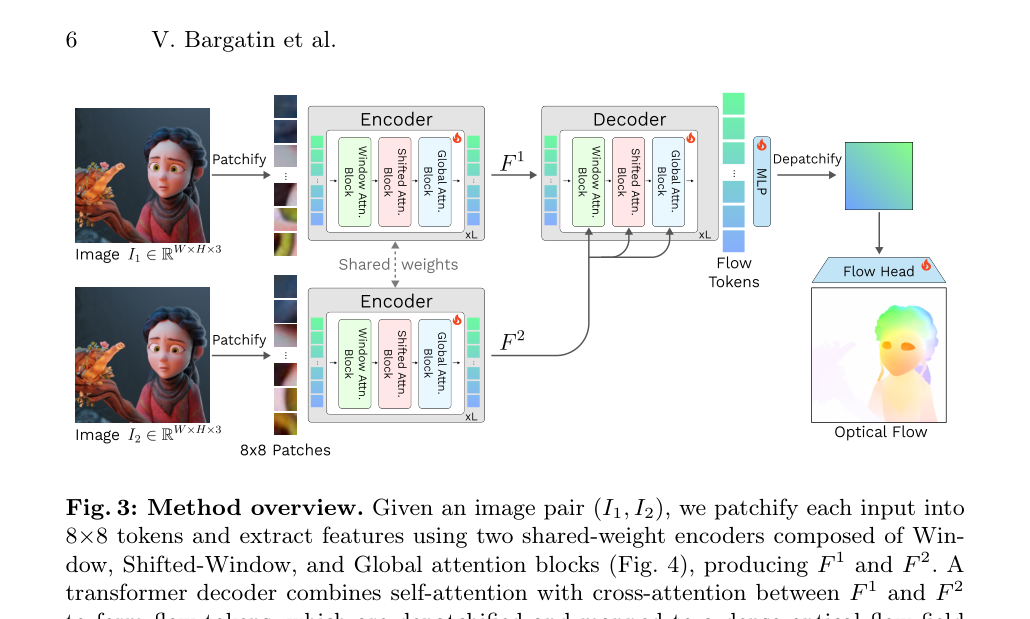
该图展示了FreeFlow的整体架构。重点观察Siamese ViT编码器-解码器结构,以及Window、Shifted-Window和Global注意力块的组合方式,理解其如何实现局部与全局信息的平衡。
最强结论
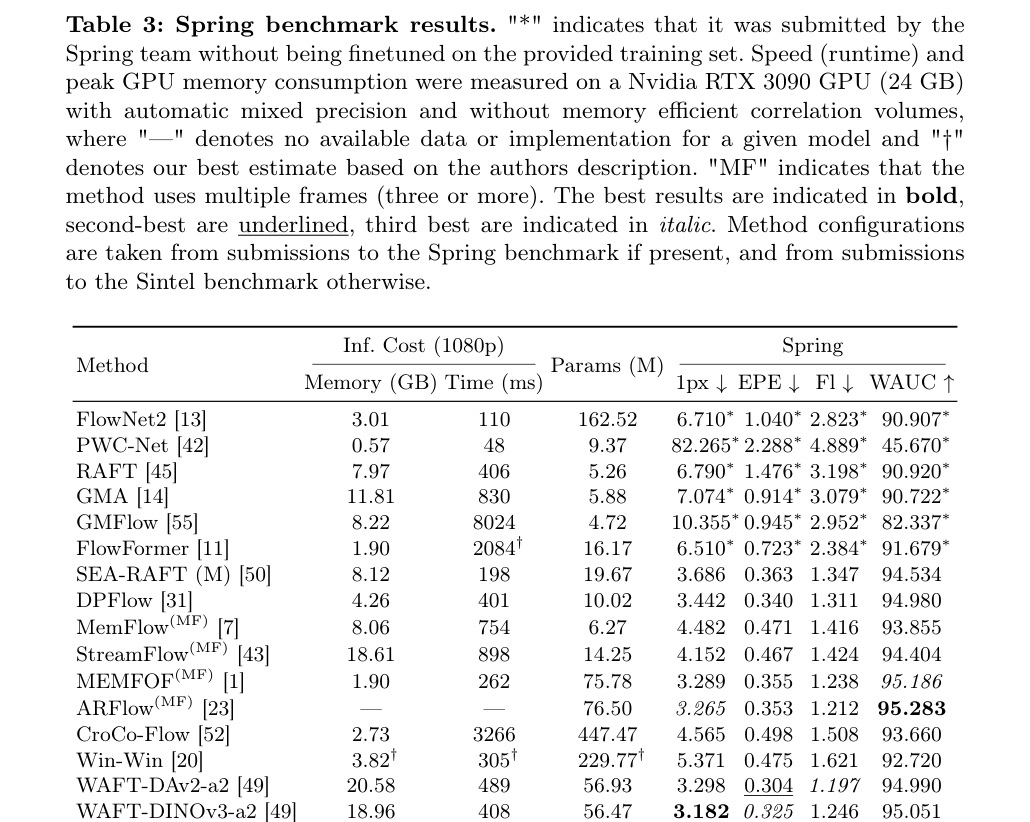
FreeFlow在Spring基准上实现了最先进的性能,证明了无偏置Transformer架构在高分辨率光流估计中的有效性。
意义与局限
FreeFlow为光流估计提供了更简洁、可扩展的新范式。但零样本迁移性能受限于训练数据覆盖范围。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 在Spring、Sintel和KITTI-2015基准上进行评估,使用Nvidia RTX 3090 GPU测量推理时间和内存。
- 消融实验分析masking ratio、注意力块配置和patch size的影响。
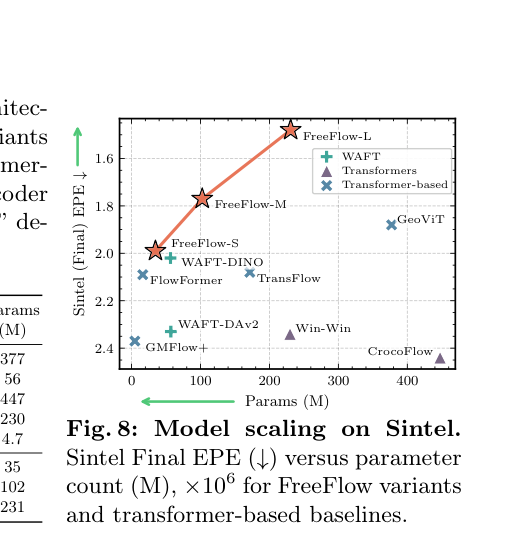
- 模型缩放实验验证S/M/L不同规模模型的性能增益。
- 零样本迁移实验评估在Sintel和KITTI训练集上的零样本性能。
关键结果与论文证据
- FreeFlow在Spring基准上实现了0.278的EPE,显著优于基线方法。
- Dense Feature Fusion相比Late Feature Fusion,在全局一致性上表现更优。
- 8×8 patch size比16×16更优,后者在相同推理时间下需要更多参数和内存。
- Global注意力块在高masking ratio (0.95) 下对性能至关重要。
阅读时需要注意
- 零样本迁移性能不随模型规模单调提升,受限于训练数据的运动覆盖范围。
- 相比一些轻量级CNN方法,推理时间可能较长。
关联工作
- CroCo-Flow是基线对比,FreeFlow在其基础上改进了高分辨率处理和特征融合。
- WAFT保留warping偏置,FreeFlow移除。
- DepthPro使用Late Feature Fusion,FreeFlow使用Dense Feature Fusion。