快速导读:IMLE-VLA 通过引入基于 conditional Implicit Maximum Likelihood Estimation (cIMLE) 的单步动作头替换传统的迭代式 flow-matching 头,在保持 π0.5 鲁棒性的同时,将 VLA 推理频率提升至 55 Hz(3.67 倍),并在 LIBERO 基准测试中取得 98.0% 的最高成功率。
视觉-语言-动作(VLA)策略通过结合预训练视觉-语言模型(VLM)与动作生成头,实现了跨任务的泛化能力。然而,现有主流 VLA 策略(如 π0.5)依赖多步迭代采样(如 10 步 Euler steps)生成连续动作,导致推理延迟高,产生“stop-and-go”运动模式,限制了实时控制频率和任务完成速度。IMLE-VLA 针对这一瓶颈,提出了一种基于条件隐式最大似然估计(cIMLE)的单步动作头,旨在在不牺牲动作分布覆盖能力的前提下,大幅提升推理效率。
该框架冻结 VLM 骨干网络,仅训练一个轻量级的单步条件生成器。通过采样多个噪声向量生成候选动作,并采用最近邻分配机制将真实动作匹配到最接近的候选项,IMLE-VLA 在单步前向传播中有效覆盖了多模态动作分布,避免了传统单步回归头易发生的 mode collapse 问题。实验表明,该方法在 LIBERO 基准测试中取得了 98.0% 的最高成功率,并将推理频率提升至 55 Hz,为实时机器人控制提供了新的技术路径。
英文题目:IMLE-VLA: Fast Single-Step Action Generation for Vision-Language-Action Policies
论文出处:arXiv 每日论文精选 · arXiv:2609.10915
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLA 策略的核心挑战在于如何高效地生成连续、平滑且符合多模态分布的动作。传统的迭代式动作头(如 diffusion 或 flow matching)虽然能够较好地处理多模态分布,但其多步采样过程是主要的计算瓶颈。例如,π0.5 需要 10 步 Euler steps 才能生成一个动作序列,导致推理延迟高达 15 Hz,无法满足实时控制的需求。
另一方面,简单的单步回归头(如 L1 回归)虽然推理速度快,但极易发生 mode collapse,即模型倾向于回归到动作分布的均值,无法处理多模态动作分布。例如,OpenVLA-OFT 使用 L1 回归头,虽然速度快,但鲁棒性较差,且在复杂任务中成功率较低。Shallow-π 等蒸馏方法虽然提升了速度,但往往以牺牲成功率为代价。
因此,如何在保持多模态动作分布覆盖能力的同时,实现单步推理,成为 VLA 策略研究的关键问题。IMLE-VLA 正是针对这一研究空白,提出了基于 cIMLE 的单步动作头,旨在解决推理速度与动作分布覆盖能力之间的矛盾。
核心创新
- 提出 IMLE-VLA 框架,首次将 cIMLE 应用于通用 VLA 策略,实现单步多模态动作生成。
- 设计基于最近邻分配的 cIMLE 训练算法,无需教师模型即可避免 mode collapse。
- 实现 3.67 倍推理频率提升(55 Hz vs 15 Hz)和最高 11 倍动作吞吐量,同时保持或提升任务成功率。
方法概览
IMLE-VLA 冻结 VLM 骨干网络,仅训练一个轻量级的单步条件生成器 Gθ。该生成器使用 cIMLE 目标函数,通过采样多个噪声向量生成候选动作,并采用最近邻分配机制(nearest-neighbour assignment)将真实动作匹配到最接近的候选项,从而在单步前向传播中覆盖多模态分布,避免回归到均值。
- IMLE-VLA 框架冻结 VLM 骨干网络,仅训练一个轻量级的单步条件生成器 Gθ。该生成器接收 VLM 输出的状态表示和语言指令,直接生成动作序列,无需多步迭代采样。
- cIMLE 目标函数通过采样多个噪声向量生成候选动作,并采用最近邻分配机制将真实动作匹配到最接近的候选项。这一机制使得模型在单步前向传播中能够覆盖多模态动作分布,避免回归到均值。
- 最近邻分配机制无需教师模型,直接通过真实动作与候选动作的匹配关系进行训练,降低了训练复杂度,同时保证了多模态覆盖能力。
- 执行 horizon (H) 和 cIMLE 样本因子 (m) 是影响性能的关键超参数。H 决定了单次推理生成的动作步数,m 决定了候选动作的数量。实验表明,H=10 和 m=2 是最佳平衡点。
- IMLE-VLA 在推理时仅需单次前向传播,显著降低了计算开销。在 NVIDIA L40S/A6000 硬件上,其推理频率达到 55 Hz,较 π0.5 提升 3.67 倍。
- 该方法在训练时增加了计算开销(需采样 m 个候选动作),但推理时是单步的,因此在实际部署中更具优势。
逐图理解论文
失败案例与直觉
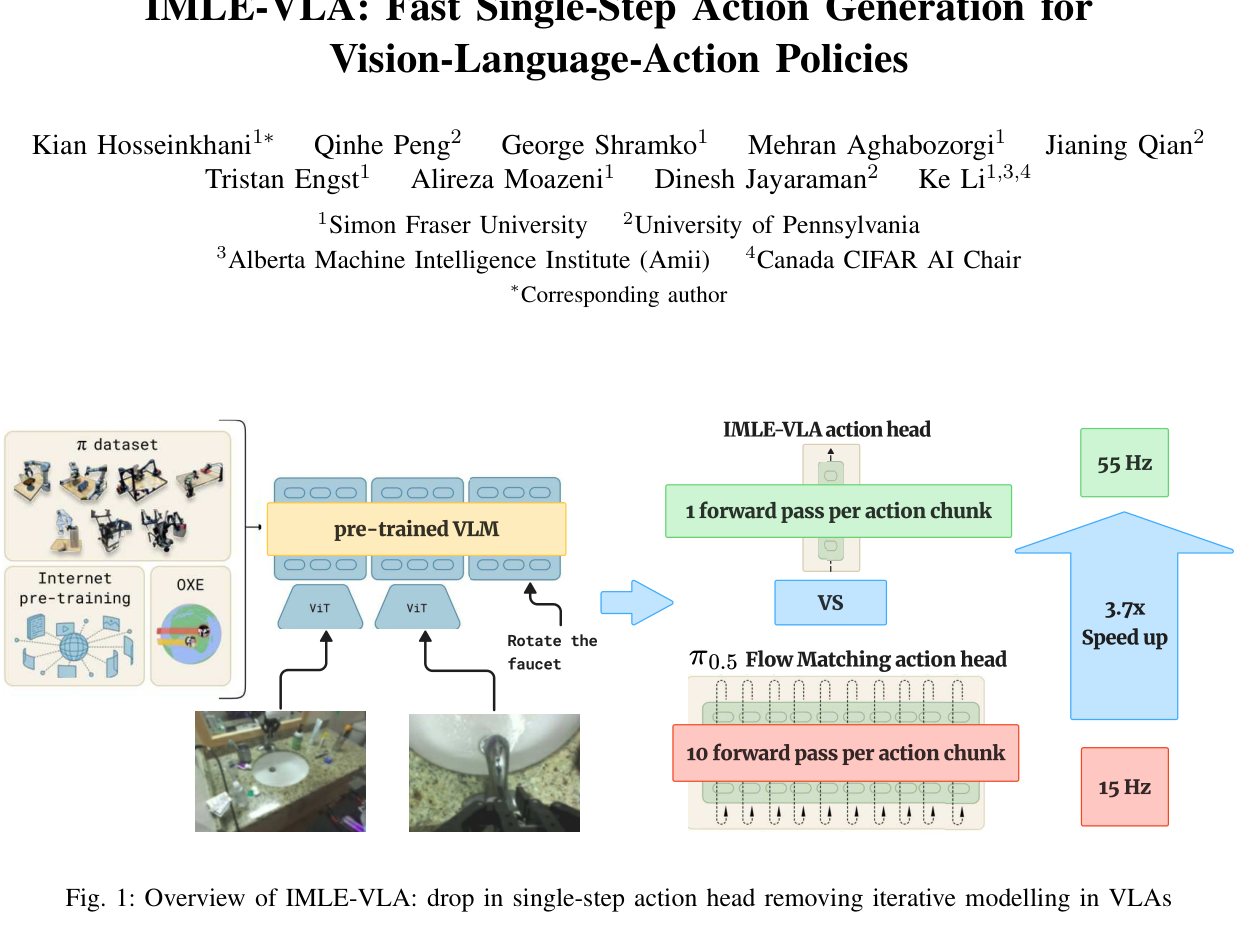
该图展示了 IMLE-VLA 的整体架构,重点突出了单步动作头替换迭代式建模的过程。观察 VLM 骨干网络与单步生成器 Gθ 的连接方式,理解如何在不改变 VLM 的前提下实现单步推理。该图直观地说明了 IMLE-VLA 如何消除迭代建模的计算瓶颈。
实验验证
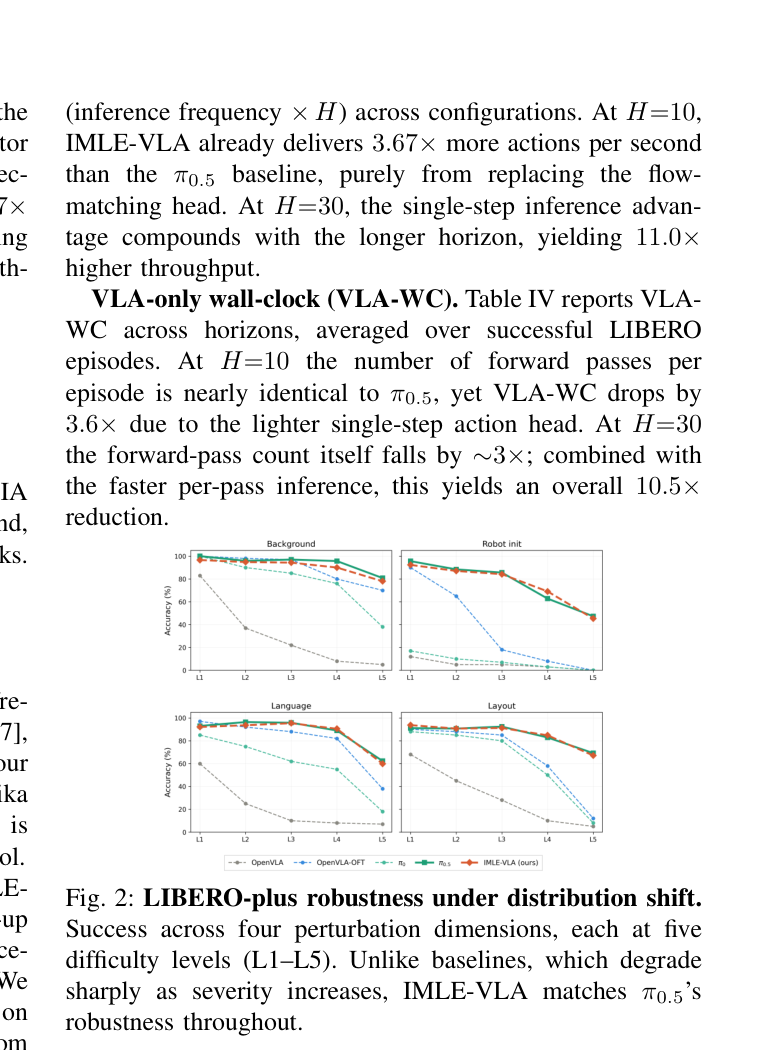
该图展示了 LIBERO-plus 鲁棒性测试的结果,涵盖背景、初始状态、语言和布局四个维度的分布偏移。观察 IMLE-VLA 与基线方法在不同难度级别(L1–L5)下的成功率变化趋势,理解其如何保持与 π0.5 相当的鲁棒性。该图是评估 IMLE-VLA 泛化能力的关键证据。
结论与意义
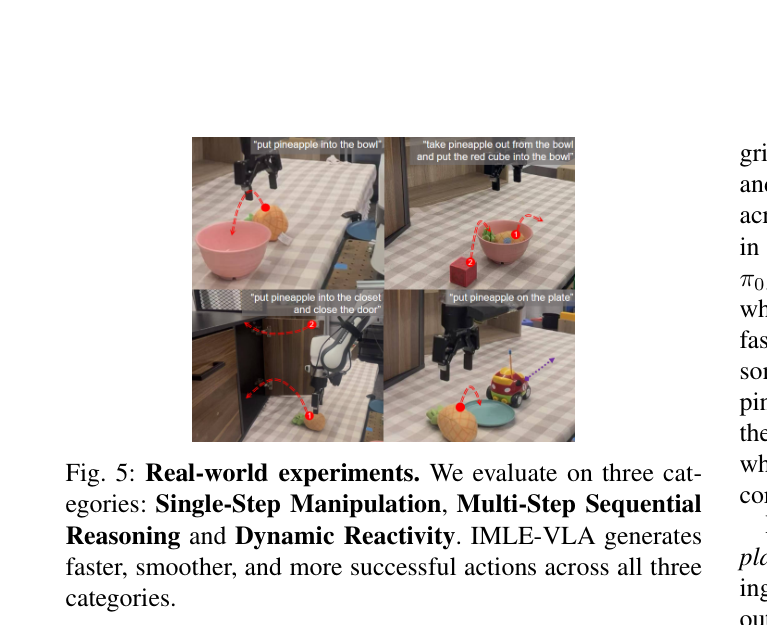
该图展示了真实世界实验的结果,涵盖单步操作、多步推理和动态反应三类任务。观察 IMLE-VLA 与基线方法在动作速度、平滑度和成功率上的对比,理解其在实际部署中的优势。该图是评估 IMLE-VLA 实用性的关键证据。
实验如何设计?
- LIBERO 基准测试:在 40 个桌面操作任务上评估成功率和推理频率,涵盖单步操作、多步推理和动态反应任务。
- LIBERO-plus 鲁棒性测试:在背景、初始状态、语言和布局四个维度的分布偏移下评估性能,每个维度包含五个难度级别(L1–L5)。
- 消融实验:分析执行 horizon (H) 和 cIMLE 样本因子 (m) 对性能的影响,确定最佳超参数组合。
- 真实世界实验:在 Franka Emika Panda 机器人上测试单步操作、多步推理和动态反应任务,评估实际部署中的表现。
关键结果与论文证据
- 在 LIBERO 基准测试中,IMLE-VLA 在 H=10 时取得了 98.0% 的平均成功率,显著优于 π0.5 和其他基线方法(第 5 页)。
- 推理频率提升至 55 Hz,较 π0.5 的 15 Hz 提升 3.67 倍;在 H=30 时,动作吞吐量提升 11.0 倍(第 5 页)。
- 在 LIBERO-plus 鲁棒性测试中,IMLE-VLA 在四个分布偏移维度上均保持了与 π0.5 相当的鲁棒性,而基线方法在难度增加时性能急剧下降(第 5 页)。
- 消融实验表明,m=1 时性能急剧下降,证实了纯回归目标不足以建模复杂动作分布;m=2 和 m=5 性能几乎相同,因此选择 m=2 以平衡计算开销(第 6 页)。
- 执行 horizon (H) 增大虽提高吞吐量,但会降低反应性并略微降低成功率(H=30 时成功率为 97.1%),H=10 是最佳平衡点(第 6 页)。
- 真实世界实验中,IMLE-VLA 在单步操作、多步推理和动态反应任务中均表现出更快、更平滑、更成功的动作,VLA-only wall-clock time 降低 3.9x–6.6x,proprioceptive jerk 降低 2.2x–3.0x(第 7 页)。
阅读时需要注意
- 执行 horizon (H) 增大虽提高吞吐量,但会降低反应性并略微降低成功率,需在吞吐量和反应性之间权衡。
- 真实世界实验仅涵盖 4 个特定任务,未展示在更广泛复杂场景中的泛化能力。
- cIMLE 训练需要采样多个候选动作(m=2),增加了训练时的计算开销,尽管推理时是单步的。
- 推理频率的提升依赖于特定的硬件(NVIDIA L40S/A6000)和优化实现,跨硬件性能可能不同。
关联工作
- π0.5 是 IMLE-VLA 的主要基线,其 flow-matching 动作头是多步迭代的代表,IMLE-VLA 通过替换该头实现单步推理。
- OpenVLA-OFT 使用 L1 回归头,易发生 mode collapse 且鲁棒性较差,IMLE-VLA 通过 cIMLE 机制避免了这一问题。
- Shallow-π 是蒸馏方法,速度提升但成功率下降,IMLE-VLA 在保持成功率的同时提升了速度。
- cIMLE (Implicit Maximum Likelihood Estimation) 是 IMLE-VLA 的核心方法,提供了多模态覆盖的理论基础。