快速导读:SenseFuse 只改开放词汇三维实例分割的 mask 标注阶段,用无标签敏感度在单场景未标注提议上毫秒级估计场景级融合权重,把冻结的二维图像编码器与三维形状编码器线性融合。
闭集三维实例分割会吃形状信息,开放词汇管线在给 mask 打标签时却几乎只用二维图像特征或图像蒸馏表示。机器人一旦进入未见环境,椅子被桌子挡住、门和窗帘几何相近这类情况,单靠外观或单靠形状都会系统性说错。KAIST 的 SenseFuse 不重训骨干、不改 mask 几何,只在现成管线的标注阶段插入一个无标签晚融合模块。
出发点是实证:二维图像编码器与三维形状编码器几乎在不相交的实例上失败,也很少给出同一个错误标签;两个二维编码器则会大量重复同一类错。因此该融合的互补对象是 2D–3D,而不是再加一个二维头。方法用信号检测里的敏感度衡量各头把正确类抬离自身背景噪声的程度,在中心化余弦分数上用闭式权重混合两路分数,并在单场景未标注提议上于毫秒级估出场景级 ŵ。代码已开源:https://github.com/hanes1207/SenseFuse。
英文题目:SenseFuse: Label-Free Fusion of Image and Shape Encoders for Open-Vocabulary 3D Instance Segmentation
论文出处:arXiv 每日论文精选 · /tmp/ingest_20260920/arxiv-2609-20475.pdf
原始论文:PDF / 论文页面
这篇论文解决什么问题?
ScanNetv2 等基准上的闭集 3DIS 从点分组、动态核到实例 query,都会显式用三维几何。固定类别集无法覆盖新物体,于是出现训练式蒸馏(OpenScene、PLA、RegionPLC)与训练免费实例级分割(OpenMask3D、Open3DIS、Open-YOLO3D)两条开放词汇路线。前者用二维伪标签训三维网络,容易偏向已见类;后者用冻结二维模型给类无关提议打标签,形状证据在赋值阶段完全闲置。
二维失败可预期:被桌子挡住的椅子在多数视角里会被看成桌子。三维头也会错,但错法不同——同一把椅子可能被 Uni3D 打成 folded chair。图 1 把这个分歧画出来:两路各自选错,线性融合后正确类 chair 回到最高。如何在标注阶段利用点云形状、同时保持零样本、避免类偏,正是本文要填的缺口。
并行成熟的文本对齐形状编码器(ULIP、OpenShape、Uni3D)可以把点云直接对类名打分,不需要二维投影。它们在物体中心形状上很强,单独丢进杂乱室内场景却弱于二维头。SenseFuse 的判断是:不要指望形状头单打独斗,也不要再训一套三维骨干,而是按场景可靠性把已经冻结的两路分数重新加权。
实践障碍还有协议混乱。相同类别分数、相同二值 mask、置信度一律设 1.0 时,只保留每个提议的 top-1 与从摊平提议–类矩阵里取 top-600,会让 Open-YOLO3D 在 ScanNet200 上分别得到 23.9 与 28.3 mAP。因此本文把标注准确率 Acc 作为主指标,把空间召回与分类精度拆开,只评价“这个 mask 叫什么”。
核心创新
- 实证表明二维图像头与三维形状头几乎在不相交的实例上失败、很少给出相同错标,而两个二维头会大量重复同一错误,因此 2D–3D 才是该融合的互补对象。
- 在中心化余弦分数空间由前两阶矩闭式导出场景级融合权重;用软责任无标签估计敏感度,单场景未标注提议上毫秒级校准,无需训练与真值。
- 接入 Open-YOLO3D、OpenMask3D、Open3DIS,在 ScanNet200、Replica、ScanNet++ 上均提升标注精度,中位收回先知融合增益的 93%。
方法概览
冻结现有 3DIS 管线的 mask 提议与二维嵌入,对掩码点云过冻结三维形状编码器得到形状嵌入;两类分数与各自文本锚点做余弦相似度后按 mask 行中心化,再用单标量 w 线性融合。以正确类相对背景噪声的敏感度 d′h=μh/σh 衡量各头可靠性,闭式最优权重 w=π3/(π2+π3),πh=μh/σh²。因开放词汇没有真值标签,用当前融合分数的软责任(softmax 与 margin 门控)代入矩估计并迭代至收敛,得到场景级 ŵ,最终 arg max 得标签。不训练任何模块,也不改 mask 几何。
- 输入是重建室内场景的着色点云与现成管线给出的 Q 个二值 mask。二维嵌入直接继承 Open-YOLO3D / OpenMask3D / Open3DIS;三维嵌入把每个 mask 内点云重采样到 10^4 点、居中并按最远点缩到单位球,送入冻结的 Uni3D(或消融中的 OpenShape)。两头各自用自己的文本编码器把同一组类名编成锚点,分数是 ℓ2 归一化后的余弦相似度。
- 原始余弦带有头特定的基线,不能直接比。式 (1) 对每个 mask 的 K 维分数做行中心化。每个头在一个场景内用两个共享矩刻画:正确类相对背景的抬升 μh,以及错误类(背景)分数的标准差 σh。敏感度 d′h=μh/σh 就是这颗头把正确类抬离自身噪声的距离,单位是该头自己的背景标准差。
- 融合是单标量线性混合:Sc(w)=(1−w)S2,c+w S3,c,标签取 arg max。若把两头背景视为不相关,融合敏感度有闭式,令偏导为零得到 w=π3/(π2+π3),πh=μh/σh²。高斯分数、正确类位置平移且协方差对角时,该规则与 LDA / 均匀先验下的贝叶斯决策一致;部署时只依赖经验矩,不强制分布假设。
- 开放词汇没有真值,μh 不能直接量。算法 1 用当前融合分数的软责任代替缺失标签并迭代:按行标准差缩放后 softmax 得到类责任 P,剩余质量均分给背景 Γ,再用 top-1 与 top-2 间隔相对场景中位数的平滑门控 g 加权。责任加权平均得到 (μ̂h, σ̂h),再代回闭式更新 w。默认 τ0=0.25、β=8、最多 12 步、w0=0.5。软化更新在 [0,1] 上连续,存在不动点;在全部测试设置里从 {0,0.25,0.5,0.75,1} 初始化都会收敛到同一数据集级权重,ScanNet200 的 312 场景中有 302 个逐场景差在 0.01 以内。
- 背景分数实际相关 ρ̂ 约 0.14–0.26,图 3 里灰色噪声椭圆是歪的。作者把相关校正当诊断:显式修正不但不升准确率,还会在部分场景得到越界权重,故部署仍用忽略相关的式 (5)。最终硬标签的实例置信度按现有开放词汇惯例固定为 1.0。
逐图理解论文
失败直觉
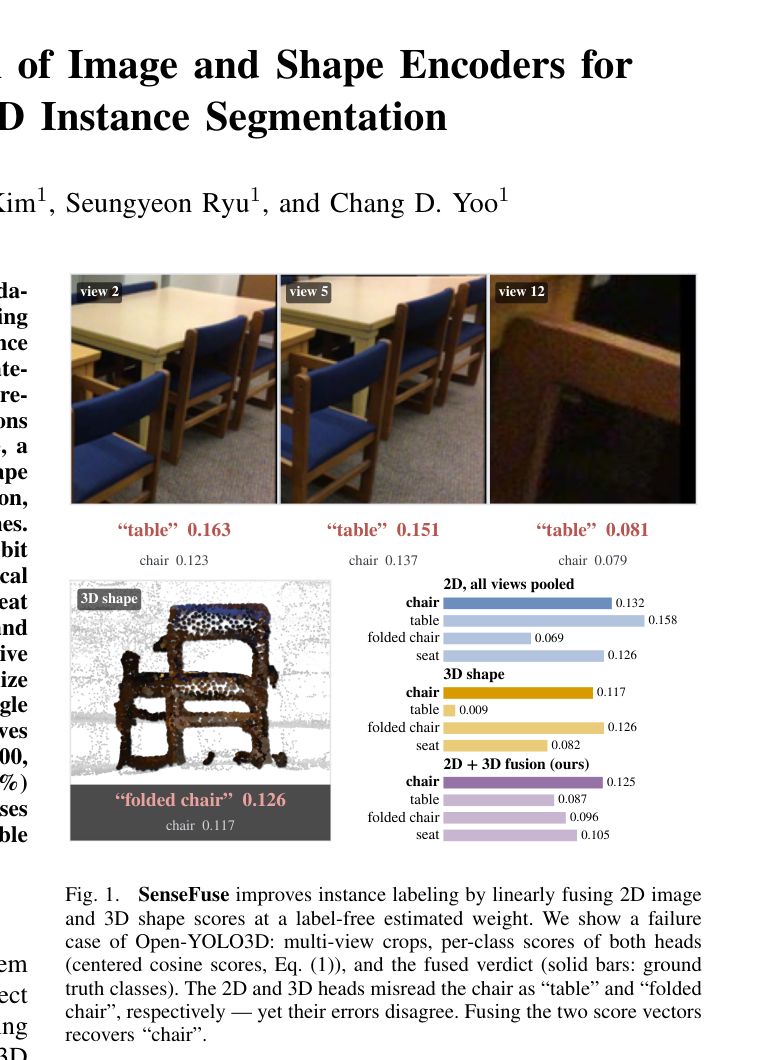
看 Open-YOLO3D 的失败案例:三张多视角作物都把椅子打成 table(红字 0.163/0.151/0.081),三维点云则把同一实例打成 folded chair(0.126)。右侧三组中心化余弦条形图里,实心条是真值类。二维汇总 table 最高(0.158),三维 folded chair 最高(0.126),融合后 chair 以 0.125 回到第一。读图时抓住“两路都错、但错法不同”。
研究缺口
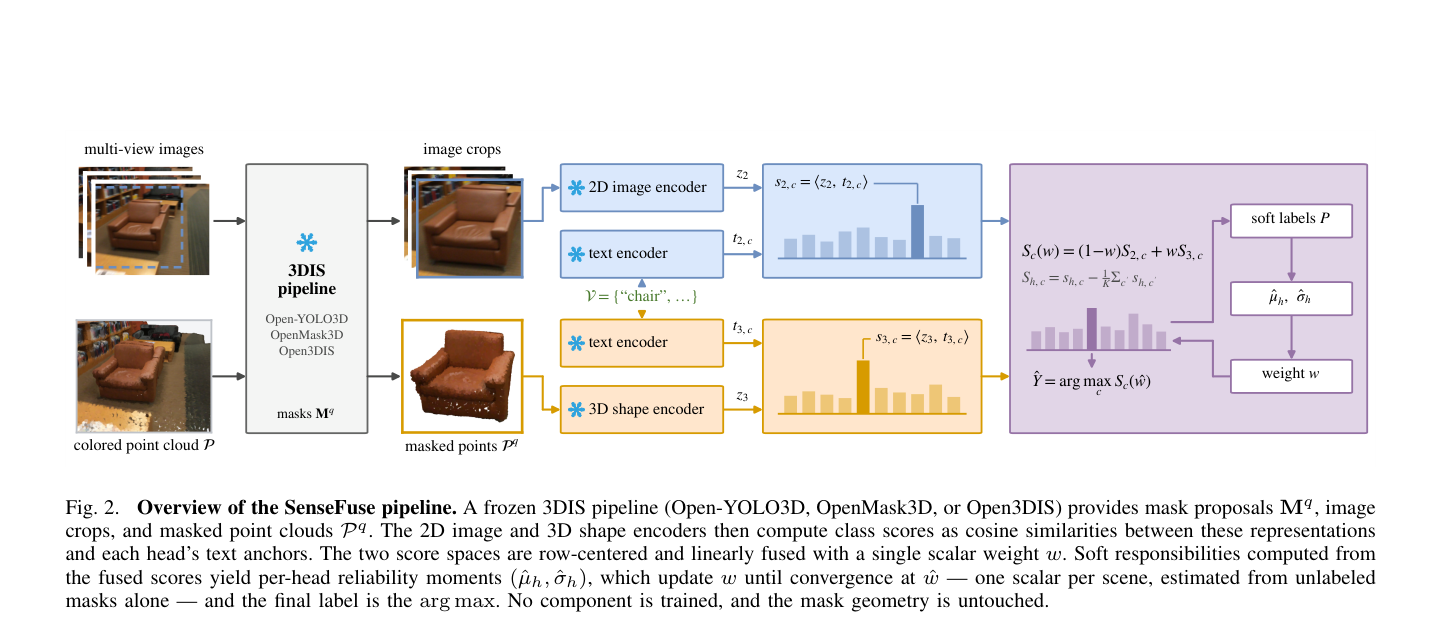
管线总图。左侧冻结 3DIS 给出 mask、作物与掩码点云;蓝色二维路径与橙色三维路径各自对文本锚点打余弦分;紫色框做行中心化、线性融合 Sc(w),再用软标签估计 (μ̂h,σ̂h) 更新 w,直到 ŵ。没有模块被训练,mask 几何不动。按从左到右、先分叉再汇合的顺序读。
关键机制
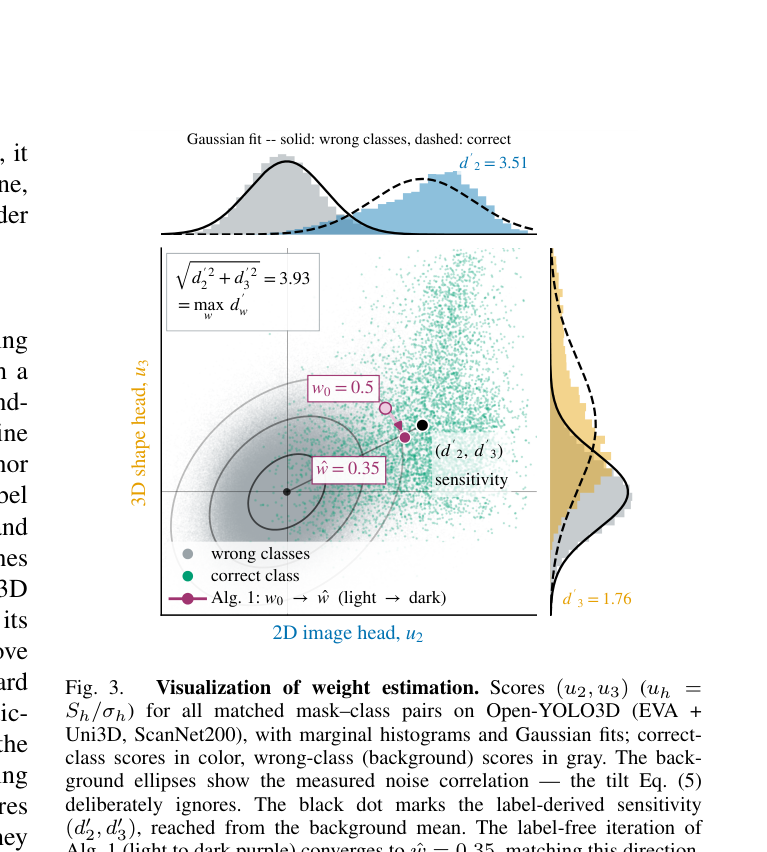
权重估计的分数平面。横轴二维标准化分数 u2,纵轴三维 u3。灰点错误类、绿点正确类;顶部与右侧是边际直方图及高斯拟合,d′2=3.51、d′3=1.76,融合最大敏感度 3.93。浅紫到深紫是算法 1 从 w0=0.5 走到 ŵ=0.35,与用标签算出的黑色敏感度点同方向。灰色椭圆的倾斜是噪声相关,式 (5) 故意忽略。
实验证据
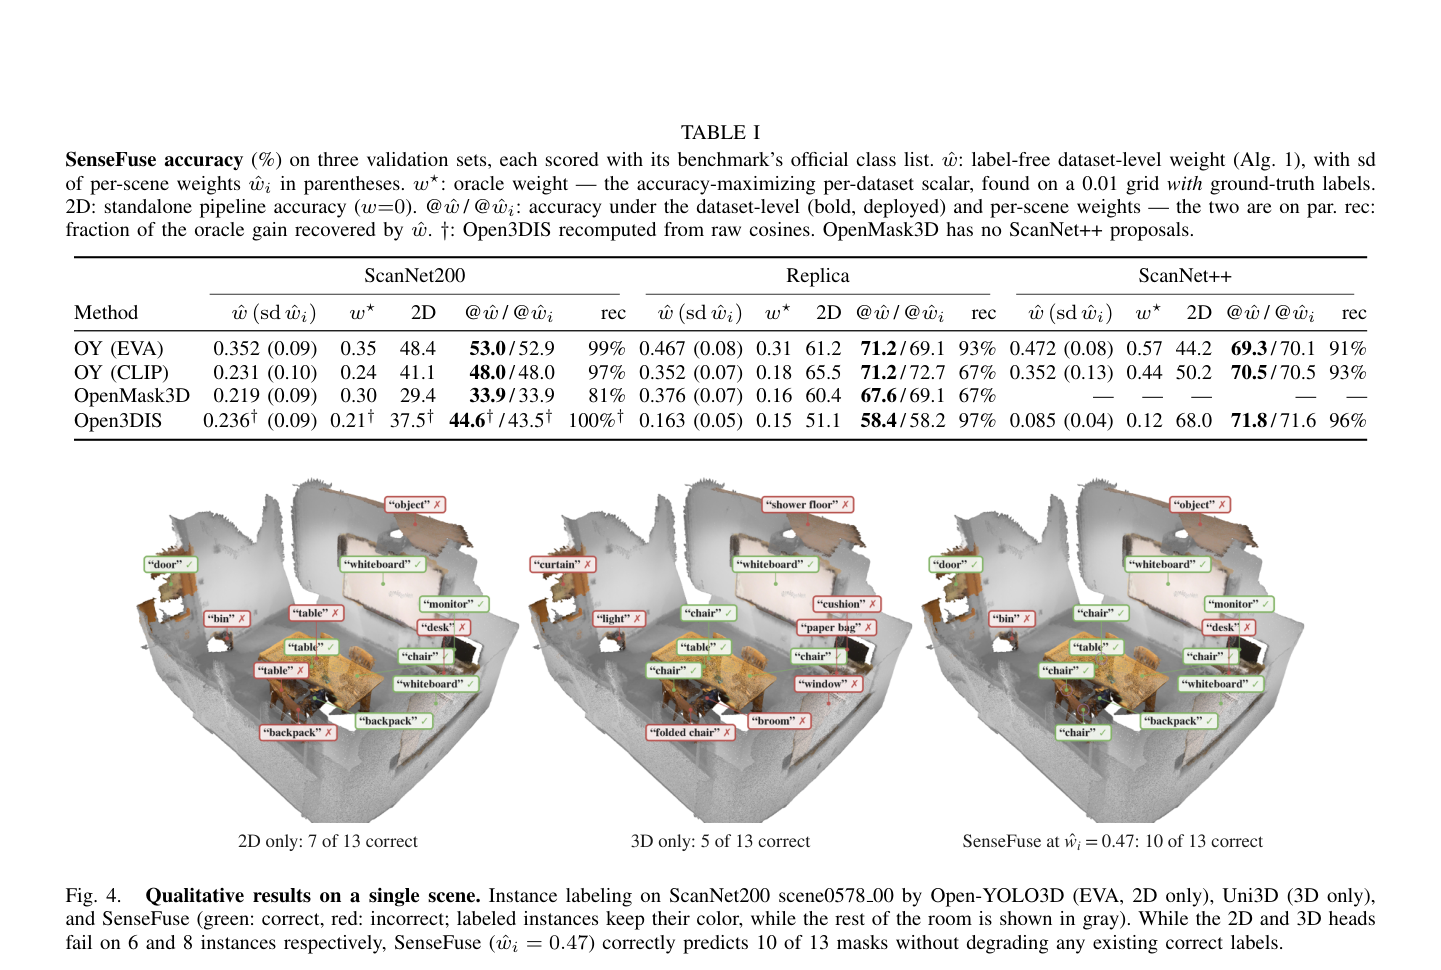
上半是表 I:三条管线、三个数据集的 ŵ、w⋆、二维基线、部署准确率与 rec。注意加粗的部署列相对 2D 列的提升,以及 ŵ 与 w⋆ 是否接近。下半是 ScanNet200 scene0578_00 的定性三连:二维 7/13、三维 5/13、融合 10/13,绿对红错。对照椅子、门、白板等标签,看融合是否在不破坏已有正确标签的前提下救人。
核心结论
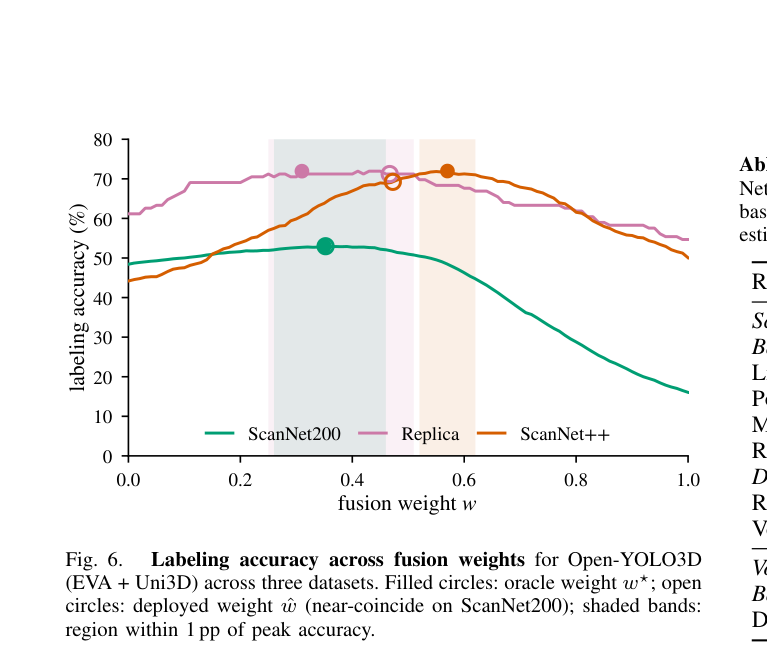
三条准确率–权重曲线。绿 ScanNet200、粉 Replica、橙 ScanNet++。实心点先知 w⋆,空心点部署 ŵ,色带是距峰值 1 个百分点的区域。ScanNet200 两圆几乎重合;Replica 空心略右偏仍在高台;ScanNet++ 的 ŵ 在峰值左侧但仍收回大部分先知增益。右侧露出表 V 表头残片,融合规则数字见表 V 正文。
实验如何设计?
- 三个基准:ScanNet200 验证集 312 场景 198 类、ScanNet++ 验证集 50 场景 84 类、Replica 按 OpenMask3D 的八场景划分 48 类。为把标注与提议质量分开,沿用三条 SOTA 管线的二值 mask 与每 mask 二维证据,只替换最终类指派。Open-YOLO3D 报告 EVA 与 CLIP 两种二维头;OpenMask3D 用 CLIP ViT-L/14 作物嵌入;Open3DIS 用 mask 池化的 CLIP 点特征。默认三维头 Uni3D-giant,配对研究另测 OpenShape。单卡 NVIDIA TITAN V 12 GB。
- 主指标 Acc 把每个提议匹配到 IoU≥0.5 的最高重叠真值实例。Open-YOLO3D / OpenMask3D 在 ScanNet200 上匹配 6534 个 mask,Open3DIS 为 28224 个。另按 top-1 与 flattened top-600 两种提交规则报 AP。Open3DIS 公开的是 softmax 后、经过滤的概率,作者重跑官方代码提取未过滤的预 softmax 余弦,在中心化空间评估,表中标 †。OpenMask3D 无 ScanNet++ 提议。
- 先知权重 w⋆ 用真值在 0.01 网格上最大化数据集准确率。部署权重是算法 1 的数据集级 ŵ,并与逐场景 ŵi 对照。回收率 rec=(Acc(ŵ)−Acc0)/(Acc(w⋆)−Acc0),Acc0 为 w=0 的纯二维准确率。互补性在 ScanNet200、Open-YOLO3D 的 6534 个 mask 上穷举 2D+2D、3D+3D、2D+3D。消融覆盖相关校正、硬伪标签 vs softmax、τ0/β 扫描、以及线性 / PoE / MaxPool / 秩 / Router / Veto / Dirichlet 等融合规则。运行时在整个 312 场景验证集上分阶段计时。
关键结果与论文证据
- 表 I:十一条设置标注准确率全部上升,中位 +7.1 个百分点(+3.8 到 +25.1)。无标签 ŵ 收回先知增益的中位 93%、最低 67%。数据集级 ŵ 落在准确率平台上,与逐场景 ŵi 均值最多差 0.04,二者效果相当。对场景做 bootstrap 后,ScanNet200 与 ScanNet++ 的增益全部高于零;Replica 只有八个场景,四个设置里只确认一个。
- Open-YOLO3D (EVA)+Uni3D 是主展示:ScanNet200 从 48.4 到 53.0(ŵ=0.352,w⋆=0.35,rec 99%);Replica 从 61.2 到 71.2(rec 93%);ScanNet++ 从 44.2 到 69.3(rec 91%,整体 +25.1 个百分点)。Open3DIS 在 ScanNet200 上 rec 为 100%(†)。图 4 的 scene0578_00:二维 13 个 mask 对 7 个,三维对 5 个,ŵi=0.47 的融合对 10 个,且没有把原先正确的标签改坏。
- 表 II:22 个 AP 设置里 21 个上升,最高约 +4.5 mAP。例外是 Open-YOLO3D (EVA) 在 ScanNet200 的 flat 规则,28.3 降到 28.2。作者强调 AP 随提交规则波动,所以不以 AP 为唯一结论。
- 表 III 解释为什么必须 2D+3D:EVA+CLIP 尽管 CLIP 单独 41.1 强于 Uni3D 的 16.1,融合只到 49.6(+1.2);identical-wrong 41.4%,Spearman ρ=0.677。EVA+Uni3D 融合到 53.0(+4.5),identical-wrong 仅 5.9%,ρ=0.226。OpenShape 相关更低,但单独太弱,增益只有 +0.9 到 +1.6。两头的 rescue rate 其实接近(CLIP 7.8%,Uni3D 7.5%),差别在于错误是否同向。
- 图 5:几何显著类获益最大,bathroom stall door +62、shower wall +30、armchair +29、jacket +23、curtain +21。靠纹理或上下文的小物体下降,tissue box −22、paper towel dispenser −21、toilet paper −21、lamp 与 bar 各 −18;这些下降类的中位点数都低于 1000。ScanNet200 只有最低点数四分位在降(−2.1 pp),第三四分位 +8.4 pp。小于 1000 点的 mask 占 ScanNet200 的 28%、ScanNet++ 的 0.7%,与 ScanNet++ 更大的整体增益一致。
- 图 6:三条数据集曲线在峰值附近都有宽平台(距峰值 1 个百分点的带宽约 0.06–0.27)。ScanNet200 上实心先知点与空心部署点几乎重合;即便 ScanNet++ 的 ŵ 落在平台外,仍收回 91% 先知增益。平台位置并不跨管线共享(ŵ 从 0.085 到 0.472),三个验证集 jointly 调一个常数权重只收回平均 81%,而 ŵ 为 89%;固定 w=0.30 会让 ScanNet++/Open3DIS 掉到纯二维以下。表 V:线性规则 53.0(+4.5),PoE 52.8(+4.3),MaxPool 不升,秩融合掉到 32.0,决策级 Router/Veto 各掉 1.6 与 1.2 点,说明必须在 arg max 之前融分数。Open-YOLO3D 原始稀疏检测计数只能当 Dirichlet 先验,+1.0。
- 运行时:基线提议 0.9 s、二维标注 24.6 s,共 25.4 s。SenseFuse 加 4.7 s 三维编码和 3.5 ms 权重估计(最大 11 ms)。双卡时三维编码可与二维标注并行,关键路径只多 3.5 ms;单卡串行也只多 18%。EVA 9.4 GB、Uni3D 3.9 GB。
阅读时需要注意
- 每个场景一个权重,不能表达“这个实例更该信二维、那个更该信三维”。作者把实例级自适应列为后续工作。
- 增益受较弱一头封顶。OpenShape 相关虽低,单独准确率不够,融合几乎涨不动;更强的形状编码器会直接抬高天花板。
- 闭式规则目前是两个头。多头推广是文中点名的方向,但没有实验。
- 小而纹理驱动的物体在融合后变差,退化集中在稀疏 mask。若场景里这类实例占比高,场景级 ŵ 可能伤到它们。
- Replica 样本极少,统计确认不完整。AP 对提交规则敏感,跨论文直接比 mAP 会误导。本文是 2026-09-17 预印本,尚未同行评审。
关联工作
- Open-YOLO3D、OpenMask3D、Open3DIS 代表训练免费开放词汇 3DIS:提议策略各异,标签几乎都来自二维或图像蒸馏。SenseFuse 把它们当冻结前端,只重评类指派,用来隔离标注贡献。
- Uni3D 与 OpenShape 把点云、图像、文本拉到同一空间,支持类名零样本形状识别。SenseFuse 证明它们在杂乱场景里不宜单独当标注器,但作为二维头的纠错通道很有用。
- PLA、OpenScene、RegionPLC 等训练式方法用二维监督训三维骨干,未见类会退化,这是本文坚持不训练、避免类偏的原因。
- ODIN 在单模型里融 2D/3D 特征,但是闭集。SenseFuse 用形状编码器保留几何意识,同时去掉固定标签集。
- CLIP 与 EVA-CLIP 是二维开词汇识别的标准底座。表 III 显示再加一个二维头收益很小,因为失败模式高度重叠。