快速导读:本文把视觉否定锚定在安全认知上,发布纯否定长描述数据集 SNUS,并用极性感知的 CESG Score 评测多模态大模型对缺失风险的生成式理解。
现有多模态大模型擅长给图像做肯定描述:车道上有白色两厢车、路边停着红色皮卡。安全场景真正要命的往往是该有却没有的东西——路口灯没亮、没有斑马线、没有指挥交通的人。这类缺失在认知上构成风险的“在场”,却长期被任务、数据和指标三层约束挡住:研究停在图文对比,数据枚举无功能意义的缺席,指标带着肯定偏差,遇到极性翻转就会崩溃。
本文把否定推理边界锚定在安全认知,定义 SNUS(Scene Negation Understanding under Safety Cognition)。数据集把局部危险的稠密断言映射成高保真纯否定长描述;评测侧提出 CESG(Cognitive Expected Scene Graph)Score,把不存在的物体、属性与关系写成反事实拓扑,再做极性感知与依赖跟踪。实验显示当前模型在该生成任务上挣扎,传统指标在语义反转下失效,CESG 能为风险感知的情境理解提供可用标尺。
英文题目:Benchmarking MLLMs via Cognitive Expected Scene Graph for Safety-Critical Visual Negation Understanding
论文出处:arXiv 每日论文精选 · /tmp/ingest_20260920/arxiv-2609-19767.pdf
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现代场景理解被写成捕捉可见现实:预训练对齐让 MLLM 精通像素里出现的实体。作者指出,场景的创建与演化也依赖缺席信息,人通过否定完成可行动的功能理解。交通与制造等安全关键域里,关键要素的缺失直接定义风险,机器感知需要从被动登记像素转向对缺席信息的自上而下推理。
既有视觉否定研究受任务、数据、指标三重限制。任务层几乎只做图像与否定文本的对比学习,忽略生成式描述;数据层缺少高层认知目标,常列举“场上没有篮球”这类正确但琐碎的缺席;指标层沿用 BLEU、ROUGE、SPICE、CAPTURE、CLIPScore 等工具,它们没有原生极性意识,也无法在物体、属性、关系之间跟踪拓扑依赖,遇到共指歧义与跨类语义交叉时会发生灾难性崩塌。
Table 1 把 SNUS 与 Valse、CC-Neg、NegBench、NegRefCOCOg、NEG-TTOI、CXR-Align 对照:前人数据几乎全是短句,且常混用 True Negative 与 False Negative。False Negative 把图中存在的物体写成不存在,便于制造人为错配,却评测不了“对真实缺失风险的主动推断”。SNUS 只保留 True Negative,并加上长描述与认知约束(CC)列。
肯定偏差不仅在模型里,也在尺子里。把真值里的 no / not / without 剥掉,得到 Affirmative Caption 基线后,字面重叠极高,传统指标不降反升,说明它们奖励的是表面词元而非安全逻辑。需要一条能对空拓扑打零分、又能把“没戴护目镜”与“眼睛未受保护”对齐的结构评测。
核心创新
- 把视觉否定推理边界锚定在安全认知,提出 SNUS 生成式任务而非对比匹配。
- 构造带物体、属性、关系与认知约束的纯 True Negative 长描述数据集。
- 提出极性感知、可跟踪拓扑依赖的 CESG Score,并系统评测商业、开源与微调 MLLM。
方法概览
定义 SNUS 任务,用四阶段人机协同管线构造安全约束下的纯否定长描述:混合真实与扩散图像,GPT-4o 标注缺失物体、属性与关系,再合成为段落并人工复核。CESG 经共指消解、去否定变换、分句、DiscoSG-Refiner 解析、正负图对比与合并得到;评测经硬匹配、同义/视觉共指、跨类交互、额外信息与软匹配,再按物体、属性、关系加权得到 CESG Score。
- 任务定义:SNUS 要求模型在安全认知约束下生成段落级纯否定描述,覆盖缺失物体(内在结构缺陷与外部防护缺失)、缺失关系与缺失属性,而不是做图文是否匹配的选择题。
- 数据管线四步。先混合网络抓取与扩散生成的安全关键图像;再用 GPT-4o 按安全约束自动标注缺失信息;接着由 MLLM 把结构化标注写成流畅段落;最后人机闭环复核,去掉幻觉,保证真值保真。
- 规模与形态。SNUS 含 12118 对图文,划分 8770 / 1548 / 1800。场景覆盖道路、工地等,危害包括火灾与坠落。语料统计缺失物体 29893、关系 42091、属性 5591。描述为多句稠密段落,句句含否定,均长 32.38 词(5 到 122),均含 3.51 个否定词(1 到 14)。
- CESG 与普通场景图不同:它对齐认知目标而非原始像素,可以包含图中不存在的节点,并丢掉与任务无关的可见细节。图 3a 用工地例子说明:墙边消防箱与地面工人旁的消防箱应共指同一物体;“没戴护目镜”与“眼睛未受保护”应算高相似语义;安全帽必须挂到脚手架上的工人,而不是地面工人。
- 六阶段构图:LINGMESS 做代词与复数共指;去掉否定修饰得到肯定文本;NLTK 分句;DiscoSG-Refiner 分别解析否定句与肯定句;交叉对比,把只出现在否定图中的内容标成黑节点与虚边;再按规则合并到场景级 CESG——已存在物体仅在指称相同才去重,缺失信息禁止合并以免语义损失。
- 匹配流水线先滤出纯在场子图,再对缺失物体、属性、关系做硬匹配、WordNet 同义加 MLLM 视觉仲裁、SimCSE 跨类交互匹配、额外信息匹配与同类软匹配。每个缺失元素带着依赖集 D(e):属性挂父物体,关系挂主客体及其指称,避免把“没有灭火器”错安到错误容器上。
- CESG Score 是加权宏观 F1:wo·F1o + wa·F1a + wr·F1r,且 wo+wa+wr=1。实现里取 wo=0.5、wa=0.25、wr=0.25,强调物体作为拓扑锚点,同时用属性与关系惩罚把否定边错接到事实实体上的刷分行为。
逐图理解论文
失败直觉
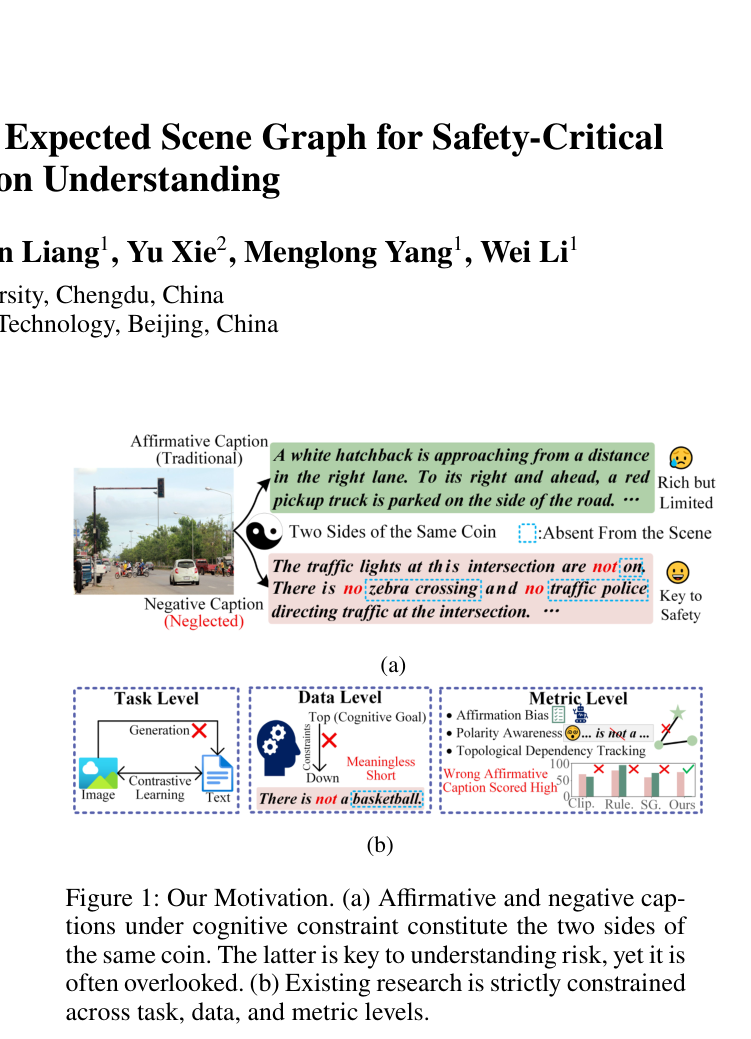
先看路口照片与太极符号:绿色肯定描述只登记白色两厢车与红色皮卡,被标成丰富但有限;粉色否定描述点出灯未亮、无斑马线、无交警,被标成安全关键。再看下方三块:任务层生成被打叉、只剩对比学习;数据层缺少认知目标、举“没有篮球”的无意义短句;指标层柱状图里 Clip / Rule / SG 对错误肯定描述打高分,Ours 打对号。这张图把全文的问题、缺口与尺子失败画在一页。
研究缺口
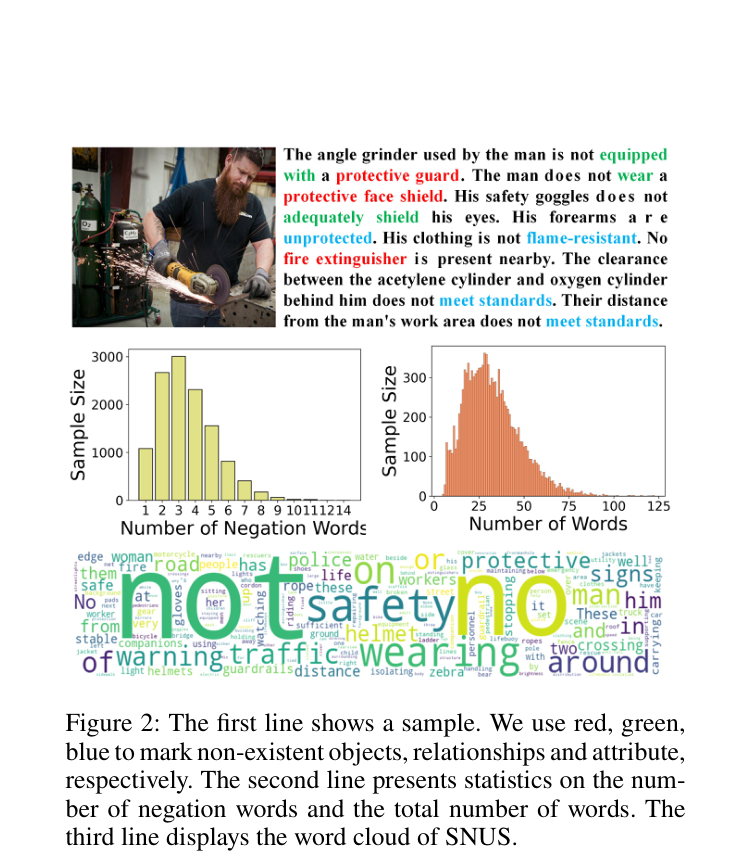
第一行车间样本用红、绿、蓝分别标缺失物体、关系与属性:无防护面罩、无灭火器是物体,角磨机未装防护罩、气瓶间距不合规是关系,前臂无防护、衣服不阻燃是属性。第二行直方图给出否定词个数与总词数分布;第三行词云以 not、no、safety、wearing、helmet 为主。用来建立“句句否定、安全词密集”的数据直觉。
方法贡献
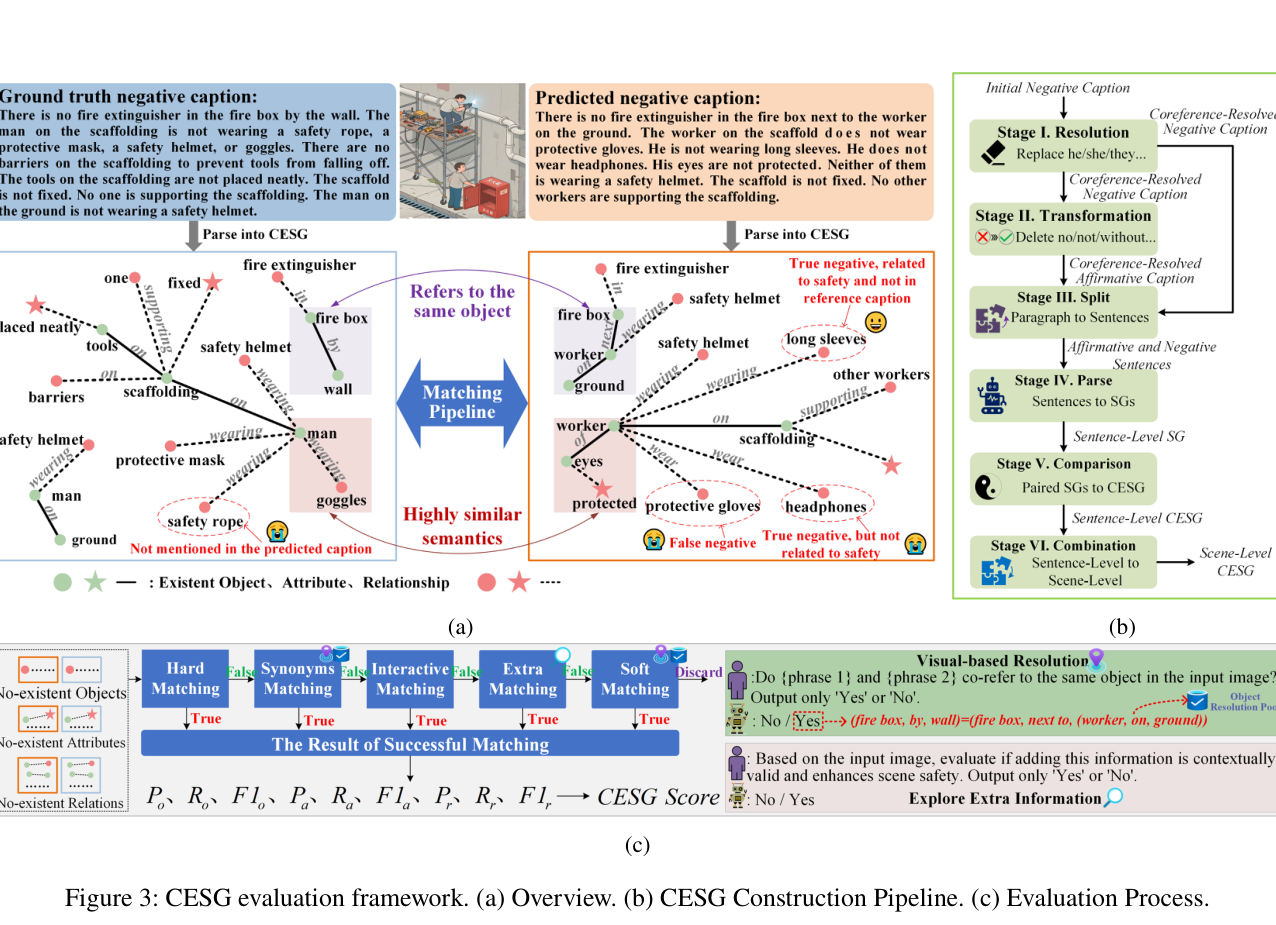
这是方法主图。左上真值与预测否定描述被解析成两张 CESG,中间 Matching Pipeline 标出共指(墙边消防箱与工人旁消防箱)、高相似语义(护目镜与眼睛未保护)以及预测里的假否定。右侧六阶段构图从 Resolution 到 Combination。底部硬匹配到软匹配汇成物体、属性、关系的 P/R/F1,再得到 CESG Score。读图时跟住虚边缺失与实边在场的颜色约定。
实验如何设计?
- 评测 13 个 MLLM,分商业、开源与在 SNUS 训练划分上 LoRA 微调三组。商业模型包括 GPT-4o、GPT-5.4、Claude-opus4.8、Claude-sonnet5、Gemini2.5-flash 与 Gemini3.5-flash;开源包括 LLaVA1.5-7B、Llama3.2-11B、Qwen2.5VL-3B/7B、Qwen3VL-4B/8B 与 Intern3.5VL-14B。
- 训练在两张 NVIDIA RTX A6000 上进行,LLaMA-Factory LoRA rank=8,学习率 1×10⁻⁴,5 个 epoch。推理全部 greedy decoding,保证描述可复现。CESG 权重固定为 0.5 / 0.25 / 0.25。
- 对照指标包括词面重叠(ROUGE-L、METEOR、CIDEr、BLEU-4)、结构指标(CAPTURE、SPICE)与嵌入指标 CLIPScore。Affirmative Caption 基线从真值剥离否定修饰,专门压迫肯定偏差。
- 一致性实验用 GPT-4o 作裁判,真值描述锚定 8/10,9–10 分留给发现未标注风险的模型。统计量包括 Pearson 相关、决定系数、Kendall τ、Sample γ、Spearman ρ 与同场景 Pairwise Accuracy。
- 消融遍历物体、属性、关系权重的单类、两两组合、均等三分与默认 0.5/0.25/0.25,看哪组与裁判最齐。
关键结果与论文证据
- Affirmative Caption 在几乎所有传统指标上反超全部商业、开源与微调模型:ROUGE-L 91.64、METEOR 90.04、BLEU-4 71.72,CAPTURE 59.41、SPICE 94.55;CLIPScore 虽低至 21.66 仍无法有效惩罚极性反转。CESG 对 AC 的各类精细维度与总分均为 0,因为空的反事实拓扑表示它没有定位任何缺失危害(第 6 页,Table 2)。
- 零样本 CESG 出现明显天花板:开源 Qwen3VL-8B 为 49.12,商业 Claude-sonnet5 为 49.74。监督微调能拉开词面指标(如 CIDEr 可到百量级),但 CESG 峰值只到 Qwen3VL-4B 的 53.67,说明拟合否定句式不等于穷尽风险(第 6–7 页,Table 2)。
- 性能被召回卡住。GPT-4o 物体精确率 Po 达 92.29%,召回 Ro 只有 34.79%;微调模型召回也大约停在 50%。作者把它归因于预训练对齐的肯定偏差:模型更会核实已经注意到的显式危害,而不会主动推断像素外的缺席(第 7 页)。
- 关系与属性弱于物体。F1r、F1a 低于 F1o,说明否定上下文需要多跳:先锚定不存在的实体,再解析它该挂在哪个人、哪只箱子或哪段防护关系上(第 7 页)。
- 与裁判一致性上,词面与结构指标多为负相关,CIDEr 的 PCC 为 -0.5644,SPICE 为 -0.6130,Pairwise Accuracy 可低至 11.58%–18.16%;CLIPScore 的 PA 接近随机的 56.73%。CESG 取得 PCC 0.7578、R2 0.5743、Kendall τ 0.6336、Sample γ 0.7866、Spearman ρ 0.7912、PA 86.41%(第 6–7 页,Table 3)。
- 权重消融支持“物体是锚、属性与关系是罚项”:仅物体时 PCC 0.7027、Spearman ρ 0.7198;去掉物体后 PCC 与 R2 大约掉到 0.56 与 0.31;纳入 wa、wr 后 Pairwise Accuracy 从 0.7034 升到 0.8641。默认 0.5/0.25/0.25 在所试配置中最高(第 7 页,Table 4)。
阅读时需要注意
- 即使微调,CESG 仍停在五十多分,作者承认场景认知因无法穷尽潜伏风险而根本不完整。
- 高精确、低召回说明评测暴露的是“看见了能说对、没看见就不会找”的盲区,而不是已经可部署的安全感知。
- 人机一致性依赖 GPT-4o 裁判,不是大规模安全专家标注;额外匹配同样调用 MLLM,可能与被测模型共享肯定偏差。
- 图像来自网络与扩散生成的混合语料,真实工地或路口的长尾分布未必被覆盖。
- 短文未给出公开数据或代码入口,复现 CESG 六阶段管线与视觉仲裁需要自行实现。
关联工作
- Valse、NegBench、NegRefCOCOg、NEG-TTOI 等把否定主要写成短句 True Negative 或 False Negative 的对比题,评的是匹配而不是生成风险描述。
- CC-Neg 覆盖物体、属性与关系,但仍是短句、无认知约束;CXR-Align 把否定带到医学影像,同样不是安全长描述。
- SPICE 与 CAPTURE 用事实场景图刻画语义依赖,作者认为它们登记的是在场信息,不能表示不存在与反事实拓扑。
- CLIPScore 被写成视觉词袋匹配:对实体共现敏感,对“没有斑马线”这类极性翻转不敏感。
- SC-Captioner 试图缓解否定评测,本文认为它仍停在像素可见感知,无法从认知视角检查看不见的信息。
- DiscoSG-Refiner 提供篇章级解析能力,但直接用在否定句会漏边极性、无法区分并行同质物体,并推断未陈述关系,故 CESG 必须先变换再对比。