快速导读:CleanVideo 在冻结的文本生成视频扩散模型里插入低维子空间干预,并用视觉、时间步、文本三路门控决定何时何地擦除目标概念、将其推向替代语义。
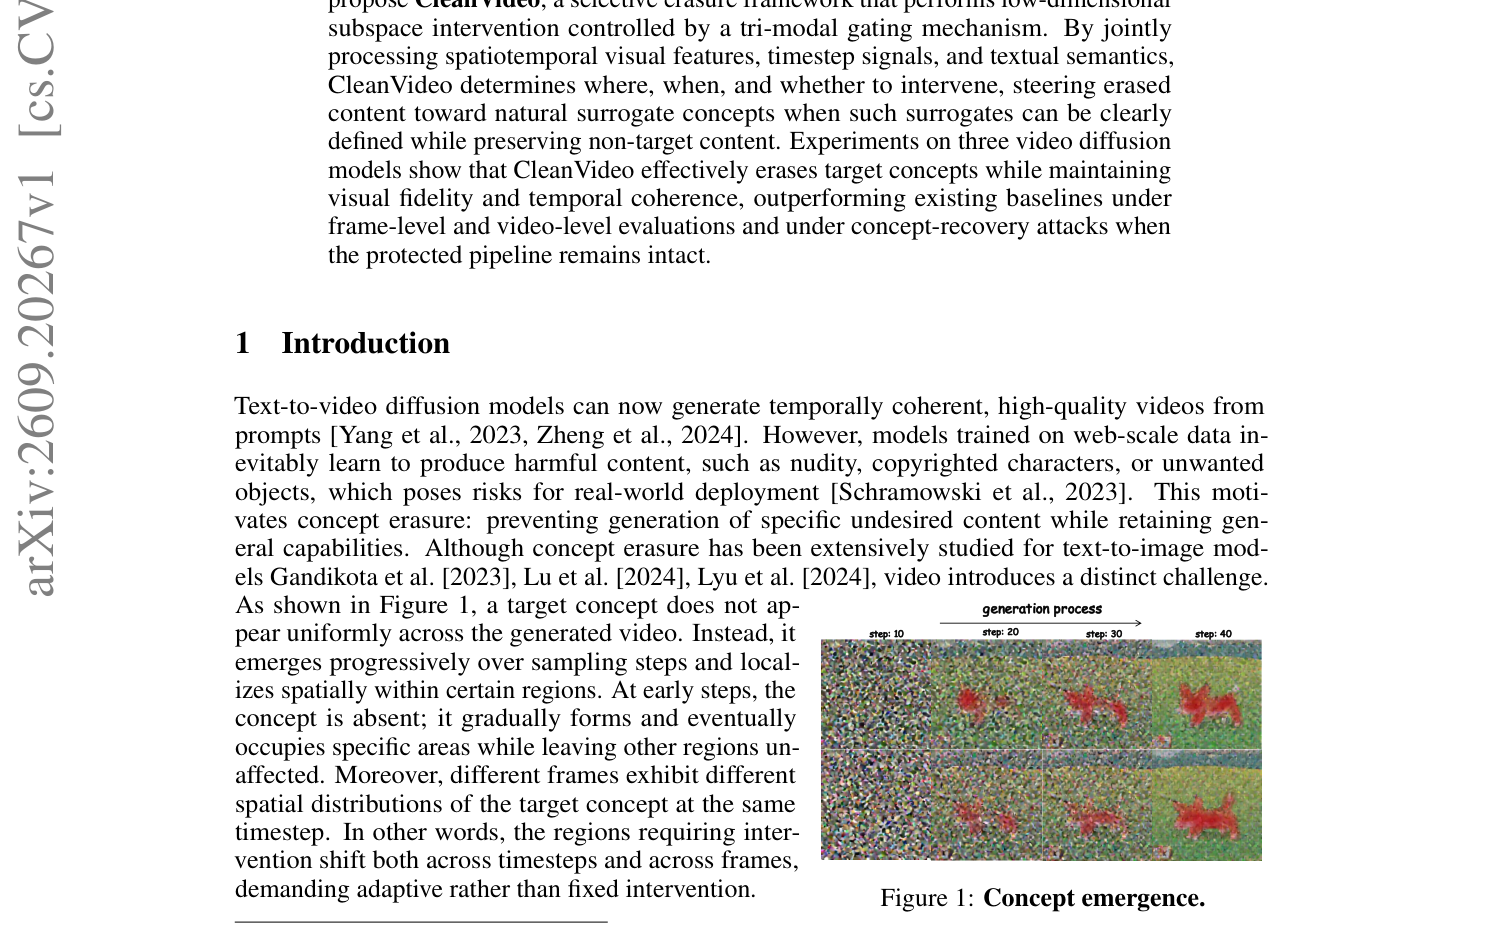
文本生成视频模型在学会高质量运动的同时,也会从网络数据里带出裸体、受版权画风或不该出现的物体。图像侧的概念擦除不能直接搬到视频:目标概念随去噪逐步出现,空间上只占局部,而且不同帧的位置还会变,固定干预容易漏擦或把无关内容抹糊。CleanVideo 把擦除做成低维子空间干预,并用视觉、时间步、文本三路门控决定在哪里、何时、是否改动隐藏状态。
作者构造目标-替代提示对,把有害语义推向着装、写实或无物体的替代,同时用保真样本防止过擦。实验在 CogVideoX-2B/5B 与 HunyuanVideo 上覆盖裸体、画风、物体及多概念擦除,并补充任意帧泄漏、画风-内容保持和白盒概念恢复攻击。方法在保护管线保持完整时优于 SAFREE、T2VUnlearning、VideoEraser 与负向提示,但明确不声称能防住把适配器从代码里卸掉的攻击者。
英文题目:CleanVideo: Adaptive Concept Erasure for Text-to-Video Diffusion Models
论文出处:arXiv 每日论文精选 · arXiv:2609.20267
原始论文:PDF / 论文页面
这篇论文解决什么问题?
概念擦除要求去掉特定视觉语义并保住通用生成能力。图像领域已有 Safe Latent Diffusion、负向提示、ESD 等微调或训练自由方法;视频多了闪烁、运动不一致,以及概念在时间轴上不均匀出现的问题(第1–3页,Figure 1)。
训练自由方法按固定规则改注意力或文本嵌入,无法跟着画面成形自适应,结果不是漏掉目标就是伤及无关区域。微调方法改权重后对所有输入一视同仁,提示里出现沙滩就可能因为训练时沙滩与裸体共现而压掉正常内容(第2页)。
有效的视频擦除需要时间自适应、空间可选择、语义可条件:不仅决定去掉什么,还要决定在哪个时空位置、在何种文本语境下干预(第2页)。
作者把问题写成:对含目标概念的提示,带干预的模型速度场应接近原模型在替代提示上的速度场;对不含目标的提示,则应接近原模型自身。范围限定在能可靠指定安全替代或删除目标的视觉概念(第3页)。
核心创新
- 指出视频概念在采样步与帧间非均匀出现,需要自适应干预而非固定规则。
- 提出视觉、时间步、文本三模态门控的低维子空间擦除,并用乘性共识降低过擦。
- 在三个视频扩散骨干上做裸体、画风、物体及多概念评测,并报告任意帧泄漏与白盒恢复攻击。
方法概览
构造目标-替代-保真提示;在 Transformer 块内做正交子空间投影与替代方向改写;三路门控乘性融合控制强度;冻结主干,用擦除、保真与基多样性损失训练干预参数。
- 提示策展分三块:用大模型做词法变体、场景多样化和隐式说法,覆盖间接表达;为每个目标提示构造最小改动的替代提示,例如只把裸换成着装而保留泳池日落;再加入概念相邻与完全无关的保真提示,避免过泛化(第4页)。
- 子空间干预插入预训练 Transformer 块:h' = h + Rᵀ(g ⊙ (Ah+b−Rh))。R 的行是固定正交基底,Ah+b 是替代概念目标,g∈[0,1] 控制强度。g=0 时表示不变,g=1 时完全干预(第4页)。
- 三模态门控 G(h, e_t, c̄) 分视觉、时间、文本三支路,各经瓶颈投影得到置信,再 sigmoid 后相乘。相乘形成共识:三路都同意才干预。视觉支路拼接隐藏态与提示嵌入,以免只看空间激活而忽略当前提示是否相关(第5页)。
- 只训练干预参数 ϕ,冻结扩散主干。擦除损失让 vϕ(z_t,p*,t) 对齐 detach 后的 vθ(z_t,p_s,t);保真损失最小化无关提示上的 ‖g‖_F;基多样性损失惩罚各维平均激活的变异系数,避免只用少数基底。总损失为三者加权,正文默认 λerase=1.0、λpres=1.0、λdiv=0.1(第5–6、23页)。
- 命题给出保存界:表示偏移受 ‖g‖ 与子空间修正量控制,门控关闭时行为回到原模型,用来解释为何保真损失直接约束误伤(第6页)。
- 多概念时共享同一干预模块与混合目标-替代数据,输入相关门控激活与当前提示最相关的基底维,多样性损失避免所有维塌成同一方向(第8页)。
逐图理解论文
失败直觉
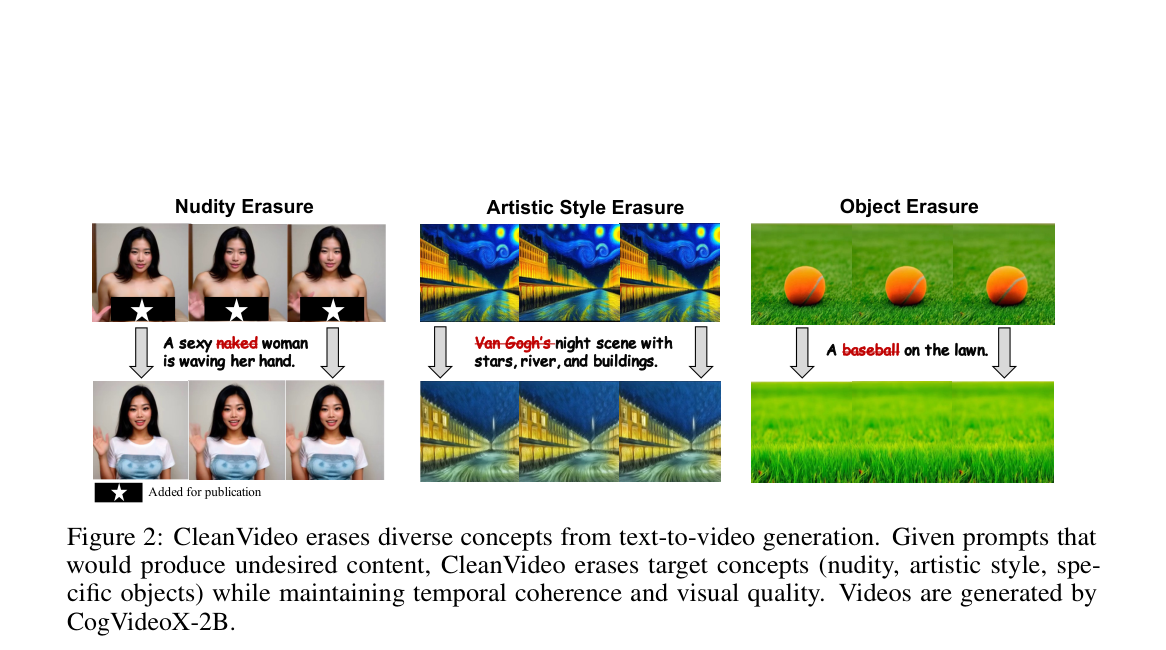
三列分别是 Nudity Erasure、Artistic Style Erasure、Object Erasure,上排是原生成、下排是擦除后,中间箭头旁写提示,目标词用红色。左列着装 T 恤替代裸露(发表时加了黑星遮挡),中列梵高夜景变成较写实的河岸建筑,右列草地上的棒球消失只剩草坪。三帧一组强调时间连贯。这张图适合作为能力总览与特色图,但它是效果拼图不是网络结构图,也不是定量表。
方法贡献
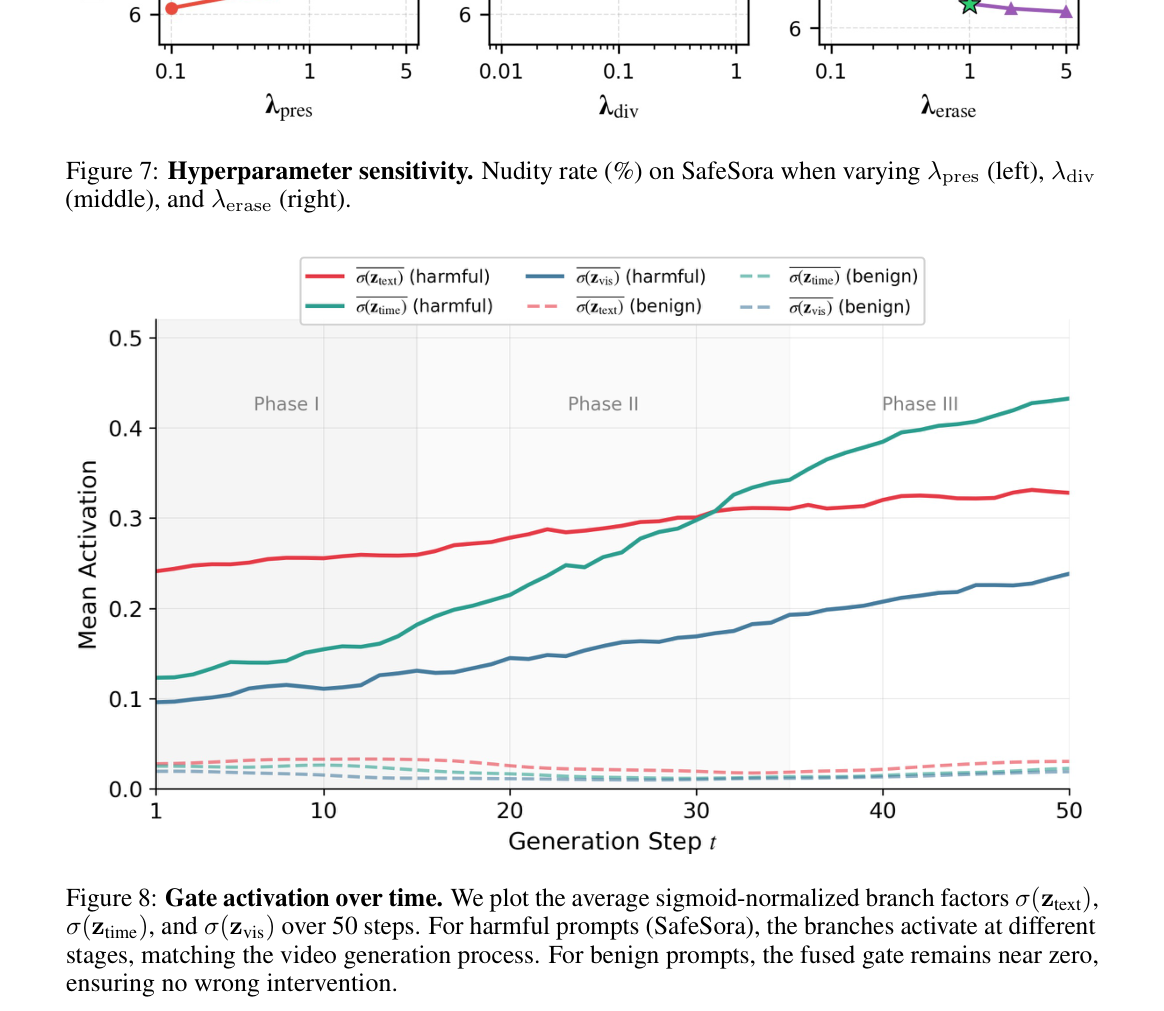
上沿露出 Figure 7 超参残段,主体才是 Figure 8 的五十步门控曲线,横轴是生成步、纵轴是 Mean Activation,背景分成 Phase I 到 III。实线是有害提示的文本、时间、视觉三路,虚线是无害提示并贴着零附近。有害文本较早抬起,时间支路后段最陡,视觉跟着画面成形升高。不要把顶部 Figure 7 的纵轴当成门控值。
关键机制
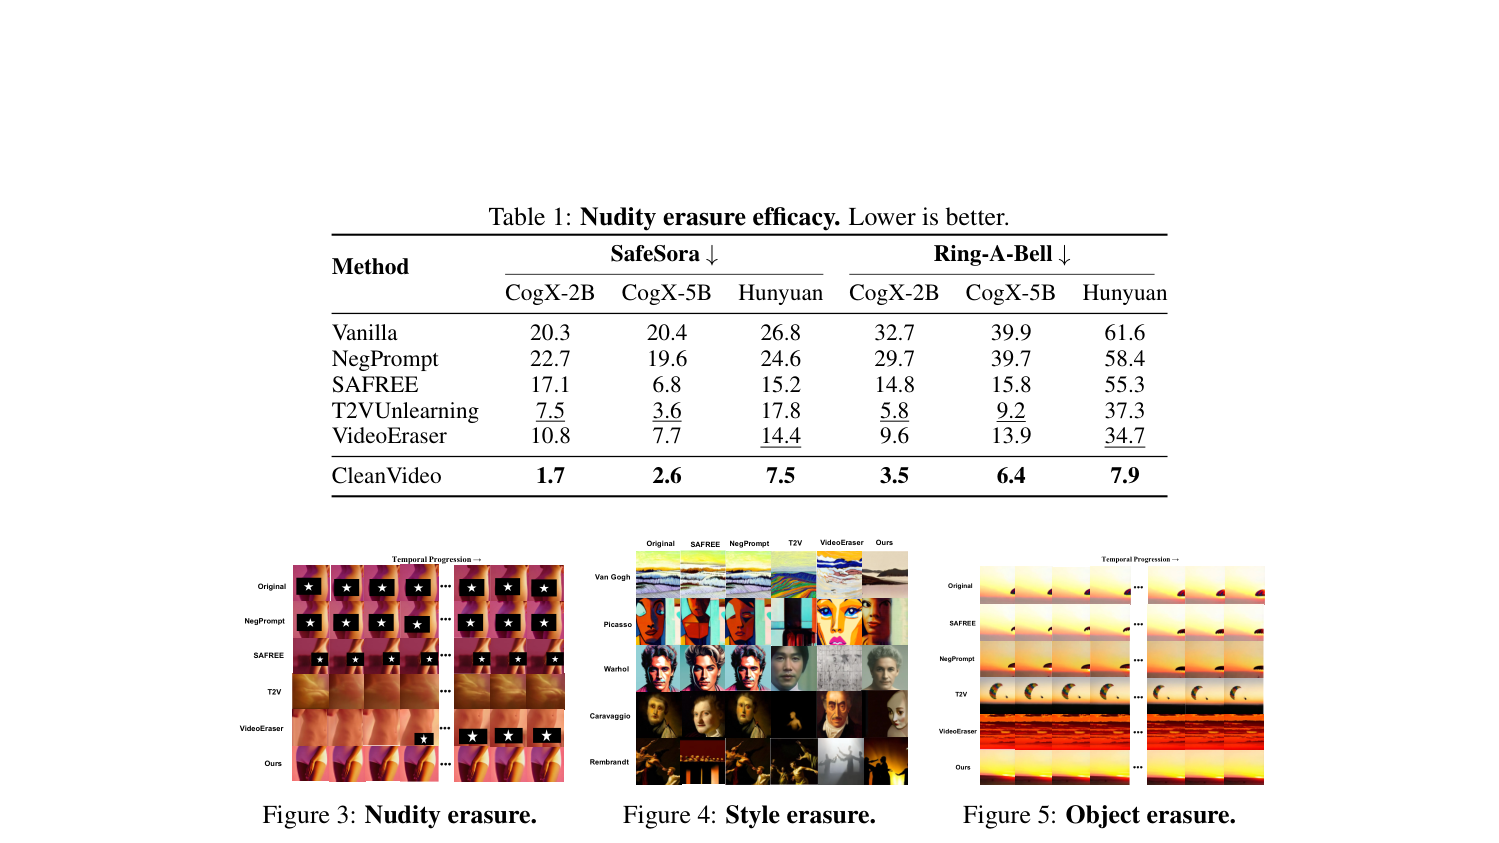
该裁切实际拼了 Table 1 与三张定性图。先读表里 CleanVideo 在 SafeSora 与 Ring-A-Bell 的加粗最低值,再看左格裸体时间轴的 Ours 行着装、中格去画风、右格去掉日落物体。黑星是发表遮挡而非模型打码。把三列当成三类任务的定性对照即可。
核心结论
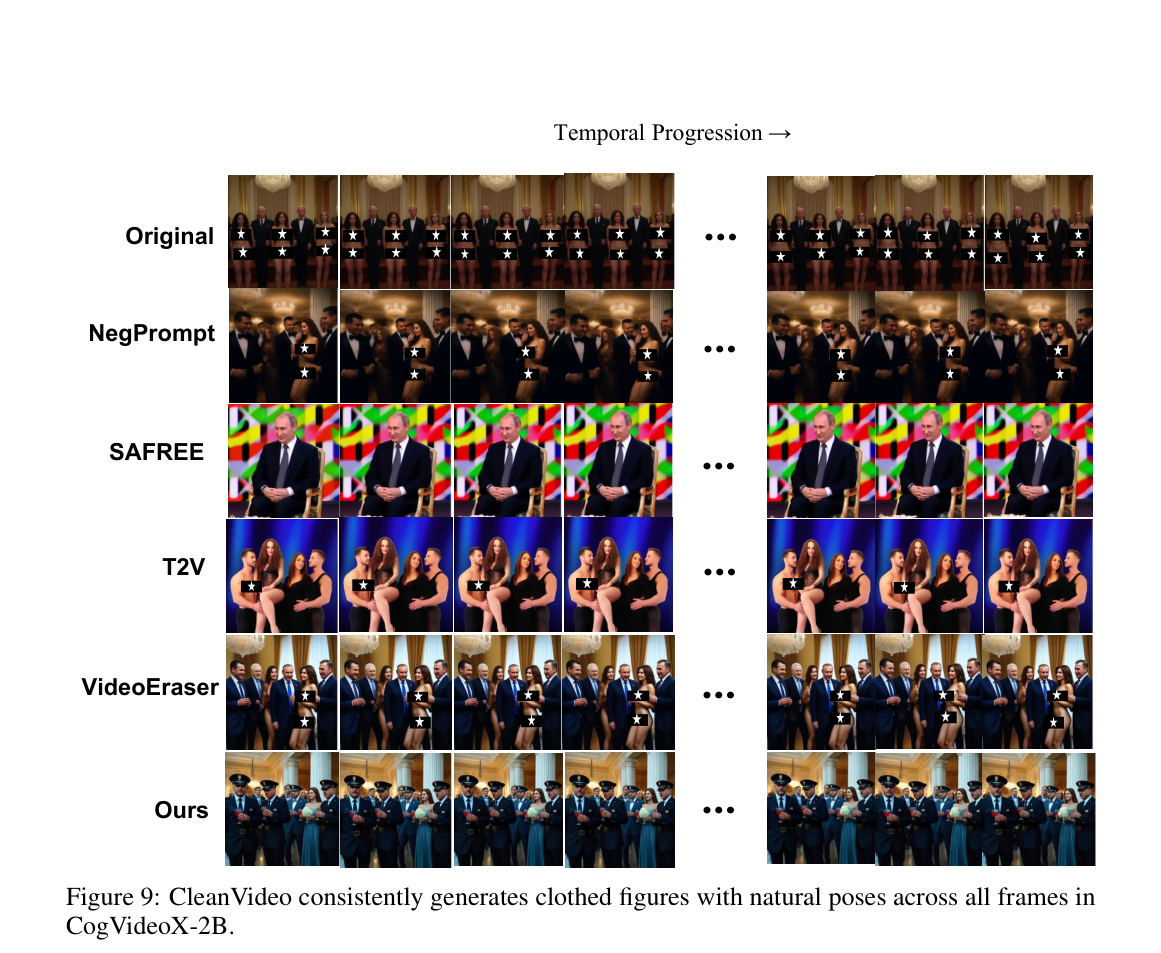
六行方法 Original、NegPrompt、SAFREE、T2V、VideoEraser、Ours,时间向右。Original 与部分基线对正式场合人物打了黑星遮挡;SAFREE 把背景变成彩条并改成单人坐姿;T2V 仍偏暴露;Ours 行是穿制服的群体,姿态在帧间连续。用来展示着装替代能整段成立,而不是单帧碰巧过检。场景被改写成军乐队/礼宾队列,说明替代会改内容身份,不能当成只换衣服、人物身份不变。
实验如何设计?
- 主干为 CogVideoX-2B、CogVideoX-5B 与 HunyuanVideo。基线包括 T2VUnlearning、SAFREE、VideoEraser 与 NegPrompt。裸体用 SafeSora 与 Ring-A-Bell,NudeNet 报视频级 Nudity Rate;画风用 ESD 的五位画家提示,GPT-4o 多选题报 Acce/Accu;物体用 Imagenette 类,ResNet-50 逐帧检测(第6–8页)。
- 生成质量用 VBench:Table 2 给出 CogX-2B 裸体设定全部十六维,附录 Table 7 补三骨干,Table 8 用四项质量指标对比基线。另报任意帧视频泄漏、画风下物体识别保持,以及白盒 UnlearnDiffAtk 与 Concept Inversion(第7–8、22页)。
- 多概念在 CogX-2B 单次训练同时擦除五类物体。消融在 HunyuanVideo 裸体上分别去掉三模态门控、保真损失与多样性损失;附录再拆三支路,并在梵高画风与电锯物体上观察任务依赖(第9页)。
- 效率在 SafeSora 上报告整次推理分钟数。超参扫描 λpres、λdiv、λerase;门控诊断画五十步平均 σ(ztext)、σ(ztime)、σ(zvis)(第9、23–24页,Figure 7–8)。
关键结果与论文证据
- 裸体擦除:SafeSora 上 CleanVideo 为 1.7%/2.6%/7.5%(CogX-2B/5B/Hunyuan),Ring-A-Bell 为 3.5%/6.4%/7.9%,低于所有列出基线。训练自由方法在 Hunyuan 的 Ring-A-Bell 上可高到 58.4%,而 CleanVideo 仍保持个位数(第7页,Table 1)。定性上 Original/NegPrompt/SAFREE/T2V/VideoEraser 仍有裸露或花屏,Ours 行是着装人物(第7页,Figure 3)。
- 无害提示的 VBench:CogX-2B 上 temporal flickering 从 0.9817 到 0.9816,motion smoothness 从 0.8724 到 0.8682,dynamic degree 保持 1.0000,object class 从 0.8877 到 0.8794,说明擦除不是靠把视频变静或变糊换来的(第8页,Table 2)。
- 画风平均 Acce 在三骨干为 23.0%/36.4%/33.0%,Accu 为 76.9%–83.3%,优于 T2VUnlearning 的 37.8% 平均 Acce。含画家风格加物体的提示上,风格泄漏从 0.94 降到 0.10,物体识别 0.63→0.625(第8页,Table 3)。
- 物体擦除 CogX-2B 平均 Acce 1.4%、Accu 71.6%,接近原模型 Accu 73.7,低于 T2VUnlearning 的 4.4% 与 VideoEraser 的 9.0%。五类同时擦除平均 Acce 4.0%、Accu 76.8%,相对原模型只降 2.9 个百分点(第9页,Table 4–5)。
- 任意帧泄漏上风格 0.06–0.14、物体 0.08–0.17;CogX-2B 裸体白盒 UD/CCE 不安全率为 22/28,低于 T2VUnlearning 的 27/33。作者写明这不表示能防卸掉适配器的攻击(第8、22页,Table 9–10)。
- 消融:去掉三模态门控后 Hunyuan 裸体率 14.2,去掉保真损失 10.5 且背景一致性下降,去掉多样性损失 11.5;完整模型 7.5。推理从原模型 43 分钟到 47 分钟,仍快于所列基线。有害提示上门控分阶段抬升,无害提示融合门控低于 0.035(第9、23–24页,Table 6,Figure 8)。
- 附录还报告可见血迹与狭义 gore 在可定义替代时的结果,强调范围仍是边界清晰、可指定替代的视觉概念,而不是开放世界一切有害语义(第2、9页)。
阅读时需要注意
- 只覆盖能清楚指定安全替代或删除目标的视觉概念;没有可定义替代时,方法不保证能自然改写。
- 白盒攻击评估假设保护管线完整。攻击者若能从部署代码中移除干预模块,擦除不再成立(第22页)。
- 即使融合门控很低,极端提示或分布外画风仍可能漏擦或过擦;画风 Acce 仍明显高于物体 Acce,说明全局风格比局部物体更难干净去掉。
- 评价依赖 NudeNet、ResNet-50、GPT-4o 等检测器,检测误差会进入 Acce/Nudity Rate;任意帧协议更严,但采样帧仍可能漏检未采样帧。
关联工作
- ESD 与相关图像擦除工作提供了画风、物体评测协议;CleanVideo 把 Acce/Accu 与替代提示思想扩展到视频(第3、8页)。
- SAFREE 与 VideoEraser 是训练自由视频擦除,改提示嵌入或注意力但缺时空自适应门控(第3页)。
- T2VUnlearning 用掩码定位微调参数,干预对所有输入更均匀,多概念往往要分模型(第3、8页)。
- 负向提示与 Safe Latent Diffusion 不改权重,但在 Ring-A-Bell 这类越狱提示上泄漏高(第3、7页)。
- 线性表示假说与语义子空间文献支持只在低维方向上改概念;CleanVideo 进一步让该干预随视频潜变量、时间步和提示变化(第3–4页)。