快速导读:PART 把三维零件检索与装配写成集合预测,用查询式 Transformer 同时选出零件、估计六自由度位姿并分割目标,再以分割增强优化 refinement 装配。
三维内容生产、游戏和制造里,复杂物体往往由可复用零件拼成,而不是一次生成一整块网格。现有装配方法多假设输入零件集合正好对应目标所需部件,一旦零件库出现冗余、缺失或可替换件,固定集合网络就无法同时完成检索与六自由度放置。SIGGRAPH Asia 2026 论文 PART 把零件检索与装配写成集合预测问题,用统一的查询式 Transformer 在一次前向中选出零件并估计刚体位姿。
框架用 Point Transformer v3 提取目标点级特征与零件全局特征,经自注意力与交叉注意力交互后,由一组可学习实例查询并行预测检索类别、分割掩码和装配位姿;未匹配查询落入空类,从而支持可变长度输出。作者还利用装配与分割的对偶关系,在测试阶段用分割增强优化 refinement 初始位姿,并配以 A-Matrix 旋转表示与对称感知损失。实验覆盖 PartNet 固定零件装配、千件库检索装配、3D-FRONT 场景布局、Hunyuan3D 单图提升目标以及 Redwood 真实扫描。
英文题目:PART: Learning 3D Part Assembly and Retrieval with Transformers
论文出处:arXiv 每日论文精选 · arXiv:2609.19872
原始论文:PDF / 论文页面
这篇论文解决什么问题?
传统 CAD 装配需要设计师在软件里手工摆放成百上千个零件。近年文本或图像驱动的三维生成能得到看起来合理的几何,但工业设计、游戏资产和制造流水线更需要从已知、可复用的零件库重建目标,以保留零件身份、可编辑性和库兼容性(第2页)。
既有装配工作如 DGL、RGL、SPAFormer、ScorePA、3DHPA、Assembler 等,主要在给定零件集合上估计位姿,默认这些零件恰好能拼出目标。UPRA 把检索和装配耦合到潜空间优化,但仍依赖超参数或规则控制检索数量;GPAT 借助目标分割辅助装配,却仍要求预定义输入零件、不做检索(第2–3页)。
检索式装配面临三道难关:组合爆炸随库规模快速增长;不同目标需要不同零件数量,固定长度网络难以直接输出;一般零件装配要在连续非欧的 SE(3) 上估计位姿,而不是乐高那样的离散插接(第2页)。
作者因此把问题重新表述为:给定目标点云与规范位姿的候选零件点云库,允许重复取件,检索子集并预测每个被选零件的刚体变换,使装配结果重建目标几何(第3–4页)。
核心创新
- 把零件检索与装配表述为可变长度集合预测,用 DETR 式实例查询一次前向同时取件与放置。
- 联合训练检索、装配与分割,并在测试时用分割增强优化 refinement 位姿。
- A-Matrix 无奇异旋转回归加对称感知损失,缓解 SE(3) 姿态估计与对称件歧义。
- 整理逾八万形状的多样零件数据,并展示场景布局、单图目标与真实扫描泛化。
方法概览
用 Point Transformer v3 编码目标点云与候选零件,查询式 Transformer decoder 并行预测检索类别(含空类)、点级分割与 A-Matrix 旋转加平移;二分匹配训练,对称感知损失处理离散对称,测试时用分割-装配对偶做后处理优化;训练短库、测试长库。
- 特征提取:对目标点云 P 与候选零件集合 C,分别用 Point Transformer v3 得到点级特征 fP(目标点数 Np=10000)和零件全局特征 fC,再经自注意力与交叉注意力交换信息(第4页,Figure 2)。
- 查询式解码:固定数量的可学习实例查询在 L 层 Transformer decoder 中先做 query 自注意力,再依次交叉注意零件特征与目标特征,使每个查询成为检索与放置的代理(第4页)。
- 三个并行头:检索头把查询分类到 M 个候选索引加一个空类;分割头把目标点分给各查询实例;装配头预测平移 t 与十参数对称矩阵 A,再取最小特征值对应的特征向量作为四元数,采用 A-Matrix 以避免 SO(3) 回归的次优性(第4页)。
- 训练用二分匹配消除集合预测的排列歧义,匹配代价同时考虑检索概率、平移误差和分割一致性。检索与分割用交叉熵;平移用 ℓ2;旋转在二十四类立方对称中筛选 Chamfer 距离低于 10^{-3} 的有效对称,再取 Chamfer 与测地距离的最小值作为对称感知损失(第5页,Figure 3)。
- 总体损失联合监督平移、旋转、接触/几何一致性、检索与分割,并采用 train-short-test-long:训练时每个形状配对固定 M=20 的库(真零件加随机干扰件),推理时可接到远大于二十的库,默认实验用 M'=100,检索对比甚至用一千个独特零件(第2、6–7页)。
- 推理时按检索头最大概率把查询赋给零件或空类。随后进入分割增强优化:用预测位姿变换零件诱导分割,再用分割区域把零件对齐回去,目标函数同时最小化装配与目标的 Chamfer、零件到分割区域的 Chamfer,以及分割交叉熵,使装配与分割互相校正(第5页)。
- 注意力可视化显示,有效查询会逐步把目标局部区域与几何兼容零件对应起来,得到一致的分割与装配(第8页,Figure 6)。
逐图理解论文
失败直觉
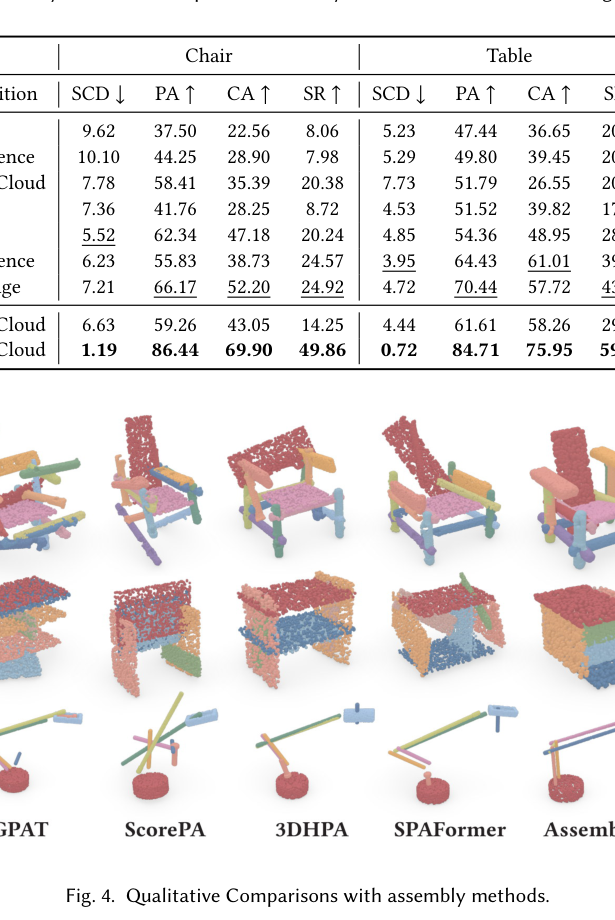
裁切上部露出 Table 1 的 Chair/Table 数值,Ours 一行加粗,Chair 的 SCD 1.19、PA 86.44、CA 69.90、SR 49.86。下部三行点云分别是椅子、桌子、台灯,从左到右为 GPAT、ScorePA、3DHPA、SPAFormer、Assembler。对比基线的散架椅腿、错层桌面和交叉灯臂,用来说明固定零件装配的失败模式,但本图右侧 Assembler 列被裁切,完整数字以正文表格为准。
研究缺口
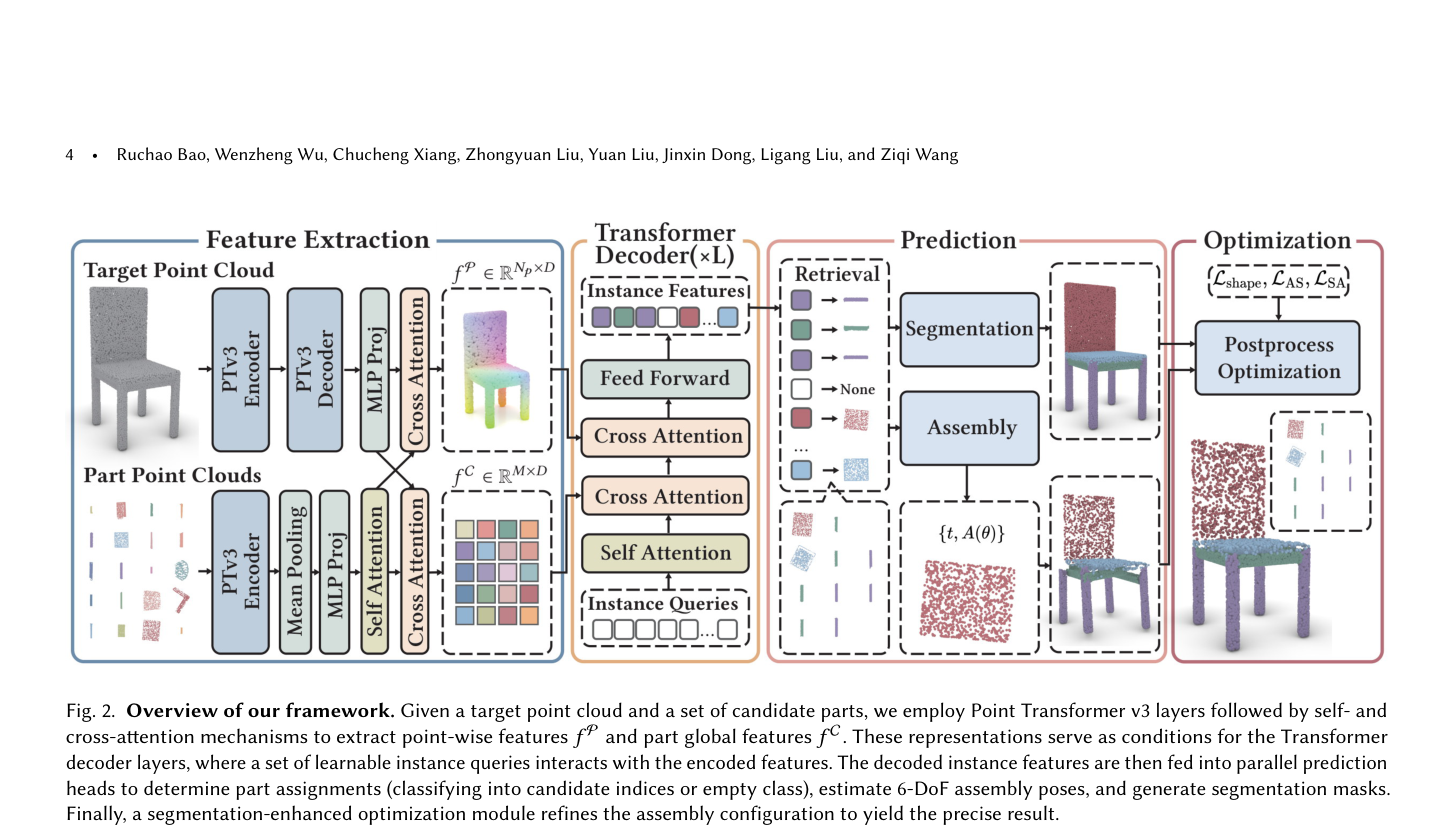
按蓝橙红绿四段从左到右读流水线。左侧椅子点云与彩色零件分别进 PTv3,经交叉注意力得到着色椅背特征与零件 token;橙色解码器里实例查询经自注意力与两层交叉注意力;红色预测头分出 Retrieval(含 None)、Segmentation 与 Assembly 的 {t,A(θ)};绿色后处理用 Lshape、LAS、LSA 把散乱零件收成完整椅子。这张图适合作为方案总览与特色图。
方法贡献
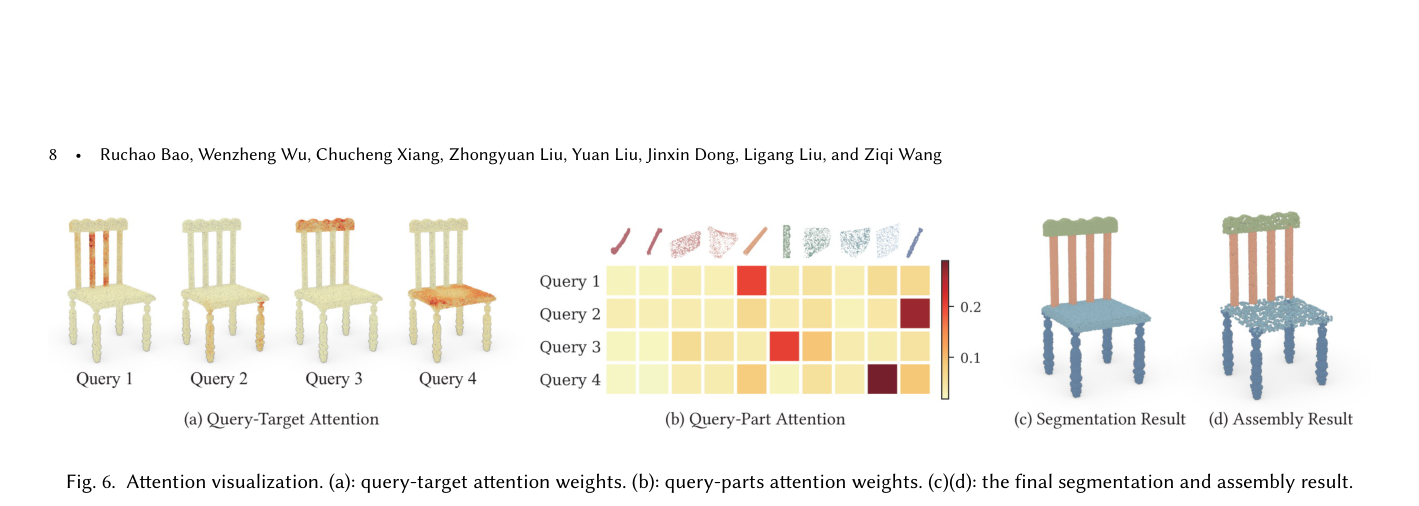
左侧四把浅色椅子上的红斑是 Query 1 到 4 对目标的注意力,分别落在椅背、侧框、座面和另一侧。中间热图行是四个查询、列是候选零件小图,色条约到 0.2。右侧 (c) 分割把椅背、腿、座面着不同颜色,(d) 装配点云与之对应。用它理解查询如何同时对准目标区域和库中零件。
关键机制
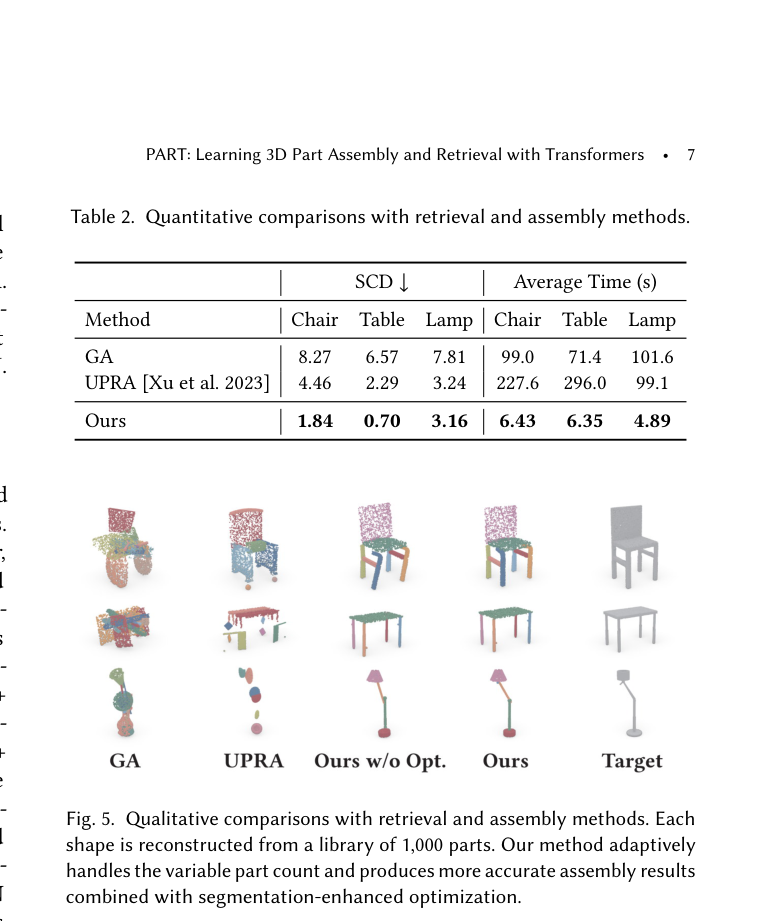
上部 Table 2 给出一千零件库设定:Ours 的 SCD 与平均时间全面低于 GA 与 UPRA。下部五行标签是 GA、UPRA、Ours w/o Opt.、Ours、Target,三行物体为椅、桌、灯。看 GA 的碎块、UPRA 的错位桌面,再看无优化已成形、有优化更贴合灰色目标,用来理解检索加分割增强优化的作用。
核心结论
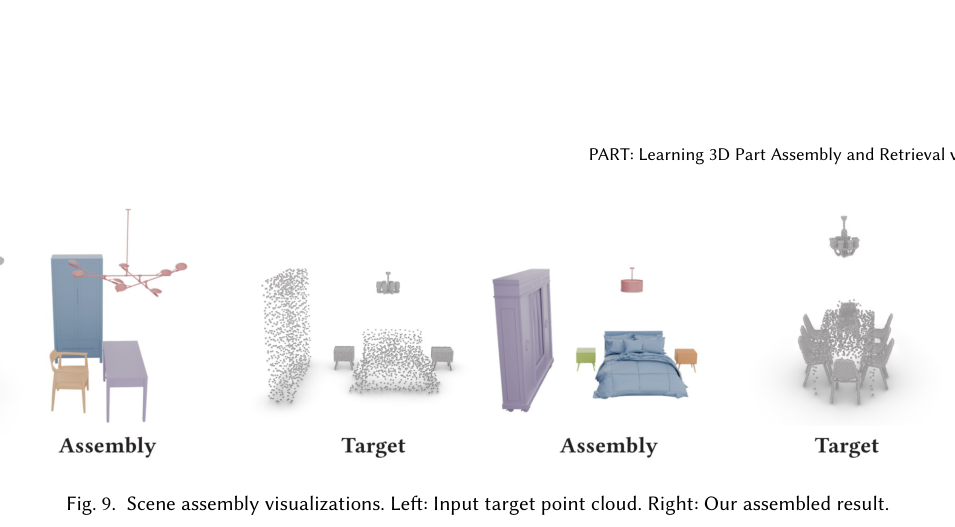
实际是四联图,从左到右标签为 Assembly、Target、Assembly、Target,而不是简单的左目标右结果。第一联是蓝柜、木椅、长桌与枝形吊灯的装配;第二联是卧室点云;第三联是衣柜、双人床与床头柜;第四联是餐桌椅点云。用来展示场景级检索布置,注意右侧被裁切,且方法仍不管碰撞与承重。
实验如何设计?
- PartNet 在 Chair、Table、Lamp 最细粒度分割上评测,过滤二至二十个零件的物体,沿用官方 70%/10%/20% 划分。固定零件装配对比 DGL、RGL、GPAT、ScorePA、3DHPA、SPAFormer、Assembler,指标为 Shape Chamfer Distance、Part Accuracy、Connectivity Accuracy 与 Success Rate;另报 Ours-PN(PointNet++ 且无后处理)以对齐早期骨干(第6–7页,Table 1,Figure 4)。
- 检索加装配设定中,所有方法共用对应类别测试集一千个独特零件的库与一万点目标,对比遗传算法 GA 与在 PartNet 上重训的 UPRA,报告 SCD 与单卡 A800 平均推理时间(第7页,Table 2,Figure 5)。
- 消融在 Chair 上进行,去掉后处理优化、A-Matrix、对称匹配、目标-零件特征融合,或以 Segmentation+PCA 间接恢复位姿,并用 Shape mIoU 衡量分割(第7页,Table 3)。库规模实验在 Chair 测试集随机一百个形状上扫描二十至一千个零件,记录 SCD、时间与显存(第8页,Figure 7)。
- 扩展实验包括 3D-FRONT 场景级家具布置(Figure 9)、Hunyuan3D 单图提升后的点云装配(Figure 10),以及 Redwood RGBD 扫描的零样本泛化,库为从 PartNet 随机抽样的一百个零件(第9页,Figure 11)。
- 自建数据从 PartNet、PartNeXt、3DCoMPaT++、PartVerse-XL 整理逾八万形状,用于更一般的物体检索装配;类别基准用隐藏维三百八十四、约五千一百九十万参数,一般物体与场景用隐藏维七百六十八、约一亿一千三百万参数,八卡 A800 训练(第6页)。
关键结果与论文证据
- 固定零件装配上,完整 PART 在 Chair/Table/Lamp 的 SCD 分别为 1.19/0.72/1.63,PA 为 86.44/84.71/75.74,CA 为 69.90/75.95/58.37,SR 为 49.86/59.96/52.24,全面优于所列基线;无优化的 Ours-PN 能超过早期 DGL/RGL,但对 3DHPA、SPAFormer 不占明显优势,说明后处理拟合目标几何是拉低 SCD 的关键(第6页,Table 1,Figure 4)。
- 一千零件库的检索装配中,PART 的 Chair/Table/Lamp SCD 为 1.84/0.70/3.16,平均时间 6.43/6.35/4.89 秒,低于 GA 的 8.27/6.57/7.81 与近百秒耗时,也低于 UPRA 的 4.46/2.29/3.24 与更长优化时间。定性上 GA 与 UPRA 更碎、更错位,去掉优化后的 PART 已接近目标轮廓,完整优化后更整齐(第7页,Table 2,Figure 5)。
- Chair 消融中,去掉优化后 SCD 从 1.19 升到 3.96、SR 从 49.86 降到 33.65;去掉 A-Matrix 或对称损失同样变差;Segmentation+PCA 的 SCD 5.95、SmIoU 64.96,明显差于联合训练的 77.16,说明装配与分割需要互相强化,而不是先分割再 PCA 对齐(第7页,Table 3)。
- 库规模从二十增到一千时,Chamfer 与推理时间只缓慢上升,一千零件时单形状显存约 3.2GB,仍可用;即使库中没有完美匹配件,模型仍能检索几何相近的替代,但尺度差过大或库中全无相似件时会失败(第8页,Figure 7–8)。
- 场景装配能把柜、椅、床、灯等家具放到与目标点云一致的房间布局中;单图路径先经 Hunyuan3D 得到网格再采样点云;Redwood 扫描上零样本检索 PartNet 零件也能得到可辨认的近似装配(第9页,Figure 9–11)。
- 注意力图显示不同查询分别盯住椅背、腿、座面等局部,并在零件库热图上对几何兼容件给出高峰,最终分割着色与装配网格一致(第8页,Figure 6)。
阅读时需要注意
- 方法不考虑零件之间的连接关系,也不加入碰撞规避、结构稳定性等物理约束,装配结果在几何贴合上成立,并不保证可制造或可插接(第9页)。
- 每个零件只预测刚体六自由度位姿,不建模零件缩放与非刚性变形;当库内零件与目标尺度差过大时会出现失败(第8–9页,Figure 8)。
- 训练采用短库、测试接长库的策略对 Transformer 二次复杂度做了折中,超大库仍会推高显存;注意力可视化与场景实验偏定性,场景级缺少与物体级同等完整的表格对比。
- 图像条件装配依赖外部三维生成模型的几何质量,扫描泛化也受点云噪声与库覆盖限制,不能外推为任意真实产线零件库都已可用。
关联工作
- DETR 把可变长度集合预测做成查询式 Transformer,PART 把同一思想从二维检测迁到零件检索与装配,并用空类抑制未使用查询(第3页)。
- UPRA 用预训练 VAE 加潜空间优化联合检索与装配,但不显式建模零件间与零件-整体关系,输出数量依赖超参数;PART 用查询分类空类来决定长度(第3页)。
- GPAT 证明分割能帮助未见零件装配,但仍假设零件集合预先给定;PART 把分割、检索、装配放进同一套查询(第3页)。
- SPAFormer、RGL 等利用输入顺序或图消息传递提升固定集合装配;Assembler、Rectified Point Flow、GARF 用扩散或流匹配间接预测位姿。PART 强调库检索与一次前向并行,而不是只在给定零件上迭代(第2–3页)。
- Point Transformer v3 提供点云骨干;A-Matrix 旋转参数化来自连续旋转回归文献,用来避免四元数直接回归的奇异与次优(第4页)。