快速导读:RGS 用 VGGT 跨视角几何先验约束反光表面,再用反射引导加密把高斯放到真正贡献高光的区域,提升反光物体的新视角合成。
高斯溅射把新视角做成可实时的显式渲染,但强反光会破坏跨视角一致:高光随相机移动,表面容易被拟合出坑,镜面映射也就错。University of Technology Sydney、Adelaide University 与李想汽车的 RGS(Reflection-aware Gaussian Splatting)把问题收成三块:延迟渲染里用物理着色先得到粗几何;用三维基础模型 VGGT 的跨视角伪深度把反光区表面拉连续;再用反射引导加密,让真正贡献高光的高斯更容易分裂。项目页 https://xiaobiaodu.github.io/reflectivegs/。
表示采用 2DGS,属性含位置、颜色、不透明度、法向和粗糙度,延迟光栅化出漫反射、粗糙度、法向、深度,并用可学习 HDR 做微面 BRDF 积分。因为 VGGT 不是度量深度,深度监督用 Pearson 相关而不是绝对误差。实验覆盖 Shiny Blender、Glossy Synthetic、Ref-NeRF Real 与 NeRF Synthetic 共 23 个场景,Table I–V 显示新视角、法向和参数量同时优于 3DGS-DR、EnvGS、Ref-Gaussian 等对照。
英文题目:RGS: Reflection-aware Gaussian Splatting via Learning Geometry Continuity for Reflective Objects
论文出处:arXiv 每日论文精选 · arXiv:2609.19421
原始论文:PDF / 论文页面
这篇论文解决什么问题?
反光新视角难,是因为观测本身不一致。同一块镀铬在不同视角亮斑位置不同,多视图立体容易把亮斑当成几何凹凸。3DGS-DR 把环境效果延迟映到表面,作者观察到它在反光区过拟合高光,法向塌陷,新视角镜面发糊。
想用现成几何先验去补,也不容易。DSINE 的法向、Depth Pro 的深度在高反光上会失败,Figure 1(a)(b) 把它们标成 inconsistent / non-metric。错误几何无法给高斯正确的镜面映射。Depth Anything 在引言里同样被列为在高反光区失效的基础模型。
体积方法如 Ref-NeRF、Ref-NeuS 能建模环境光,但强镜面仍然吃力,而且射线采样慢。高斯路线要的是:表面别掏空,高光别烤进漫反射,还尽可能保持实时。
因此需要两件同时成立的事:跨视角几何约束要能用在非度量先验上;加密要对准高光相关原语,而不是整场景均匀加密。
核心创新
- 反射感知高斯溅射:物理延迟渲染加 BRDF,针对反光物体新视角。
- 跨视角形状一致正则:用 VGGT 伪深度和相关损失,减轻反光区几何掏空。
- 反射引导加密:多视图从高光框顶点追光线,加密真正贡献镜面的高斯。
方法概览
以 2DGS 为表示,延迟渲染出漫反射、粗糙度、法向、深度,并用可学习 HDR 做微面 BRDF 镜面积分。VGGT 对训练视图估伪深度,因非度量而用 Pearson 相关约束渲染深度;在粗糙度低于分位阈值的区域对法向做全变差平滑,并约束残差法向。反射引导加密:由粗糙度得到高光强度图,从各视图高光框顶点发射光线,平面相交定位贡献镜面的高斯,将其加密阈值减半。总损失为颜色、深度相关、法向 TV 与残差法向项。
- 表示与延迟着色:沿射线混合 2DGS,得到漫反射颜色 C 与深度 D,并渲染法向 N 与粗糙度 R。最终颜色是漫反射加上着色器作用在反射方向上的镜面特征;镜面用微面 BRDF 对环境入射积分。残差法向 Δn 被 L2 拉小,让主法向自己收敛。
- 颜色损失与 3DGS 相同,是 L1 与 DSSIM 的加权。几何项包括深度 Pearson 损失、高光区法向全变差,以及残差法向正则。总损失 L = λrgb Lrgb + λdepth Ldepth + λnormal Lnormal + λΔn LΔn,权重分别为 1、1e-3、1e-2、1e-3。
- 跨视角形状正则:VGGT 吃所有训练视图,输出伪深度 D′。因尺度不定,用 1−Corr(D′, D) 约束渲染深度。作者认为多视图相关性能在细粒度上修几何,减轻空洞。
- 反射引导法向正则:用粗糙度分位 p=0.9 得到高光掩码 β,只在这些像素上对法向做 TV,避免把整幅图抹平。
- 反射引导加密:先从粗糙度提高光强度并取二维框;不从框内所有像素发射光线,只从框顶点按相机参数发射,降低计算。不同视图的平面相交得到三维区域,落在其中的高斯把加密阈值减半。算法 1 总结了该过程。另采用 MVGS 的多视图训练以加强约束。其余超参跟随 3DGS-DR。硬件为 RTX 3090 Ti。
逐图理解论文
失败直觉
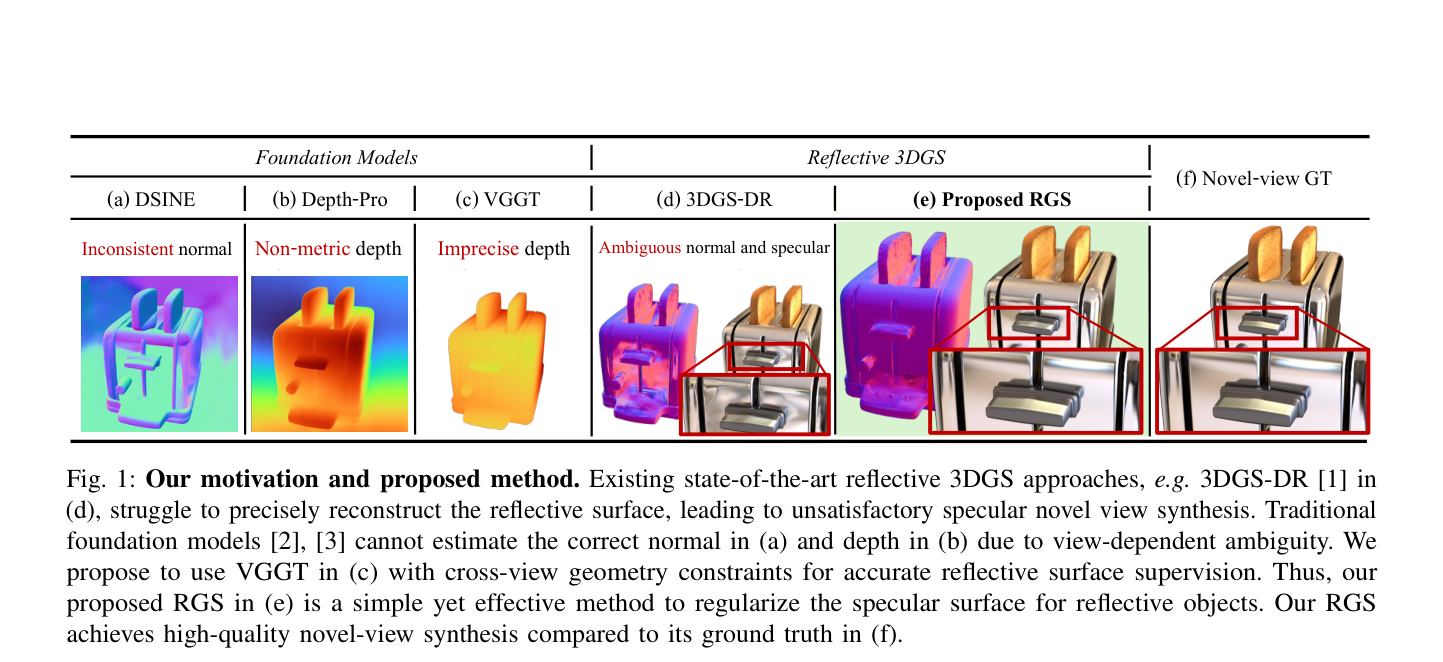
六格从左到右是 DSINE 法向、Depth-Pro 深度、VGGT 深度、3DGS-DR、Proposed RGS、Novel-view GT,物体是带把手的镀铬烤面包机。红字标签写 Inconsistent normal、Non-metric depth、Imprecise depth、Ambiguous normal and specular。请同时看题注:作者仍把 VGGT 当作可用的跨视角先验,面板 (c) 的 Imprecise depth 说明它不是度量真值。(e) 与 (f) 的红框对把手高光。不要从这张图读 PSNR。
研究缺口
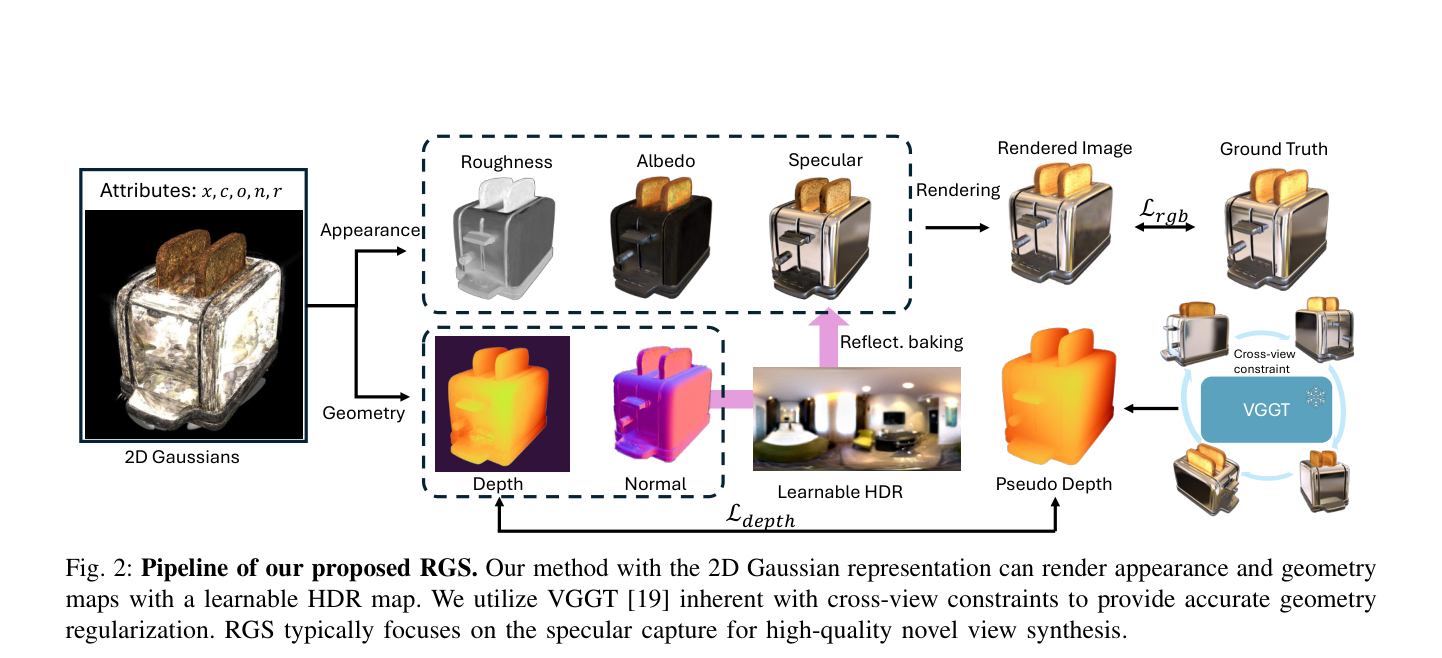
左列 2D Gaussians 烤面包机,属性 x,c,o,n,r。上分支 Appearance 出 Roughness / Albedo / Specular,再 Rendering 与 GT 做 Lrgb。下分支 Geometry 出 Depth / Normal,Learnable HDR 经 Reflect. baking 接到高光。右侧 VGGT 从多视图得到 Pseudo Depth,与渲染深度做 Ldepth,并画了 Cross-view constraint。按外观、几何、HDR、VGGT 的顺序读。
关键机制
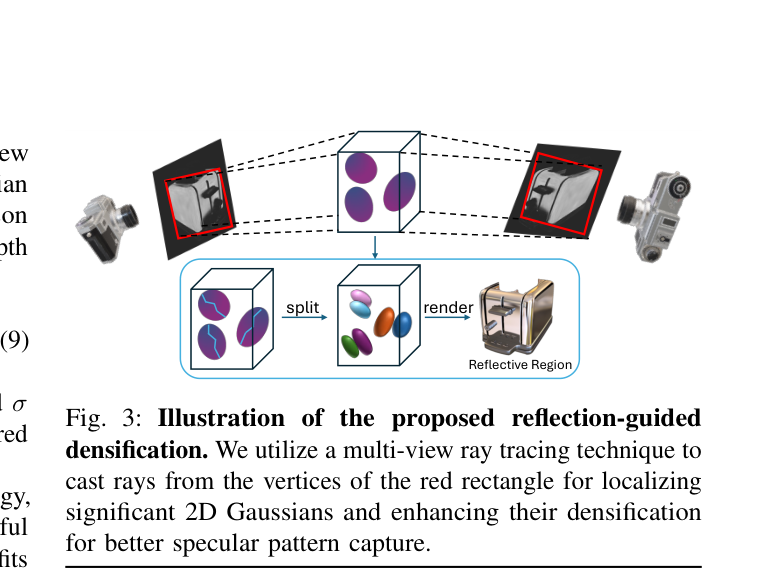
左右相机对着高光物体,图像上有红框。虚线交到中间立方体里的紫色高斯团,再 split 成更多椭球、render 出 Reflective Region。左侧露出公式 (9) 残片,那是 Pearson 深度损失,不是加密公式。要点是只从红框顶点发射光线来定位该加密的高斯。
核心结论
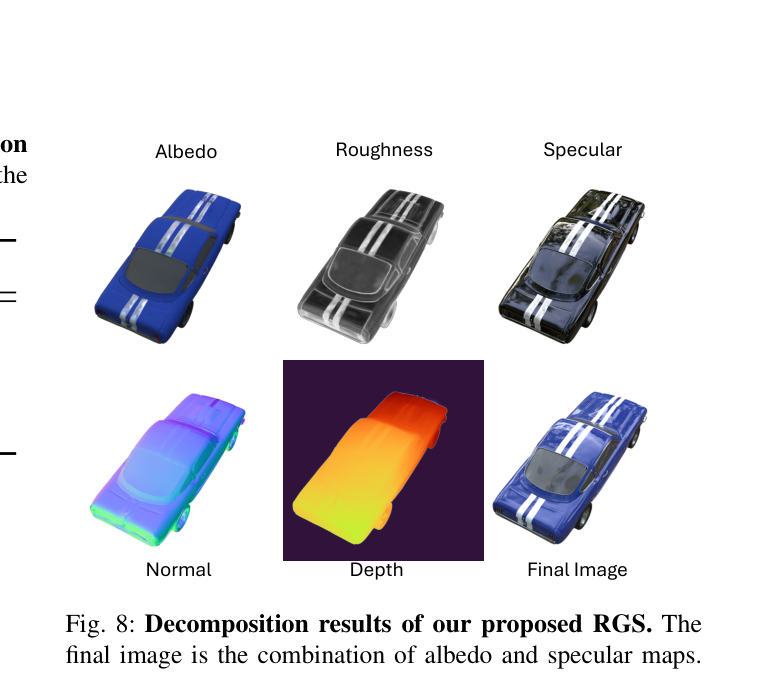
蓝色双条纹轿车的分解:Albedo、Roughness、Specular 在上,Normal、Depth、Final Image 在下。题注说最终图是漫反射加高光。深度是橙黄色伪彩,没有色标刻度。左侧有正文残字,可忽略。用这张图说明几何正则之后材质才能分开,而不是报 Table I。
实验如何设计?
- 数据:反光与普通物体共 23 场景,含 Shiny Blender、Glossy Synthetic、Ref-NeRF Real、NeRF Synthetic。指标 PSNR、SSIM、LPIPS;法向另报 MAE。
- Table I 对照包括 Ref-NeRF、NPC、3DGS、3iGS、GaussianShader、ENVIDR、Spec-Gaussian、3DGS-DR、EnvGS、Ref-GS、Ref-Gaussian。
- Table II 看 NeRF Synthetic 泛化;Table III 看法向;Table IV 看参数量、训练时间和 FPS。
- 消融以接入延迟渲染的 2DGS 为基线,再加 CSCR 与 RD。Figure 9 另比较去掉 VGGT 深度辅助。定性图含合成反光物体近景和 Ref-NeRF Real。
关键结果与论文证据
- Table I(第 6 页):RGS 三套反光数据均为最优。Glossy Synthetic 31.24/0.965/0.043,Shiny Blender 35.38/0.976/0.050,Ref-NeRF-Real 24.31/0.670/0.257。最接近的对照多是 Ref-GS / Ref-Gaussian / 3DGS-DR。
- Table II:NeRF Synthetic 上 PSNR 33.51、LPIPS 0.028,说明几何正则没有把普通物体打崩。Table III:法向 MAE 2.04,低于 3DGS-DR 的 2.62 与 EnvGS 的 2.66。
- Table IV:参数 0.1M 远小于 3DGS 的 3.3M 和 EnvGS 的 2.9M;训练 3h 与 EnvGS 相同、长于 3DGS 的 0.6h;FPS 146,介于 3DGS 的 604 与 3DGS-DR 的 71 之间,仍实时。
- Table V(第 7 页):基线 33.29 PSNR / 1.4M;只加 CSCR 到 34.54 且参数降到 0.4M;只加 RD 到 34.63 / 0.2M;两项都上到 35.38 / 0.1M / 146 FPS。作者把参数变少解释为多视图约束让高斯更紧凑。
- Figure 4:铃铛、头盔、轿车、服务铃上,Ours 的高光边缘更接近 GT,3DGS-DR 与 GaussianShader 常糊或错位。Figure 8:蓝色双条纹轿车被拆成漫反射、粗糙度、高光、法向、深度,最终图是漫反射加高光。Figure 9 单例 28.94→29.41 只说明 VGGT 有帮助,不是全数据均值。
阅读时需要注意
- 伪深度没有度量尺度,监督只能是相关而不能是绝对深度。
- 若 VGGT 在某类反光上仍不准,CSCR 会把错误几何灌进高斯;图 1(c) 本身仍标注 Imprecise depth。
- 训练 3 小时、FPS 低于原生 3DGS;加密阈值减半是经验选择。
- 评测以物体中心反光场景为主,论文未单列 Limitations,也没有系统的失败案例表。
关联工作
- 3DGS-DR 是最直接的延迟反射对照,RGS 认为它的塌几何限制了环境贴图学习。
- VGGT 提供跨视角深度;DSINE / Depth Pro 则被用来展示错误先验。
- Ref-NeRF、GaussianShader、GS-IR、NeRO 是反光与逆渲染谱系;RGS 走显式高斯加几何正则。
- MVGS 贡献多视图训练/加密;RGS 把加密条件改成高光框顶点光线。
- Ref-Gaussian、EnvGS、Ref-GS 是 Table I 里最接近的近期高斯反光方法。