SAM-V:把多视图几何注进 SAM,跨视角分出同一个物体
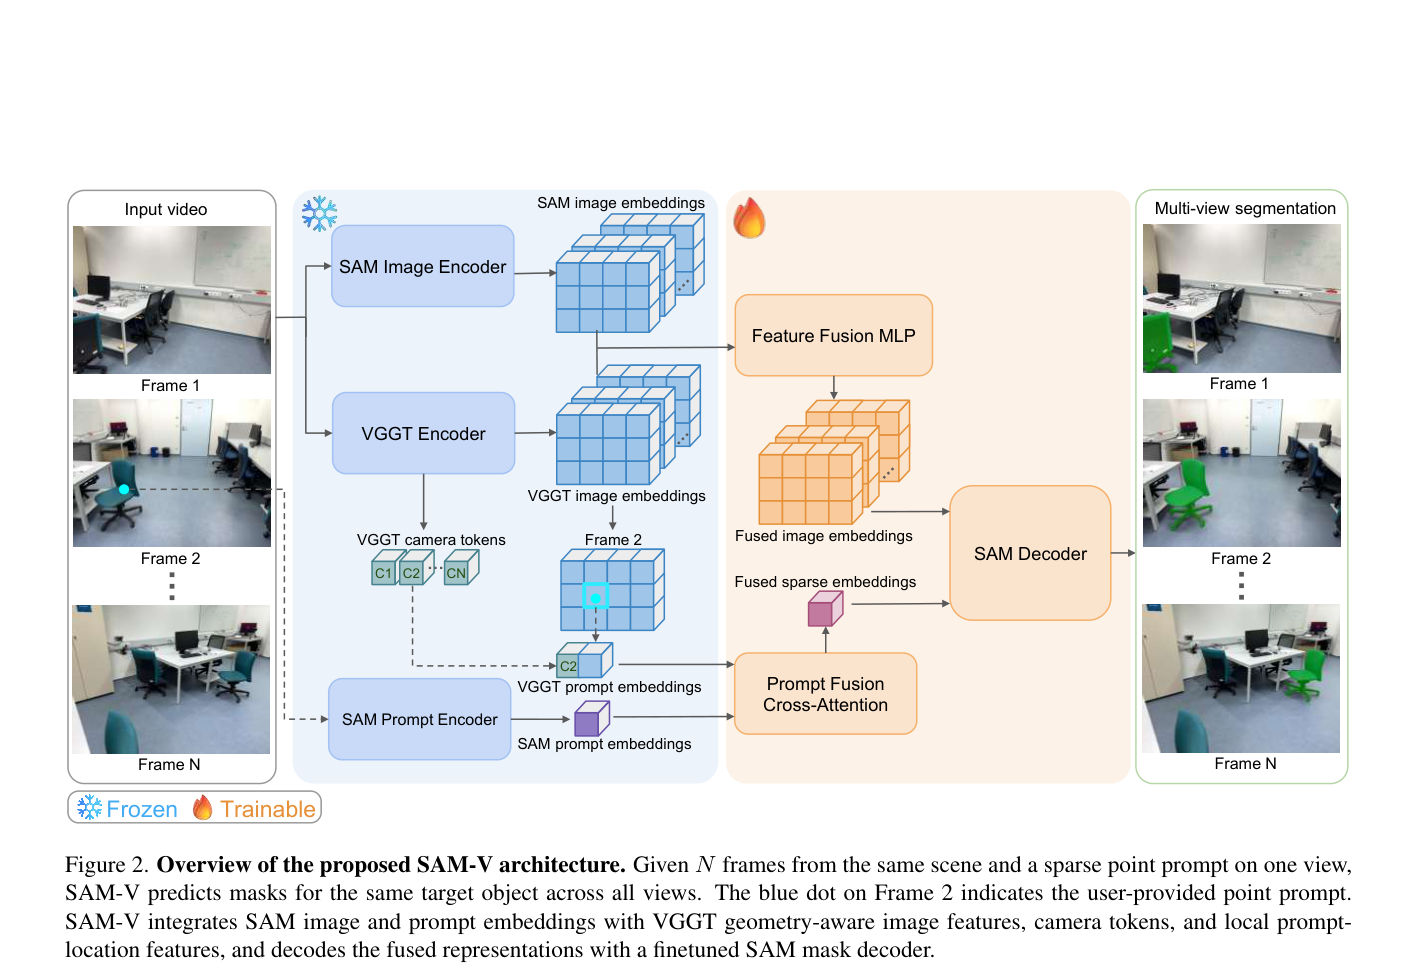
SAM-V 在掩码解码前融合冻结的 SAM 与 VGGT,并用相机 token 和提示位置的局部特征锚定稀疏点,从而一次前向预测跨视图的同一实例。
SAM-V 在掩码解码前融合冻结的 SAM 与 VGGT,并用相机 token 和提示位置的局部特征锚定稀疏点,从而一次前向预测跨视图的同一实例。
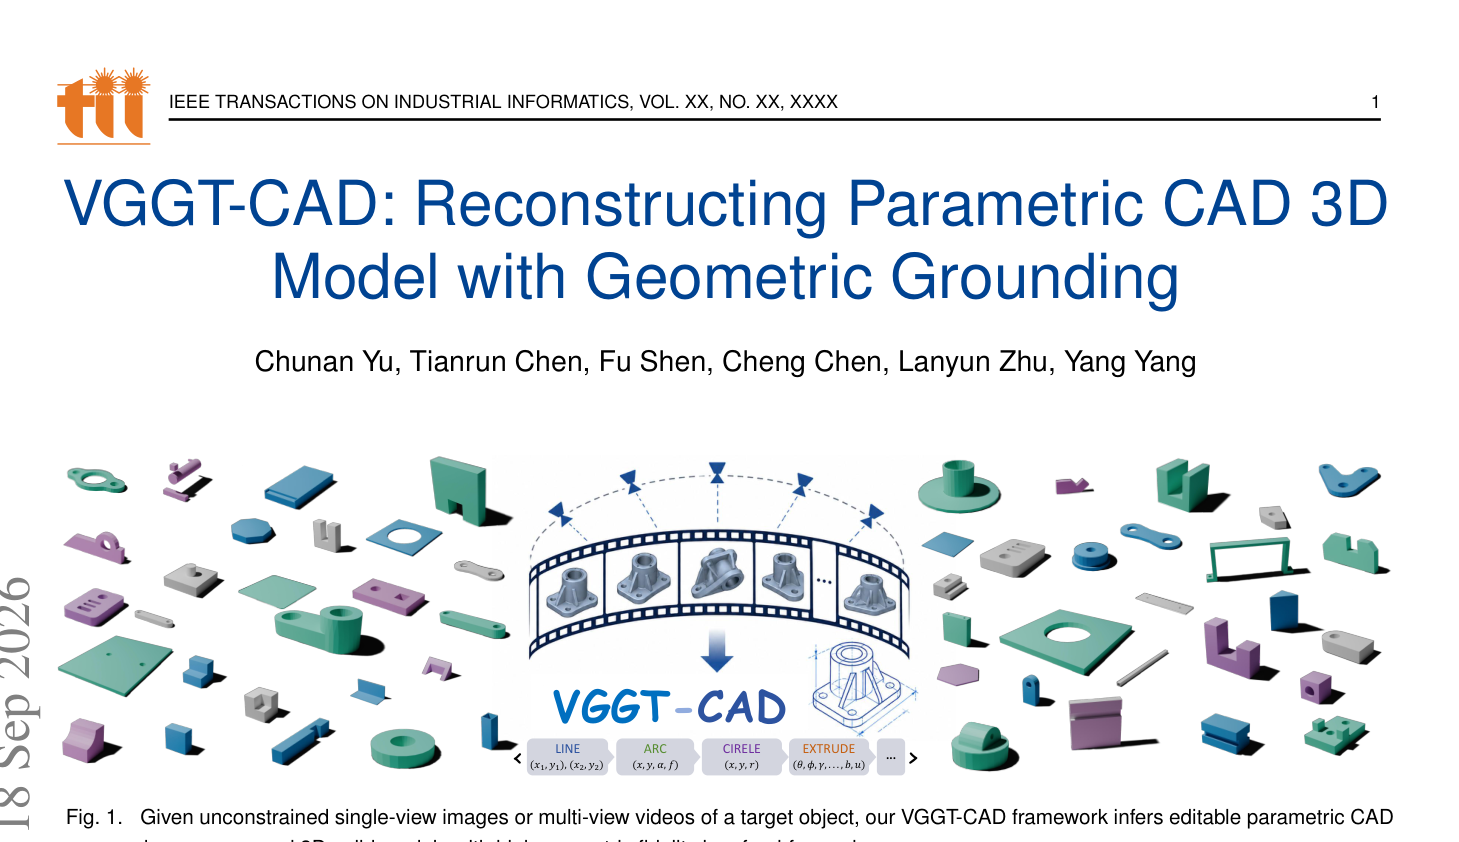
VGGT-CAD 把预训练 VGGT 几何先验与相机条件编码迁到参数化 CAD 序列预测,用可变视角聚合和非自回归解码,并发布 VideoCAD 基准。
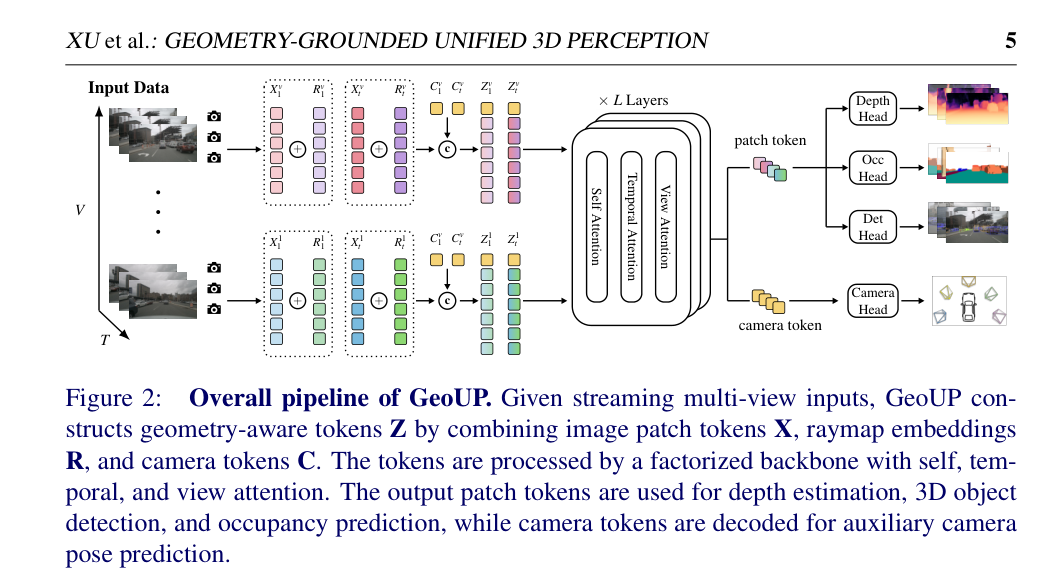
GeoUP将VGGT的重建导向潜在表示适配到标定流式多相机驾驶场景,通过时序-视角注意力分解与raymap注入,以单一架构支持深度估计、3D检测与语义占用预测。
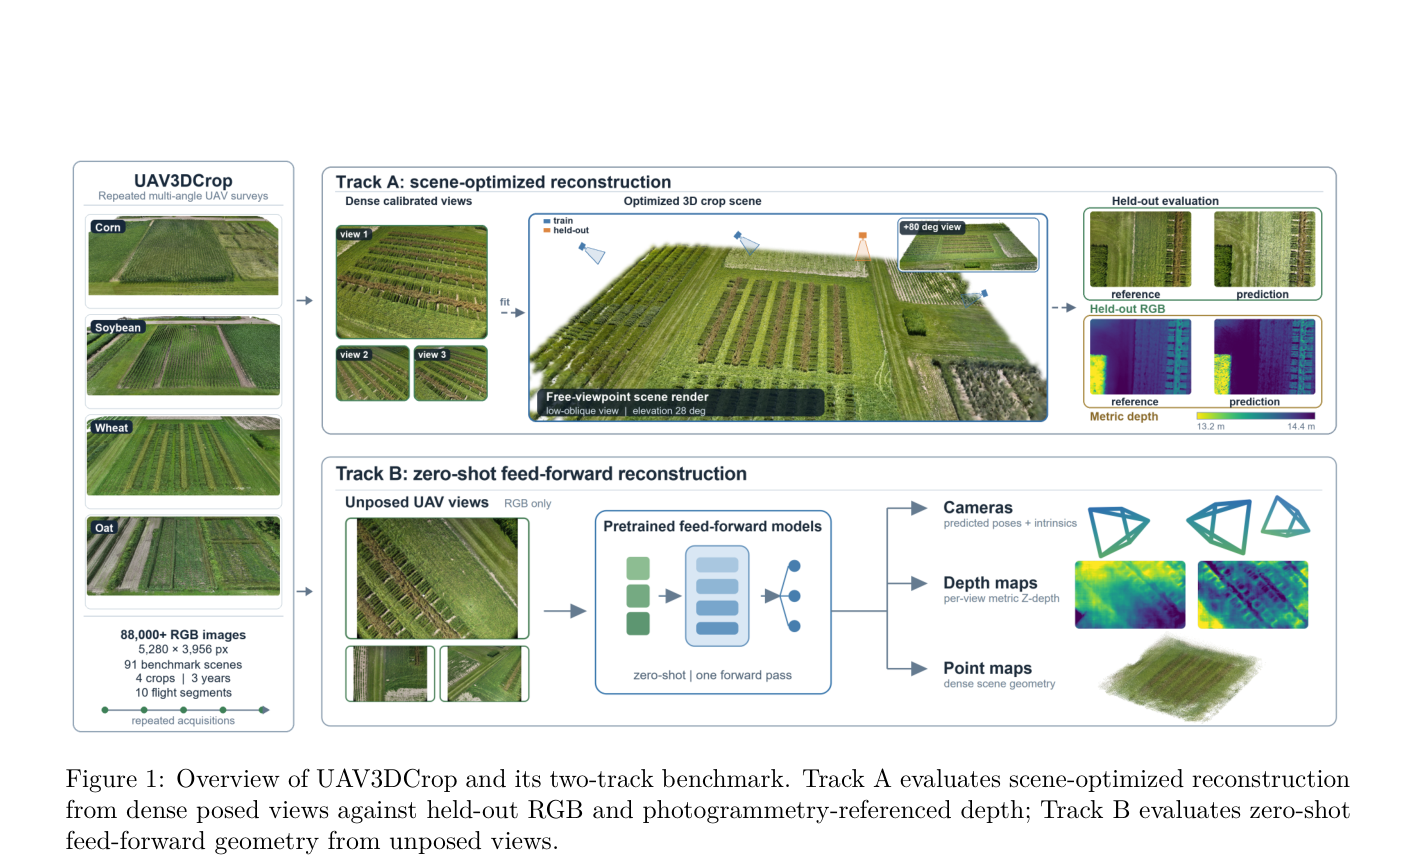
现有的三维重建基准,要么是ETH3D这样的通用场景,要么是室内盆栽的作物数据集,没有一个把田间尺度的多角度重建和农艺实测指标挂起钩来。更关键的是,最近火热的零样本前馈模型——比如DUSt3R和VGGT——号称能从几张图直接预测三维结构,但它们飞到玉米地上空还能不能行,从来没人认真检验过。UAV3DCrop为此设计了两条赛道:赛道A让NeRF和3DGS方法在已知位姿下逐场景优化,赛道B让前馈模型在完全零样本的条件下直接预测位姿和几何。
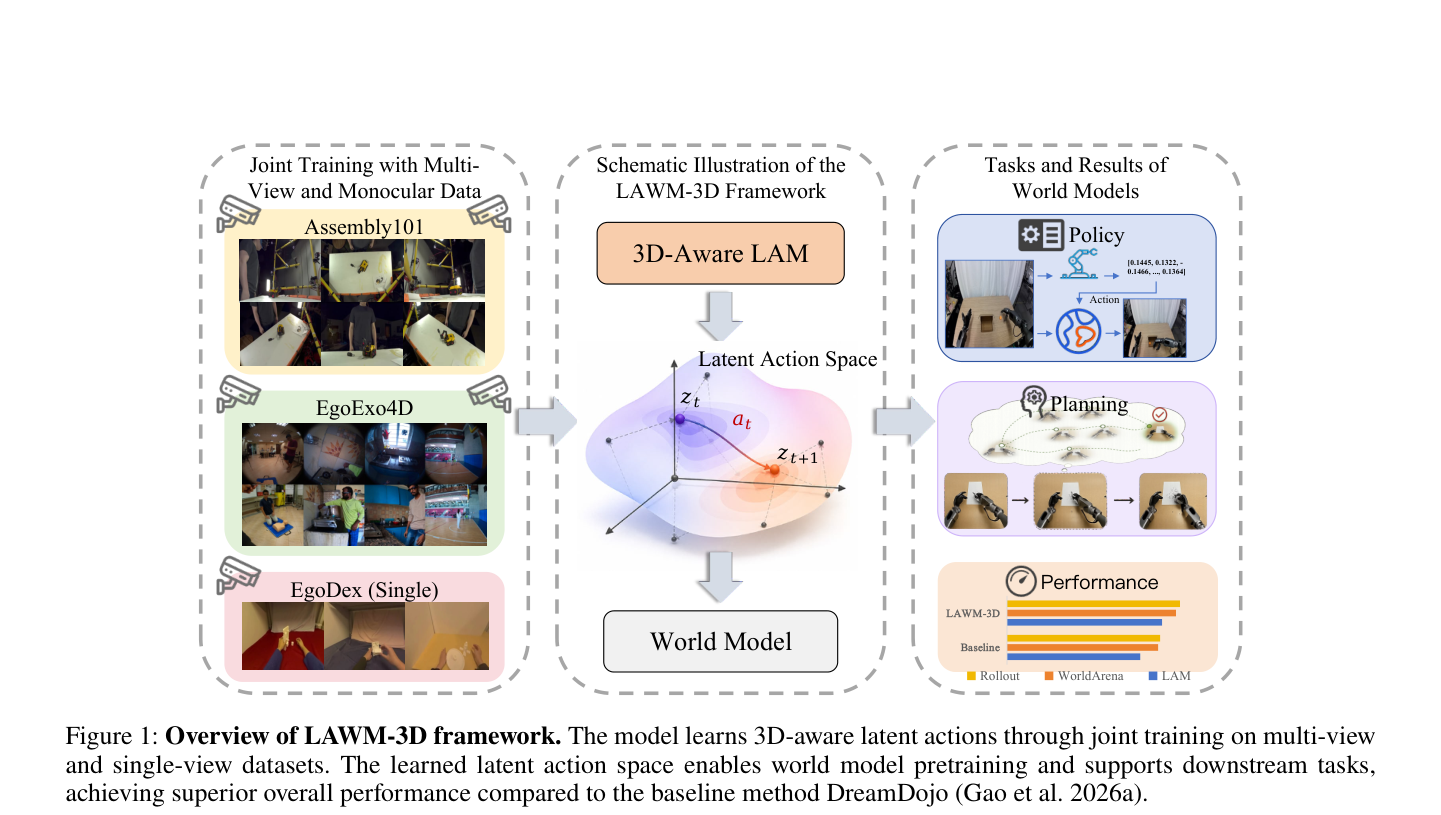
提出LAWM-3D框架,通过多视角联合训练、非单射RGB-D重建和几何特征对齐,从无标签人类视频中学习视角不变的3D感知潜在动作,显著提升世界模型的生成质量、物理一致性和泛化能力。