快速导读:PhysReflect 在深度条件 BrushNet 修补骨干上,训练时把预测干净潜变量解回像素,用极线对应、TwinTrack 边界投影、DINOv2 语义和低阶球谐光照做镜面监督,推理图保持不变。
扩散模型已经能画出清晰的房间和物体,镜子却经常不像一面镜子。镜中内容会偏到错误的位置、朝向拧掉、比例失衡,或者轮廓变形。哈尔滨工业大学的 PhysReflect 把镜面反射生成写成深度条件的图像修补,但把新增监督放在训练时解码出来的像素上:几何损失检查反射是否落在镜面几何给出的位置,感知损失检查身份、外观和低频光照是否还连贯。推理仍使用原来的 BrushNet 输入和采样,不另加测试时模块。
论文在合成基准 MirrorBenchV2 的单物体与多物体划分,以及真实数据 MSD 上,与 BrushNet-FT、MirrorFusion、MirrorVerse 比较。几何类指标和光照误差的提升大于普通重建指标,用户研究里物理可信度的偏好也更集中。CLIP 文本对齐并不总是最高,说明“像不像提示句”不能代替反射是否摆对。预印本,abs 页未见独立代码链接。
英文题目:PhysReflect: Geometry and Perception Guided Diffusion for Physically-Plausible Mirror Reflections
论文出处:arXiv 每日论文精选 · arXiv:2609.23442
原始论文:PDF / 论文页面
这篇论文解决什么问题?
镜面反射同时卡住几何和外观。虚像必须出现在镜面法向和距离决定的位置,轮廓要跟镜外物体的投影对齐,身份和纹理不能换成别的物体,光照还要和周围场景处于同一套低频照明里。Fig. 1 上半用 Stable Diffusion 3.5、Flux、Gemini 3.1 和 GPT-5 展示四类失败:位置偏移、方向错位、比例失衡和目标扭曲。下半用绿色掩码标出几何上正确的镜内位置,商业模型和修补基线的轮廓经常离开这片区域。
MirrorFusion 把任务定义成条件修补,用镜外深度做条件;MirrorVerse 进一步扩大合成数据,并按单物体、多物体、真实场景做课程。它们的共同缺口是:深度和掩码只作为输入提示,标准潜空间去噪并不在像素上检查源点与反射点是否满足极线,也不检查生成轮廓是否贴住投影边界。身份和光照同样只是从配对样本里间接学到。
因此缺口不是再换一个更大的去噪器,而是在解码图像上写出可微的镜面约束,同时不把这些辅助网络带进推理。真实镜子还有估计深度和估计内参,监督必须能在噪声大的时间步上减弱,否则错误的像素测量会反过来伤害生成。
核心创新
- 把镜面物理约束从潜空间去噪挪到解码图像上的可微几何与感知损失,推理计算图不变。
- 用极线软对应加上 TwinTrack 门控的边界投影对齐,分别约束稀疏对应和反射轮廓。
- 用镜内/全局 DINOv2 与几何感知的低阶球谐光照正则保住身份和光照,并按噪声水平退火。
方法概览
训练时由预测干净潜变量 ẑ0 解码 X̂0=D(ẑ0),在像素上加 Geometric Loss 与 Perceptual Loss,并以时间步权重 w(t) 做退火,压低高噪声步。几何项含稀疏极线对称和稠密边界投影:镜面由相机系单位法向 n 与有符号距离 d 定义,虚点 p_virt=p-2(n^T p+d)n,极线关系 p̃_in^T F p̃_out=0,F=K^{-T}[n]_×K^{-1}。镜外采样点用 DINOv2 ViT-S/14 在极线带内做温度 τ=0.05 的软期望匹配,损失混合点到线距离与反射方向余弦。边界项把镜外物体掩码按深度和内参抬到三维、按镜面反射再投影,得到目标轮廓 B_proj;TwinTrack 把真值图与解码图当成两帧,冻结 SAM2 传播轮廓得到分离掩码,只用来门控解码图的 Sobel 边缘,边界损失是 BCE 加 Soft-Dice。感知项用镜内与全图 DINOv2 做语义一致,并用冻结 Lotus 估计深度与法向,拟合镜区二阶球谐作为低频光照描述,而不是镜面反射率模型。总损失为噪声预测 MSE 加上 w(t) 加权的几何与感知项。推理仍是原来的 BrushNet 输入和采样,不引入额外开销。
- 骨干沿用深度条件 BrushNet。输入是加噪潜变量、掩码图、镜面掩码、镜外深度和文本。Generation Net 预测干净潜变量,Conditioning Net 经零卷积注入多尺度条件。训练时用预训练 VAE 解码得到 X̂0,几何与感知损失都作用在这张图或由其导出的结构上。
- 镜面在相机坐标里写成 n^T p+d=0。镜外点的虚像是 p_virt=p-2(n^T p+d)n。齐次像素坐标下,镜外点与镜内点满足极线 p̃_in^T F p̃_out=0,其中 F=K^{-T}[n]_×K^{-1}。距离 d 不出现在极线里,因为极线只依赖法向;度量投影构造目标边界时仍然使用 d。
- 极线项在镜外采样点,用冻结 DINOv2 ViT-S/14 的局部特征,在镜内极线带候选点上做软匹配。温度 τ=0.05,匹配位置是候选点的软期望,梯度经冻结特征回到解码图。分离的置信度和互检滤掉不可靠匹配,保留匹配太少就跳过该项。损失把归一化点到线距离和相对法向消失点的方向余弦罚项按置信度加权。
- 边界项补上极线管不到的轮廓范围。镜外物体掩码用深度和内参抬到三维,按反射公式再投影,软膨胀后取出目标轮廓 B_proj。直接分割生成中的镜内物体不可靠,因为训练早期会漂移和缺块。TwinTrack 把真值图 X0 与 X̂0 当成两帧伪视频,冻结 SAM2 把真值轮廓传到预测帧,得到分离掩码。该掩码只决定在哪里计算损失:Sobel 边缘来自解码图本身,边界损失是局部 BCE 加稀疏轮廓的 Soft-Dice。
- 感知损失不追求像素级复制。语义项比较镜内 DINOv2 补丁特征,另有全图项做场景级正则。光照项用冻结 Lotus 从解码图估计深度和法向,深度法向项约束局部结构,二阶球谐在镜区内拟合低频光照。球谐是照明描述,不是镜面材质模型。
- 总损失是标准噪声预测 MSE,加上时间步权重 w(t) 乘几何项与感知项。w(t) 下调高噪声步、强调低噪声步,因为高噪声解码不稳定,匹配、边缘、语义和光照估计都不可靠。训练日程跟随 MirrorVerse 的三阶段。辅助估计器、匹配器和缓存目标只在训练使用;推理输入与采样程序不变。
逐图理解论文
失败直觉
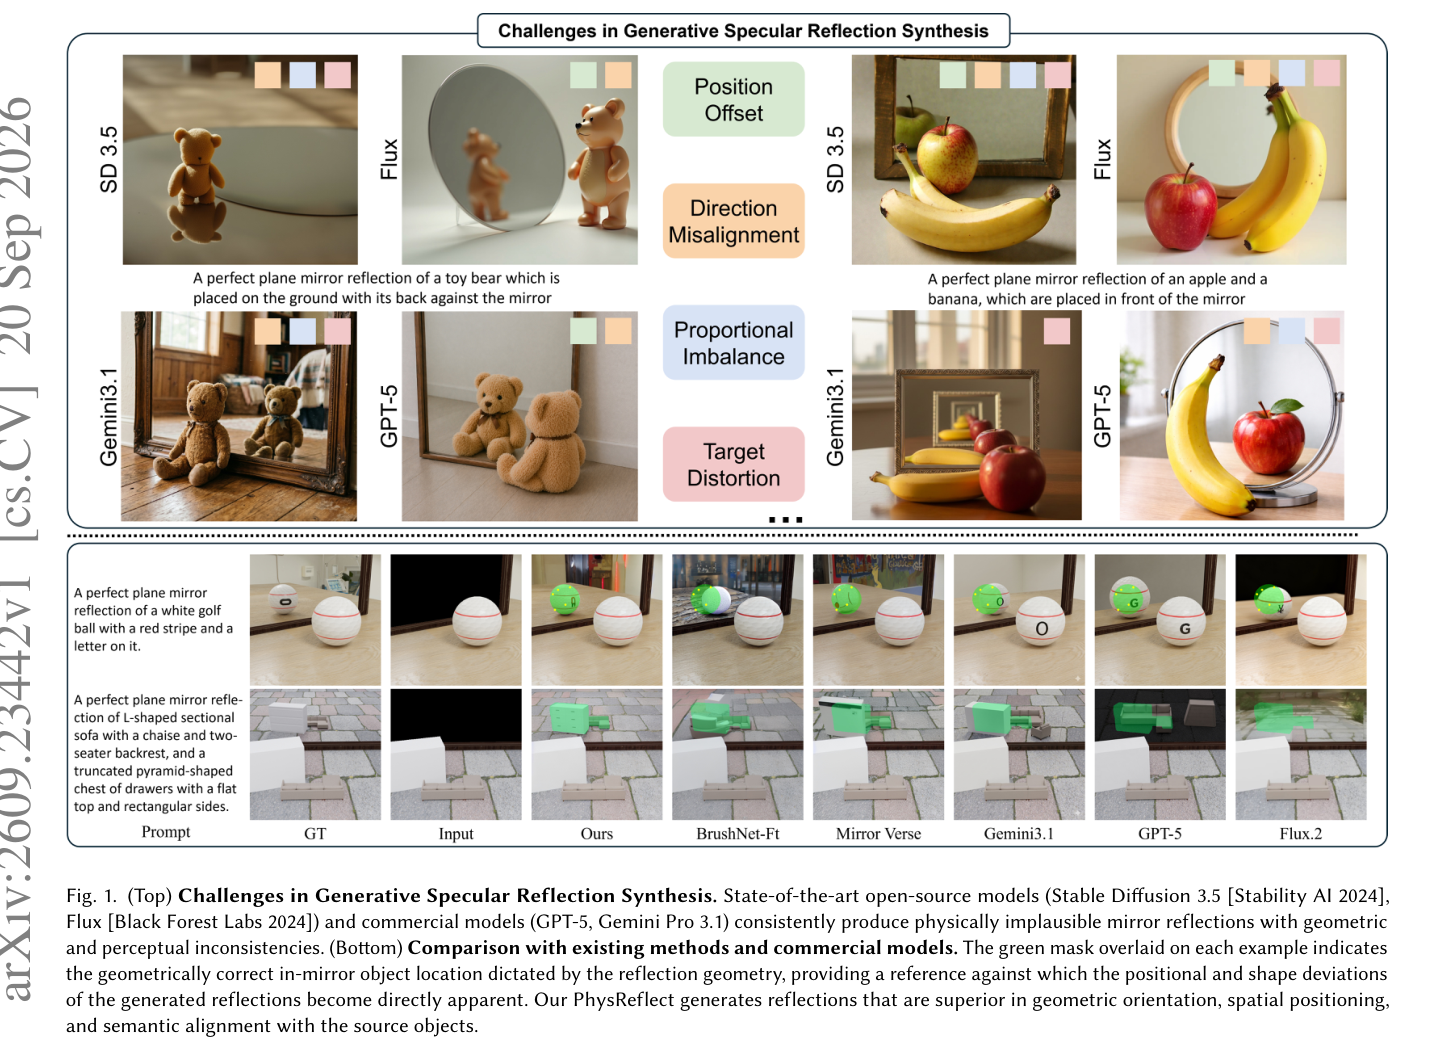
上半标题是生成式镜面反射的挑战,四格标注位置偏移、方向错位、比例失衡和目标扭曲,模型名为 SD 3.5、Flux、Gemini 3.1 和 GPT-5,例子是玩具熊以及苹果香蕉。下半是高尔夫球和家具的对照,列依次为 Prompt、GT、Input、Ours、BrushNet-Ft、Mirror Verse、Gemini 3.1、GPT-5、Flux.2。绿色遮罩是几何正确的镜内位置,用来看生成轮廓偏了多少,不是检测分数。
方法贡献
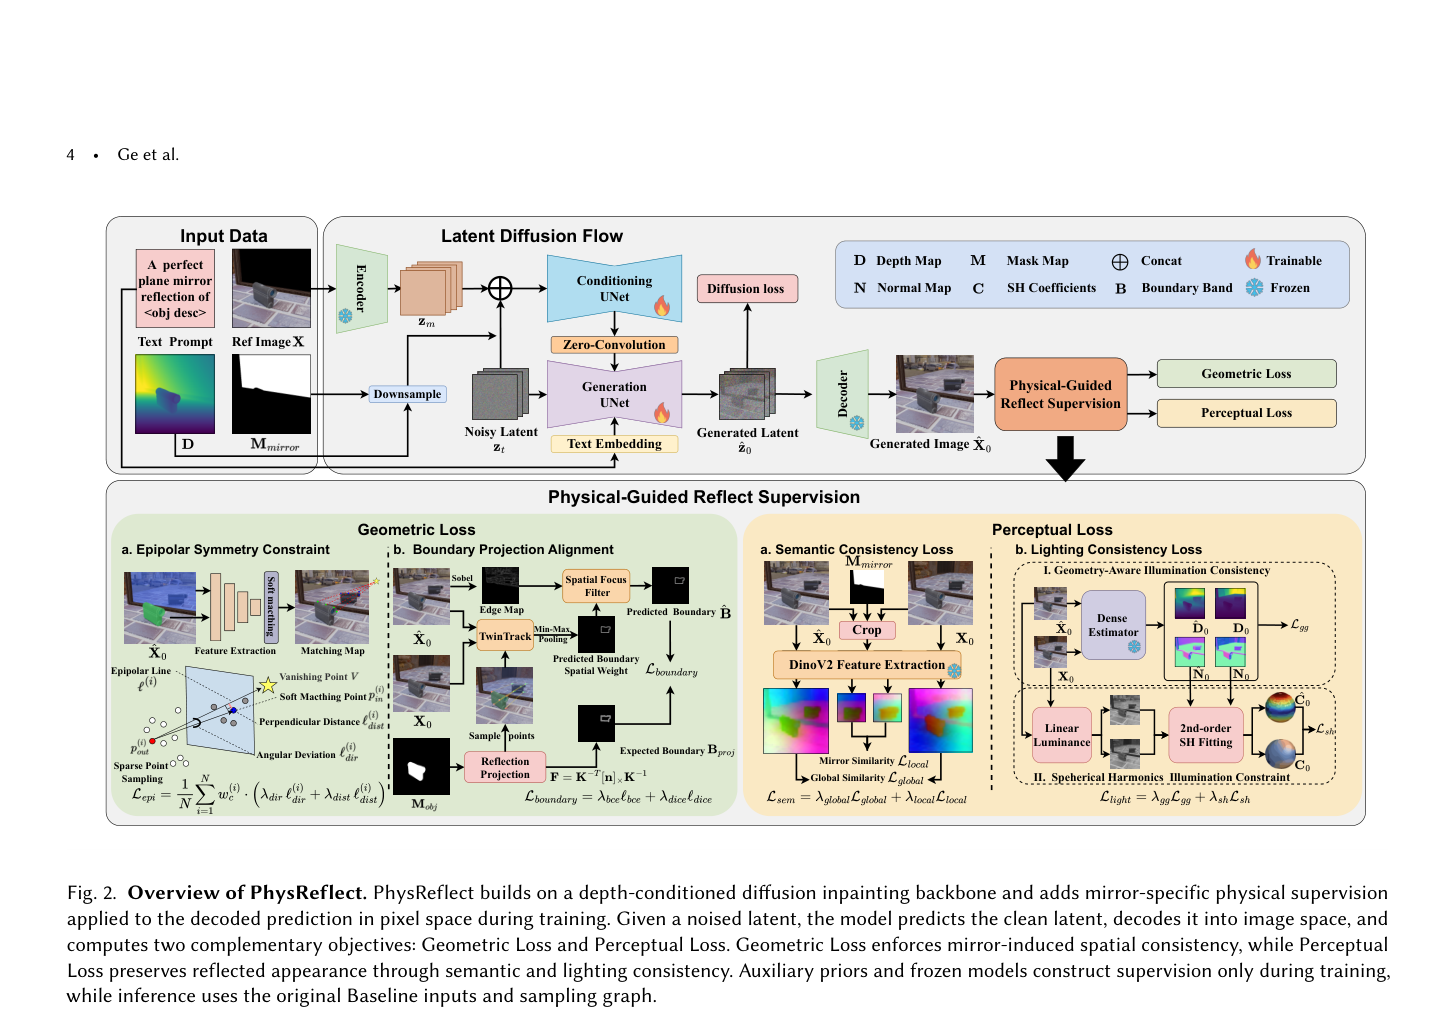
这张是方法总览,适合作为特色图。上排从左到右是文本、参考图、镜外深度和镜面掩码,经可训练的条件 UNet 与零卷积进入加噪潜变量,生成 UNet 预测潜变量后由解码器得到图像,再分成几何损失和感知损失。下排左侧是极线软匹配和 TwinTrack 边界投影,右侧是 DINOv2 的镜内/全局语义,以及 Lotus 深度法向和二阶球谐光照。图例里火焰是可训练、雪花是冻结。推理不走下排这些辅助分支。
对照结果
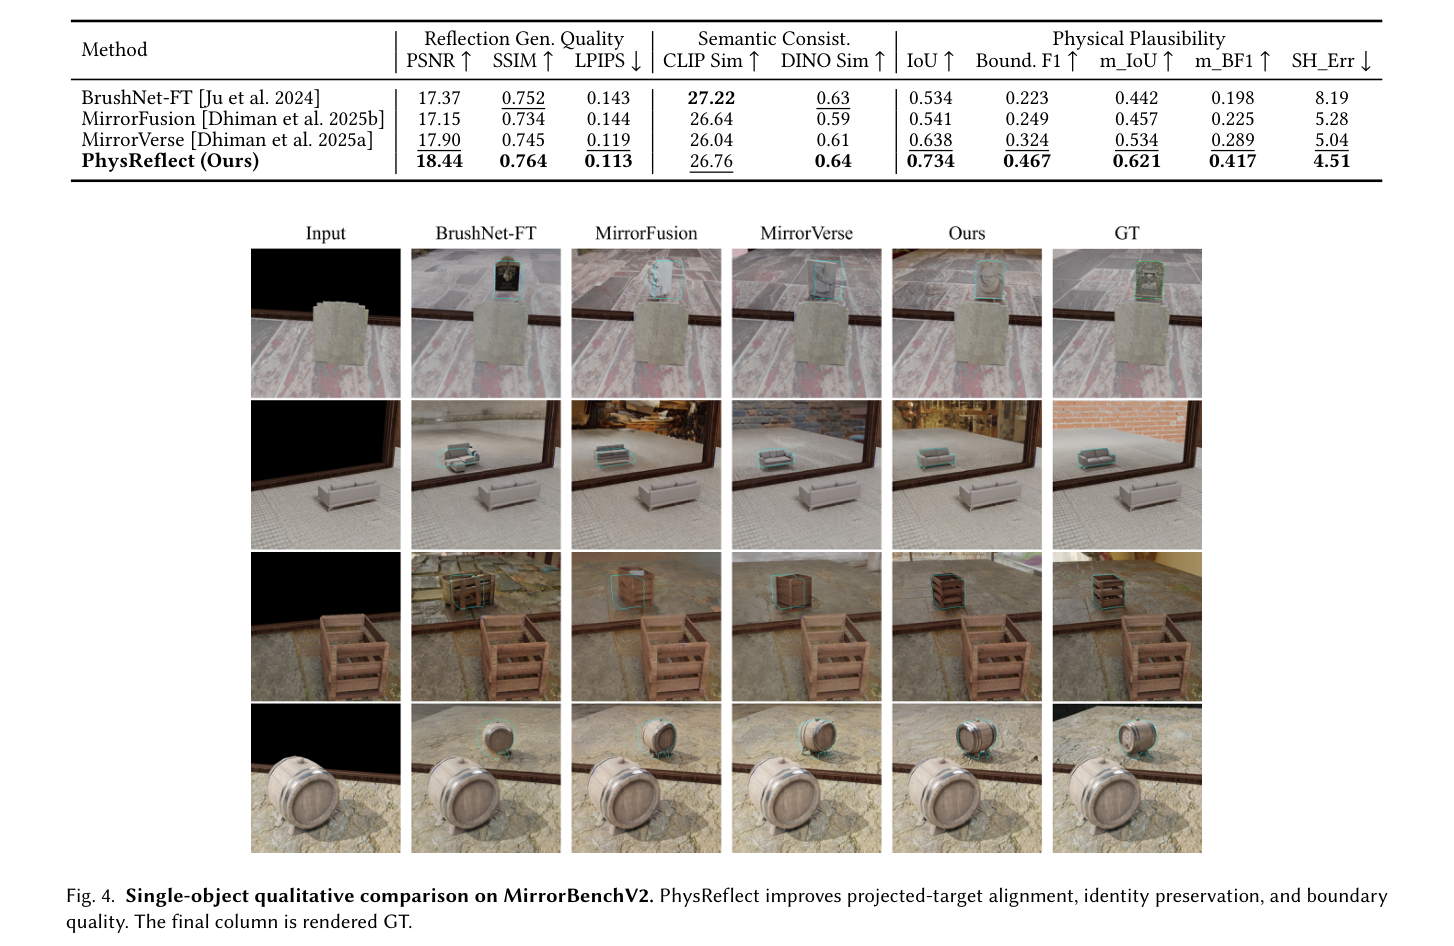
裁切上方如果出现数字表,那是同页 Table 2 的多物体指标,不要当成这张单物体定性图的分数。下方网格列是 Input、BrushNet-FT、MirrorFusion、MirrorVerse、Ours、GT,行是石块、木箱和木桶。看镜内物体是否落在与末列 GT 相近的位置,轮廓有没有拧掉。青色参照线帮助看投影,末列是渲染 GT。
核心结论
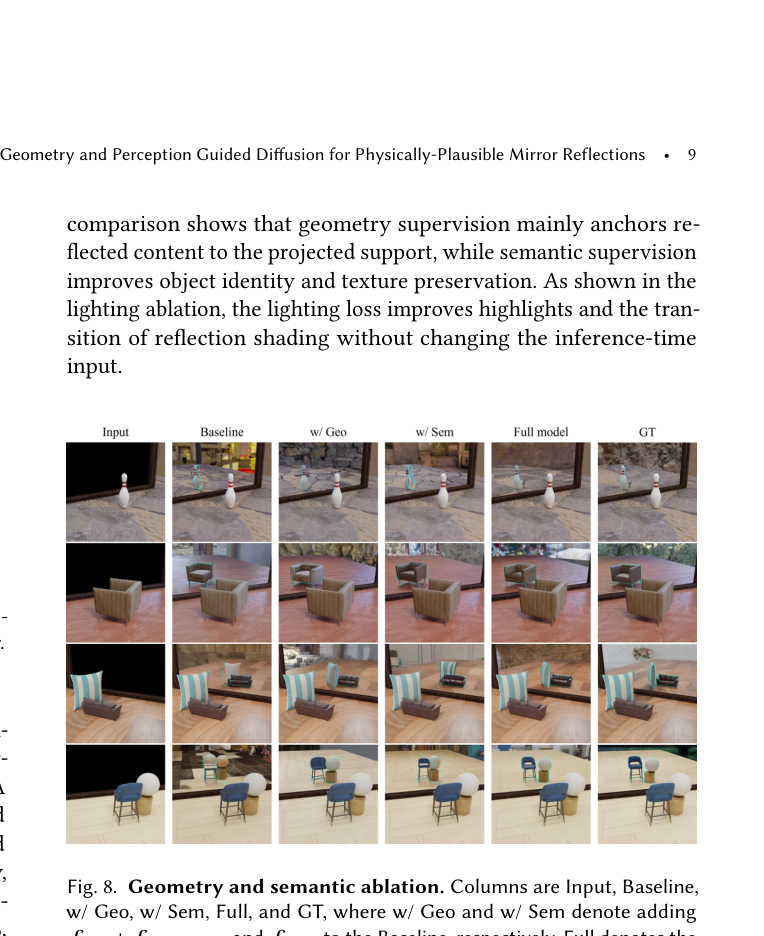
几何与语义消融。可用列是 Input、Baseline、w/ Geo、w/ Sem、Full model、GT,四行是保龄球瓶、扶手椅、条纹靠垫和一组蓝凳。w/ Geo 看位置是否回到投影支撑,w/ Sem 看条纹和外观是否保住,Full 看两边是否同时接近 GT。左侧有被裁进来的正文,底部图注不完整;定量消融以 Table 4 为准,不要从这张图读出 PSNR。
实验如何设计?
- 数据:SynMirrorV2 含 201610 个 Blender 镜面场景、66062 个目标物体,MirrorBenchV2 是其评测划分,分单物体和多物体。MSD 含 4018 张真实室内镜面图,深度和相机内参为估计值,指标相对拍摄参考而不是确定性渲染 GT。
- 训练:在预训练 Stable Diffusion v1.5 上用 Adam 微调,学习率 1×10^{-5},batch size 4,FP32,四张 NVIDIA H100。单物体、多物体、真实阶段分别为 60000、30000、20000 步。消融在两张 H100 上跑。
- 评测分辨率 512×512,采样策略与提示对齐,每样本四个随机种子,按 MirrorVerse 的未遮罩区域 SSIM 选择最好结果。对照为 BrushNet-FT、MirrorFusion、MirrorVerse;MSD 另报是否做 MSD 微调。
- 指标:镜区 PSNR、SSIM、LPIPS;CLIP Similarity 与 DINO Similarity;IoU、Boundary F1,多物体另有 m_IoU 与 m_BF1;SH_Err 用二阶球谐衡量低频光照,越低越好。
- 用户研究:九名评价者,200 个样本,在 PhysReflect、MirrorVerse、MirrorFusion、BrushNet-FT 中四选一。至少五票记为严格多数。效率表在单张 H100、FP32、一张 512×512 上比较 DDIM 50 步与 UniPC 15 步。
关键结果与论文证据
- Table 1(第 7 页)单物体:PhysReflect 为 PSNR 19.14、SSIM 0.78、LPIPS 0.103、CLIP 25.87、DINO 0.68、IoU 0.671、Boundary F1 0.406、SH_Err 15.33。MirrorVerse 为 18.74、0.77、0.108、25.69、0.64、0.598、0.316、49.93。重建分只略好,IoU、轮廓和光照误差拉开更多。MirrorFusion 的 CLIP 25.89 略高,SH_Err 仍是 51.48;BrushNet-FT 的 SH_Err 为 107.42。
- Table 2(第 7 页)多物体:PhysReflect 的 PSNR/SSIM/LPIPS 为 18.44/0.764/0.113,DINO 0.64,IoU 0.734,Boundary F1 0.467,m_IoU 0.621,m_BF1 0.417,SH_Err 4.51。MirrorVerse 对应为 17.90/0.745/0.119、0.61、0.638、0.324、0.534、0.289、5.04。BrushNet-FT 的 CLIP 27.22 高于本文 26.76,正文据此说明文本图像对齐不是物理布局的可靠代理。
- Table 3(第 8 页)MSD:未微调 PhysReflect 的 PSNR 16.84、DINO 0.52、SH_Err 75.95,对照未微调 MirrorVerse 的 16.76、0.48、128.74。微调后 PhysReflect 为 17.11、0.58、65.69,MirrorVerse-FT 为 16.61、0.51、96.47。CLIP 最高的是 MirrorVerse-FT 的 27.67,不是本文。未微调行已在若干指标上接近或超过微调后的 MirrorVerse,说明增益不只有记住合成反射。
- Fig. 4 与 Fig. 5:单物体网格里石块、木箱和木桶的反射,基线更容易偏位或变形;多物体网格里椅子、被遮挡的沙发、两只花瓶和柜子,基线会出现缺失、重复或挤在错误深度,PhysReflect 更靠近末列渲染 GT。青色线是投影或轮廓参照,不是分数。
- 用户研究(第 9 页,Fig. 7):共识覆盖率在视觉质量、图文语义、物理可信度上为 58.5%、55.5%、84.0%,无共识比例为 41.5%、44.5%、16.0%。共识样本中的偏好份额,视觉质量为 BrushNet-FT 2.56、MirrorFusion 5.13、MirrorVerse 10.26、PhysReflect 82.05;图文语义为 2.70、5.41、10.81、81.08;物理可信度为 4.76、2.38、4.76、88.10。这是共识子集内的分布,不是全部 200 张的得票率。
- Fig. 8:列顺序为 Input、Baseline、w/ Geo、w/ Sem、Full、GT。保龄球瓶、扶手椅、条纹靠垫和一组凳椅上,几何监督主要把反射拉回投影支撑,语义监督更保纹理和身份,完整模型更接近 GT。正文称光照损失改善高光和阴影过渡且不改推理输入;Table 4 还表明退火和 TwinTrack 影响监督何时、何处生效。抽取到的无退火几何行重建明显变差(约 PSNR 15.28、SH_Err 114.42),但勾选列易错位,且完整行约 18.93/0.621/17.25,不要和 Table 1 的 19.14/0.671/15.33 混成一行。
- Table 5(第 10 页):PhysReflect 的 DDIM 50 步 S-Time/M-Time/显存为 7.31/7.23/9.82,UniPC 15 步为 1.45/1.38/10.03,贴近 BrushNet-FT 的 7.12/7.06/9.76 与 1.28/1.25/9.97,也贴近 MirrorVerse。物理增益不是靠推理时多跑 SAM2 或 DINOv2。
阅读时需要注意
- 结论写明方法目前面向以平面镜为主的场景,曲面镜、强烈非平面反射不在当前公式里。
- 几何监督依赖镜面法向、距离、深度和内参。MSD 上这些量是估计的,估计错误会直接削弱极线和投影边界。
- 合成到真实仍有域差距。Fig. 6 的末列是拍摄参考,不能当成渲染 GT 来解读像素误差。
- 冻结的 DINOv2、SAM2 和 Lotus 增加训练成本。附录有代表性失败例,正文没有把失败归零。
关联工作
- 潜扩散修补与可控生成提供骨干,但条件通常告诉模型在哪里画,不保证画出来的内容满足镜面关系。ReFL、AlignProp、DRaFT、REPA、PixelGen 说明解码输出和预训练特征可以做监督;PhysReflect 把它们收成源到反射的几何约束和镜内外观、光照先验。
- 镜面检测、玻璃分割,以及 MirrorGaussian、Mirror-3DGS 一类重建方法处理的是多视图场景恢复,通常需要位姿和迭代优化。本文是单图生成,输入仍是掩码、深度和文本。
- EpiDiff 用极线约束多视图特征交换,Zero-1-to-3 用相对相机位姿。镜面任务的对应发生在同一张图的镜外与镜内,极线来自镜面法向而不是第二台相机。
- 最直接的对照是 MirrorFusion 与 MirrorVerse 的数据与课程路线,以及 BrushNet 微调。本文沿用它们的三阶段日程和 SSIM 选种协议,以便把差异归因到像素空间的物理损失。