快速导读:佛罗里达州立大学与 JAIST 的工作区分感知失败和过程失败:模型可以正确列出证据仍给出与证据矛盾的答案;SRT 用状态抽取、相关性核验和目标承诺约束决策,而增益取决于过程先验是否对齐图像当前的阶段边界。
视觉语言模型已经能在很多图文问答里给出像样的答案,但有一种错误很顽固:模型先正确描述了画面,紧接着却做出和这段描述矛盾的决定。论文把这种现象称为过程失败,以区别于根本没看见证据的感知失败。佛罗里达州立大学与日本北陆先端科学技术大学院大学的工作用三阶段实验说明,多给视觉标注补不上这道缝,必须规定模型怎样使用已经看见的证据。
方法叫 SRT,即状态抽取、相关性核验和目标承诺。三个步骤是任务无关的不变量,具体核验什么则要跟着图像当前的决策边界变。基准 VPAC-BENCH 覆盖九个真实图像过程族,并标注活动阶段。核心结论是:过程先验的价值不在提示写得长,而在它是否对准这张图所处的阶段;金标边界能收回大部分差距,模型自己找边界仍然不行。
英文题目:Seeing Is Not Enough: Vision-Language Models Perceive Evidence but Fail to Act
论文出处:arXiv 每日论文精选 · arXiv:2609.22588
原始论文:PDF / 论文页面
这篇论文解决什么问题?
引言里的例子是“车是什么颜色”。图中有多辆不同颜色的车,模型被要求先描述时所列候选是对的,最终却仍输出单一自信答案。证据已经在上下文里,决定没有服从证据(第1–2页)。这类情形还包括歧义指代、空间关系验证,以及判断一个动作正处于准备、执行还是完成。
一条研究路线加强视觉接地,用 NaturalBench、Winoground、VQA v2、物体幻觉和视觉–知识冲突来解释模型为什么不看图。这些工作的失败定义停在最终答案,没有分开“没感知到”和“感知到了但没绑定”。另一条路线用思维链、多模态 CoT、Visual Sketchpad 和 LLaVA-CoT 把中间推理写出来。中间痕迹本身不保证证据一致:模型可以列举全部候选,仍承诺一个自己的观察支持不了的答案(第2–3页)。
因此缺两样东西。一是度量过程失败的评测,二是在推理时显式给出的过程先验,告诉模型如何把已见证据收成决定。作者用 S1、S2、S3 分别回答“失败是否独立存在”“同一先验能否跨模型迁移”“迁移差异是不是因为没对准阶段边界”(第2页)。
核心创新
- 把“看见了却没用”定义为与感知失败不同的过程失败,并用指代歧义的对照把它从“多给视觉标注”里分离出来。
- 提出 SRT 三不变量,以及按图像当前决策边界选择过程先验的 boundary-sensitive 扩展。
- 发布 VPAC-BENCH:九个真实图像过程族,带人工复核标签和阶段边界,用来检验先验是否对齐当前活动阶段。
方法概览
过程式视觉问答要求正确答案来自场景合适、且能被可见证据核验的过程 P,而不能只靠问句的语言统计。感知失败是 e(I) 不含决策状态;过程失败是 e(I) 含有该状态但最终答案不等于 P(e(I), Q, d)。SRT 把 P 写成三个任务无关的不变量:S 抽取最小充分视觉状态,R 只保留区分当前决策边界的关系,T 只承诺证据能判定的结论,多个可接受答案时改为报告歧义。S1 在 COCO/GQA 指代消歧上用已有的 inspect–judge–decide 证明过程结构本身有用;S2 把 SRT 用到 VSR 空间关系;S3 在 VPAC-BENCH 九个过程族上把先验按阶段边界路由。Oracle router 使用金标边界,self-router 让模型自己先猜边界。
- 形式化:给定图像 I、问题 Q 和目标决定 d,若存在过程 P 使正确答案 A*=P(I,Q,d),且 A* 不能只靠问句的语言统计或笼统场景先验得到,这个任务就是过程式的。e(I) 是模型从图像抽出的证据。感知失败指 e(I) 不含决策相关状态;过程失败指 e(I) 含有该状态,但答案仍不等于 P(e(I),Q,d)(第4页)。
- S 状态抽取:从全部可见实体 V(I) 里选出最小充分子集,抑制决策用不到的物体和属性。R 相关性核验:在抽出的证据上只保留区分目标边界所必需的关系,其余关系视为过程漂移。T 目标承诺:答案必须落在仅凭已核验证据就能判定的集合里,不推断画面上看不见的过去或未来;若允许多个答案,则一个都不承诺,改为指出歧义(第4页)。
- 三个阶段共用这组不变量,但语义不同。S1 的 S/R/T 是可见候选、候选是否唯一、以及作答/枚举/澄清。S2 是主体、参照物和几何布局,只核验被问到的空间关系,再给出真、假或不确定。S3 是演员、工具、被操作物体和状态线索,核验阶段边界是否兼容,再输出当前阶段标签(第3页 Table 1)。
- S1 并不引入完整 SRT 提示。它把“只增加视觉访问”和已有的 inspect–judge–decide(Visual Sketchpad)对照。inspect 对应状态,judge 对应相关性,decide 对应承诺。这个结构有效,才促使作者写出 S2/S3 直接评测的 SRT-base(第5页)。
- 边界路由:一个过程族有多条边界。工具刚接触物体,和状态转换已经完成,需要的证据不同。路由器先选 b*=arg max g(I,b),再实例化该边界的先验;S、R、T 的角色不变。Oracle 把 g 设成金标指示,只回答“对齐是否有用”;self-router 让模型先预测边界,回答“模型能不能自己找到边界”(第5页)。
逐图理解论文
失败直觉
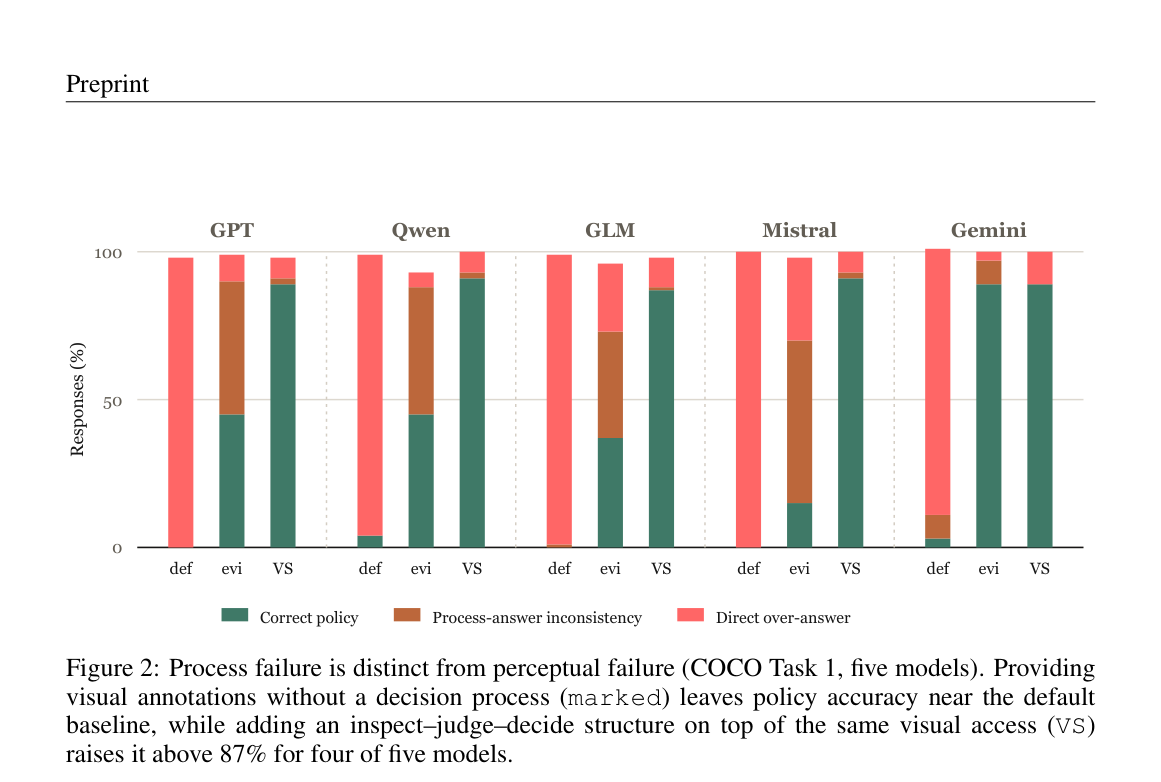
五组堆叠柱对应 GPT、Qwen、GLM、Mistral、Gemini,每组三根,标签是 def、evi、VS。纵轴是 Responses (%),大约从 0 到 100。绿色是正确策略,棕色是过程与答案不一致,粉色是直接过答。def 柱几乎全粉,VS 柱以绿色为主,evi 介于两者之间,其中 Gemini 的 evi 已经大部分变绿。用它理解“看见更多”不够、加上审视–判断–决定才把多数模型从过答里拉出来。图注提到的 marked 条件没有单独的柱。
实验观察
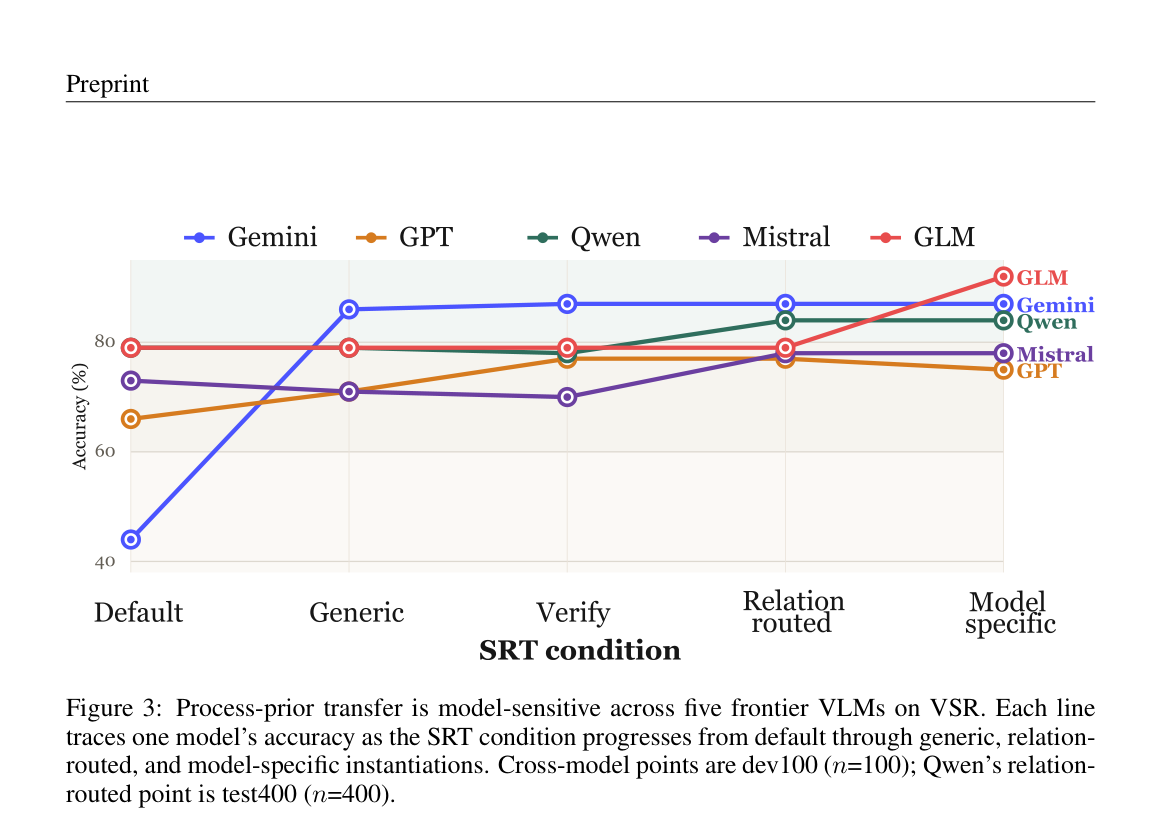
折线横轴是 Default、Generic、Verify、Relation routed、Model specific,纵轴是 Accuracy (%)。蓝线 Gemini 起点最低,到 Generic 就升到高位并走平;橙线 GPT 缓升后在最后一点略降;绿线 Qwen 中后段上升;紫线 Mistral 先平后升;红线 GLM 前段平,在 Model specific 升到最高附近。点上没有数字。它说明同一套过程先验不是均匀的迁移,读的时候不要把五条线当成同一个测试切分,Qwen 的 relation-routed 点来自更大的 test400。
Figure 4: Oracle boundary-sensitive SRT versus generic SRT on three of the four standardized pro- cess families (n=60 pe
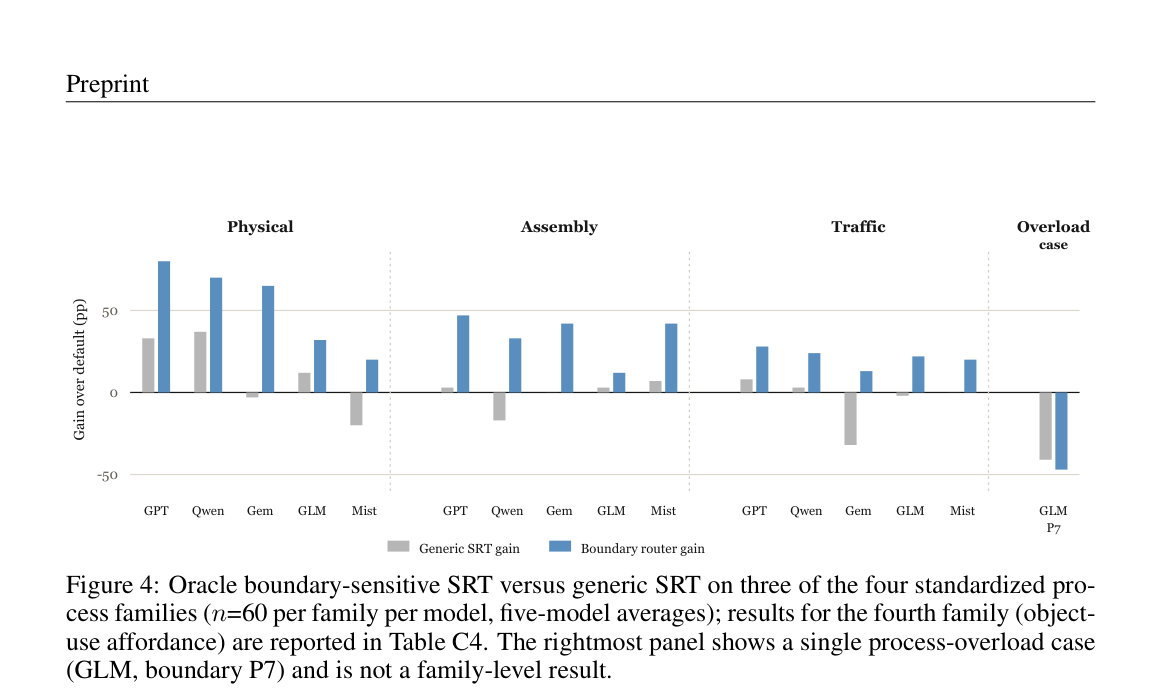
四个面板:Physical、Assembly、Traffic,以及最右的 Overload case。灰柱是通用 SRT 相对默认的增益,蓝柱是边界路由增益,纵轴单位是百分点,零线清楚可见。前三个面板里蓝柱多为正,灰柱多次接近零或为负,Traffic 里 Gemini 的灰柱明显低于零线。最右只有 GLM、边界 P7,两根柱都为负且蓝柱更低。读图时把前三面板当成逐模型的族内对比,把最右面板当成单个过载例子,不要把它平均进族结论。柱顶没有印出具体百分点。
实验如何设计?
- 五个前沿模型:GPT-5.4-mini、Qwen2.5-VL-72B、GLM-4.6V、Mistral-Small-3.2-Vision、Gemini-3.1-Pro。解码温度 0,最大输出 700 token(第6页)。
- S1 主集来自 COCO:457 个歧义指称、330 个唯一指称。GQA 外部集为每模型 100 个歧义和 96 个唯一。四个条件是 default、evidence(先列举候选)、marked no prior(有视觉标注但无决策过程)、visual sketchpad(同样标注再加 inspect–judge–decide)。策略准确率要求歧义时枚举或澄清、唯一时才作答;过答率是歧义未解仍给唯一答案的比例(第6页)。
- S2 在 VSR 上报告标准准确率。Figure 3 的横轴是 Default、Generic、Verify、Relation routed、Model specific。图注说明跨模型点来自 dev100(n=100),Qwen 的 relation-routed 点来自 test400(n=400)(第7页)。
- S3 的标准化四族在五模型上评估,每族每模型 n=60,论文要求把族级数字当成诊断证据,Wilson 区间在附录。支撑五族只用模型子集。Figure 4 画的是其中三族的逐模型增益,物体使用可供性在 Table C4,最右面板不是族结果(第8页)。
- Table 3 的消融平均 GPT-5.4-mini、Qwen2.5-VL-72B 和 Mistral-Small-3.2,每条件每族 n=180。正文明确它和五模型 S3 均值不是同一统计,不能横比(第8–9页)。
关键结果与论文证据
- Table 2(第6页)支持过程失败独立于感知失败。COCO 上五模型默认过答率在 95.8% 到 100% 之间,策略准确率接近 0(GPT 0.0/98.5,Mistral 0.0/100.0)。evidence 让策略准确率上升,但很不均:Mistral 只有 15.0,Gemini 已到 89.0;许多回答列出多个合法指称后仍然提交唯一答案。marked 对 GPT、Qwen、GLM、Mistral 仍接近默认。VS 把这四个模型的策略准确率抬到 87.0–91.0,过答率低于 13%,且不损害唯一指称的 Task 2(各模型不低于 99%)。
- Figure 2 把 COCO Task 1 画成堆叠柱:def 几乎全是粉色直接过答,evi 混有绿色正确策略、棕色过程–答案不一致和残余粉色,VS 以绿色为主。Gemini 的 evi 柱已经大部分是绿色,和表中 89.0 一致,所以“先列举”对它已经很强。图上没有 marked 柱(第4页图,数字在第6页表)。
- S2(第5、7页):generic SRT 对 Gemini 约 +43 个百分点,是 n=100 上唯一置信区间不相交的提升;其他模型不变或略降。Figure 3 上蓝线在 Generic 处从最低一带跳到高位后走平,橙线 GPT 缓慢上升后在 Model specific 略回落,红线 GLM 主要到 Model specific 才上升。点上没有印数值,不能把目测纵坐标当成表内数字。
- S3 五模型(第8页):physical 默认只有 26.7%,oracle 边界路由平均增益 +53.3 pp;assembly +35.0 pp,traffic +21.7 pp,affordance +22.7 pp。通用 SRT 会伤部分模型:Gemini 在 traffic 上 −31.7 pp,Qwen 在 assembly 上 −16.6 pp,GLM 在 affordance 上 −8.3 pp,并且在四族上都低于最佳 CoT 基线。Figure 4 的蓝柱(边界路由)在 Physical、Assembly、Traffic 上总体高于灰柱,灰柱多次落到零下;最右 GLM P7 两根柱都为负,且蓝柱更低,这是单个过载案例。
- 三模型消融 Table 3(第9页):physical 默认 29.4,只给视觉证据 51.1,只留策略 T 15.6,S+T 27.8,R+T 41.1,S+R 无 T 为 35.0,完整 SRT 46.1。错误边界路由器 26.7,低于完整 SRT 也低于默认附近的可用水平,而它和 oracle 的提示信息量、格式相同,因此不能把收益解释成“提示更具体”。assembly 上完整 SRT 42.2,并不高于默认 44.4,各残缺配置的区间大量重叠。
- self-router 在 physical/assembly 上为 47.8 / 42.8,相对 generic SRT 的 46.1 / 42.2 只多 +1.7 和 +0.6 pp,置信区间几乎重合,论文要求不要解读成统计上成立的提升。Oracle 为 86.1 / 85.0。边界预测准确率约 36.7–61.7%,自动找边界是可部署版本的主要瓶颈(第9页)。贡献列表中的 86.1% 对 29.4% 指的就是这张三模型表的 physical 行,不是五模型的 26.7%。
阅读时需要注意
- Oracle 路由假定边界标签已知,只能作为上界。self-router 没有实质关上与 oracle 的差距,论文把自动边界识别留给后续(第9页)。
- 通用 SRT 不是安全的默认提示。错边界控制在 physical 上 26.7,低于完整 SRT 的 46.1,区间不相交;在 assembly 上 30.5,低于默认。过载案例里更强的过程约束反而更差。
- 族级样本只有每模型 60 张,作者明确将其作为诊断证据。三模型消融换了模型集合和配对方式,引用数字时必须写明是哪一张表。
- 只提供边界标签、不提供对齐的过程描述,在 physical 上能涨,在 traffic 和 affordance 上会跌。作者指出还需要与输出格式匹配的对照,才能分开过程内容和格式本身(第9页)。
关联工作
- 过程导向的数据集如 EPIC-Kitchens、COIN、HowTo100M 把过程本身当成要识别的视频任务,或依赖外部工具链。本文把过程当成单张图像上的决策约束,不要求视频序列(第3页)。
- 歧义指代工作训练模型寻求澄清,但通常不检验最终答案和模型自己列出的观察是否一致。S1 的策略准确率把“该澄清时是否澄清”写成可计算指标(第3、6页)。
- 空间推理基准 VSR 覆盖大量关系。S2 说明关系先验不能无差别迁移:对 Gemini 帮助大,并不自动成为其他模型的增益(第5、7页)。