快速导读:MinCU 用 2000 对只有一处原子变化的近重复图像,同时要求描述、双图框和实体名;SG-ISA 让 Qwen3-VL 先输出语义线索,再用 10 个离散位置锚点约束描述和细框。
近重复的两张图里,真正重要的差别往往很小:戒指不见了、沙发换了颜色、多出一顶帽子,或者瓶子从左边挪到中间。多模态模型若只写一句说明,可以靠语言猜;若只在单张图上画框,又不知道变化前的对应区域在哪里。大连理工大学等的 MinCU 把这件事定义成同时完成三件事:说出原子变化、在原图和编辑图上框出对应区域、给出实体标签。配套方法 SG-ISA 不靠长篇文字思维链,而是先给出语义线索,再吐出少数离散位置锚点,然后才写描述和细框。
测试集有 2000 对,物体、属性、计数、关系各 500 对;训练集超过 8000 对。在 Qwen3-VL-2B 上,SG-ISA 的 Grounded F1 为 82.88,高于同骨干监督微调的 72.75,也高于表中的 GPT 5.4、Gemini 3.1 Pro 和 Qwen3-VL-Plus。相对显式文本思维链,平均输出长度从 135.77 降到 100.58,约少 26%。预印本,abs 页未见独立代码链接。
英文题目:MinCU: A Fine-Grained Benchmark for Grounded Minimal-Change Understanding in Image Pairs
论文出处:arXiv 每日论文精选 · arXiv:2609.23336
原始论文:PDF / 论文页面
这篇论文解决什么问题?
多数多模态模型按单图设计。近重复图像对要求的是跨图比较:哪一个实体变了,原位置和新位置是否还是同一个东西,增加和删除哪一侧应该是空的。只做差异描述的 Spot-the-Diff、CLEVR-Change、OmniDiff、Image-Editing-Request 不要求框。VisMin 更接近图文匹配。DiffGround 开始提供变化区域的框,但编辑多为原位替换,变化前后的框在位置和尺度上仍然靠近,覆盖不了位移、尺度变化和一对多、多对一。
建模侧也缺一块中间表示。Pix2Seq、Shikra、Ferret、Qwen3-VL、InternVL3.5 把定位做进自回归解码,目标仍是单图。Migician、VLM-R1、UniVG-R1 用文本思维链或多图训练,但一维文字只是二维对齐的间接界面,既长,也容易在描述展开之后才发现框已经偏了。
所以基准和模型要一起改。基准必须把变化收成互斥的原子类型,并强制描述、双图框和实体同时正确。模型则需要一个比自由文本更短、比直接回归连续坐标更稳的空间瓶颈。
核心创新
- 把最小变化理解定义成描述、双图定位和实体对齐必须同时正确,并建成四类原子变化基准。
- 用语义引导的十格离散锚点做隐式空间瓶颈,替代冗长的文本思维链。
- 用 Grounded F1 把 IoU、BERTScore 和实体标签绑在同一个真阳性上,避免只看描述或只看框。
方法概览
SG-ISA 把目标序列写成 Y=Yobj⊕Yanchor⊕Ydesc⊕Ybox,用教师强制的负对数似然做监督微调。Think:先生成简短实体序列,其隐藏状态对视觉标记做交叉注意力,形成空间查询。Locate:把 [0,1000] 上的框坐标按 Q(c)=<loc_i>、i=min(floor(c/100),9) 量化成 10 个离散锚点,每个区域四个锚点;增删用 <loc_null>。Describe:在锚点条件下生成描述,最后再输出 1000-bin 的细框。词表新增 16 个特殊标记:loc_0 到 loc_9、loc_null、box_sep,以及原图和编辑图隐式空间链的起止标记。骨干是 Qwen3-VL,视觉编码器冻结,语言模型、连接器和这 16 个标记更新。
- 任务输入是图像对 IA、IB 和指令。输出序列固定为四段:实体 Yobj、锚点 Yanchor、描述 Ydesc、细框 Ybox。训练就是这条序列的教师强制负对数似然,不另加强化学习。实体的隐藏状态作为查询,与视觉标记做交叉注意力,从而在预测坐标之前先把相关图块激活。
- 锚点把连续框 B=[x1,y1,x2,y2]、坐标范围 0 到 1000,按元素量化。Q(c) 对应 <loc_i>,i 等于 min(floor(c/100), 9),词表只有十个位置标记。一个区域因此是四个粗标记。论文把它写成信息瓶颈:滤掉背景,并给后续描述一个几何范围。细框仍在最后以 1000-bin 分辨率回归,粗锚点留在上下文里当先验,不再做额外后处理。
- 不对称变化用 <loc_null> 表示某一侧没有区域。完整新增标记共 16 个:loc_0 到 loc_9、loc_null、box_sep,以及原图和编辑图隐式空间链的起止标记。图 3 里视觉编码器带雪花,核心语言模型带火焰,表示编码器冻结。
- 描述阶段的条件概率显式依赖已经生成的锚点和实体,用来减少文字脱离所框区域。图 1 的街景示例把顺序印成:先判断变化对象,再给出 <loc_1><loc_7> 一类锚点,然后写 “The color of the car on the road changed from white to dark blue.”,最后给出两侧细框和标签。
- 实现:微调 Qwen3-VL-2B-Instruct 五个 epoch,AdamW,学习率 10^{-5},更新语言模型、连接器和 16 个新标记,冻结视觉编码器。约两小时,八张 NVIDIA A800 40GB。4B 与 8B 用同一解码格式。提示要求按 Think-Locate-Describe-Ground 输出指定标记,而不是自由段落。
逐图理解论文
失败直觉
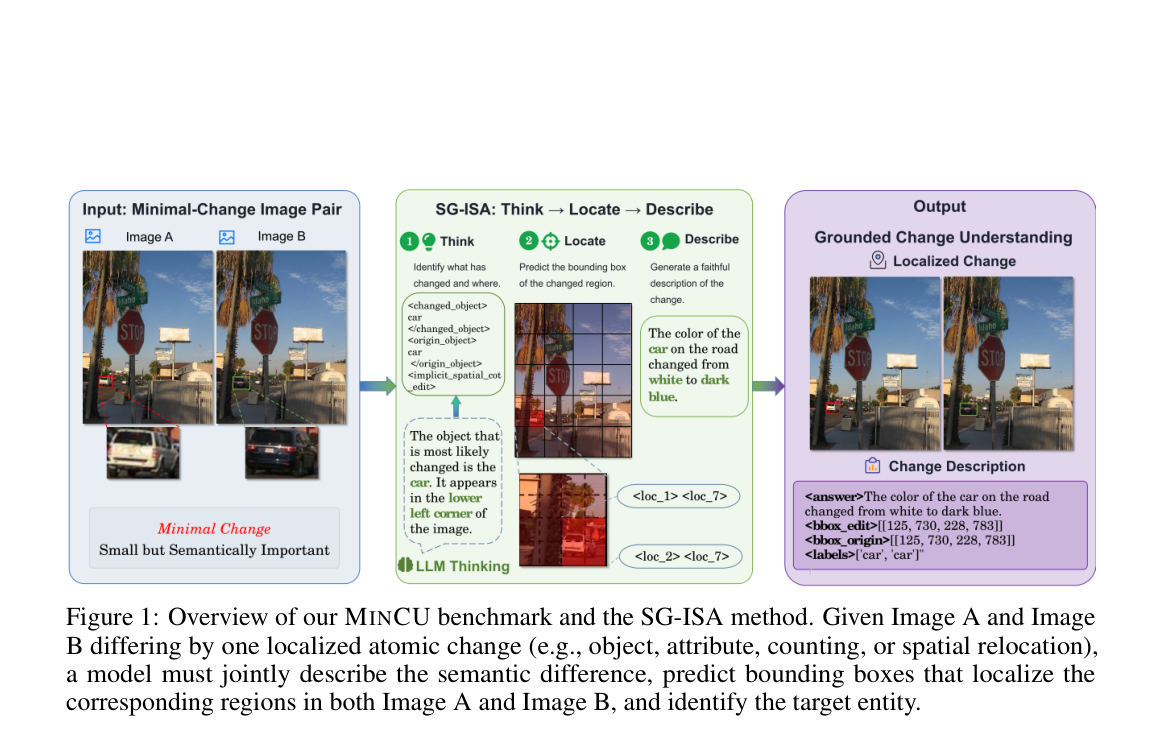
总览从左到右三块。左块是近重复街景对,小图放大局部,底部写着小而语义重要。中块是 Think、Locate、Describe:先输出变化对象和原对象标记,旁注判断变化对象出现在画面左下;Locate 在网格上给出 <loc_1><loc_7> 与 <loc_2><loc_7>;Describe 写路上的车从白色变成深蓝色。右块把两侧框、答案句和标签 ['car','car'] 放在一起,示例细框都是 [125, 730, 228, 783]。这张说明任务输出长什么样,不是定量排行榜。
研究缺口
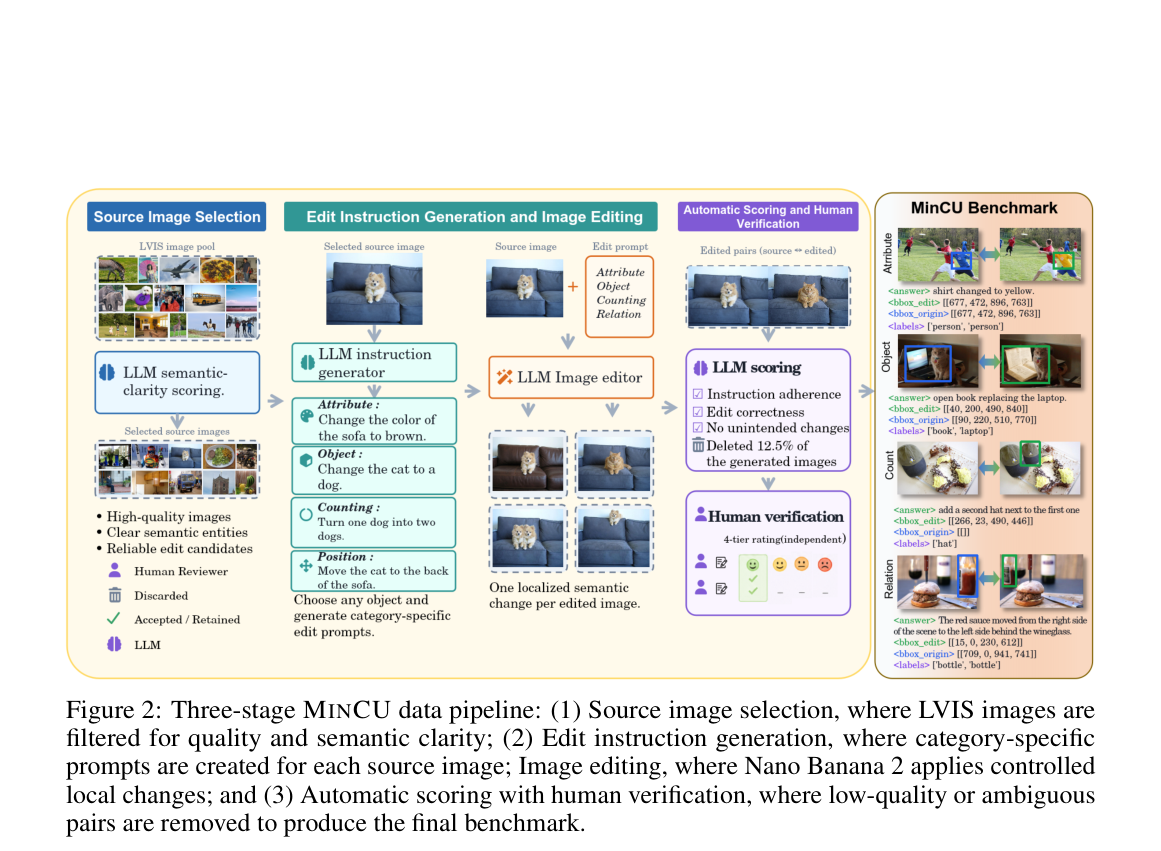
数据管线四列。第一列从 LVIS 池做语义清晰度筛选,人审图标区分丢弃和保留。第二列由指令模型写属性、物体、计数和位置四类提示,例如把沙发改成棕色、猫改成狗、一只狗变成两只、把猫挪到沙发后,再交给图像编辑模型,每张编辑图只有一处变化。第三列自动评分检查是否听话、编辑是否正确、有没有无关改动,并写明删掉 12.5% 的生成图;人工四档独立评分。第四列是四类保留样例和对应的答案、双框、标签。用它核对基准不是网上随便抓的图像对。
方法贡献
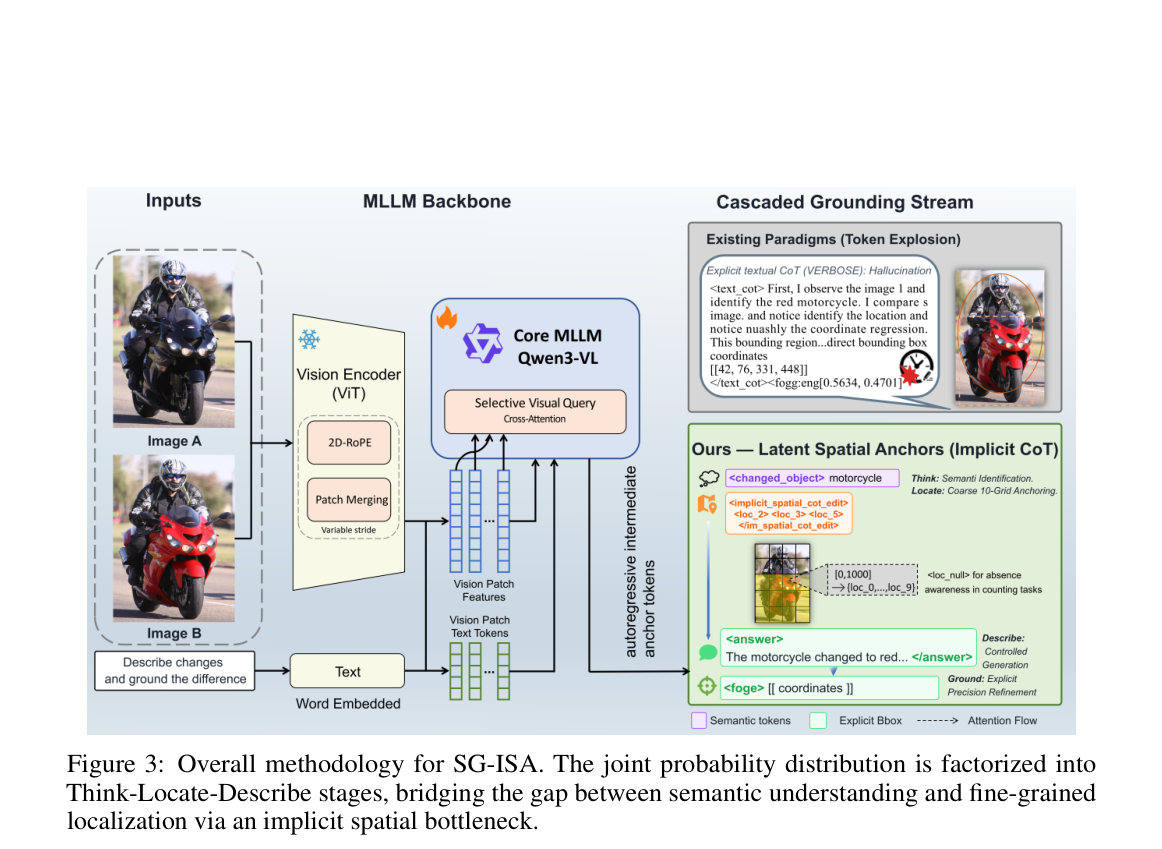
这是方法图,适合作为特色图。左侧两张摩托车图像进入带雪花的视觉编码器,编码器里有 2D-RoPE 和可变步长的 patch merging。中间是带火焰的 Qwen3-VL,用选择性视觉查询做交叉注意力,自回归吐出锚点。右上对比冗长的显式文本思维链,右下是本文的隐式锚点:先 <changed_object>,再 <loc_*> 粗网格,描述放在 answer 标记里,最后给细框。图中还标出 loc_null 用于计数任务里的缺席。看它是为了确认空间标记出现在描述之前,以及视觉编码器不更新。
对照结果
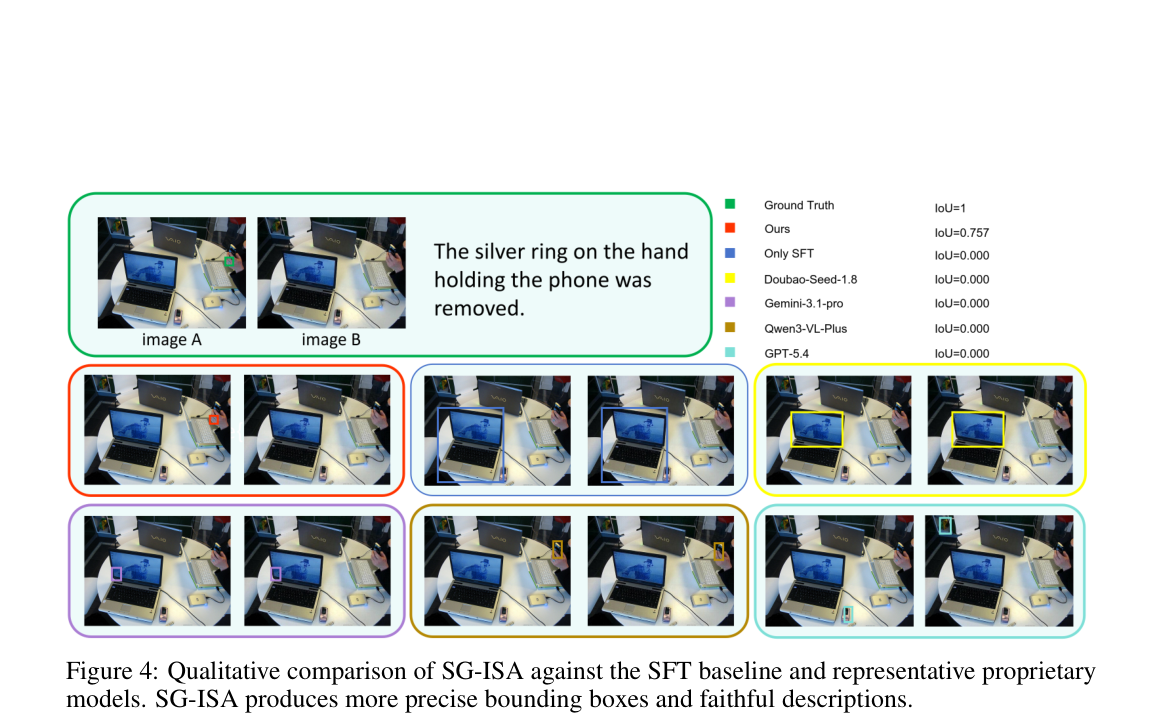
定性对比,不要和第 7 页的正文裁切混淆。绿框是真值,说明银戒指从拿手机的手上消失,并印着 IoU=1。红框是本文,IoU=0.757,框在手附近。蓝框 Only SFT、黄框 Doubao-Seed-1.8、紫框 Gemini-3.1-pro、棕框 Qwen3-VL-Plus、青框 GPT-5.4 的 IoU 都印成 0.000,框多落在笔记本屏幕或整台电脑上。这个 0.757 只属于该样例。描述句本身印在图中,可以核对模型有没有把“戒指消失”说成“电脑变化”。
核心结论
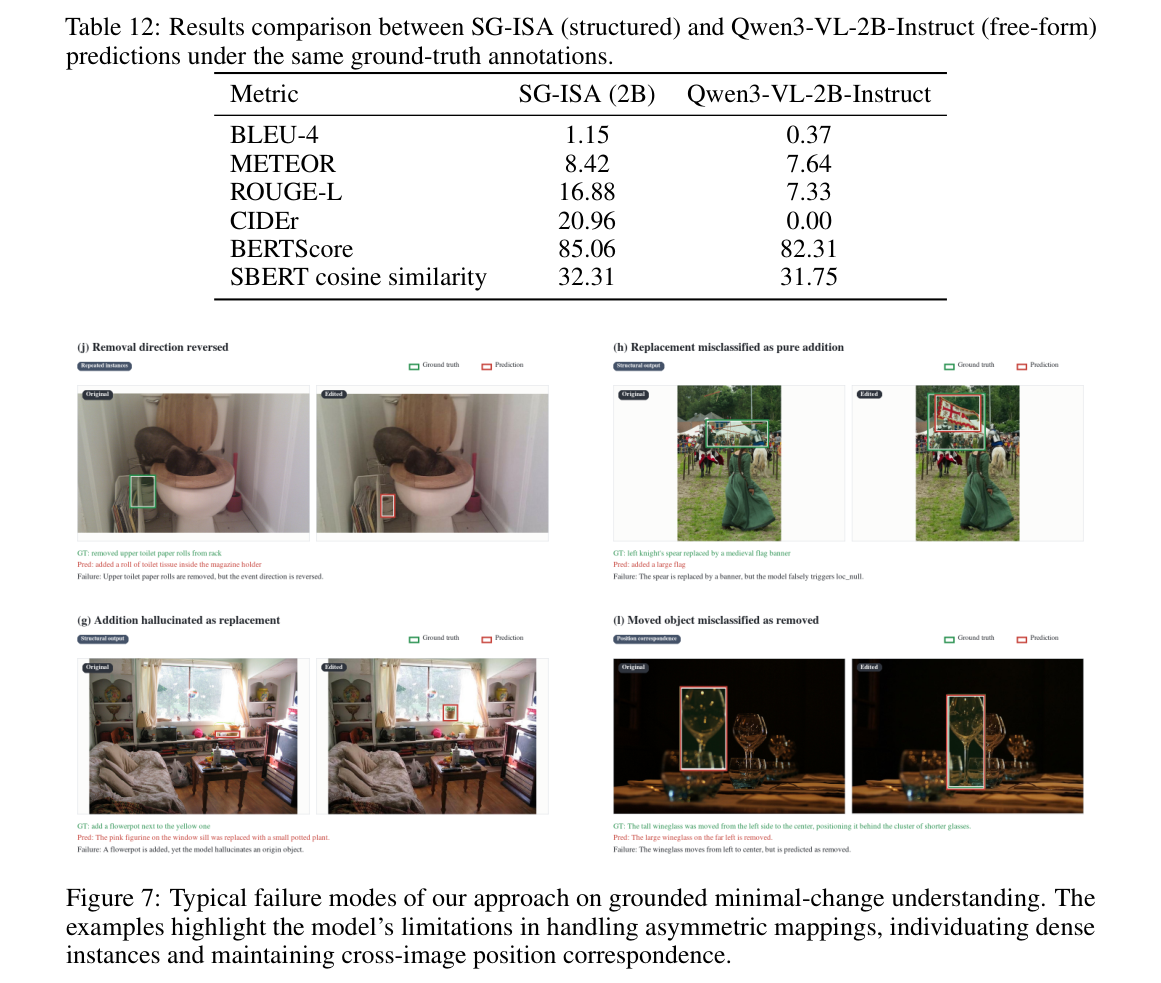
失败例,顶部另附 Table 12,不要把它当成失败图的检测分数。Table 12 是结构化 SG-ISA 相对自由形式 Qwen3-VL-2B-Instruct:BLEU-4 1.15 对 0.37,ROUGE-L 16.88 对 7.33,CIDEr 20.96 对 0.00,BERTScore 85.06 对 82.31。下方四格:卫生纸卷移除方向说反;马刺换成旗帜却被当成增加并误触发空锚点;新增花盆被说成原有盆栽被替换;高脚杯从左移到中间却被预测为移除。绿框是真值,红框是预测。它支持局限,不支持主表的 82.88。
实验如何设计?
- 数据三阶段。源图来自 LVIS,用 GPT 按图像质量和语义清晰度打分。每张源图由 Gemini 3.1 Pro Preview 写四类编辑指令:属性、物体、计数、关系,再由 Nano Banana 2 各生成一个编辑变体。约 13800 张编辑图先经 GPT 打分,约 12.5% 因不遵守指令或带上无关改动被丢掉;剩余样本由两名标注者独立做四档评分并标框,只有双方都给 excellent 才留下,这一步再去掉幸存者中的约 15%。最后 2000 对做测试,其余 8000 对以上做训练。
- 测试集四类各 500。属性包括颜色、材质、纹理、形状或状态;物体是替换、引入或删除;计数改变实例个数;关系在保持身份的同时移动实体。难度按最大物体面积:Easy 大于 25%,Medium 大于 10% 且不超过 25%,Hard 不超过 10%,采样比 1:2:2。
- 主指标是 Grounded F1:IoU 至少 0.5、BERTScore 至少 0.85、实体标签正确,三者同时成立才是真阳性。同时报告 mIoU、COCO 风格 mAP,以及 BLEU、ROUGE-L、METEOR、CIDEr、SPICE、BERTScore 和 SBERT。HR 是幻觉率,越低越好。
- 零样本对照覆盖闭源通用模型、开源通用模型和专用定位模型。消融在同一 2B 微调设定下比较解码顺序、显式文本思维链和锚点粒度。附录另做 50% 图像顺序对调,以及自由形式输出对照。
关键结果与论文证据
- Table 1(第 8 页):SG-ISA(2B)Gr-F1 82.88、mIoU 72.51、mAP 48.77、HR 3.10、CIDEr 23.16、METEOR 48.91、BERTScore 92.77。同数据 SFT 基线为 72.75、64.41、38.10、7.25、18.72、43.83、91.94。零样本里 Qwen3-VL-30B-A3B 的 Gr-F1 为 51.76,Qwen3-VL-Plus 为 48.43,Gemini 3.1 Pro 为 42.89,GPT 5.4 为 19.58 且 HR 90.00。Migician 47.76,VLM-R1 只有 0.29,UniVG-R1 为 14.11。专用定位目标并不自动迁移到跨图最小变化。
- 规模:SG-ISA 4B 为 83.17,8B 为 83.07。2B 到 8B 的 Gr-F1 几乎不动,HR 从 3.10 降到 2.60。正文据此把收益归于解码界面,而不是参数规模。未微调的 Qwen3-VL-2B 只有 13.26,所以 82.88 也不能写成“2B 零样本超过闭源”。
- Table 2(第 8 页)分类 Gr-F1:SG-ISA(2B)在物体、属性、关系、计数上为 92.30、90.56、81.74、66.87;SFT 为 87.73、88.31、68.71、46.86。计数的缺口最大,关系次之。Table 3 的 mAP 同样是计数最低:SG-ISA(2B)计数 mAP 25.88,物体 64.33。部分闭源模型的分类平均和 Table 1 总表有零点几个点的差别,跨模型排名以 Table 1 为准。
- Table 4(第 9 页)顺序:直接答案加框 72.75;先锚点后答案 79.47;先完整答案后锚点 81.58,HR 2.90;本文的实体、锚点、答案、细框为 82.88,HR 3.10。先有语义再下锚点最好,但幻觉率最低的是 Anchor-After,不是本文。
- Table 5:显式文本思维链 Gr-F1 82.15、mAP 48.21,平均 135.77 token,最长 512。隐式锚点 82.88、48.77,平均 100.58,最长 379。无思维链只有 72.75,但平均更短,为 78.40。约 26% 的节省是相对显式链,不是相对最短基线。Table 6:100 格 Gr-F1 83.04,略高于 10 格的 82.88,但 CIDEr 21.16 低于 10 格的 23.16,词表也从 10 个锚点扩到 100 个。论文选用 10 格。连续 1000-bin 直接回归仍是 72.75。
- Fig. 4(第 9 页)印出单个戒指样例的 IoU:真值 1,本文 0.757,Only SFT、Doubao-Seed-1.8、Gemini-3.1-pro、Qwen3-VL-Plus、GPT-5.4 都是 0.000。说明写的是“银戒指被拿走”,但多数框落在笔记本或整只手上。这是例子而不是测试集均值。
- Table 13(第 21 页):训练只用固定顺序,测试把 50% 的图像对调换并改写框和标签后,SG-ISA(2B)Gr-F1 73.88、mIoU 67.56、mAP 35.89、HR 11.45,低于原顺序的 82.88,仍高于原顺序 SFT 的 72.75。Table 14 给出打乱后属性 86.94、物体 77.45,计数降到 55.63,该类幻觉率 35.40%。顺序不是唯一捷径,但计数的方向性仍然脆弱。Table 11 在计数子集上,去掉 loc_null 的 Gr-F1 为 65.83、mAP 26.45,加上后为 66.87 与 25.88,空锚点略抬联合分数,并不抬高所有定位分。
阅读时需要注意
- 附录 Fig. 7 把失败收成细粒度实例绑定。小物体会被更显眼的物体替换进描述;增删破坏一一对应,该输出 loc_null 时不输出,替换时却误触发;密集同类实例被收成一个大框;位移被说成替换或删除;分散的属性变化得到过宽的并集框。
- 图中的具体失败包括:卫生纸卷的移除方向说反;马刺换成旗帜却被当成纯增加并触发空锚点;新增花盆被说成原有小盆栽被替换;高脚杯从左移到中却被预测为移除。
- 数据来自 LVIS 加生成式编辑和人工 excellent 过滤,不是监控、医疗或工业里的自然变化。同一管线的训练和测试会高估对野生图像对的泛化,尽管附录声称有野外零样本,本文不把未核对的附录表数字写成主结果。
- Grounded F1 的两个阈值和标签约束很严,描述很好但框差、或框很准但措辞不够像参考句,都会变成假阴性。HR 的定义在不同表之间也不应和 CIDEr 直接换算。
关联工作
- 差异描述一条线从 Spot-the-Diff 的网页表面变化,到 CLEVR-Change 的可控语义因素,再到 VIXEN、OneDiff 和 OmniDiff。它们回答“变化是什么”,不回答“两侧的框是否是同一个实体”。
- 单图定位一条线用离散坐标、混合区域特征或集合标记提示专有模型。Set-of-Mark 能让冻结模型指到标记,但仍是一张图上的参照,不是两张图的对应。
- 显式思维链一条线包括组合式提示、Argus 的物体中心视觉链、Grounded CoT,以及 GeM-VG、Migician 和 GRPO 类的 VLM-R1、UniVG-R1。SG-ISA 保留自回归,但把中间状态换成十个位置标记,而不是一段推理段落。
- 和 DiffGround 的差别主要在变化类型:本文强调位移和计数这类空间不对齐的最小编辑,并用双图框而不是单侧框评分。