Qwen3-VL
MinCU:用离散空间锚点同时描述并定位图像对中的最小变化
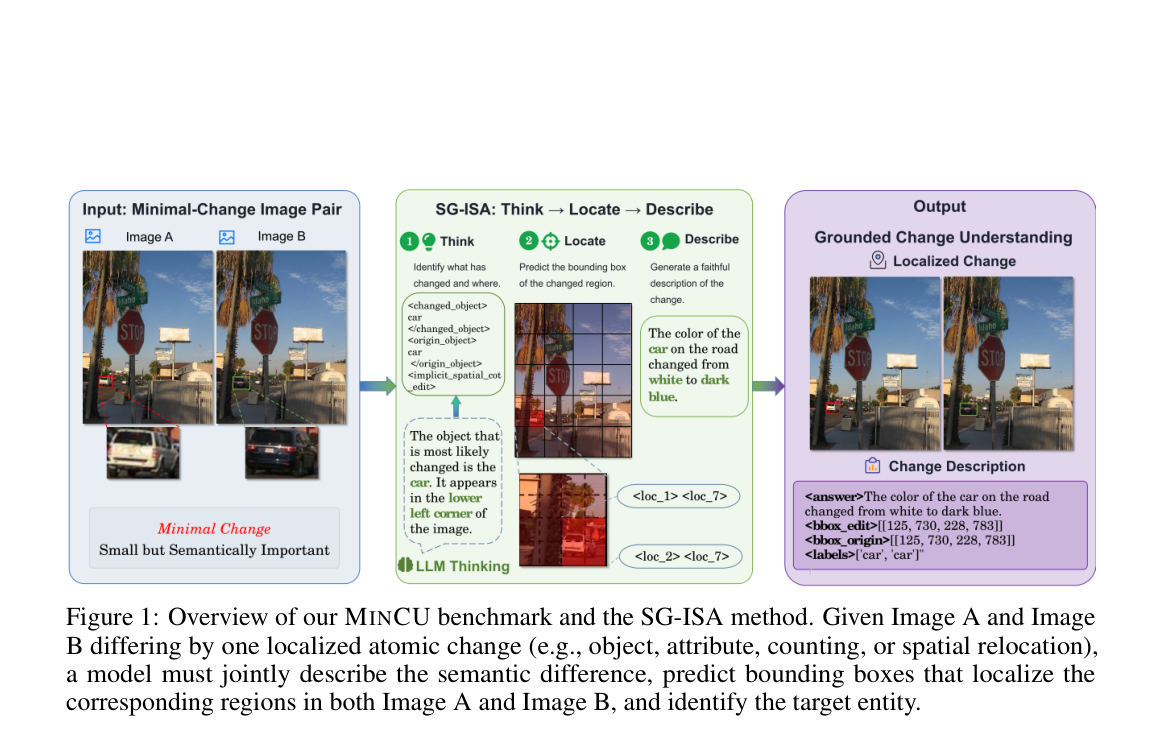
MinCU 用 2000 对只有一处原子变化的近重复图像,同时要求描述、双图框和实体名;SG-ISA 让 Qwen3-VL 先输出语义线索,再用 10 个离散位置锚点约束描述和细框。
StreamTTT:流式VLM如何同时保住实时感知与长期记忆
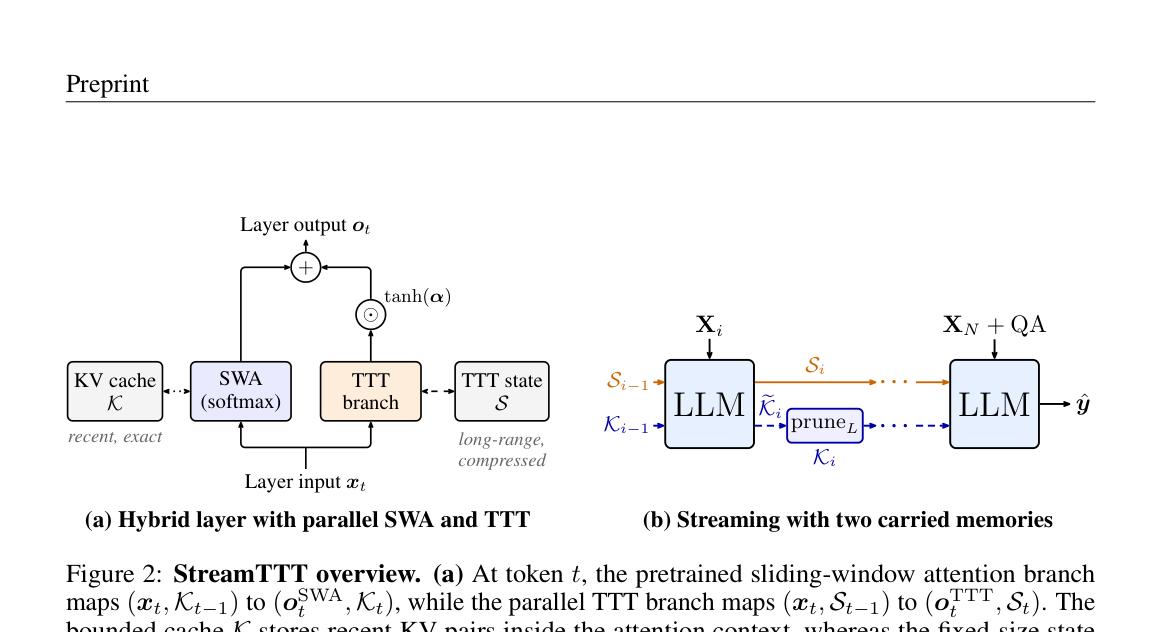
StreamTTT通过将长期历史写入注意力上下文之外的在线更新快权重(TTT分支),同时保留短滑动KV缓存专用于近期证据,从而在流式VLM中同时保持实时感知精度并提升回溯记忆能力。
问两次,看两次:提示回音解决视觉语言模型中的“问题优先”悖论
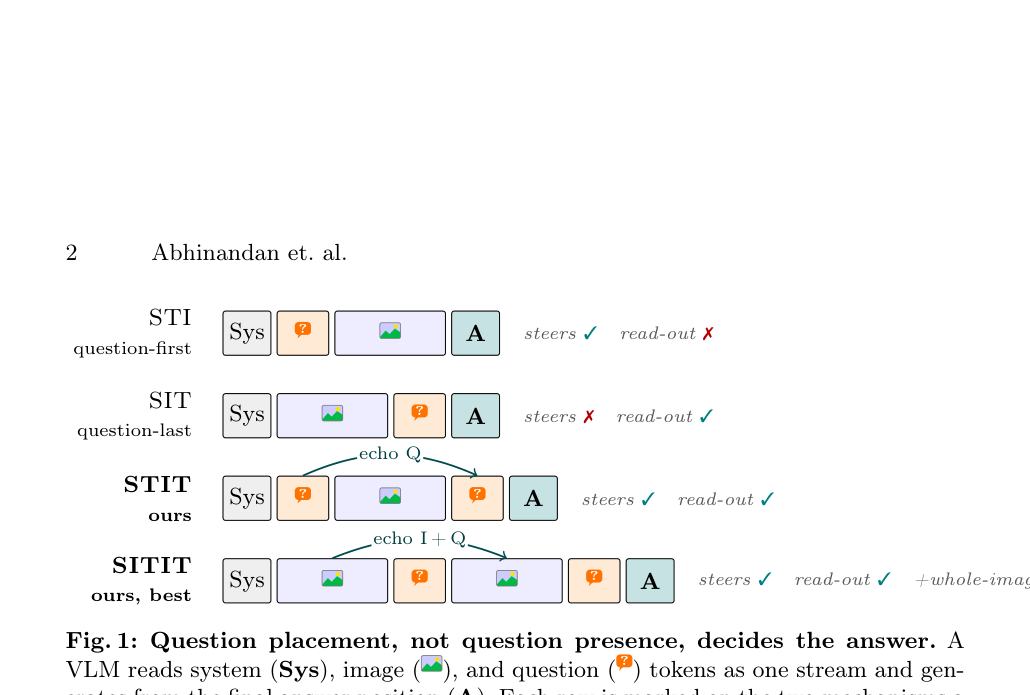
本文揭示了视觉语言模型(VLM)中“问题优先”(Question-First)提示导致性能下降的悖论。通过Logit Lens和因果注意力阻断实验,我们发现问题优先虽能引导感知,但因距离过远导致下游读取失败。为此,提出无需训练的提示回音策略(Question Echoing和Image Echoing),在Qwen3-VL等模型上显著恢复并超越基线性能。