快速导读:太原理工、腾讯 Visvise 等机构把点选、文本和整件分解收成同一个自回归部件假设模型,并在列出的对照表里取得更高的掩码交并比;这篇已被 SIGGRAPH Asia 2026 / ACM TOG 接收。
部件分割要回答的不是一张固定标签图,而是:这个三维物体在当前意图下应该切成哪些块。Zhe Zhu、Yiheng Zhang、Peng Li、Zixing Zhao、Honghua Chen、Yaqing Zhang、Le Wan、Zhiyang Dou、Cheng Lin、Yuan Liu、Mingqiang Wei 与 Wenping Wang 来自太原理工大学、腾讯 Visvise、香港科技大学、岭南大学、MIT、澳门科技大学和德州农工大学。他们的 PartLLM 把点选、文本点名和整件分解收成同一次自回归生成。论文是 arXiv:2609.25832,版式为 ACM Transactions on Graphics 文章编号 178,已被 SIGGRAPH Asia 2026 接收。
模型先用语言写出部件名和粗略三维框,再把这些假设连同背景一起解码成互斥的点级掩码。训练把 323K 个不重复形状整理成 110 万条样本。在论文列出的表里,Ours 高于同列对照;作者在贡献列表中使用了 state-of-the-art 这一说法。这个说法只覆盖所评设定和所列表格。项目页可以打开,独立代码仓库没有在 PDF 里给出,开源状态待核验。
英文题目:PartLLM: A Unified Multimodal Foundation for 3D Part Segmentation
论文出处:arXiv 每日论文精选 · arXiv:2609.25832
原始论文:PDF / 论文页面
这篇论文解决什么问题?
人在改资产、绑骨骼或计划抓取时,先要知道物体由哪些部件组成、彼此怎么接。早期学习方法把这件事做成点分类,词表来自 ShapeNetPart 和 PartNet。真实资产的类别和部件名经常落在词表外面,所以封闭世界的分类器很难直接用。
后续工作分成几截。一类用视觉语言模型或图像分割模型,从渲染视角把二维掩码抬进三维,结果依赖视角是否盖全。一类前馈模型直接从点云出掩码:FIND3D、PatchAlign3D 和 CoSMo3D 按用户给的名字做接地,却不决定整件该如何分解;PartField、PartSAM、P3-SAM、S2AM3D 和 SegviGen 可以做类别无关分解或点提示,区域却没有稳定的语义身份。表 1 用四列能力对照这些方法,只有 PartLLM 四列都打勾。
作者认为这些任务的差别主要是意图怎么说、粒度要多细。同一物体在不同语义角度看,合法部件数并不固定。把它当成只有一个标准答案的判别任务,模型容易学到折中、发糊的边界。生成式接口可以按提示改变部件数,并且让后一个部件看见已经生成的部件。这是方法动机,不是实验本身已经证明所有歧义都被消除。
核心创新
- 把点选、文本接地和可控粒度的整件分解写成同一种自回归部件假设,异构标注可以混成同一套监督。
- 部件假设同时带开放词表名称和粗略三维框,名称不是掩码出来之后另接的标签。
- 解码器把部件和背景放进同一次互斥分配,避免每个查询独立sigmoid造成重叠边界。
方法概览
输入点云和用户意图。PointTransformerV3 提取全分辨率点特征,再采样 4096 个点投影进 Qwen3-VL-4B。模型按坐标顺序自回归写出 label、轴对齐三维框和 <|PART|>,响应以 <|BG|> 结束。这些隐藏状态组成动态查询,两层双向 Transformer 更新查询和点特征后,超网络为每个查询生成分类向量,每个点在部件和背景上做 softmax。语言侧用下一词损失,掩码侧用点级交叉熵,总损失是二者相加,掩码权重为 1。提示决定生成哪些部件:整件分割可用粗、细或大约 N 个部件;文本模式只生成被点名的部件;交互模式第一轮给一个三维点,后续轮把上一张掩码编成点颜色并给出包含或排除点。
- 输入是形状上采样的点云 P,以及一句用户意图 u。例如整件分割可以说 Please segment all parts。三维感知的多模态模型自回归生成假设序列 Y。每个假设 ys 是语义名 ls 加一个轴对齐框 bs,序列化成 label=Backrest, bbox=[…] 再接 <|PART|>。框是空间提示,不是最终掩码。 <|PART|> 的隐藏状态汇总名称、位置、意图、点云和此前部件。响应最后还有 <|BG|>,它不对应任何一个被写出的部件,而是当前假设集合的补集。
- 点云侧使用 PointTransformerV3,权重来自 Utonia。输入 81920 个点,点特征维度 1386。最远点采样保留 4096 个点,线性层把它们投到语言模型隐藏维,填进 <point_cloud> 位置。全分辨率特征留给解码器。语言模型是 Qwen3-VL-4B。
- 解码不用每个查询一张独立二值掩码。S 个 <|PART|> 隐藏状态加上 <|BG|> 组成查询 H。两层双向 Transformer 让查询和点特征互相注意,宽度 512,8 个头。每个更新后的查询经过超网络变成分类向量,与点特征做内积,得到 N 乘以 (S+1) 的对数。每个点在这些类别上 softmax。这样相邻部件必须竞争同一批点,边界由同一次分解决定。图 4 把这条路径和 SAM 式的逐查询 sigmoid 画在一起。
- 训练同时监督文本和分配。语言损失是目标响应的下一词对数似然,目标里包含部件名、框和两个特殊标记。掩码损失是点级交叉熵,真值类别按响应顺序编号,未覆盖点归到背景类。总损失是语言损失加上掩码损失,权重为 1。假设按框中心的 x、y、z 升序写出。训练时做随机三维旋转,框和点提示在旋转后的坐标系里生成。
- 三种任务共用同一响应格式。整件分割的提示可以是全部部件、主要部件、细节部件,或大约 n 个部件。层级数据里,最浅的有效分解当作粗,最深的当作细;其余数据按部件数切:最多 6 个为粗,7 到 12 为中,13 个及以上为细。文本模式的提示列出要切的名字,其余区域进 <|BG|>。交互的第一轮给出一个三维点;之后把上一张掩码画成点的颜色,再给一个包含或排除的修正点。
- 因为差别都在提示和目标响应里,不同标注可以混训。有语义的数据写入真实部件名;类别无关分解仍用同样格式,名字写成泛称 part。同一形状可以派生出不同粒度的整件样本、部件子集的文本样本,以及带可选修正轮的交互样本。作者把这看成扩展监督的方式:新数据靠提示设计接入,不必改结构和损失。48 张 H20 上端到端训练 5 个 epoch,AdamW 的动量为 0.9 和 0.95,权重衰减 0.02。编码器与语言模型学习率 1e-5,投影层 5e-5,解码器 1e-4。
逐图理解论文
自回归假设
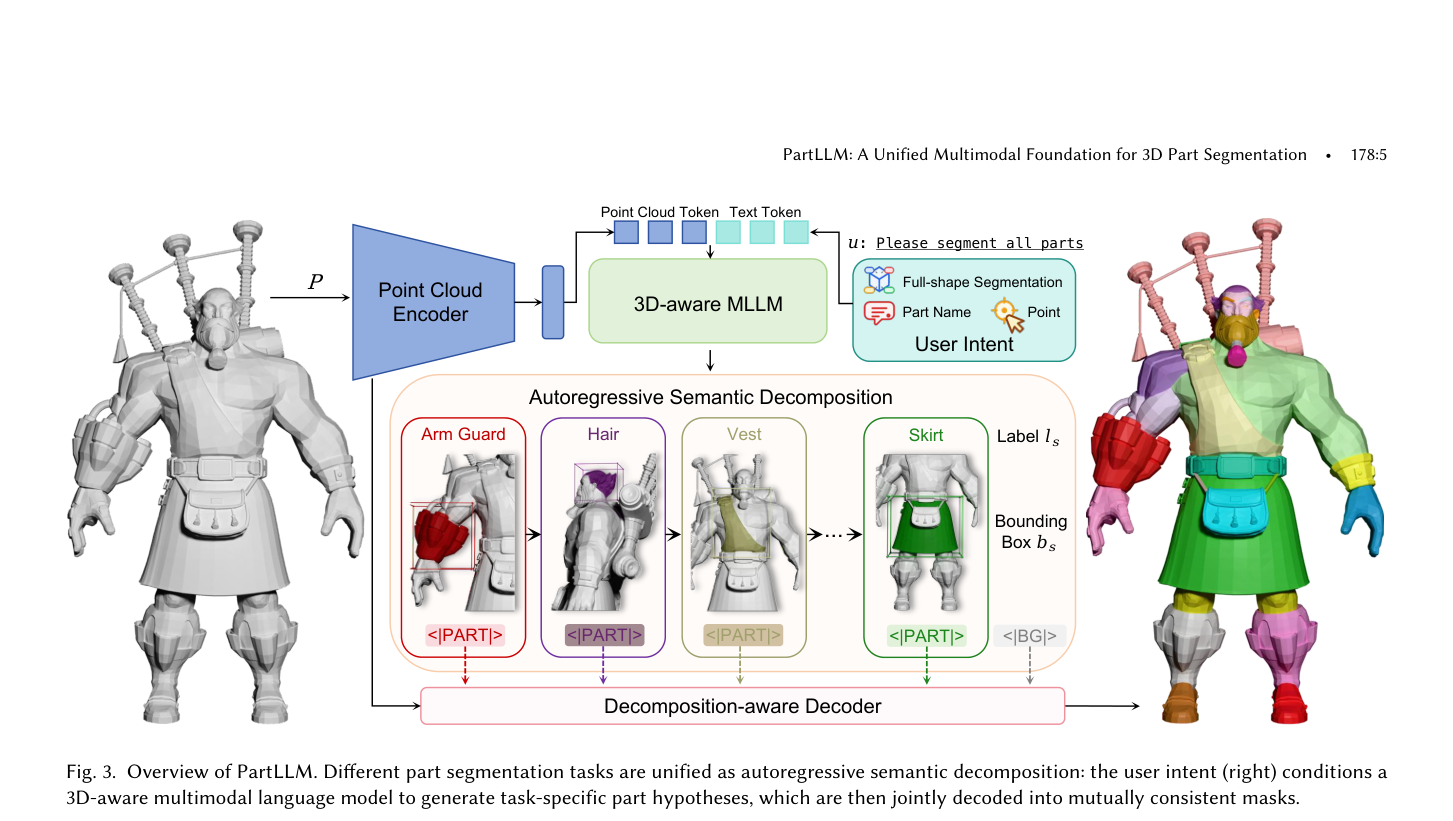
这是方法总图,页眉印着文章号 178:5。左侧灰模角色指向蓝色点云编码器,输出分成蓝色点云块和青色文本块,进入绿色的 3D-aware MLLM。右侧用户意图写着 Please segment all parts,并标了整件分割、部件名和点。下方四个彩色卡片依次是 Arm Guard、Hair、Vest、Skirt,每张卡片下有 <|PART|>,后面还有 <|BG|>。粉色长条是分解感知解码器,箭头同时来自部件卡片和编码器。用它看清假设先生成、掩码后联合解码。彩色角色是示意图,不是定量结果。
Fig
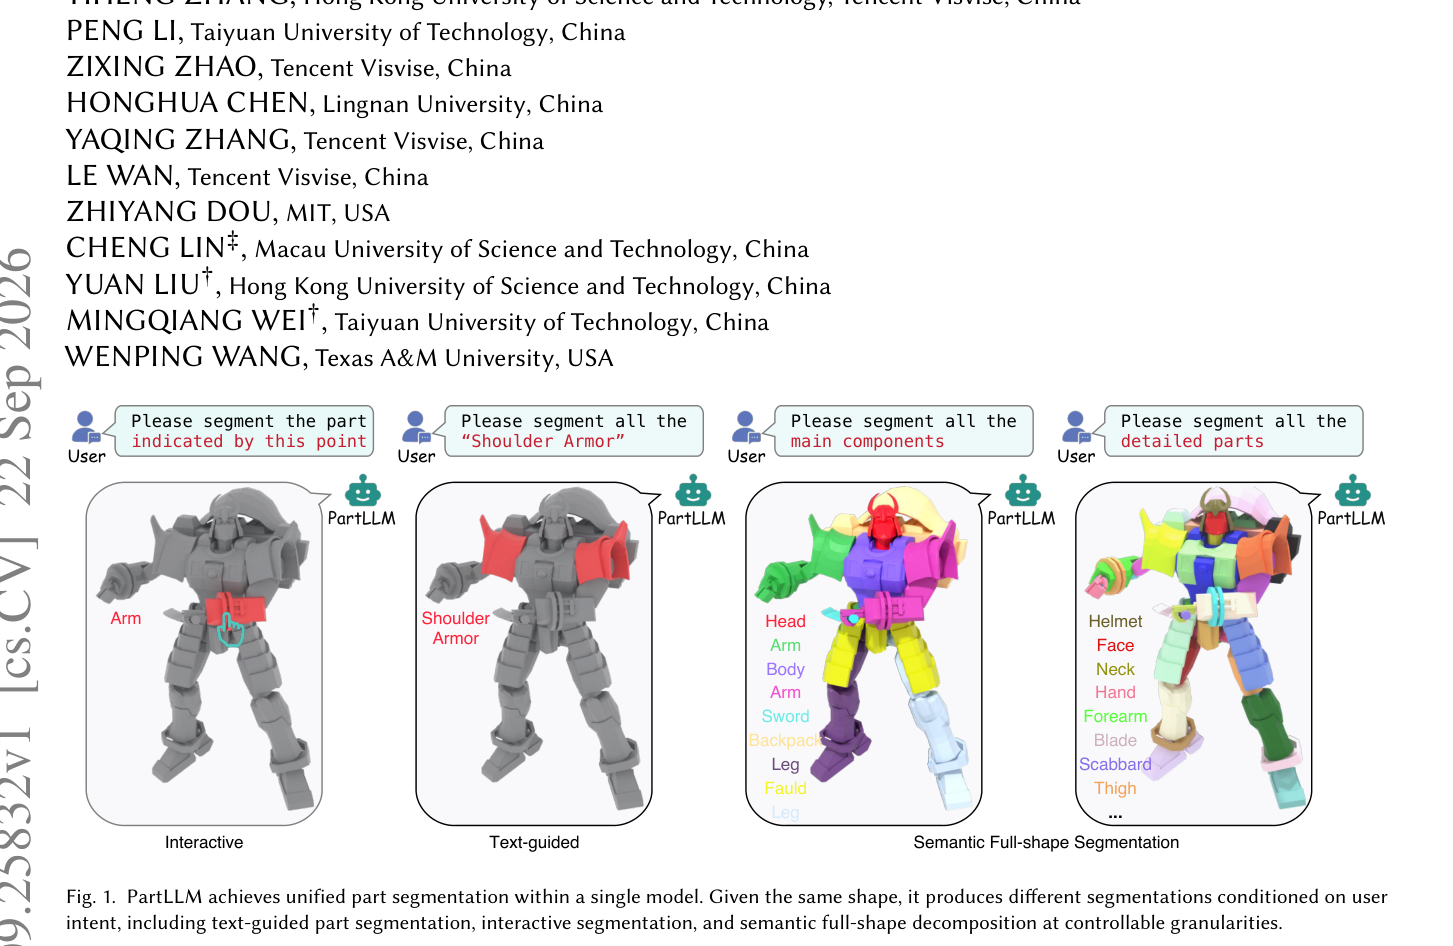
首页裁切上方是作者和单位,左侧有 arXiv 竖排日期。主体是同一个机器人的四格。第一格交互,提示指向一个点,高亮并标出 Arm。第二格文本,提示点名 Shoulder Armor,肩甲被涂红。后两格是整件分割:一格是 Head、Body、Sword、Backpack 这类主要部件,另一格拆到 Helmet、Face、Forearm、Scabbard、Thigh。用它理解同一形状会随提示改变粒度,不要把作者行当成图例。
Fig
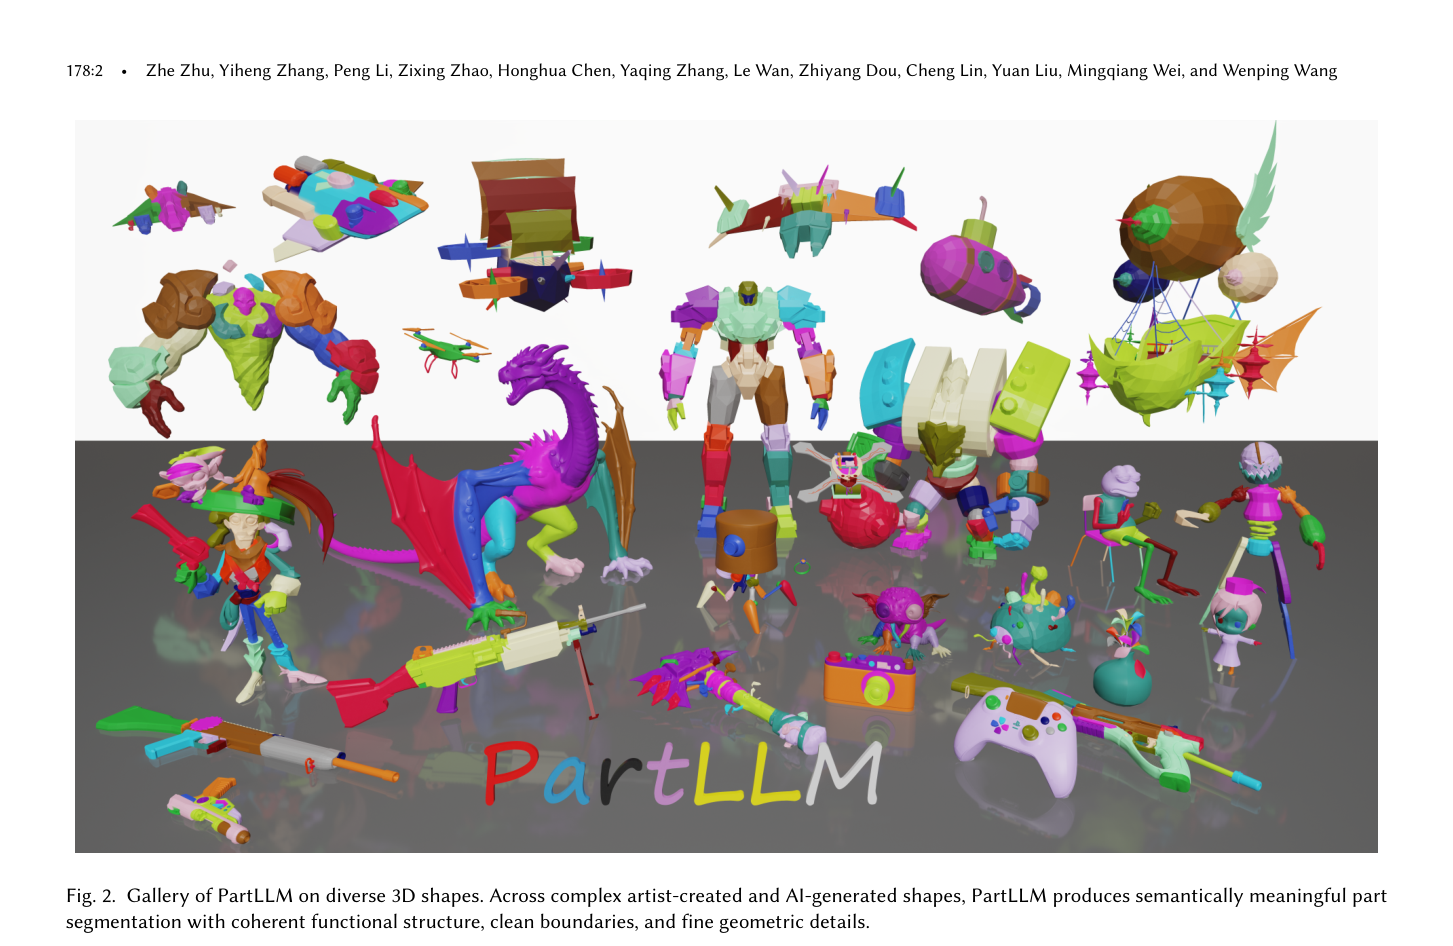
画廊图,上沿是 178:2 和作者姓名。灰色地面上排列着已经上色的部件分解:龙、机甲、飞艇或潜艇一类载具、枪械、手柄、相机和若干角色,地面有倒影。底部是拼色的 PartLLM 字样。图注说这些形状既有艺术家制作的,也有生成模型做出的,并强调功能结构、边界和细节。它展示覆盖面,不能代替表 3 到表 8 的数字。
实验如何设计?
- 语义数据来自 PartNeXt、3DCoMPaT200 和 PartVerse,再加上 75K 份授权三维资产,其部件名由多模态模型标注。类别无关几何来自 HY3D-Bench 的训练子集。合计 323K 个不重复形状、110 万条样本。75K 这一部分的标签质量论文没有单独量化。
- 评测形状全部留出。PartNeXt 用 500 个形状、50 个类别。3DCoMPaT200 约 2000 个形状、200 个类别,并有多级标注。HY3D-Bench 选 100 个形状,部件数大致均匀,最复杂的真值可达 50 块。类别无关整件分割还用 PartObjaverse-Tiny。文本引导另用 PartNet-E。真实扫描用 FAUST(标注来自 SATR 的人体扫描协议)和 AKBSeg(AKB-48 上的关节部件)。除特别说明外,指标是基于交并比的 mIoU。
- 类别无关协议跟随 PartField 和 PartSAM:每个方法产生多个粒度,每个真值部件在所有粒度里找交并比最高的预测,再取平均。PartLLM 使用表 2 的 general、coarse、fine 提示,固定随机种子,不用按数量控制的提示,因此测试时不知道真值部件数。PartField 的聚类数从 1 到 20。PartSAM 和 P3-SAM 调后处理得到三组掩码。SegviGen 没有显式粒度旋钮,用三个随机种子采三张结果。这套分数高于“用户只说一次”的操作点,读表时要记住匹配发生在多个候选之间。
- 语义整件分割没有现成的开放世界基线,因为对照要么没有名字,要么要求用户先给出名字。作者把 PartSAM 和 P3-SAM 的掩码渲染出来,再请 Qwen3-VL 为高亮区域起名,得到两阶段基线。SA-mIoU 在掩码交并比上乘一个语义匹配指示。匹配器是通过 OpenAI API 调用的 GPT-5.5,与 PartLLM 的骨干分开。提示要求只回答 yes 或 no:在给定物体类别下,预测名和真值名是否为等价部件名。
- 文本定量实验一次把全部真值部件名送给模型,再按类别平均 mIoU。交互实验报告每一轮之后的 mIoU。第一点采自真值掩码的中心区域,后面的点采自预测和真值不一致的区域。Point-SAM、PartSAM 和 SegviGen 有多轮数字;P3-SAM 和 S2AM3D 只给出一次点击。因此“七次点击领先 18.5”只在有多轮输出的方法之间比较。
关键结果与论文证据
- 表 3 是类别无关的整件分割。按列读,Ours 为 PartNeXt 56.7,3DCoMPaT200 粗 86.1、细 74.2,HY3D-Bench 68.3,PartObjaverse-Tiny 78.8。3DCoMPaT200 粗列里 SAMPart3D 为 51.6,86.1 减 51.6 等于正文所说的 34.5。细列里 PartSAM 为 42.2,74.2 减 42.2 等于 32.0。PartObjaverse-Tiny 上 PartSAM 已经有 69.5,Ours 是 78.8,差距小于 3DCoMPaT200。图 5 的四行示例里,对照列更容易把功能块并在一起、把一块拆碎,或漏掉烤面包机槽这类小结构;最右列带有部件名图例。图 6 是生成网格上的定性结果,没有对应的数值表。
- 表 4 把名字也算进去。PartNeXt 上,Ours 的 mask mIoU 56.7 降到 SA-mIoU 43.2;PartSAM+MLLM 从 37.2 降到 13.8,P3-SAM+MLLM 从 40.3 降到 18.3。3DCoMPaT200 粗粒度 Ours 为 86.1 对 71.9,细粒度 74.2 对 63.1。正文概括两阶段基线下降 17.5 到 23.6 个点,PartLLM 下降 11.1 到 14.2 个点。这支持“名字和掩码一起生成,语义惩罚更小”这一解读,但匹配器是 GPT-5.5,分数包含匹配器的判断,不只是几何重叠。
- 表 5 的文本引导,Ours 在 PartNet-E、PartNeXt、3DCoMPaT200 粗、细上为 50.1、78.7、86.1、80.0。CoSMo3D 为 17.6、37.9、48.8、26.1,所以 PartNeXt 的 78.7 减 37.9 为 40.8,粗细两列分别为加 37.3 和加 53.9,与正文一致。PartNet-E 上最接近的是 PatchAlign3D 的 41.4,Ours 的 50.1 仍更高,但不是四十个点的差距。图 8 里,未点名区域画成灰色,对应 <|BG|>。表 11 把一次查询一个名字和一次查询全部名字对比:PartNet-E 从 50.1 到 53.3,PartNeXt 从 78.7 到 77.0,粗从 86.1 到 87.4,细从 80.0 到 78.2。单部件查询并没有崩。
- 表 6 的交互结果里,Ours 每一轮都高于同格有数字的对照。3DCoMPaT200 的一次点击是 60.7,对照里 PartSAM 为 50.6,差 10.1,对上正文“最多 10.1”。HY3D-Bench 七次点击 Ours 为 77.1,SegviGen 为 58.6,差 18.5。一次点击已经能盖住较完整的部件,而不是只包住点击附近;这是作者对图 9 的解读。后续点使用了真值误差区,所以多轮增益不能直接当成真实用户点选的增益。
- 真实扫描上,表 7 的 FAUST 类别无关分割 Ours 为 72.2,PartSAM 为 55.3。表 8 的文本引导,FAUST 上 Ours 87.6,SATR 79.8;AKBSeg 上 Ours 54.8,PatchAlign3D 35.6。图 10 展示噪声、缺失表面和不规则扫描上的定性分解,没有另附一张误差表。
- 表 9 把设计拆开。换成独立二值掩码后,3DCoMPaT200-Fine 的文本和交互从 80.0、60.7 降到 76.2、57.5,整件 mask 和 SA-mIoU 从 74.2、63.1 降到 62.9、54.6。去掉粗框的伤害更大:文本降到 55.4,SA-mIoU 降到 38.1。去掉语义名后,文本降到 62.0,交互降到 53.8,语义列为空,因为没有名称可匹配。图 11 用定性例子说明独立解码的接缝更糊。
- 方向和采样没有把主结果推翻。表 10 里,随机三轴旋转后,PartObjaverse-Tiny 的整件 mIoU 从 78.8 到 78.3,HY3D-Bench 一次点击从 51.2 到 50.7。十个种子的均值和标准差是 78.5±2.2。把 main parts 说成 coarse structures、把 detailed parts 说成 fine-grained components,PartObjaverse-Tiny 为 76.2,默认模板为 78.8。表 12 显示数据是混在一起起作用的:从只有整件监督的 56.2/48.3,加文本到 62.7/58.5,加交互再到 67.2/61.8,最后加上无名字的几何分解达到 74.2/63.1,文本和交互分为 80.0 和 60.7。图 12 的曲线没有在正文里逐点读出,只能采用正文的定性说法:语义数据变多时三项都上升,再加入类别无关数据后,整件和交互升得更明显。
- 表 13 在单张 H20 上测 3DCoMPaT200-Fine 的整件分割。PartField 约 10 秒、mIoU 35.0,PartSAM 约 12 秒、42.2,P3-SAM 约 10 秒、40.3。PartLLM 随部件数增加:5 个部件 4.8 秒,10 个 7.1 秒,20 个 11.7 秒,30 个 16.3 秒,表内 mIoU 仍是 74.2,不是每个部件数各有一个精度。作者认为在中等部件数下速度可以和基线相比,同时精度更高;部件很多时延迟会继续随生成长度上升。
阅读时需要注意
- 图 14 和正文第 4.8 节给出的失败是类别混淆。几何本身像另一类物体时,分解可以内部自洽但语义先验是错的。路由器被当成床之后,会出现床的子结构。提示里补上物体类别,预测改回路由器主体和天线。作者据此认为还缺物体级上下文,并建议未来加入渲染图、多视角特征,或在出掩码前做思维链。这些都还没在本文实现。
- 最佳粒度匹配和误差区点击,都比真实使用更有信息。类别无关表不能读成“随便一句提示就有表中的 mIoU”。七次点击的领先也不能读成用户研究。SA-mIoU 还多一个外部名称匹配器。
- 75K 资产的名字来自多模态模型自动标注。如果标注把错误名字写进目标响应,模型会把这些名字和几何绑在一起。论文没有报告这批标注的人工核对比例。
- 编辑例子把预测掩码当成换材料和改几何的把手,图 13 用点击或文本 Wheel 选中部件。这是接口演示,没有编辑质量的定量评测。
- PDF 只给出项目页 https://czvvd.github.io/PartLLMPage/ 。没有独立代码仓库地址,不能把权重和训练脚本写成已经公开。
关联工作
- 封闭世界的 PointNet++、KPConv、DGCNN 和 Point Transformer 说明部件分割曾经就是点分类。PartLLM 保留点特征,但标签集改成当前这次生成出来的动态集合。
- 二维抬升路线,包括 SATR、PartSLIP 以及把 SAM 或 CLIP 特征投到三维的工作,带来开放词表,也带来渲染和逐形状处理。PartLLM 的前向不再为每个形状融合多视角掩码。真实扫描实验仍说明扫描噪声没有被完全消掉。
- SAM 式三维部件模型把查询当成独立二元决定。PartLLM 的论证是:要切什么已经由语言模型生成,解码器只负责把这组标签落到点上,所以可以用一次 softmax 把重叠消掉。表 9 里,独立掩码对少量被点名的目标掉得少,对整件分解掉得多,和这个论证方向一致。
- Part-X-MLLM 用程序描述部件级推理、生成和编辑。正文把它和 PartLLM 分开:程序输出仍然是符号的,不直接给出表面上的互斥掩码。二者不是同一项任务的对照实验。