快速导读:慕尼黑工业大学等机构在十二套二维医学图像上对照十类量化器,发现本基准内重建能预示生成、码本用满不等于潜空间丰富,且该结果不能外推为临床可用。
潜扩散已经成为医学图像生成的常用底座,而真正卡住上限的往往是前面的分词器:它把图像压成生成器所在的潜变量。Niklas Bubeck、Yundi Zhang、Vasiliki Sideri-Lampretsa、Julian McGinnis、Jiancheng Yang、Daniel Rueckert 与 Jiazhen Pan 来自慕尼黑工业大学、慕尼黑机器学习中心、埃利斯芬兰研究所、阿尔托大学和帝国理工。他们问的是一个迁移问题:自然图像上形成的分词器经验,到了更小、更重复的医学图像上还成不成立。论文是 arXiv:2609.24691 的预印本,尚未同行评审。
在他们自己的对照里,重建质量能够预示生成质量,这和自然图像上“重建不是生成的代理”相反;现代量化器可以把码本用得很满,潜变量却仍然塌在低维子空间里;训练记忆整体温和,压缩更强时更弱;离散化对多数家族的线性探测影响不大,无查找表的二值量化是主要例外。这些都是研究基准上的观察。本文没有做临床读片、没有报告诊疗结局,不能写成临床可用的分词器或诊断系统。
英文题目:What Makes a Good Medical Image Tokenizer? Rethinking Reconstruction and Generation in Medical Image Tokenization
论文出处:arXiv 每日论文精选 · arXiv:2609.24691
原始论文:PDF / 论文页面
这篇论文解决什么问题?
医学生成几乎都走连续潜变量上的扩散,自回归和离散 token 模型相对少,而且常常绑在特定任务上。分词器一旦把局部高频细节抹掉,后面的生成器只能在这个被压缩过的空间里采样。作者强调,自然图像的两条流行结论并没有在医学统计条件下被同样检验过。第一条是重建分数不能代表生成,生成更取决于潜空间里的全局语义和空间结构。第二条是码本利用率高、不塌缩,就说明潜空间有表达力,因而生成也会更好。
医学数据的统计不一样。集合更小,同一器官的图像共享大体布局,样本之间的差别常常是一小块病灶或纹理。可错的余量更窄。除此之外,合成图像若被指望减少真实患者数据的共享,就不能记住并吐出训练扫描;同一套压缩表示还会被拿去作分类、检索或多模态模型的输入。因此作者把重建、生成、几何、记忆和下游可分性放进同一协议,而不是只报 PSNR。
需要把“数据来自医学影像”和“系统已经可以临床使用”分开。论文使用 MedMNIST+ 的十二套二维图像,并在摘要里提到专家标注。实验测量的是分词器作为生成基底的行为。线性探测被作者明确写成更丰富临床任务的简化代理。下文所有数字都只描述这个基准。
核心创新
- 第一套面向医学图像分词器的对照基准:十类家族、三个压缩率、十二套数据,只改量化器。
- 多轴协议同时看重建、生成、潜空间几何、记忆和下游线性探测,用来检验自然图像假设是否成立。
- 生成统一在量化前连续潜变量上训练同一个扩散模型,避免离散词表大小干扰比较。
方法概览
所有分词器共用去掉自注意力的卷积 VQGAN 骨干、相同损失权重和训练日程,只换量化器和空间压缩因子 f∈{4,8,16},潜通道 d∈{3,4,8}。量化前连续潜变量 ze 经量化得到 zq,解码得重建。训练损失是 MSE、LPIPS、PatchGAN 对抗项和量化器自带的辅助损失。生成阶段冻结自编码器,在单位方差的 ze 上训练同一个 DiT-B/2,而不是在离散码上做自回归,以免码本大小本身惩罚某些家族。条件是扩散时间步、类别和数据集索引三者拼接后走 AdaLN-Zero。评测轴包括重建、生成、码本几何、线性探测和记忆。
- 共享骨干是去掉自注意力的卷积 VQGAN 编码器—量化器—解码器。作者去掉自注意力,是因为原骨干只在部分分辨率使用它,分辨率相关的全局混合会干扰跨压缩率的几何比较。于是每个压缩因子上的差异可以归到量化器。空间压缩 f 取 4、8、16,潜通道 d 取 3、4、8,所有量化器看到的潜变量形状一致。
- 离散家族覆盖硬量化 VQGAN、码本重参数化 SimVQ、把 QINCo 的隐式神经码本单独拿出来的 SimQINCo、残差量化 RQVAE、可微量化 DiVeQ 及其空间填充变体 SF-DiVeQ,以及无查找表的 LFQ 和 BSQ。连续基线是 AEKL,软量化基线是 SoftVQ。QINCo 原版在图像分词分辨率上太贵,所以 SimQINCo 只用一个小 MLP 把可学习坐标变成码本。
- 损失对所有分词器相同:像素 MSE、VGG-LPIPS、对 PatchGAN 的 hinge 对抗损失,再加上各量化器自己的承诺、熵或码本项。感知和对抗权重都是 0.01。AEKL 另有一个很小的 KL 项。感知损失在前 5 万步线性升温;对抗项先关闭 10 万步,再升温 5 万步,之后按梯度范数自适应缩放。为了小数据上的判别器稳定,作者加入可微颜色/平移/挖空增强、一致性正则和 LeCAM。
- 生成不在离散码 zq 上训练自回归 Transformer。那样做会把词表大小卷进生成分数,LFQ 的 2^d、残差量化的 K^L 和普通 VQ 的 K 没有公平的 softmax。作者冻结自编码器,把量化前的 ze 按训练集标准差缩放到单位方差,再训练一个 DiT-B/2。采样后仍可由冻结量化器把去噪结果吸到码本上。
- 条件有三个离散信号:扩散时间步、类别和来源数据集。三者各自嵌入后拼接,而不是像原版 DiT 那样把时间和类别相加,以免类别和数据集挤在同一个加性码里。每个块用 AdaLN-Zero 产生平移、缩放和门控,调制初始化为零,使每块从恒等映射起步。
- 码本几何用联合 t-SNE 看量化前潜变量和实际被选中的码字是否重合,并用失真除以码本使用熵作为 D/bit。记忆测试沿用近邻复现的思路:SSCD 负责拷贝检测,DINOv2 负责语义相似,只有两者都指向训练近邻才记为可疑。copy-rate 的阈值是该数据集测试图到训练图相似度的第 95 百分位,因此真实留出数据自己的基线大约是 0.05。
逐图理解论文
失败直觉
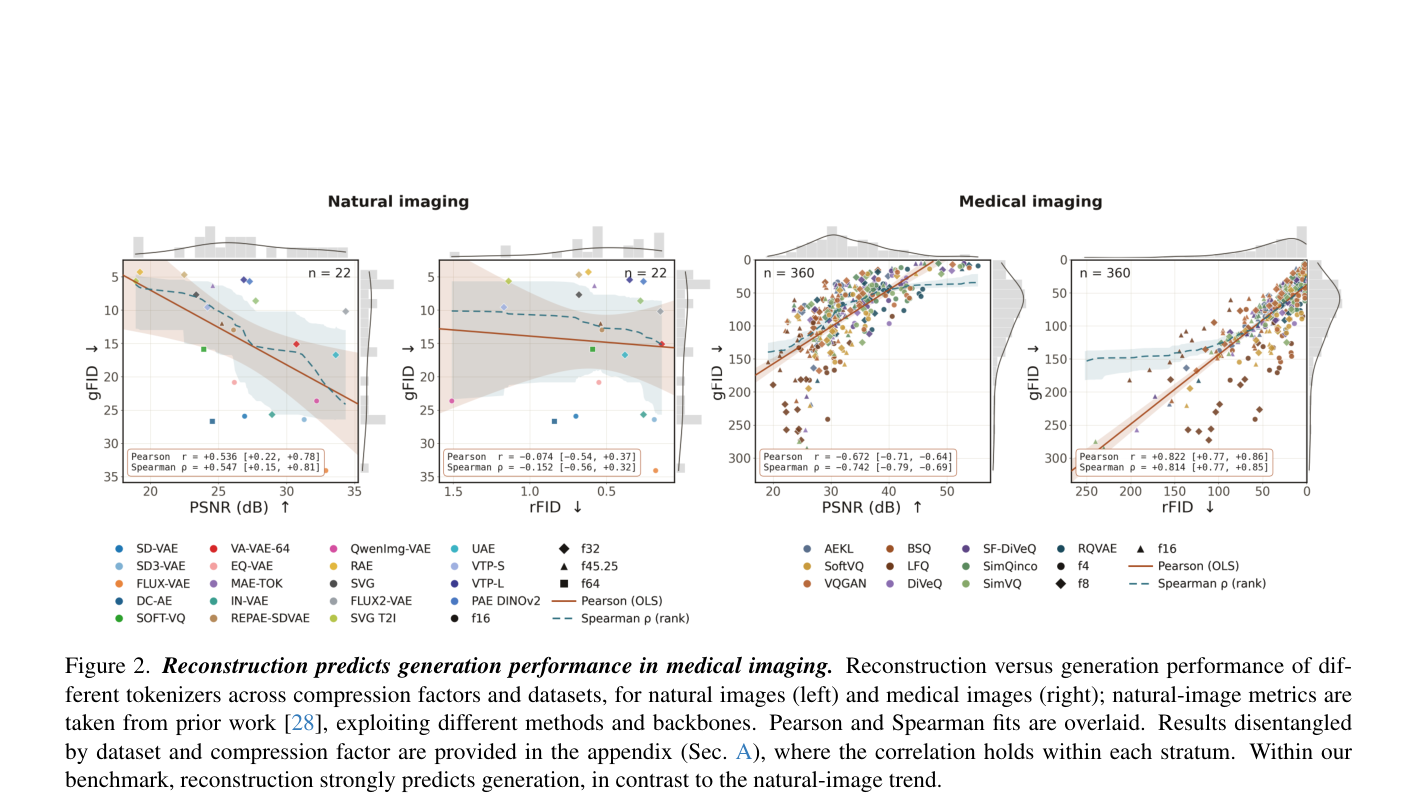
四幅散点,左边两幅是自然图像、n=22,右边两幅是医学图像、n=360。每幅都叠了 Pearson 实线和 Spearman 虚线,角上有相关系数和区间。先看右侧两幅是否同向:重建变好时生成距离变低;再看左侧 rFID 面板的拟合几乎平、区间跨过零。自然图像点来自先前工作,不能和右侧当成同一次训练。
核心结论
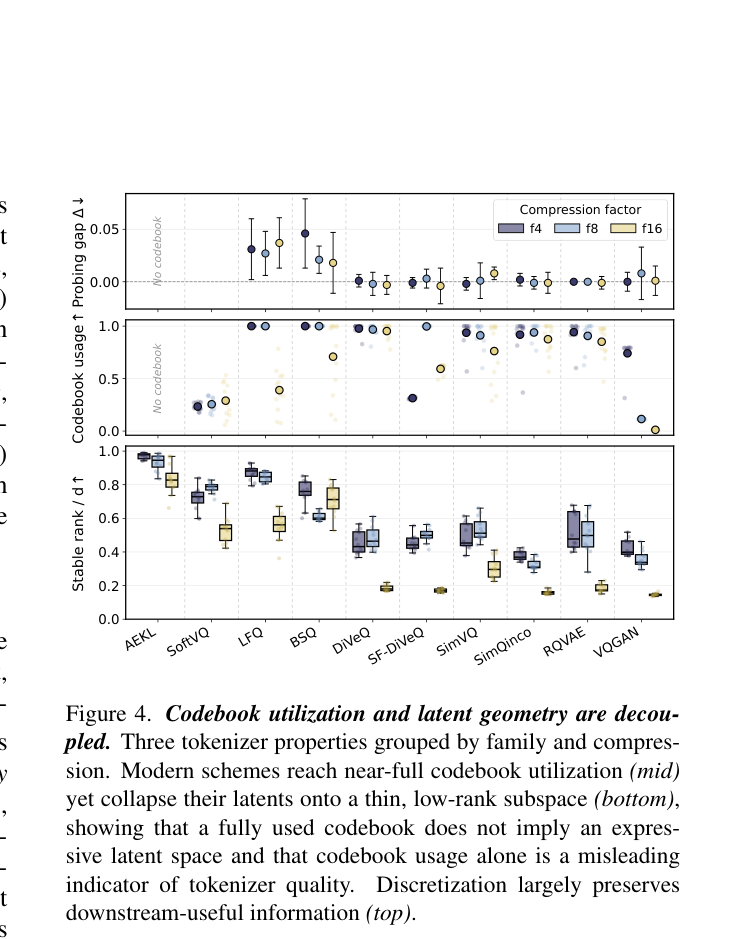
三行从上到下是线性探测差距、码本利用率和稳定秩,颜色区分 f=4、8、16。中行用来看谁把码本用满,底行用来看潜变量是不是变薄,顶行用来看离散化有没有伤到线性可分性。AEKL 与 SoftVQ 标了没有码本。图左侧有正文残字,不要把残字当成额外坐标。
Figure 1
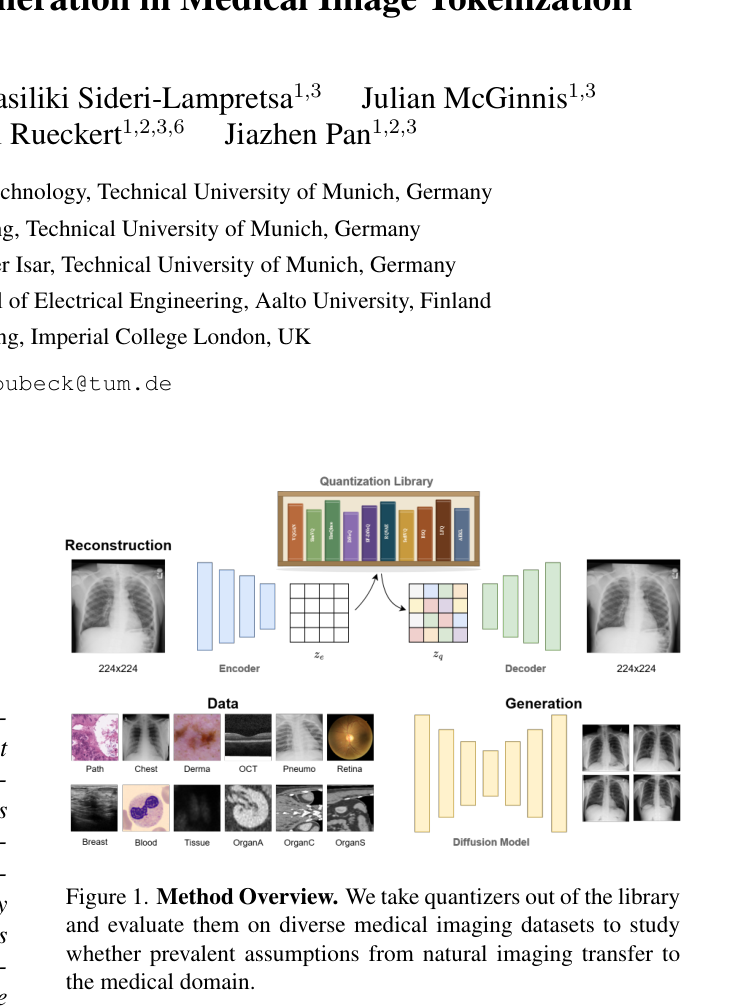
裁切上沿残留论文标题和作者单位,主体是方法示意图。上方是一排彩色量化器,像从库里抽出来替换。中间一行是胸片从 224×224 进入编码器,变成网格 ze,再量化成彩色 zq,经解码器回到胸片。下方左侧是十二套数据的缩略图,右侧是扩散模型生成的胸片。用它理解实验在替换哪一个模块,不要把它读成临床流程或产品界面。
实验如何设计?
- 数据是 MedMNIST+ 的十二套原生 224×224 图像:Path、Chest、Derma、OCT、Pneumonia、Retina、Breast、Blood、Tissue、OrganA、OrganC、OrganS。论文写超过 70 万张,涵盖多类、多标签和有序标签。压缩率和家族交叉后,作者称超过六十个训练好的模型;摘要则概括为十个模型家族、十二套数据、三个压缩因子、三十种配置的系统评测。
- 重建在测试图上编码再解码,用 torch-fidelity 计算相对真值的 rFID,并报 PSNR、SSIM、LPIPS。生成则每套分词器配同一个 DiT 配方:100 个采样步、线性噪声日程。Table 1 按压缩因子汇总十二套数据的中心趋势,Fréchet Medical Distance 用中位数,因为各数据集样本量可以从几百到几万,且特征提取器并不共享。
- 相关分析把所有配置放在一起算 Pearson 和 Spearman,并用 B=10000 的百分位 bootstrap 给 95% 区间。附录按数据集和压缩因子拆开,检查相关是不是混合造成的假象。自然图像散点不是他们重训的,而是取自先前工作,面板样本量为 22,骨干也不统一。
- 下游探测是在冻结的 ze 与 zq 上训练线性分类器,差距定义为两者指标之差,用来隔离量化这一步,而不是编码器本身的容量。记忆实验对每个(分词器,数据集)配置嵌入全部生成图,并用来自测试集的近邻作参照。
关键结果与论文证据
- 重建与生成在这套医学基准里同向。正文给出 rFID 与 gFID 的 Pearson r=0.82,区间 [0.77, 0.86],360 对观察,Spearman ρ=0.81 [0.77, 0.85]。Fig. 2 右下医学 rFID 面板的图中注释约为 +0.822 与 +0.814,与正文一致。PSNR 越高、gFID 越低,所以医学 PSNR 面板的 Pearson 为负,图中约 -0.672。附录称这一关系在每个数据集、每个压缩因子内部仍然成立。
- 自然图像面板呈现相反或很弱的关系,而且不能当成同一实验。左半 n=22,指标来自先前工作的不同方法和骨干。图中 rFID 与 gFID 的 Pearson 约为 -0.074,区间跨过零;PSNR 与 gFID 反而有一条约 +0.536 的正相关。作者用这组对照说明:不能把“重建无助于判断生成”直接搬进他们的医学设定。
- Table 1 在 f=4 上,残差量化 RQVAE 的跨数据集 PSNR/SSIM/rFID 为 41.3 / 0.963 / 7.0,VQGAN 为 40.0 / 0.953 / 9.4,SimQINCo 为 40.1 / 0.953 / 9.5。无查找表的 LFQ 只有 29.4 / 0.860 / 40.1,gFID 141.9;BSQ 的 gFID 为 104.5。生成最好的 f=4 格子并不总是重建最好的那一格:DiVeQ 的 gFID 48.1、gFMD 中位数 11.5,VQGAN 的 gFID 50.5 但 gFMD 26.4。读表时要同时看重建距离和生成距离。
- 压缩加重后差距更明显。f=8 时 RQVAE 仍以 PSNR 37.1、rFID 19.0、gFID 55.5 居于离散方法前列;f=16 时它是 PSNR 34.2、rFID 38.2、gFID 70.5,LFQ 掉到 PSNR 23.2、rFID 148.0。作者在结论里把 RQVAE 写成算力与性能上较稳妥的第一步,同时承认它的低 D/bit 部分来自更高的码率,不是免费的。
- 码本用满和潜空间是否贴合数据,是两件不同的事。Fig. 3 在 f=8 把十二套测试潜变量和被选中的码字画在一起,红叉落在点云上才算对齐。图上 D/bit:RQVAE 5.632e-09,DiVeQ 2.469e-06,VQ 约 1.198e-05,而 LFQ 0.0167、BSQ 0.7358,高出几个数量级。正文解释:普通 VQ 是少量码字挤在最密的区域,其余码不用;LFQ/BSQ 利用率接近全满,但码字铺在流形外面,所以利用率好看、量化误差仍然大。SimQINCo 比 SimVQ 更均匀地盖住十二套数据。
- Fig. 4 把同一现象拆成三行。中行码本利用率上,LFQ 和 BSQ 接近 1,VQGAN 在更强压缩时掉到很低,AEKL 与 SoftVQ 没有离散码本。底行稳定秩显示,许多现代量化器把潜变量压到更薄的子空间,f=16 往往更低;AEKL 的稳定秩最高。顶行线性探测差距对大多数家族接近零。正文说显式码本、残差和可微量化的 ze 与 zq 差距在统计上与零不可区分,LFQ/BSQ 则有大约 0.02 到 0.05 的稳定差距,而且这不是因为它们秩低——它们的秩反而是最高的,损失来自硬的标量量化网格。
- 记忆温和,且主要由压缩和数据重复性决定,不是由某一个量化品牌决定。Fig. 5 印出的均值:SSCD copy-rate 在 f=4/8/16 约为 0.007、0.005、0.004,DINOv2 约为 0.016、0.005、0.002,都低于图中的真实数据基线虚线;正文说总体均值远低于由第 95 百分位构造的约 0.05 基线。最近邻距离比在 SSCD 上约 0.90,DINOv2 上约 0.82 到 0.84,低于“没有唯一匹配”的 1.0 线。Path 和 OCT 的例外被归因于数据本身更重复,而不是某个分词器特别会泄密。压缩越强越难记住样本,也越会丢掉细节。这不是隐私合规结论,更不是临床安全性结论。
阅读时需要注意
- 二维、224 分辨率的 MedMNIST+ 不能代表高分辨率放射体积或医院工作流。论文把三维和高分辨率列为未做的部分。
- 只用一个 DiT-B/2,生成分数反映的是连续潜变量好不好用,不反映离散码序列能不能被自回归模型学好,也不反映换一个更大生成器后的排序。
- 线性探针不是检测、分割或报告生成。作者写明它只是更复杂任务的代理。因此“离散化大体保留可分信息”不能改写成临床任务不受损。
- 自然图像对照的样本来源、骨干和指标实现都与右半不同。左半的弱相关用来挑战迁移叙事,不能当成作者复现了那些自然图像模型。
- 开源承诺发生在论文被接收之后。当前正文没有给出可点击核验的代码地址,权重也不能假定已经公开。
关联工作
- VAE、VQ-VAE 和 VQGAN 解释了为什么会有码本,也解释了直通估计为什么会带来有偏梯度。软量化、旋转技巧和 DiVeQ 都是在这条梯度问题上改前向或改反传。
- FSQ、LFQ、BSQ 用构造消除塌缩。本文的反例是:不塌缩的码本仍然可以不落在数据上,D/bit 会把这件事暴露出来。
- SimVQ 用线性层重参数化码本,QINCo 用网络生成码字。SimQINCo 是为了在图像分辨率上只测试“隐式码本”这一件事。残差量化则是套在任何基量化器外面的容量插件。
- 潜扩散和 DiT 提供了共享生成器。作者刻意不比较谁更会训练一个巨大的像素扩散模型,只比较分词器留下的 ze 是否适合同一个生成配方。