快速导读:宾夕法尼亚大学用现成视觉语言模型和视觉几何模型,把单张室内图分成房间、物体和分层摆放,在 Front3D 的表 1 上各项都优于列出的对照;这是尚未同行评审的预印本。
单张室内照片要变成可编辑的三维场景,难在被挡住的部分和物体之间的关系同时都欠定。Shufan Sun、Chen Wang、Enxin Song、Jiatao Gu 与 Lingjie Liu 来自宾夕法尼亚大学,前两位为共同一作。HARMONY 不新训一个重建网络,而是让视觉语言模型按层级摆放物体,再用点云和剪影把位置收到和输入图更一致。论文是 arXiv:2609.26793 的预印本,2026 年 9 月 22 日的 v1,尚未同行评审。
流程从空房间和相机标定开始,依次处理墙面附着物、独立家具和放在家具上的摆件,每层都渲染出来对照原图。Front3D 的表 1 里,作者的方法在列出的感知和几何指标上都优于同表对照,贡献列表因此使用了 state-of-the-art。这个比较包含若干评测配置上的不对称,下文分开说明。项目页可以打开;附录提到模板会随代码发布,但没有可核验的独立仓库,开源状态待核验。
英文题目:HARMONY: Hierarchical Agentic Reasoning for Monocular Image-to-Scene Synthesis
论文出处:arXiv 每日论文精选 · arXiv:2609.26793
原始论文:PDF / 论文页面
这篇论文解决什么问题?
组合式场景重建最近有两条路。智能体路线能说出物体靠哪面墙、面向谁、放在谁上面,但语言本身给不出精确的米制位置,检索式场景也往往只覆盖简单物体。视觉几何模型能从单张图预测稠密点图,小物体、遮挡和朝向仍然不稳。作者要的是两者一起用:关系靠推理,尺度和深度靠几何。
只靠感知信号拼装的方法,包括 Gen3DSR、3D-RE-GEN、CAST 以及直接扩散整场的 MIDI、SceneGen,常常在遮挡和朝向上出错,例如椅子应该面向桌子的哪一边。文本条件的 SceneSmith 可以规划从靠墙物体到家具的顺序,但场景来自资产检索。Holodeck、SAGE、VIGA 把图像接回布局,却受视觉语言模型不擅长精确数值这一限制。VIGA 主要批判最终渲染,对单个物体缺少直接的几何目标。
单目照片还看不到物体背面,近处的物体会被镜头裁掉。因此任何方法都会在补全和摆放之间做假设。HARMONY 把假设写进分层顺序和返工,而不是声称单张图已经唯一确定场景。应用方向在引言里包括增强现实内容、具身导航和场景编辑;正文实验测量的是渲染相似度和 Front3D 上的几何距离,不是机器人任务成功率。
核心创新
- 单张室内图被拆成墙面、家具、摆件的分层推理,而不是一次预测整场布局。
- 视觉语言模型负责靠墙、支撑、朝向和配对,点云和剪影再修正尺度与深度。
- 每个阶段都有渲染对照原图的返工,用来减少错误传到下一层。
方法概览
HARMONY 不训练新网络,把现成模型串成六段:房间和相机、墙面物体、家具、天花物体、摆件、光照。视觉语言模型先估计房间尺寸和最深可见墙角,VGGT 点云拟合曼哈顿三轴,再用房间高度求出相似变换,把相机标定到规范房间。物体按墙面、家具、摆件分层检测,LocateAnything 出框,SAM2 出掩码,Gemini 做遮挡补全,Hunyuan3D-2 出网格,PCA 扶正后由视觉语言模型选正面。摆放从墙角向外做深度优先,先写语义关系,再用剪影确定横向位置和尺度深度比,用点云前表面修正深度,从而确定米制尺度。碰撞取较小的分离位移,消不掉就改顺序。每阶段渲染后对照原图返工。最后为物体指定 PBR 材料,并为灯和窗估计发光,用 Blender Cycles 重打光。
- 附录写明没有任何组件被训练或微调。表 4 的分工是:gpt-5.5 负责场景、布局和光照推理;Gemini-Flash-2.5 负责遮挡补全和外观;Hunyuan3D-2 在本地把图像变成网格;VGGT 提供曼哈顿对齐;LocateAnything 出开放词表框;SAM2 出实例掩码;Blender Cycles 做物理渲染。两个被提示的模型可以走 API 或本地服务,流程不变。
- 房间阶段先由视觉语言模型根据图像里的尺度线索给出近似尺寸,例如卧室可以是数米见方,并指出最深的可见墙角;若看不到墙角,就用最远的墙端点。这个角被对应到规范房间网格的一条竖边,房间高度是这条边两端的距离。模型再给可见墙相对这个角标左、后、右。
- 几何阶段用 VGGT 的点云、相机外参和焦距。表面法向做奇异值聚类,得到宽、竖直、深三个正交轴。六个包围平面沿这些轴做直方图,并与法向对齐。最深地面角是地面和两面墙的交点,天花板角在它正上方。相似变换包含旋转、统一尺度和平移。尺度只用房间高度除以 VGGT 坐标系里这条竖边的长度。平移把地面角钉到规范墙角。相机中心和旋转再用这个相似变换写回规范坐标系。附录把实现常数固定为行带比例 0.2、法向阈值 0.7、地面天花分位 98、墙面分位 97,所有场景共用。
- 物体按层检测:墙面的画和窗,地面或天花的家具和灯,以及放在家具上的摆件。视觉语言模型先列类别和个数,LocateAnything 出框,SAM2 出掩码,再去掉重复和误检,并把摆件挂到支撑它的家具上。每个物体由视觉语言模型结合周围场景写描述,Gemini 补全被挡住的区域,例如半张桌子要补成整张。补全结果若在类别、完整性和形状上对不上,就带上材料和颜色提示重来。
- 网格来自 Hunyuan3D-2。附录使用八叉树分辨率 384、25 步扩散和 8 万面,而不是快速预览的 128、5 步和 4 万面。补全图继承原图透视,网格姿态并不规范。顶点做主成分分析,把主轴扶到世界上方向。视觉语言模型看四个偏航角的渲染,选出正面,供后来摆椅子面向桌子这类关系使用。墙面上的窗、门、画和镜子还会先把倾斜四边形拉成正对矩形再建模,架子、壁灯和电视不做这一步。
- 摆放仍是三层,每层都有返工。视觉语言模型把最深墙角当成房间最远处,先沿两面相邻墙放靠近墙角的物体,再向外放到靠近相机的物体。作者把这称为深度优先:新物体加入时,已经放好的物体都在它后面,渲染里更少被挡住。每个物体有位置、统一尺度,以及由关系决定的偏航。关系被写成短句,例如沙发背靠左墙、花瓶在桌上、椅子面向小茶几。模型再用渲染和原图做小幅旋转。摆件要核对放在哪件家具上;若两张边桌太像,就用包围盒重叠把摆件改挂到重叠最大的宿主。
- 语义位置只是近似的。图像空间里,渲染剪影的中心和宽度去对齐分割掩码。水平偏移按当前深度和焦距折算成横向平移。没有被标成严重遮挡的物体,还用视角大小约束尺度与深度的比值,因为剪影分不清物体是更近还是更大。深度空间里,VGGT 点云和渲染场景都用该物体的掩码切开,取前表面的稳健均值,沿视线修正深度,再把视角大小和修正后的深度合成米制尺度。碰撞时比较移动甲或移动乙的最小分离位移,采用更短的那一个;一组都分不开时,请视觉语言模型改摆放顺序。
- 每层计划执行完,就把当前三维场景的渲染和原图一起送回模型,检查尺度、朝向和放错的物体,并让成套的椅子共用尺寸。摆件阶段还会数一数有没有漏实例,漏了就复用同类型网格或重新生成。光照阶段不依赖图像到三维模型烘焙的底色:模型按类别猜主要 PBR 材料,例如玻璃桌的透射,再估计灯和窗的开关、颜色和强度。反射环把 Cycles 渲染和原图比较后再改这些参数。导出前的中间渲染用 pyrender 和平坦环境光。
逐图理解论文
两条旧路线
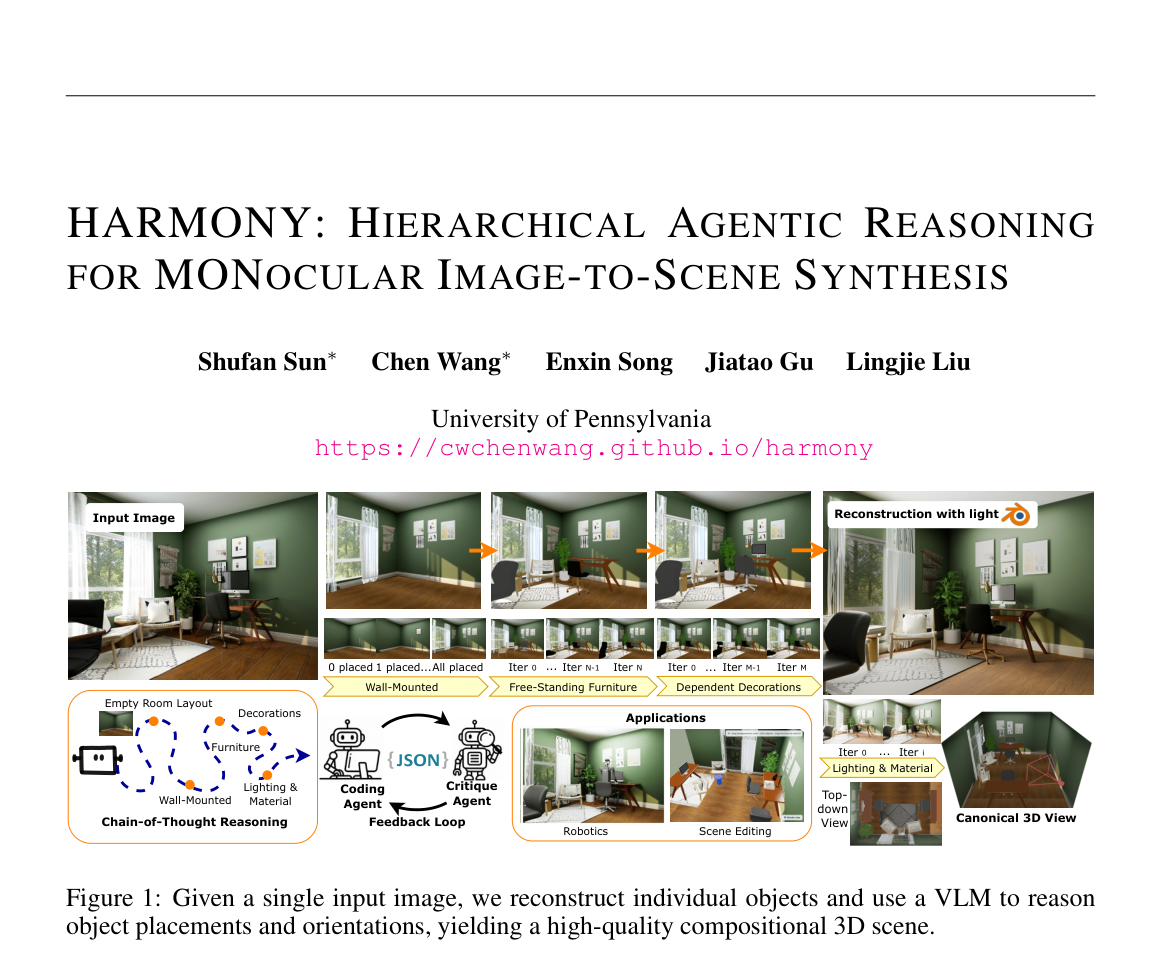
上方是论文标题、五位作者、宾夕法尼亚大学和品红色的项目页地址。中部左侧是绿色书房的 Input Image,橙色箭头连到几张逐步放进家具的渲染,再到带 Blender 标志的 Reconstruction with light。箭头下方标着 Wall-Mounted、Free-Standing Furniture、Dependent Decorations,以及 0 placed、1 placed、All placed 和多轮 Iter。底部左框是空房间、墙面、家具、摆件、光照的思维链;中框是 Coding Agent 和 Critique Agent 围绕 JSON 的反馈环;右框是 Robotics 和 Scene Editing 两张应用小图,旁边还有俯视图和红色坐标轴的规范三维视图。它是总览,不是对照实验。
分层摆放
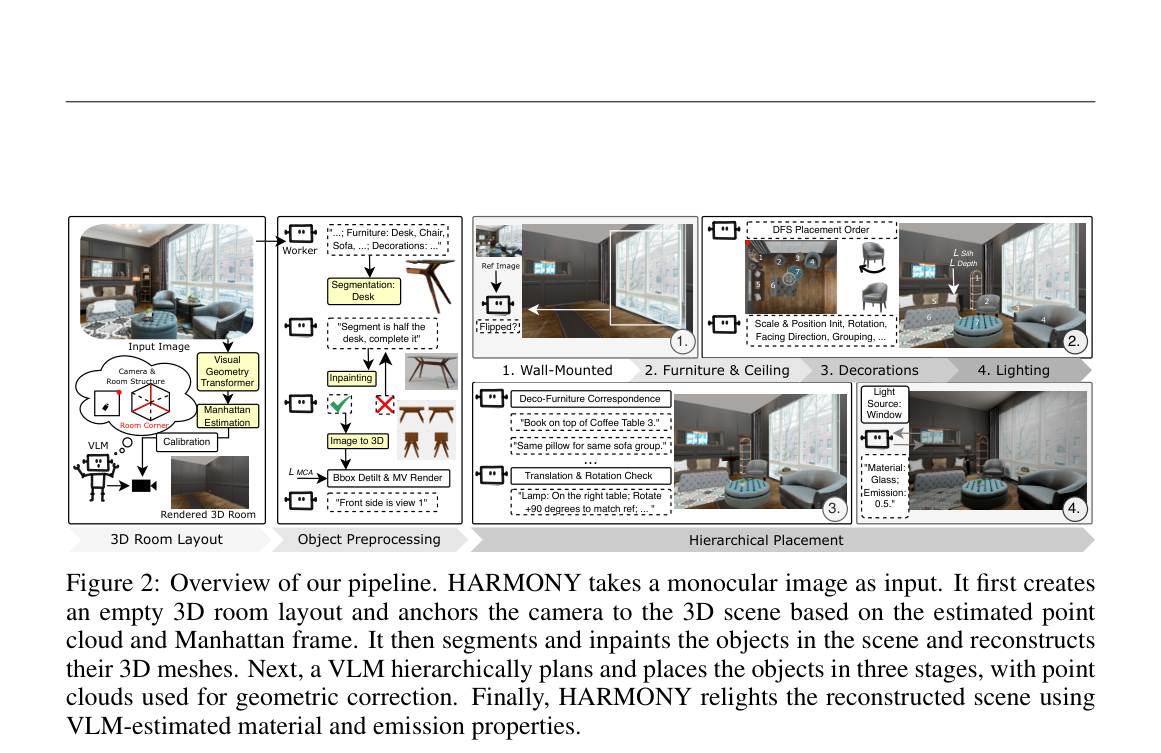
管线从左到右四段。最左是输入的室内照片,云朵里写着相机和房间结构,下面有视觉语言模型、视觉几何 Transformer、曼哈顿估计、标定和渲染出的空房间。第二段是物体预处理:工人列出家具和摆件,分割出桌子,补全时有对勾和叉,以及图像到三维、包围盒扶正和多视角渲染,旁边有半张桌子补成整桌的小图。第三段是分层摆放,底部灰条分成 Wall-Mounted、Furniture & Ceiling、Decorations、Lighting。图内能看到深度优先的数字顺序、是否翻转、尺度和朝向、摆件与家具的对应句子,以及平移旋转检查。最右是光照,写着光源为窗,材料玻璃、发射 0.5。用它理解先房间、再物体、再分层、最后打光。0.5 是示意图里的例子,不是表 1 的分数。
Front3D 表
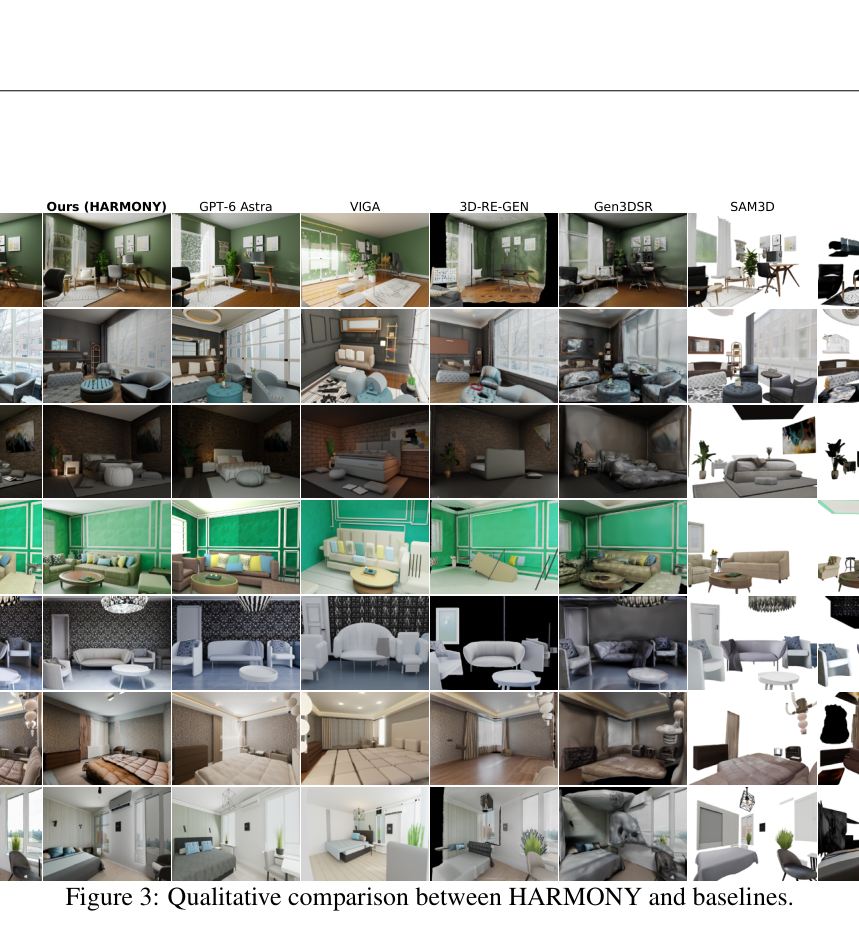
定性对照网格。列标题为 Ours (HARMONY)、GPT-6 Astra、VIGA、3D-RE-GEN、Gen3DSR、SAM3D。大约七行,覆盖书房、客厅、卧室等室内图,右缘有裁切。HARMONY 列保留窗户、墙面和成套家具;Gen3DSR 列更暗、更糊,物体轮廓粘连;SAM3D 列更多是白底上的碎块和单个家具,背景不完整;中间几列有缺失的小物体、歪斜的沙发或简化的墙。图注只写 HARMONY 与基线的定性比较,没有在格子里印 N-CLIP。SAM3D 列要记住实验使用了 HARMONY 的掩码,CAST 没有单独一列。
局限
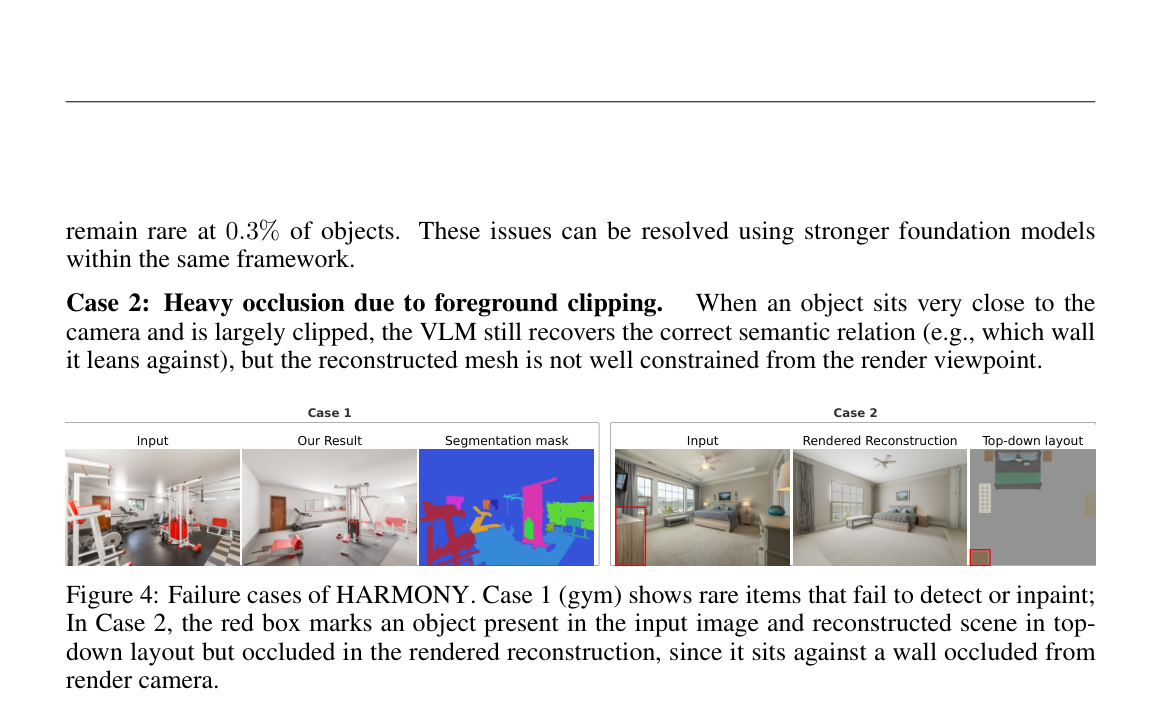
图上方残留正文,能读到 remain rare at 0.3% of objects,以及案例 2 的说明:物体贴镜头被裁切时,语义关系还在,网格却缺少约束。下方左半是 Case 1 健身房,三格为 Input、Our Result、Segmentation mask。分割掩码是蓝、青、品红等色块,器械区域有明显漏检或黏连。右半是 Case 2 卧室:输入图左侧有红框,中间是渲染重建,右侧俯视平面图里也有一个小红框。图注说明红框物体在输入和俯视里存在,在渲染相机里被墙挡住。0.3% 来自上方正文,不是图中的刻度。
实验如何设计?
- Front3D 使用 100 张带三维真值的渲染,文中也称 Front100。HARMONY30 是 30 张真实、作者标明可自由使用的室内图,布局、风格和光照不同。HARMONY300 把场景扩到 300 张,其中包含这 30 张评测图,正文说全流程都跑过。主表没有 300 张的平均分,所以下文的数字只来自表 1、表 2 和表 3。
- 渲染质量沿用 VIGA 的做法,从输入视角渲染再和参考图比。N-CLIP 定义为 1 减去 CLIP-ViT-B/32 嵌入的余弦相似度,越小越接近。PL 是归一化到 0 到 1 的 RGB 上的逐像素均方误差。协议文字还提到 LPIPS,但表 1 和表 2 的列是 N-CLIP、PL,以及 Front3D 上的倒角距离和 F-score 在 0.1、0.01、0.001 三个阈值。没有印出来的 LPIPS 不在这里引用。
- 基线是 Gen3DSR、3D-RE-GEN、CAST、SAM3D 和同期的 VIGA,能用官方检查点的都用官方。SAM3D 在整图上变差,实验改用 HARMONY 的逐物体掩码,记为 SAM3D*。CAST 没有官方发布,使用的非官方实现写在脚注的 GitHub 地址,那不是 HARMONY 的仓库。CAST 和 SAM3D 不重建背景,感知指标里补的是 HARMONY 的背景。因此表 1 的“每一列最好”是在这个配置下、相对这些行而言。
- 用户研究有 16 名参与者、20 个场景,参与者给方法和五个基线排名。报告平均名次及标准差、排第一的比例和进入前二的比例。表 2 里 GPT-6 Astra 有感知分,名次是空的,说明这组成绩没有把 GPT-6 Astra 放进同一排名。
- 消融在表 3,逐项去掉剪影修正、相机标定、检测规范化、反馈环、视觉语言推理、深度优先和摆放顺序。表 3 完整方法的 N-CLIP 是 0.1034、PL 是 0.0462,表 1 是 0.092 和 0.041。正文没有写表 3 用的是不是同一百张图。下文只把它当成组件之间的相对比较。硬件写在附录:NVIDIA L40,每张 46 GB。一个场景 20 到 90 分钟,随物体数和接口延迟变化,平均每个被摆物体 3.4 次视觉语言模型调用。作者称从照片到带光照的 glb 不需要逐场景手工干预。
关键结果与论文证据
- 表 1 上 Ours 的六项是 N-CLIP 0.092、PL 0.041、倒角距离 0.049、F@0.1 为 89.82、F@0.01 为 19.47、F@0.001 为 0.130。同表第二名并不总是同一个方法。N-CLIP 上 GPT-6 Astra 为 0.095,只差 0.003。PL 上 Gen3DSR 为 0.043,略高于 0.041。倒角距离上 CAST 为 0.052,GPT-6 Astra 为 0.061,比 Ours 的 0.049 更差。F@0.1 上 CAST 为 85.70,Ours 为 89.82。正文说在所评配置下 GPT-6 Astra 看起来像,但几何误差更大,例如床可能不贴墙。这句话是作者对表和定性结果的解释,不是一张单独的贴墙误差表。
- 其余行的 N-CLIP 更高,也就是在这个 CLIP 度量上更远:SAM3D* 0.127,CAST 0.149,3D-RE-GEN 0.163,Gen3DSR 0.168,VIGA 0.179。F@0.001 都很低,Ours 也只有 0.130,说明厘米以下的表面重合仍然有限。读 F-score 时要连阈值一起看,不能只引用 89.82。
- 表 2 的 30 张真实图上,Ours 的 N-CLIP 0.112、PL 0.045,仍是该表最低。GPT-6 Astra 为 0.127 和 0.047。Gen3DSR 的 PL 是 0.049,接近 Ours,但 N-CLIP 是 0.213。3D-RE-GEN 的 N-CLIP 0.154 好于若干基线,PL 为 0.053。用户研究里 Ours 平均名次 1.54,标准差 0.93,67.0% 的选择排第一,86.0% 进入前二。SAM3D* 的 Top-1 是 13.7%,Gen3DSR 是 11.3%,VIGA 是 0.7%,CAST 是 3.3%,3D-RE-GEN 是 4.0%。名次只覆盖这 20 个场景和这 16 个人,而且没有 GPT-6 Astra。
- 图 3 是定性网格,列名从左到右为 Ours (HARMONY)、GPT-6 Astra、VIGA、3D-RE-GEN、Gen3DSR、SAM3D,大约七行室内场景。正文对列的解释是:Gen3DSR 大致保留房间,但几何和纹理发糊,邻近物体容易粘在一起;3D-RE-GEN 能放主要家具,朝向、尺度和小摆件经常不对,还会出现悬空;VIGA 依赖对最终渲染的批判,单个物体缺少剪影和深度目标;SAM3D 在整图输入时碎裂,实验里又额外用了 HARMONY 的掩码;CAST 同样受分割和位姿影响。这些是作者对图 3 的阅读,不是每一格都有一个分数。
- 表 3 里,去掉相机标定的 N-CLIP 从 0.1034 升到 0.1381,PL 从 0.0462 升到 0.0596,是表中最大的感知退步。去掉反馈环时 N-CLIP 升到 0.1184,PL 为 0.0509。去掉视觉语言摆放推理为 0.1079 / 0.0522,去掉深度优先遍历为 0.1045 / 0.0523,去掉 VGGT 修正为 0.1069 / 0.0509,去掉摆放顺序为 0.1065 / 0.0477,去掉摆放修正为 0.1051 / 0.0516。正文认为剪影和标定主要保住感知相似度,反馈环和推理主要保住语义,深度优先用来减少遮挡和挂错。因为表 3 的起点不是表 1 的 0.092,不能把 0.1381 减 0.1034 说成表 1 会变差多少。
- 失败写在第 4.5 节。稀有物体上,视觉语言模型和检测器的词可能对不上:25.9% 的检测接地置信度低于 0.35。去掉路由和去重之后,真正摆放失败约占物体的 0.3%。作者认为换更强的基础模型可以在同一框架里缓解,这是预期,不是已经替换后的新表。贴镜头且大部分被裁掉时,模型仍可能说出物体靠哪面墙,但网格从渲染视角得不到足够约束。图 4 的案例 2 用红框标出输入和俯视布局里都在、渲染里却被墙挡住的物体。正文开头说有三类常见失败,抽出的段落和图 4 只展开了这两类。
阅读时需要注意
- 这是预印本,尚未同行评审。表 1 的优势建立在 SAM3D 使用 HARMONY 掩码、CAST 使用非官方代码、以及两者感知分补上 HARMONY 背景的配置上。换一种背景或不提供掩码,排序可能改变,论文没有给出那组对照。
- GPT-6 Astra 在 N-CLIP 上和 HARMONY 非常接近,几何指标更差,用户研究又没有给它名次。不能把 67% 的第一名说成也赢过了这个系统。
- F@0.001 只有 0.130,细几何并没有和真值表面重合。倒角距离 0.049 是在 Front3D 的合成真值上,真实图像没有几何真值,表 2 只有感知分和排名。
- 运行依赖 gpt-5.5 和 Gemini 的接口以及本地 Hunyuan3D、VGGT、SAM2。20 到 90 分钟一张图,不适合当成交互式重建。平均 3.4 次调用是每个物体,不是每个场景。
- 当前不做多视角,也不推断抽屉、门这类关节。结论把这两项列为未来工作。稀有类别和近景裁切仍然会失败。第三类失败没有在图 4 的说明里出现,不宜编造。
- 附录说完整提示模板随代码发布。PDF 中的项目页是 https://cwchenwang.github.io/harmony ,没有 HARMONY 自己的仓库 URL。在核到仓库之前,应写成待核验,而不是已经开源。
关联工作
- 单物体图像到三维,从 3DShape2VecSet、CLAY、TRELLIS 到 Hunyuan3D、TripoSG 和 SAM3D,解决的是一块网格的几何和外观。HARMONY 把 Hunyuan3D-2 当作每件物体的生成器,场景关系不由这个生成器决定。
- 几何拼装路线用分割、点云和逐物体姿态优化补上布局。3D-RE-GEN 还有背景和四自由度对齐,CAST 用场景解析加有符号距离的物理修正。HARMONY 保留点云修正,但把顺序和朝向交给分层推理。
- 智能体场景生成里,SceneSmith 从文本规划层级,Holodeck 输出约束交给求解器,VIGA 在 Blender 里迭代。HARMONY 的差别是每放一个物体就用剪影和深度写回数值,并在进入下一层之前返工。
- GPT-6 Astra 出现在表和图 3 里,论文没有把它的内部结构写成方法的一部分。它是外部系统的对照。感知分接近,说明仅靠渲染相似度不容易把两者拉开,几何表和用户研究才提供额外差别。