快速导读:哈尔滨工业大学(深圳)与新加坡国立大学的 QuantWM 在不训练的前提下,用敏感聚类和主子空间补偿减轻 2-bit Key 量化造成的注意力错位,从而在压低键值缓存的同时改善帧级画面。
世界模型和长视频要按块往后生成,历史 Key、Value 会堆成数 GB 到二十多 GB 的缓存。把缓存压到 2 bit 能省显存,可是石桥、人物和树冠会闪、会糊。哈尔滨工业大学(深圳)与新加坡国立大学的预印本 QuantWM(arXiv:2609.26425)认为,问题主要不在 Value 的重构误差,而在 Key 的小扰动改写了 QK⊤,让 Query 选错历史帧或空间位置。
方法不重训模型,并且只用已经生成过的 Query 统计,以保持因果。QSAC 按通道敏感度和残差动态范围挑选 INT2 友好的 Key 质心;PSAC 把剩下的误差补在能量最高的 8 个 Query 方向上。作者在五类自回归视频或世界模型上报告帧级指标优于 QVG,KV cache 最高约 6.20 倍压缩。摘要里的“几乎无损”指的是既有方法在 VBench 上的分数,不是对画面质量的独立复核。项目页可访问,独立代码仓库待核验。论文仍处于预印本、页眉标着 Under Review。
英文题目:QuantWM: Temporally Consistent 2-bit KV Cache Quantization for World Models and Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.26425
原始论文:PDF / 论文页面
这篇论文解决什么问题?
因果和自回归视频生成把历史键值存下来,新的一块只做注意力,而不把整段历史重算一遍。时空 token 很多,缓存就会主导显存。第1页举的例子是 LingBot-World-v2 生成约 93 帧、5 秒视频需要 21GB 以上键值缓存,内存紧张的设备很难部署。
量化把高精度张量换成低比特。语言模型里 KIVI、KVQuant 等已经把 KV cache 压到 2 bit 甚至更低。QVG 把这套思路接到自回归视频,用 K-means 质心保留 BF16、残差做低比特,并在 VBench 一类榜单上给出接近原模型的分数。第2页作者把这种现象称为 nearly lossless video performance,同时说这些方法忽略了时间闪烁和视觉退化。
Figure 1 把两件事放在一起:HY-World-1.5 的 VBench 柱读数是 BF16 81.74%、QVG 81.27%、本文 81.73%,橙框写着 Nearly lossless Video scores;下方绿框则写 Temporal flickering 与 visual degradation,并给 QVG 的桥面放大图打了差评表情。因此“几乎无损”在原文里是对榜单的描述。同一页的放大图被作者用来证明榜单没有把发糊和闪烁记全。后文不应把这句话升级成已经交叉验证的画面结论。
作者接着把 Key 和 Value 拆开。Figure 2 里只量化 Value 的 K16V2 仍接近 BF16,只量化 Key 的 K2V16 在卡通行出现闪烁、在场景行出现发糊,K2V2 与 K2V16 同类。式 (5) 写出注意力 logits 是 QK⊤ 除以根号维度,Key 误差会直接进入 logits,从而改变 top-1 时空 token。Figure 3 用同一 Query 在量化前后选中的帧号和块坐标说明这种换位,例如 HY-World 从第 8 帧位置 (7,11) 换到第 12 帧 (8,11)。
核心创新
- 指出 2-bit 视频键值量化在 VBench 接近原模型时,仍会出现闪烁和发糊,并把主因追溯到 Key 改变了时空 token 选择。
- 用 QSAC 按 Query 敏感度和残差量化难度选 Key 质心,而不是只按 K-means 距离。
- 用 PSAC 在前 8 个 Query 主方向上补偿剩余 Key 误差,保持严格因果且不重训模型。
方法概览
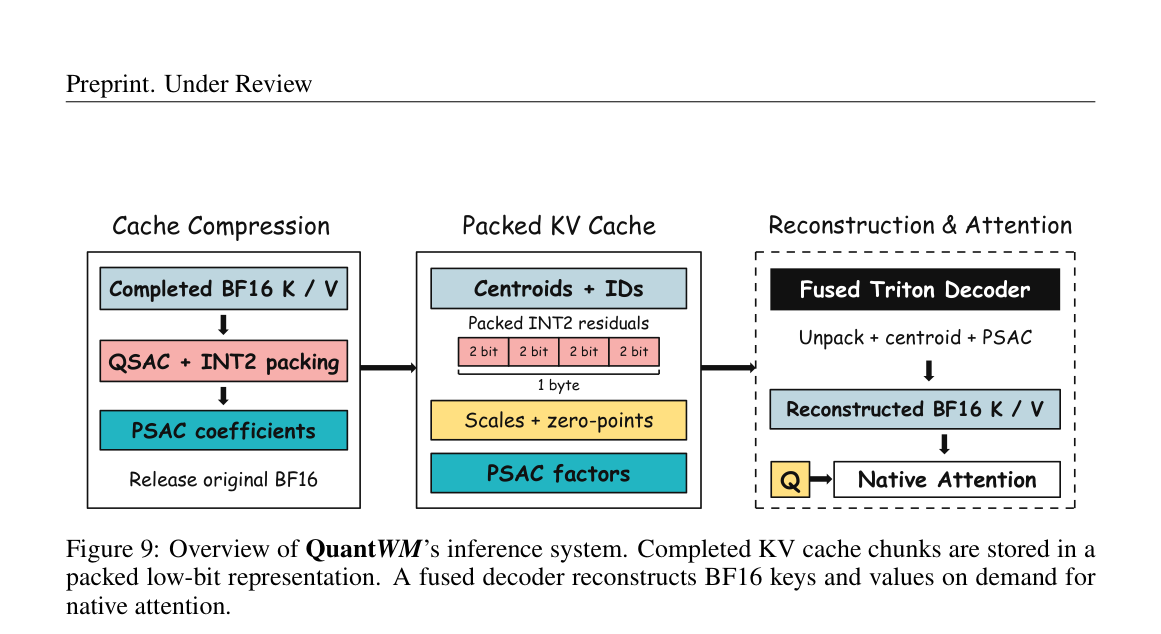
QuantWM 沿用 QVG 的质心—残差存储,质心保持 BF16,残差做 INT2,组大小 64,共 256 个质心,每个缓存块只在建好后量化一次。QSAC 用此前 Query 的对角二阶统计估计通道敏感度,先按加权距离取前 M 个候选质心,再用残差组的动态范围估计对注意力 logits 的期望扰动并选最小者。PSAC 对同一统计做特征分解,保留前 r=8 个主方向,把剩余 Key 误差投影成低秩系数 C(存成 INT8),推理时加回 logits。首块没有历史 Query,敏感度取均匀、PSAC 暂不启用。
- 存储格式沿用 QVG。每个 Key token 先归到一个质心,残差是 token 减质心;质心留在 BF16,残差做 b 比特均匀量化后再加回去。本文使用 256 个质心、组大小 64,残差为标准 INT2。缓存按流式分块,每个块建好后只量化一次。实验在 NVIDIA A800 80GB 上用 PyTorch 和自定义 Triton 核完成(第7页)。
- QSAC 不再只按欧氏距离找最近质心。对每个注意力头,系统累积此前所有 Query 的外积,得到二阶矩阵。Key 误差引起的期望平方 logits 扰动正好是误差向量对该矩阵的二次型。为了省计算,作者只用对角元,也就是各通道历史 Query 平方的平均,并归一化成权重 wh,c。加权距离先筛出前 M 个候选质心。每个候选再按组计算残差的最大值减最小值,用均匀量化的误差方差近似,乘上该组的敏感度权重,得到 QSAC 分数,取得分最低的质心(第5–6页式 6 至式 14)。默认 M=4。
- 2 bit 之后仍有误差,所以 PSAC 直接补 logits。剩余误差 E 等于原始 Key 减去 QSAC 反量化结果。对二阶矩阵做特征分解后,大特征值方向上的误差更影响注意力。实现保留前 r=8 个特征向量 Ur,系数 C 等于 E 乘 Ur。推理时反量化 Key 加上 C Ur 转置,等价于在 logits 上多加一项 Q Ur C 转置。Ur 以 BF16 保存,C 量化到 INT8。Figure 4 在 LingBot-v2 第 38 层标出前 8 个方向累积了 71.14% 的 Query 能量,正文说各模型上前 8 个方向通常超过总能量的 60%(第6–7页)。
- 因果性靠冷启动策略维持。第一个缓存块没有历史 Query,QSAC 把通道权重设为 1,只按残差的量化难度选质心;PSAC 先关闭。当前块量化完成后,它的 Query 才进入统计,供后续块使用。作者强调不需要额外校准集或手工热身(第16页)。
- 附录比较了几个开关。HY-World 1.5 上,对角近似的 PSNR 18.4485、耗时 118.75 秒,完整矩阵为 18.3827 与 123.10 秒,对角并没有更差。候选数 M 从 1 到 256,M=4 的 PSNR 为 18.4485;把 256 个质心都评一遍是 18.4450,耗时 240.66 秒,没有额外质量收益。秩从 8 增到 16,HY-World 的 PSNR 从 18.4485 到 18.5368,相对 r=8 多 0.1341 bit(第16–18页)。
逐图理解论文
失败直觉
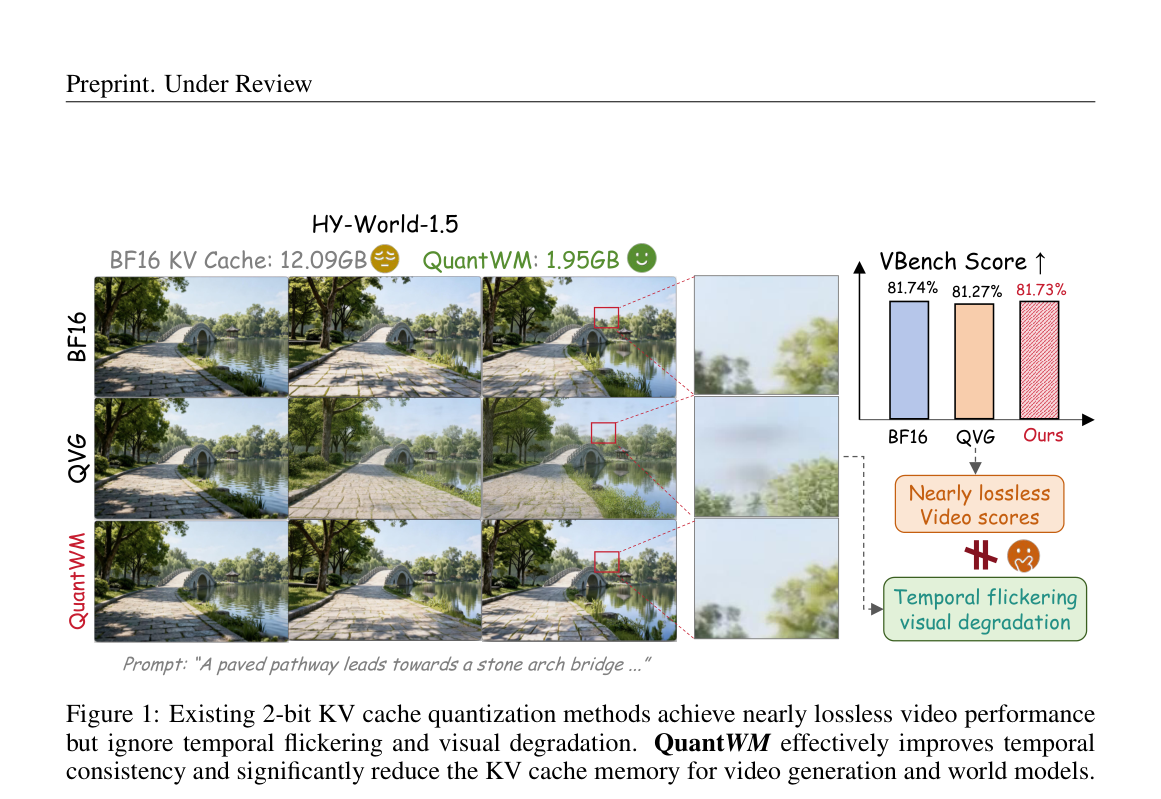
第2页 Figure 1,页眉为 Preprint. Under Review。左侧是 HY-World-1.5 的石拱桥小路,提示语写着一条铺装小路通向石拱桥。三行分别标 BF16、QVG、QuantWM。每行三格,第三格上有红框,虚线拉到更糊或更清的局部放大。上方文字是 BF16 KV Cache: 12.09GB,以及绿色的 QuantWM: 1.95GB。右侧柱状图标题 VBench Score,三根柱读数为 81.74%、81.27%、81.73%,对应 BF16、QVG、Ours。柱下橙框写 Nearly lossless Video scores,并有一个被划掉的差评表情;绿框写 Temporal flickering visual degradation。这张图同时展示了作者对榜单的说法和他们认为榜单漏掉的闪烁。81.73% 是作者绘制的 VBench 平均分,不是独立实验室的复核。
研究缺口
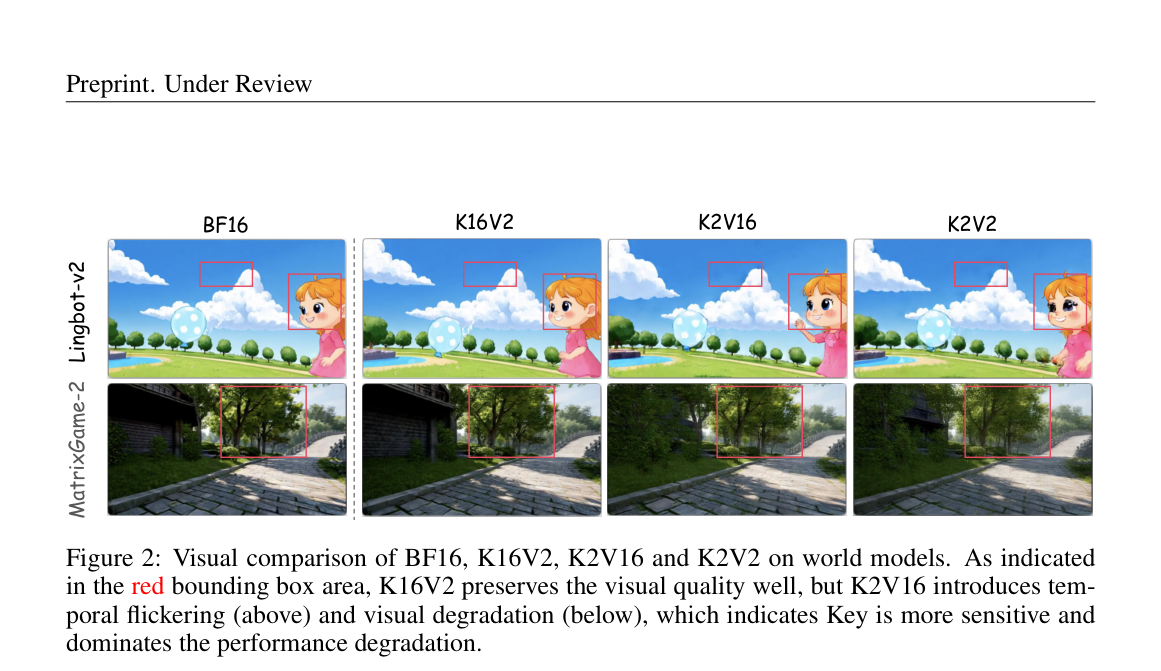
第3页 Figure 2,页眉同样是 Preprint. Under Review。四列标题为 BF16、K16V2、K2V16、K2V2。上排 Lingbot-v2 是草地、蓝天和抱着浅蓝波点气球的卡通女孩,红框分别套在云朵和面部附近。下排 MatrixGame-2 是林间小路和左侧木屋,红框套在树冠或路面。图注用红框说明:K16V2 仍保住画质,K2V16 在上排引入时间闪烁、在下排引入视觉退化,因此 Key 更敏感。单张静帧只能看出清晰度和结构差,闪烁本身要靠多帧才能确认,图注把上排红框解释为闪烁。表 2 的 PSNR 不印在这张图里。
实验观察
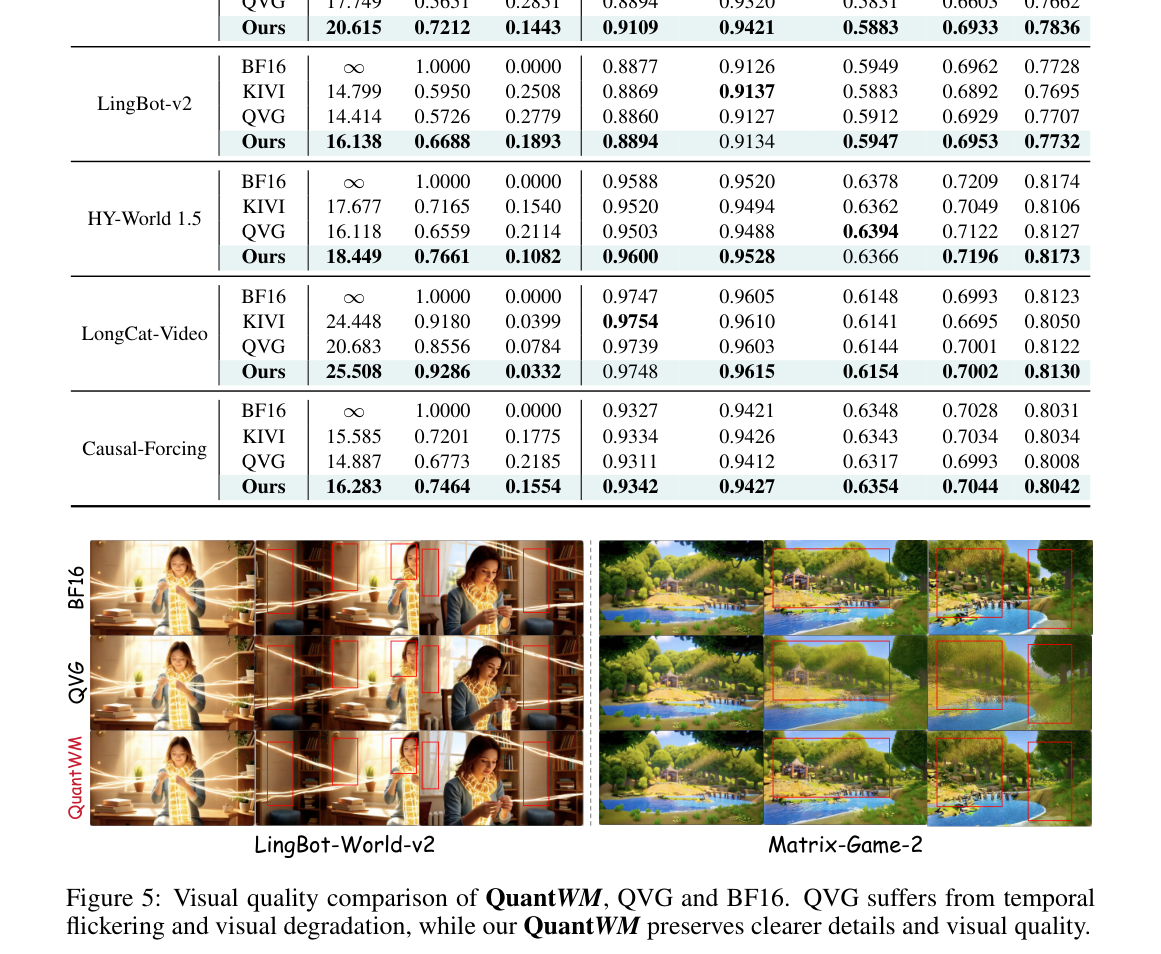
第8页裁图的上半是 Table 3 的后半截,能看到 LingBot-v2、HY-World 1.5、LongCat-Video、Causal-Forcing 的 BF16、KIVI、QVG、Ours 行。可读例子包括 LingBot-v2 的 Ours 为 16.138、0.6688、0.1893,HY-World 的 Ours 为 18.449、0.7661、0.1082,LongCat 的 Ours 为 25.508、0.9286、0.0332,以及 HY-World 的 VBench 平均 0.8174、0.8106、0.8127、0.8173。下半才是 Figure 5。左组 LingBot-World-v2 是室内编织、黄色围巾和光线条纹的女性,右组 Matrix-Game-2 是卡通河边、树林和小桥。两行三列的行名是 BF16、QVG、QuantWM,红框标在手部、围巾、树和建筑上。图注称 QVG 有闪烁和退化,QuantWM 保住更清楚的细节。红框是作者标记,不是检测框。
核心结论
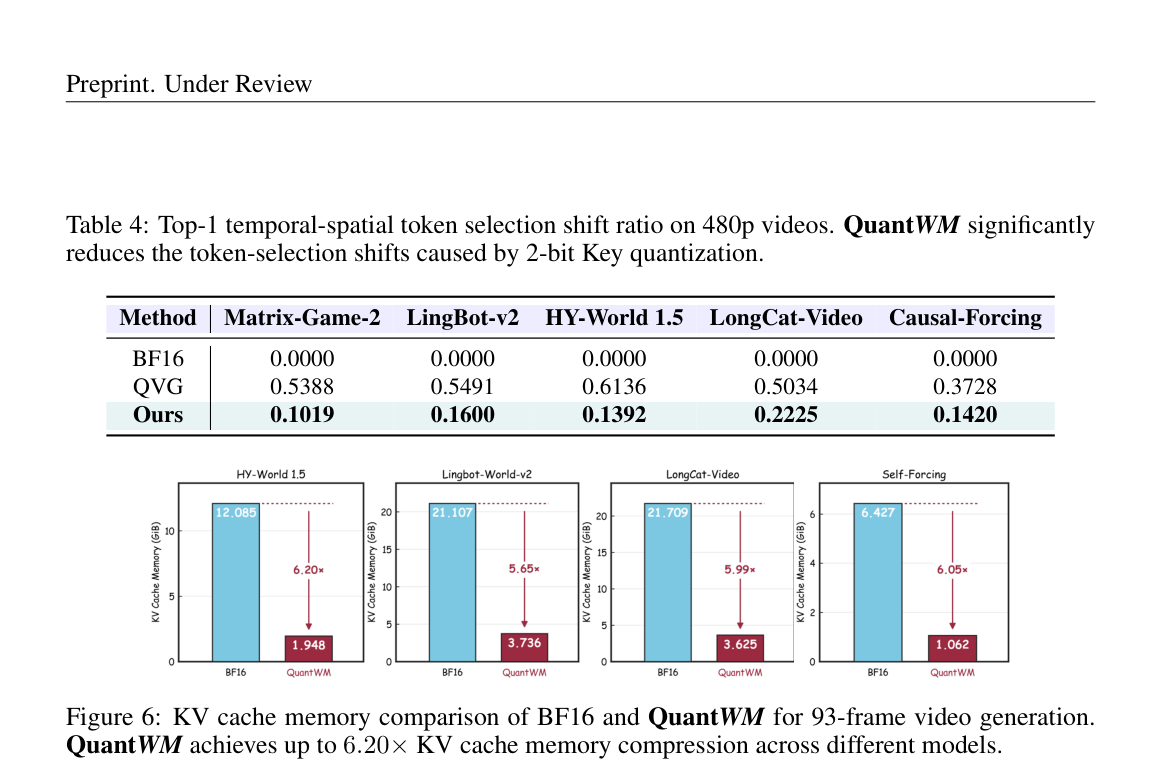
第9页裁图上方是 Table 4。五列模型为 Matrix-Game-2、LingBot-v2、HY-World 1.5、LongCat-Video、Causal-Forcing。QVG 的漂移率是 0.5388、0.5491、0.6136、0.5034、0.3728,Ours 是 0.1019、0.1600、0.1392、0.2225、0.1420,BF16 全为 0。下方 Figure 6 是四张 KV cache 柱状图,单位 GB。HY-World 1.5 的蓝柱 12.085、红柱 1.948,箭头 6.20×。Lingbot-World-v2 为 21.107 对 3.736,5.65×。LongCat-Video 为 21.709 对 3.625,5.99×。第四张标题印刷为 Self-Forcing,6.427 对 1.062,6.05×。图注说 93 帧生成上最高达到 6.20×。第四张不要和表中的 Causal-Forcing 合并。
实验如何设计?
- 五个开源模型是 LongCat-Video、HY-World 1.5、LingBot-World-v2、Matrix-Game-2 和 Causal-Forcing。主结果在 480p,附录补 720p,长度都是 93 帧。1 分钟设置只看 VBench,因为作者认为长程生成里量化误差会累积,此时更关心整体视频质量(第14页)。
- 帧级指标在全部帧上计算 PSNR、SSIM 和 LPIPS,用来直接看相对 BF16 轨迹的像素和感知差。VBench 取主体一致性、背景一致性、美学质量和成像质量,再给平均分。token 漂移率是量化后 top-1 时空 token 与 BF16 不一致的比例。
- 提示套件来自 MovieGen Benchmark。Matrix-Game-2 不接收文本,改用 29 张官方首帧,每张搭配 7 到 8 条动作序列。QVG 与 KIVI 都按官方实现复现,并作用到各模型自己的缓存约定上。作者特别说明 KIVI 组大小是 32,而且最近窗口仍用 BF16,这有利于时间一致性,也使它和纯 2-bit 残差方案的预算不完全相同(第7页)。
- 消融主表在 HY-World 1.5 上打开或关闭 QSAC 与 PSAC,同时记录 PSNR、SSIM、LPIPS 和 token 漂移。效率部分比较 93 帧 KV cache 占用和端到端秒数。
关键结果与论文证据
- 480p Table 3(第8页)里,本文在五个模型的 PSNR、SSIM、LPIPS 上都高于 QVG 和 KIVI。最明显的是 LongCat-Video:PSNR 从 QVG 的 20.683 到 25.508,LPIPS 从 0.0784 到 0.0332,KIVI 为 24.448 与 0.0399。Matrix-Game-2 的 PSNR 从 QVG 17.749、KIVI 19.298 到本文 20.615,LPIPS 从 0.2851 降到 0.1443。HY-World 1.5 为 18.449 / 0.7661 / 0.1082,对照 QVG 的 16.118 / 0.6559 / 0.2114。LingBot-v2 的 PSNR 只从 14.414 提到 16.138,绝对画质仍远离 BF16 的无穷大 PSNR,因为该指标把 BF16 当作参照。
- 同一张表的 VBench 平均分彼此很近,这正是作者说榜单不敏感的证据,而不是画面无损的证据。HY-World 1.5:BF16 0.8174、QVG 0.8127、本文 0.8173,与 Figure 1 的 81.74%、81.27%、81.73% 对应。LongCat 平均分是 0.8123、0.8122、0.8130。并不是每个子项都由本文领先:HY-World 美学分 QVG 为 0.6394,本文 0.6366,BF16 0.6378;LingBot-v2 背景一致性 KIVI 0.9137,略高于本文 0.9134。
- token 漂移(第9页 Table 4)把注意力变化量化出来。QVG 为 0.5388、0.5491、0.6136、0.5034、0.3728,最高是 HY-World 的 61.36%。本文为 0.1019、0.1600、0.1392、0.2225、0.1420。最低的是 Matrix-Game-2 的 0.1019,LongCat 仍有 0.2225。消融里,只加 QSAC 把 HY-World 漂移从 0.6137 降到 0.3817,只加 PSAC 降到 0.2290,两者一起是 0.1392,PSNR 从 16.118 到 18.449。
- 显存按 Figure 6 的柱子读取,对象是 93 帧 KV cache。HY-World 1.5 从 12.085GB 到 1.948GB,标注 6.20×,与 Figure 1 的 12.09GB 对 1.95GB 以及正文“最高 6.20×”一致。LingBot-World-v2 从 21.107GB 到 3.736GB,5.65×。LongCat-Video 从 21.709GB 到 3.625GB,5.99×,正文也写了这组 GB 数。第四柱的标题是 Self-Forcing,6.427GB 到 1.062GB,6.05×。主实验表使用的名字是 Causal-Forcing,不要把这一柱的显存写成 Causal-Forcing 的成绩。
- 延迟不是普遍变快(第9页 Table 6)。LingBot-World-v2 从 193.56 秒到 204.09 秒,增加 5.44%;HY-World 1.5 从 112.17 秒到 118.75 秒,增加 5.87%;LongCat-Video 从 255.35 秒到 209.94 秒,减少 17.78%。720p 上 Matrix-Game-2 的 PSNR 从 QVG 的 17.721 到本文 20.568,LPIPS 从 0.3047 到 0.1651(第14页)。1 分钟 VBench 平均分上,HY-World 从 QVG 的 0.5949 到本文 0.6627,BF16 为 0.6567;成像质量上 QVG 掉到 0.4756,BF16 与本文为 0.6247 和 0.6242。Causal-Forcing 的 1 分钟平均分则是 BF16 0.6398、QVG 0.6576、本文 0.6744,QVG 可以高于 BF16。
阅读时需要注意
- 作者没有单列局限。从实验设计可以直接看到的边界是:VBench 对闪烁不敏感,所以分数接近 BF16 不能单独证明时间一致性;1 分钟协议又只报了 VBench,没有给出长视频的 PSNR 或 LPIPS。
- 补偿不是零存储。r=8 的特征向量用 BF16,系数用 INT8。秩再加大,Table 9 显示质量增益变小、比特开销变大。第一个生成块还用不上 PSAC。
- 和 KIVI 的比较混有组大小 32 与最近窗口 BF16。本文相对 QVG 的设置更对齐,因为二者都用组大小 64 的质心残差。把“全面优于所有 2-bit 方法”理解成相同比特预算下的全指标胜利,会超过表的含义。
- 预印本未经同行评审。项目页返回 HTTP 200,文中没有独立代码仓库,外部复现应写待核验。Figure 6 出现 Self-Forcing,正文五模型列表写的是 Causal-Forcing,阅读显存图时要按柱子标题分开。
关联工作
- 视频侧的背景是扩散 Transformer 提升了画质,自回归和因果模型又允许按块流式生成。世界模型在此之上加入动作和相机。长程一致性还出现了显式记忆,用来取回历史观察。QuantWM 不改这些生成器的权重,只压缩它们已经在用的 KV cache(第13页)。
- 量化侧,GPTQ、SmoothQuant 和 AWQ 主要压权重或激活。KV 量化从语言模型进入视频是 QVG 的工作。Tuncer 等人从 softmax 偏差修正量化 Key;本文把校正放在质心分配和 QK⊤ 的低秩补偿上,并直接统计 top-1 token 是否换位。
- 因此这篇论文的贡献边界很具体:它改善的是低比特缓存相对 BF16 轨迹的帧级误差和 token 选择,不是提出新的世界模型,也不是宣称 2-bit 视频在所有观感指标上不可区分。