快速导读:腾讯、南洋理工、新加坡国立与 A*STAR 的 GameDirector 用外置控制层维护血量、技能和胜负,再把合法动作写成提示交给 Wan2.2 世界模型去画,从而让玩家改配置时仍守住战斗规则。
游戏世界模型已经能按玩家的键鼠画出战斗,但血量归零要收场、技能要等槽和冷却、Boss 还得看距离选招。这些规则若和像素生成缠在同一个网络里,换一套玩家配置就容易失真。腾讯、南洋理工大学、新加坡国立大学和 A*STAR 的预印本 GameDirector(arXiv:2609.25652)把逻辑放到外置控制层,让 Wan2.2 世界模型只负责按提示渲染。
玩家仍可指定场景、角色、初始血量、攻击强度和技能集合,包括把某个 Boss 的技能派给另一个 Boss。控制层读最近几帧、改写显式状态、用未微调的 2B 语言模型选招,再检查死亡和冷却。作者报告:在一分钟回放上,机制忠实度达到 GPT-5.5 的 98.5±0.2 与 Gemini-3.1-Pro 的 99.6±0.2,Boss 决策质量相对最强显式基线高出 39.9 个百分点(第7、16页)。项目页可访问;独立代码仓库待核验。这是未经同行评审的预印本。
英文题目:GameDirector: Decoupling Gameplay Logic from Rendering for Player-Configurable Game World Models
论文出处:arXiv 每日论文精选 · arXiv:2609.25652
原始论文:PDF / 论文页面
这篇论文解决什么问题?
交互世界模型按动作生成下一小段画面,游戏因此成为动作条件建模的试验场。近期工作已覆盖 NPC 战斗、环境变化和多人。相对硬编码引擎,生成式路线更愿意让玩家改角色和情景。第1页同时指出,开放生成还不等于一局完整的游戏:扣血、技能发动、战斗规则和终局都要求精确、前后一致的状态转移。
作者把缺口收成一个问题:怎样保留玩家可配置的生成灵活性,又持续满足显式机制。已有游戏世界模型或者少建模状态,或者把状态预测和视觉生成捆在一起。配置一变,角色、技能和规则都会变,单体生成器很难外推(第2页)。传统引擎可靠,但灵活性有限,这正是 Figure 1 底部两块红底对照想表达的张力。
相关工作分成三条。交互世界模型(ReactiveGWM、SCOPE、Incantation、Matrix-Game、LingBot-World)强在视觉动态和动作可控,不保证血量演化和终止条件(第3页)。状态感知模型里,WildWorld 提供对齐的状态数据,StatePlay 联合预测内部状态和画面,Marionette 先预测关节式三维状态再渲染,WorldMind 把视觉理解和基于状态的决策拆开,但状态仍主要靠学习或服务于生成。智能体路线里,Code World Model、Magpie 和 Programmable World Model 用代码、引擎或可执行程序维持状态。GameDirector 要的是闭环里同时做视觉理解、显式记账、自适应 NPC 规划和规则执行。
核心创新
- 把玩法逻辑做成外置智能体控制层,世界模型只按结构化提示渲染,玩家可改角色、状态和技能而不重训生成器。
- 用轻量感知加确定性状态更新和未微调的 2B 规划器,在闭环里执行命中扣血、技能槽、冷却和死亡规则。
- 构建带内部状态的三游戏数据集,并在同一 Wan2.2 骨干上对照无状态、预测状态、隐式与显式 Boss 控制。
方法概览
GameDirector 先由自动游玩代理采集三款游戏的对齐片段。玩家选定场景、角色、初始血量、攻击强度、技能槽和技能集合。控制层用 SituationNet 估计距离与朝向,用 AttackNet 检测命中,再按配置的攻击强度改写血量、按命中增加技能槽。未微调的 Gemma-4-E2B-it 从技能卡里选 Boss 技能,规则模块检查冷却、槽阈值和死亡覆盖。合法动作填进模板提示,Wan2.2-TI2V-5B 每步生成 4 帧并回馈给控制层。
- 数据由自动游玩代理采集。代理用键鼠打三款游戏:No Rest for the Wicked(Game N)、因版权而匿名的 Vampire(Game V)、Hollow Knight(Game H)。同步记录血量、技能槽、技能名、位置、朝向、相对角度和距离,再过滤、对齐并写成共享时间轴上的结构化提示,供 AttackNet、SituationNet 和动作条件生成使用。全集 51,786 条互不重叠的 5 秒片段,每段 80 帧、16 FPS、832×480,训练 51,486、测试 300;三款游戏占比 43.8%、36.0%、20.1%,合计 71.93 小时。13 个角色里 5 个可玩、8 个是 Boss(第4、12页)。
- 开局配置写成 I0,包含初始帧、双方初始血量、攻击强度、Boss 技能槽和技能集合 C。技能卡写有描述、有效距离、持续时间、槽阈值和冷却,数值只从对齐的训练片段估计。初始帧给世界模型,战斗参数给控制层。玩家还可以改单个技能的冷却和阈值;后文实验聚焦血量、技能槽和攻击强度这三个量(第4–5页)。
- 视觉理解是两个 ResNet-18。SituationNet 每 80 帧读最近三帧,输出距离和相对朝向。AttackNet 每 4 帧读最近三帧,输出玩家与 Boss 是否被击中的 0/1。实现上二者都接隐藏维 384 的单向 GRU,输入缩到 336×192,ImageNet 预训练后三游戏联合训练 20 个 epoch,AdamW 学习率 3×10^−4(第5、13页)。命中标签来自对齐的血量变化。
- 状态跟踪不用网络预测数值,而用命中信号改账。玩家血量减去 Boss 攻击强度乘以玩家被击中,Boss 血量减去玩家攻击强度乘以 Boss 被击中,结果截断到 0。Boss 技能槽在任意一方命中时加一,封顶为 M,放出特殊技能后重置。这些是常见战斗约定,不是为某一作单独写的隐藏公式(第5–6页式 3、式 4)。
- 动作规划把最新距离、朝向和技能卡交给 Gemma-4-E2B-it,贪心解码,不做任务微调。输出必须落在给定菜单里,例如远距离用接近技、贴身用近战。规则执行是最后一道门:任一方血量到 0,死亡覆盖后续输入;特殊技能还要槽达到阈值且冷却结束,否则退回普通攻击。通过的动作填进模板:谁在场景里怎样移动、同时做哪个动作(第6、13页)。
- 画师是 Wan2.2-TI2V-5B。VAE 和文本编码器冻结,DiT 在三游戏数据上训练 60K 步,AdamW 学习率 5×10^−5,四卡。每个训练片段含 1 个条件帧和 20 个与 0.25 秒间隔对齐的动作提示。因果化遵循 Causal Forcing++:自回归教师 20K 步、一致性蒸馏 12K 步、DMD 5K 步,最终 3 步去噪,每个控制间隔生成 4 帧。生成帧送回控制层,形成闭环(第6、13–14页)。Figure 3 把这条链画成初始化、控制层和世界模型三块。
逐图理解论文
失败直觉
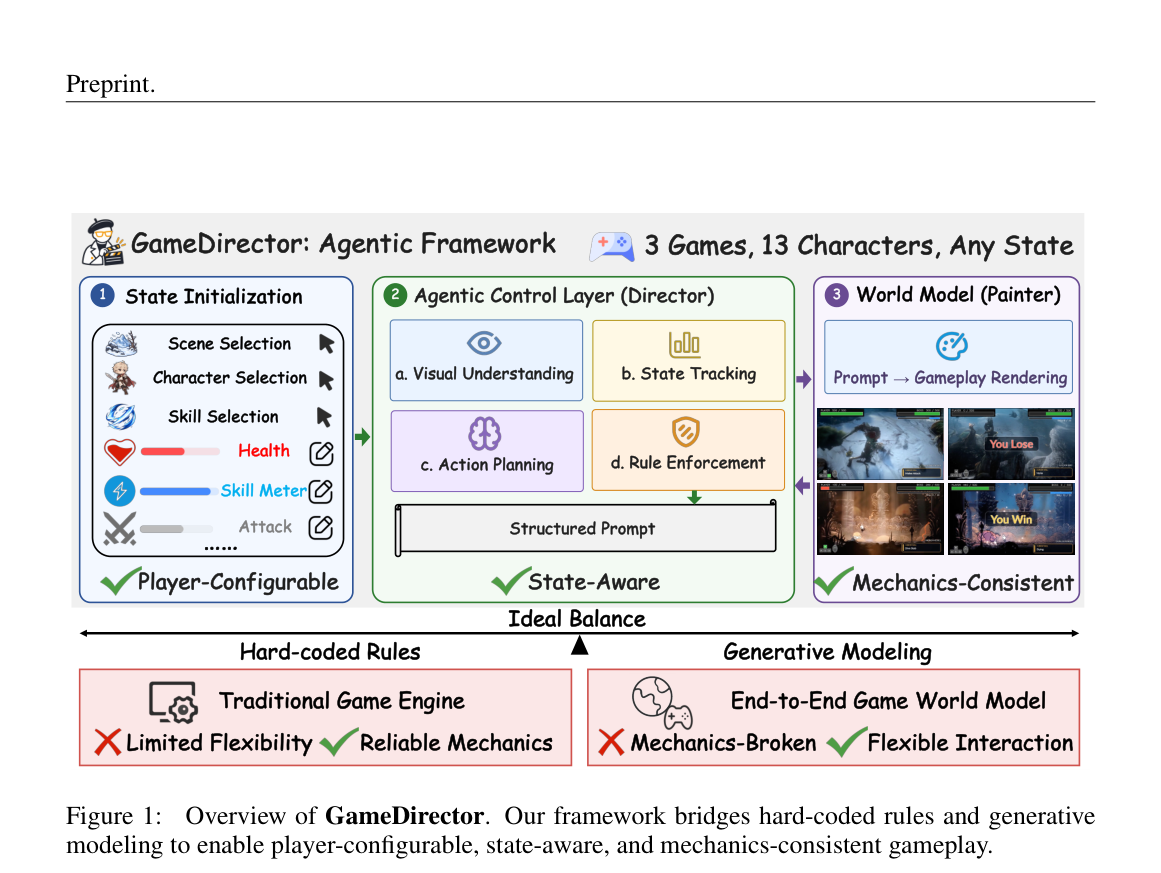
第2页总览。上方标题是 GameDirector: Agentic Framework,旁边写着 3 Games, 13 Characters, Any State。三块从左到右:状态初始化列出场景、角色、技能、血量、技能槽和攻击,底部打勾 Player-Configurable;控制层是视觉理解、状态跟踪、动作规划和规则执行,汇成 Structured Prompt,打勾 State-Aware;世界模型把提示画成对局,四张小图里能看到 You Lose 和 You Win,打勾 Mechanics-Consistent。下方横轴从硬编码规则指向生成式建模,中间标 Ideal Balance。左下传统引擎是有限灵活性、机制可靠;右下端到端游戏世界模型是机制破损、交互灵活。图内没有实验数字。13 个角色和三款游戏要到数据集一节才落到 5 名可玩角色加 8 个 Boss。
方法贡献
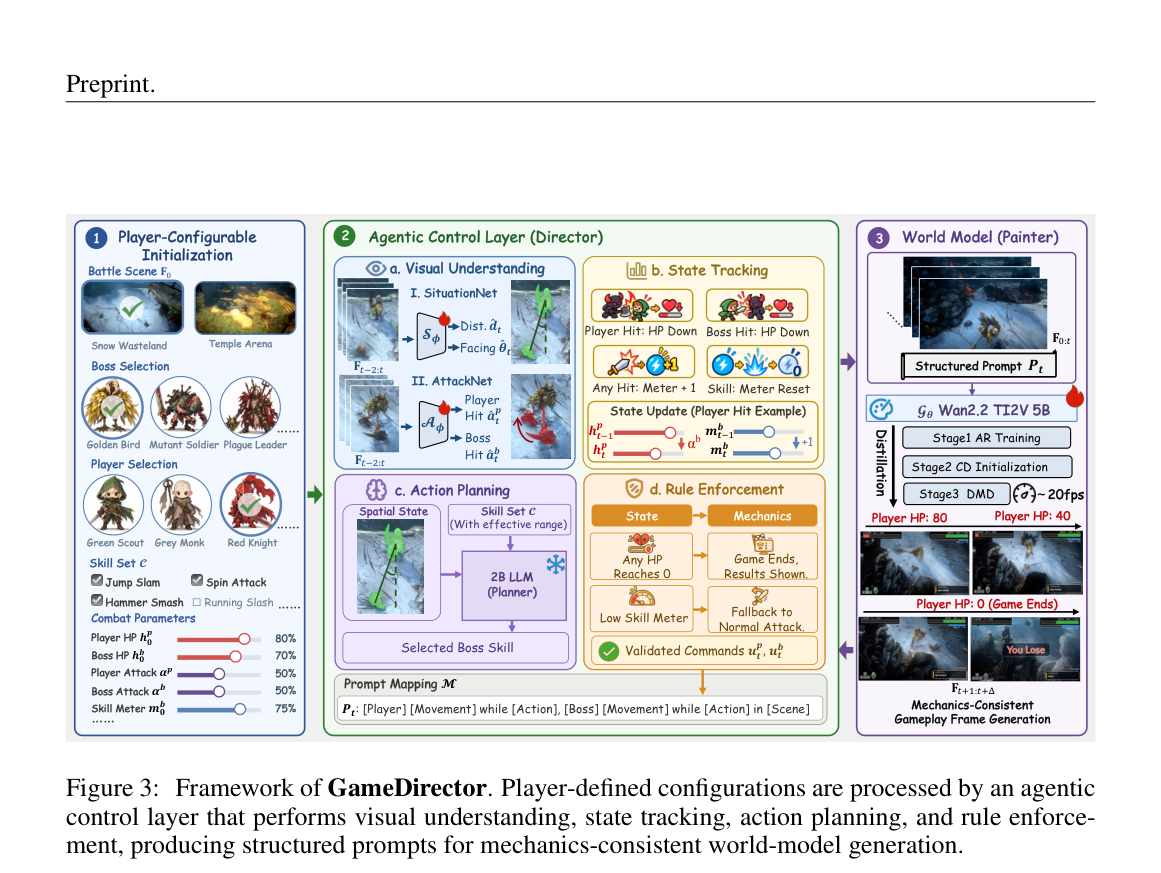
第5页框架图,顶部有 Preprint 字样。从左到右三块。左侧玩家可配置初始化:场景是 Snow Wasteland 与 Temple Arena,Boss 有 Golden Bird、Mutant Soldier、Plague Leader,玩家有 Green Scout、Grey Monk、Red Knight;技能勾选了 Jump Slam、Spin Attack、Hammer Smash,Running Slash 未勾选。滑动条标着玩家血量 80%、Boss 血量 70%、玩家攻击 50%、Boss 攻击 50%、技能槽 75%。中间绿色控制层分成视觉理解、状态跟踪、动作规划和规则执行。SituationNet 输出距离和朝向,AttackNet 输出双方命中;状态更新画了被击中后血量下降、任意命中给技能槽加一、放技能则槽重置。规划器是 2B LLM,规则模块在血量到 0 时结束对局,槽不足时退回普通攻击。底部模板是玩家与 Boss 在场景中的移动加动作。右侧世界模型标 Gθ Wan2.2 TI2V 5B,三阶段训练后约 20fps,示例帧从玩家血量 80、40 到 0 并出现 You Lose。这张图是方法总览,滑动条上的百分数是示意配置,不是 Table 1 的分数。
实验观察
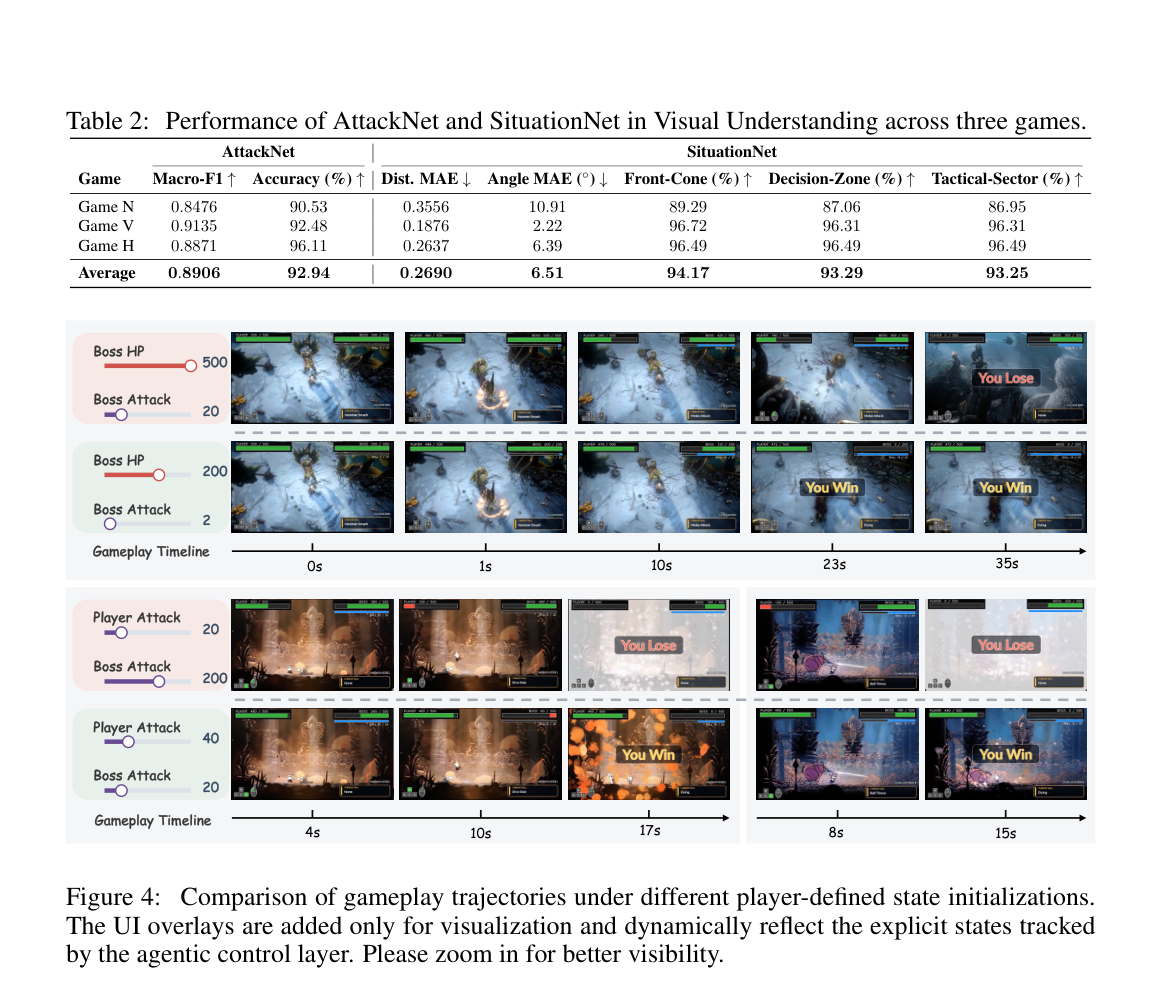
这一张 PNG 上半是 Table 2,下半才是 Figure 4,读图时不要把表的平均准确率当成轨迹图里的胜率。表中 AttackNet 准确率 Game N / V / H 为 90.53、92.48、96.11,平均 92.94;SituationNet 角度 MAE 分别是 10.91°、2.22°、6.39°。Figure 4 是雪地与遗迹场景的时间条。第一行 Boss HP 500、Boss Attack 20,时间点约 0、1、10、23、35 秒,末格 You Lose。第二行 Boss HP 200、Boss Attack 2,后段变成 You Win。第三行玩家攻击 20、Boss 攻击 200,橙字 You Lose。第四行玩家攻击 40、Boss 攻击 20,出现 You Win。图注写明界面叠层只为可视化,动态反映控制层跟踪的显式状态。因此胜负字是状态机结果,不是世界模型在像素里印上去的实验指标。
核心结论
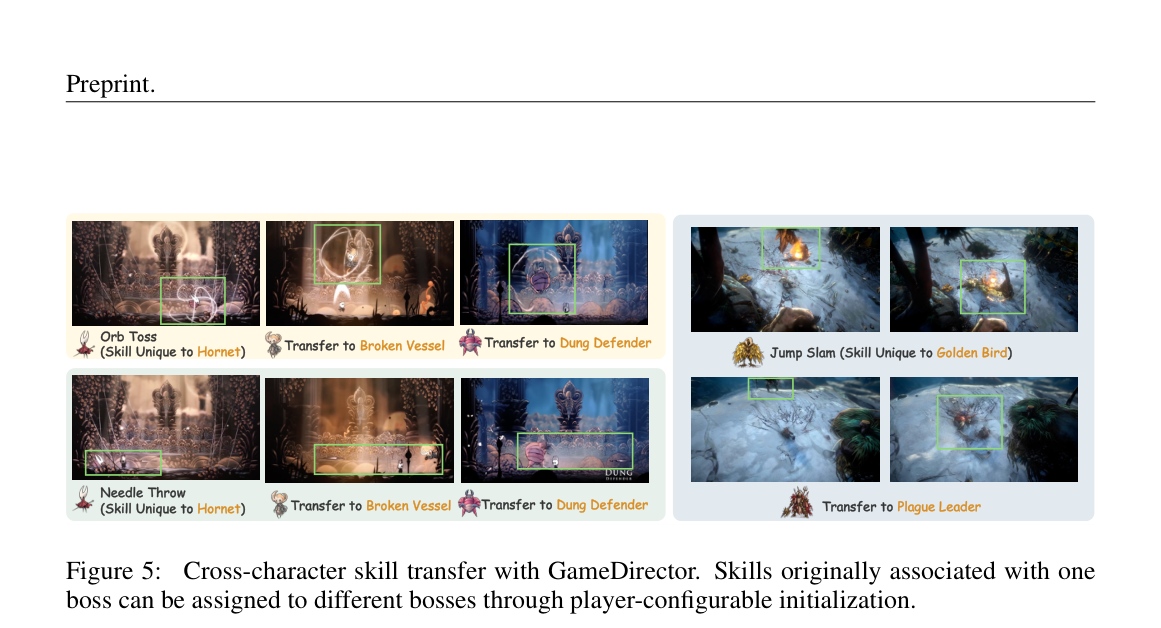
第9页跨角色技能图,顶部有 Preprint。左侧暖色面板两行:Orb Toss 与 Needle Throw 都标注为 Hornet 独有,再各转移到 Broken Vessel 和 Dung Defender,绿框圈出光球、针和地面效果。右侧冷色面板是雪地:Jump Slam 标注为 Golden Bird 独有,下一行 Transfer to Plague Leader,绿框圈住跃击和落点。图注只说明技能可以通过玩家配置初始化改派。这里没有准确率或胜率,不能把它当成 Table 1 的决策质量证据。
实验如何设计?
- 第7页用三个问题组织实验:智能体框架是否提高状态跟踪、机制忠实度和 Boss 控制;感知模块能否跨游戏支撑控制;收益在实际游玩中是否看得出。前两项有表,第三项正文落到轨迹可视化,没有另附人类评分表。
- 状态对齐检查血量是否只在检出命中后下降、技能槽是否随命中上升并在放技能后重置。一分钟回放每 0.25 秒一拍,共 240 拍。因为生成视频没有引擎命中真值,评测用 AttackNet 的检出作伪标签。附录写明,本文的满分来自用同一信号改账,衡量的是感知和记账一致,不是把隐藏引擎状态完全恢复出来(第7、14页)。
- 机制忠实度看技能是否合法、死亡后是否不再参战。基线没有显式技能标签时,评测专用的 ResNet-18 技能分类器在留出数据上准确率超过 95%,用来核对连续特殊技能是否守住最短冷却。死亡片段由 GPT-5.5 和 Gemini-3.1-Pro 各评三次,并提供死亡参考图,不要求姿态像素级相同(第7、14页,Figure 7)。
- 决策质量不看视频。裁判拿到 Boss 身份、技能卡、距离、朝向、战术扇区和从画面里识别出的动作,给每步动作有效性 0 或 1,以及整段序列契合 0 到 5(第7、15页,Figure 8)。感知模块另在 5,779 个留出间隔上评 AttackNet,在 5,576 个有效间隔上评 SituationNet。
- 闭环样本是 100 个 Game N 留出开局,覆盖 3 名可玩角色、3 个 Boss 和 2 个场景。各方法吃同一初始帧和同一段一分钟玩家操作,最多 12 个 5 秒片段。本文开局血量设为 500,攻击强度 40 与 20,Boss 槽初始为满。四种基线只做最小改造以代表无状态或预测状态、隐式或显式控制,骨干、数据、操作和生成配置相同(第14、17页)。
关键结果与论文证据
- Table 1(第7页):状态对齐上,预测状态的设定(3)(4) 在一分钟回放里降到 70.38 和 72.01,本文为 100.0。机制忠实度上,纯像素或语言控制的设定大约在 21 到 34 之间,本文为 98.5±0.2(GPT-5.5)和 99.6±0.2(Gemini-3.1-Pro)。决策质量上,隐式设定约 26 到 28,显式设定(2) 最高到 48.5±0.9 / 47.2±0.3,本文为 88.4±0.7 / 93.0±0.6。附录把后一组差距写成相对最强基线高出 39.9 和 45.8 个百分点,也就是 88.4−48.5 与 93.0−47.2(第16页)。
- Table 2(第8页)的感知平均为 AttackNet Macro-F1 0.8906、准确率 92.94%。分游戏准确率是 Game N 90.53、Game V 92.48、Game H 96.11。SituationNet 平均距离 MAE 0.2690、角度 MAE 6.51°,三个空间分类都超过 93%。这支持“命中和站位可以被轻量模型读出来”,但不能替代 Table 1 的机制分。
- Table 8 把 Game N 拆到三个 Boss(第16页)。GPT-5.5 下本文动作有效率:Golden Bird 100.0±0.0,Mutant Soldier 80.4±0.0,Plague Leader 80.2±3.1;序列契合总分 4.34±0.01。对四种设定的成对偏好约在 89.8% 到 95.8% 的匹配回放里本文更高。Golden Bird 明显更容易打满,不能把 88.4 理解成每个 Boss 都接近满分。
- Figure 4 用玩家改写的初始值展示轨迹。上排 Boss 血量 500、攻击 20 时约 35 秒出现 You Lose;血量改为 200、攻击改为 2 后变成 You Win。下排玩家攻击 20、Boss 攻击 200 时失败,玩家攻击 40、Boss 攻击 20 时获胜。正文说世界模型只画帧,血条和胜负字来自控制层状态(第8–9页)。Figure 5 把 Hornet 的 Orb Toss、Needle Throw 派给 Broken Vessel 和 Dung Defender,把 Golden Bird 的 Jump Slam 派给 Plague Leader,这是定性的跨角色技能迁移,图上没有分数。
- 速度方面,第6页和 Figure 3 写实时闭环约 20 FPS。附录 Table 9 的稳态测量是四卡 17.449、双卡 17.277、单卡 16.729 FPS,占各自 DiT 单元上限的 98% 以上。Gemma 平均 2230.264 毫秒一次,作者把规划放在每个 5 秒节拍的第 2 秒,用 3 秒前瞻把这 2.2 秒藏进生成里。单卡仍能保住生成吞吐的大头,但“约 20 FPS”和这张表不是同一个测量。
阅读时需要注意
- 主定量协议集中在 Game N 的 100 个一分钟开局。Game V 与 Game H 出现在感知表、数据统计和技能卡里,不能据此说三款游戏的机制忠实度都是 98.5。
- 两个自动裁判看的是死亡画面或文本轨迹。决策质量明确不向裁判展示视频,所以“招式选得对”和“画面真的做出了这一招”是分开的。技能分类器超过 95% 的准确率也只覆盖基线的可见技能核对。
- 第9–10页把未来工作放在包围盒、骨架和粗三维几何这类结构化中间表示上。当前账本主要是血量、技能槽和攻击强度。生成器画错身份或招式时,外置规则不会自动把像素改正。
- 预印本尚未同行评审。项目页在撰写时返回 HTTP 200,文中未给出可独立核验的代码仓库,复现状态应视为待核验。Vampire 的原名和画面被故意隐去。
关联工作
- 和 StatePlay、WildWorld 相比,本文不让生成器预测下一拍血量,而是用命中检测去改一份显式账。和 ReactiveGWM 的语言控制相比,Boss 技能在线挑选,而不是开局前写死整段策略。
- 和 Magpie 相比,规则不放进一个现成游戏引擎;和 Code World Model、Programmable World Model 相比,中间层是感知网络、语言模型和几条战斗规则,而不是通用代码或三维框程序。LingBot-World 2.0 的 pilot 与 director 代理被引用为角色行为和场景演化的同期方向,本文把四项能力收进同一控制层(第3页)。
- 画面侧直接站在 Wan2.2 和 Causal Forcing++ 上。因此视觉质量、动作跟随和长时身份保持,上限仍受这个视频骨干和蒸馏配方影响。控制层解决的是机制账本和提示是否合法。