快速导读:RECAP 保持空间关系的是非答案不变,用主张、语义矛盾和可选支持的似然比较做成拒绝风险,并由分组校准决定是否保留置信度否决。
视觉语言模型可以把左右、上下说反,两个物体却都在画面里,答案还很自信。中科院计算所人工智能安全重点实验室与中国科学院大学的 RECAP 不重写这句是或否,而是审核它有没有足够的视觉证据。它比较主张、语义矛盾和可选的单边支持,得到随答案而变的拒绝风险。校准只决定置信度能不能留下来当否决。
主结果来自 VSR 的图覆盖子集和受控 What'sUp,模型是 Qwen3-VL-8B、InternVL3.5-8B 和 LLaVA-1.5-7B。相对匹配的 VCD 像素对比,四个主指标在六个设定里都更好。相对置信度,收益集中在幻觉误接受和排序,Qwen 的 VSR 准确率几乎打平。另有 LLaVA-OneVision-7B、Qwen3-VL-2B、全池回退和 GSR-Bench 迁移。这是 arXiv:2609.26093 预印本,未经同行评审,v1 首次公开于 2026-08-04。代码仓库 https://github.com/SouthWinter/RECAP 同日创建并推送,核验时 0 star。
英文题目:RECAP: Relation Evidence Calibration for Detecting Spatial Relation Hallucinations in Vision-Language Models
论文出处:arXiv 每日论文精选 · arXiv:2609.26093
原始论文:PDF / 论文页面
这篇论文解决什么问题?
空间关系错,常常不是没看见物体。两个物体都在,预测的关系却反了,或者和图像支持的关系冲突,置信度还可以很高。置信度衡量的是确定性,学习探针使用内部状态,VCD 衡量对模糊、降采样、灰度的敏感。模型可以在这些检验下又稳又自信,同时更支持一个语义上不兼容的关系。置信度低,也可能只是场景难。
作者把任务写成关系接地的选择性预测:已经生成的是非答案保持冻结,审核器决定接受还是弃权,不重新生成。证据采集只改被探测的关系,问题和原答案不动。部署也不能一律丢掉置信度,因为有的模型上它已经能把幻觉排开。该不该留下,要由与测试集不相交的校准决定。
空间语言本身提供反证。left of 对 right of,above 对 below,inside 与 contains 可以按物体顺序归一。非互斥的后果只能当单边支持,不能写成矛盾。SpatialTrust 用检测框和重叠,本文协议没有这类接地标注。BCEA 用水平翻转给左右主张找证据并做共形控制,它的分数决定要不要断言关系。RECAP 比的是冻结答案所断言的那条关系。
核心创新
- 把空间关系审核写成固定答案的选择性预测,证据只改被探测的关系。
- 用主张–矛盾图和答案条件的软析取,把图像似然收成拒绝风险,文本参照相减保持可选。
- 分组校准同时设定覆盖率阈值和置信度否决资格,留出集不参与选模式。
方法概览
关系图把反向谓词按主客体对调。矛盾边覆盖左右、上下、前后和包含;on 对 below 是矛盾,above 只以 β=0.5 做单边支持。探测句为 “Is [subject] [relation] [object]?”,边际是 log p(yes)−log p(no)。RECAP-Img 用图像边际。RECAP-Cal 减去匹配的纯文本边际。yes 要求主张净证据压过矛盾与支持惩罚;no 对缺少主张、反证和支持失败取最大。风险取负。部署只有 RECAP-Img 或 RECAP-Selector。后者取置信度与关系风险的校准 CDF 最大值。1000 次分组自助的联合 95% 界要求 H-FPR 上界低于 0.5 且 Hall-AUC 下界高于 0.5,否则不用置信度否决。
- 每个样本有图像、主体与客体、关系,以及一条是非问句。冻结的多模态模型给出 yes 或 no。RECAP 不改这个答案,只赋予拒绝风险。任意探测句的边际是 log p(yes) 减 log p(no),实现上是 no 与 yes 的负对数似然之差。置信度基线是这条直接答案边际的绝对值取负,风险越高越该拒绝。
- 关系图是有向约束,不是提示词清单。节点是有序物体对上的二元谓词。矛盾边给出互斥见证,支持边是单边、带固定权重的检查。反向谓词通过交换主客体归一,例如 contains(A, B) 收成 inside(B, A)。表 1 在第 3 页列出五族:left_of 对 right_of,above 对 below,in_front_of 对 behind,inside 对 contains。on 的矛盾是 below,above 只是支持。缺边表示拒绝把这对关系当成可靠反证。唯一使用的软权重是 on 到 above 的 0.5,在评测前固定。
- 每个节点变成问句 “Is [subject] [relation] [object]?”。图像边际记为 mI。匹配的纯文本问句给出 mT,差值 Δ 等于 mI 减 mT。mT 被当成文本参照偏好,里面混有提示、词元、关系频率和共现,不是因果语言先验。默认通道 x 取 mI,即 RECAP-Img。RECAP-Cal 把 x 换成 Δ,图和答案语义不变。直接问句只有在边际与显式主张探测完全一致时才复用。
- 矛盾摘要取各矛盾边上 x 的最大,没有矛盾边则为 0。支持惩罚只累加权重乘上负证据的正部。主张证据等于主张边际减去矛盾摘要再减去支持惩罚。回答为 yes 时,这份净证据就是充分见证。回答为 no 时,缺少主张、出现正的反证、支持失败三者取最大,软析取,互不抵消。风险是该见证取负。
- 部署预先规定两种模式:单独 RECAP-Img,或 RECAP-Selector。后者先把置信度风险和关系风险各自映射到校准集上的经验 CDF,再取较大的那个分位,因此比的是校准尺度,不是原始风险数值。接受阈值是目标覆盖率的校准分位数,主表把关系通道定为 RECAP-Img。RECAP-Cal 只作机制对照。图、探测和风险公式都不学习。标注的分组不相交校准只设定阈值,并检验置信度能否当否决。
- 否决资格来自 1000 次分组自助、Bonferroni 校正的单侧界,名义联合覆盖 95%。直接答案的 H-FPR 上界要低于 0.5,置信度 Hall-AUC 下界要高于 0.5。前者表示负例里被错接受的不超过半数,后者表示排序好于随机。两条都过才允许置信度留下,否则用 RECAP-Img。界本身不是风险保证。模式和阈值在看留出效用之前冻结。
逐图理解论文
失败直觉
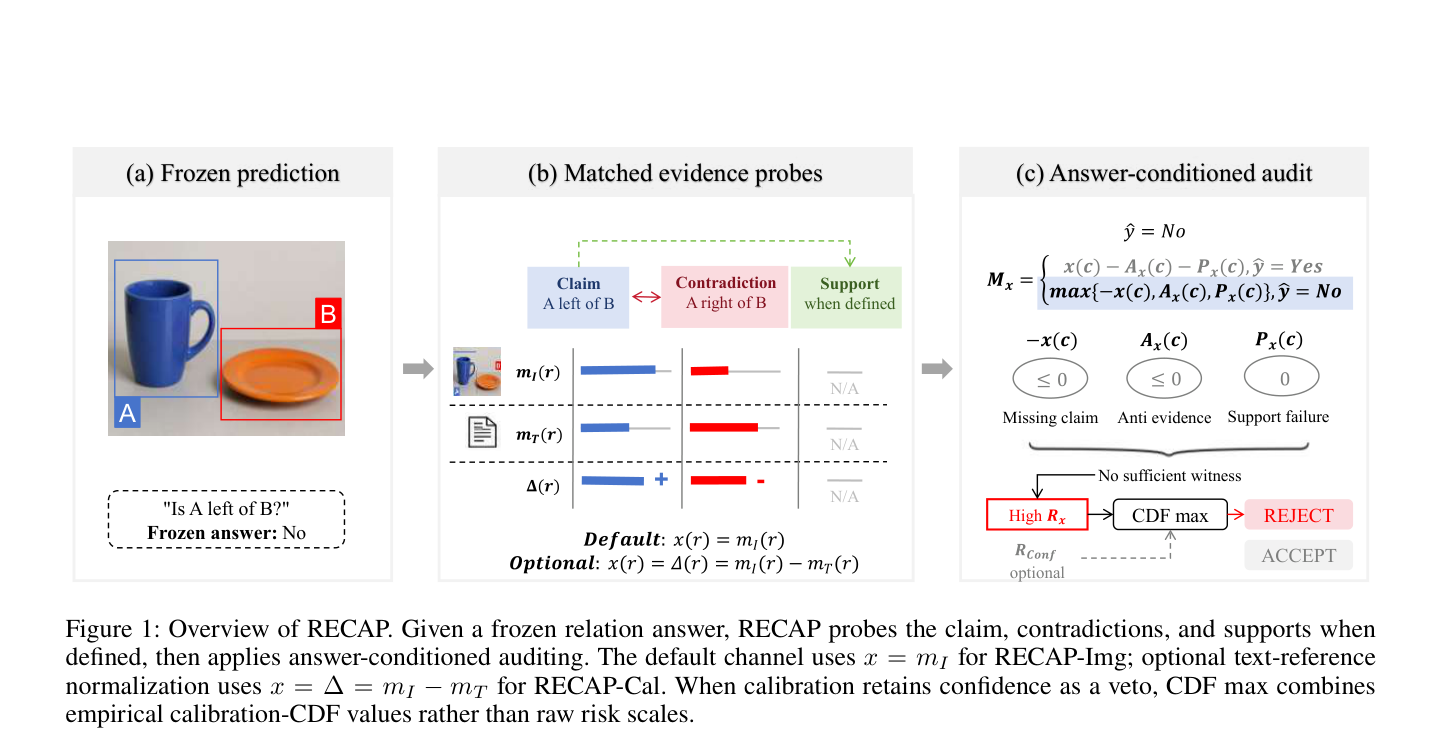
这是方法总览,适合做特色图。左栏是冻结预测:蓝杯标 A、橙盘标 B,问句是 A 是否在 B 左边,冻结答案为 No。中栏对主张 “A left of B”、矛盾 “A right of B” 和未定义的支持做匹配探测,三行分别是图像边际、文本边际和二者之差。右栏按答案做审核,No 分支取缺少主张、反证和支持失败的最大项,风险高则拒绝。可选的置信度经 CDF max 并入,不是把原始分数直接相加。不要把第 2 页那张正文残片 figure-01-p002-01 当成这张图。
对照结果
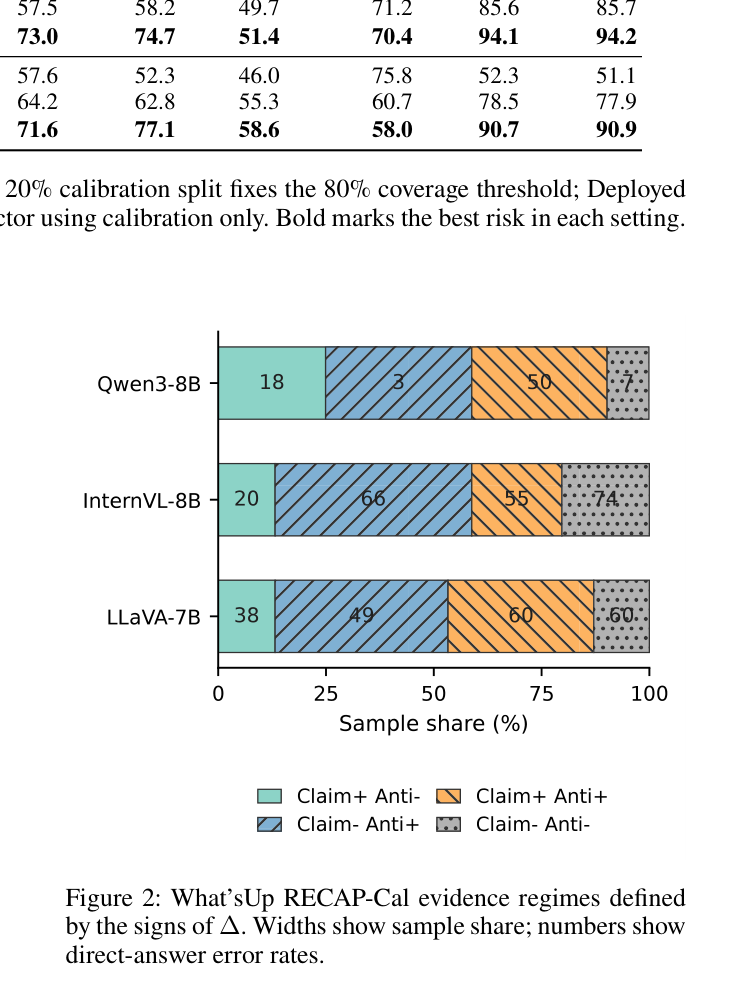
这张图在第 5 页,按 RECAP-Cal 的 Δ 符号划分 What'sUp。四种颜色对应主张与最强反关系同号或异号。条的宽度是样本占比,条内数字是直接答案错误率。正文点名 Qwen 干净区 18% 与 3%,InternVL 同号区 55%–74%,LLaVA 两个同号区都是 60%。裁切顶部印着 Table 2 的末行和半句表注,那些百分比属于表,不属于这四根条。
Figure 4: Coverage curves for selective accuracy (top) and hallucination false-positive rate (bottom)
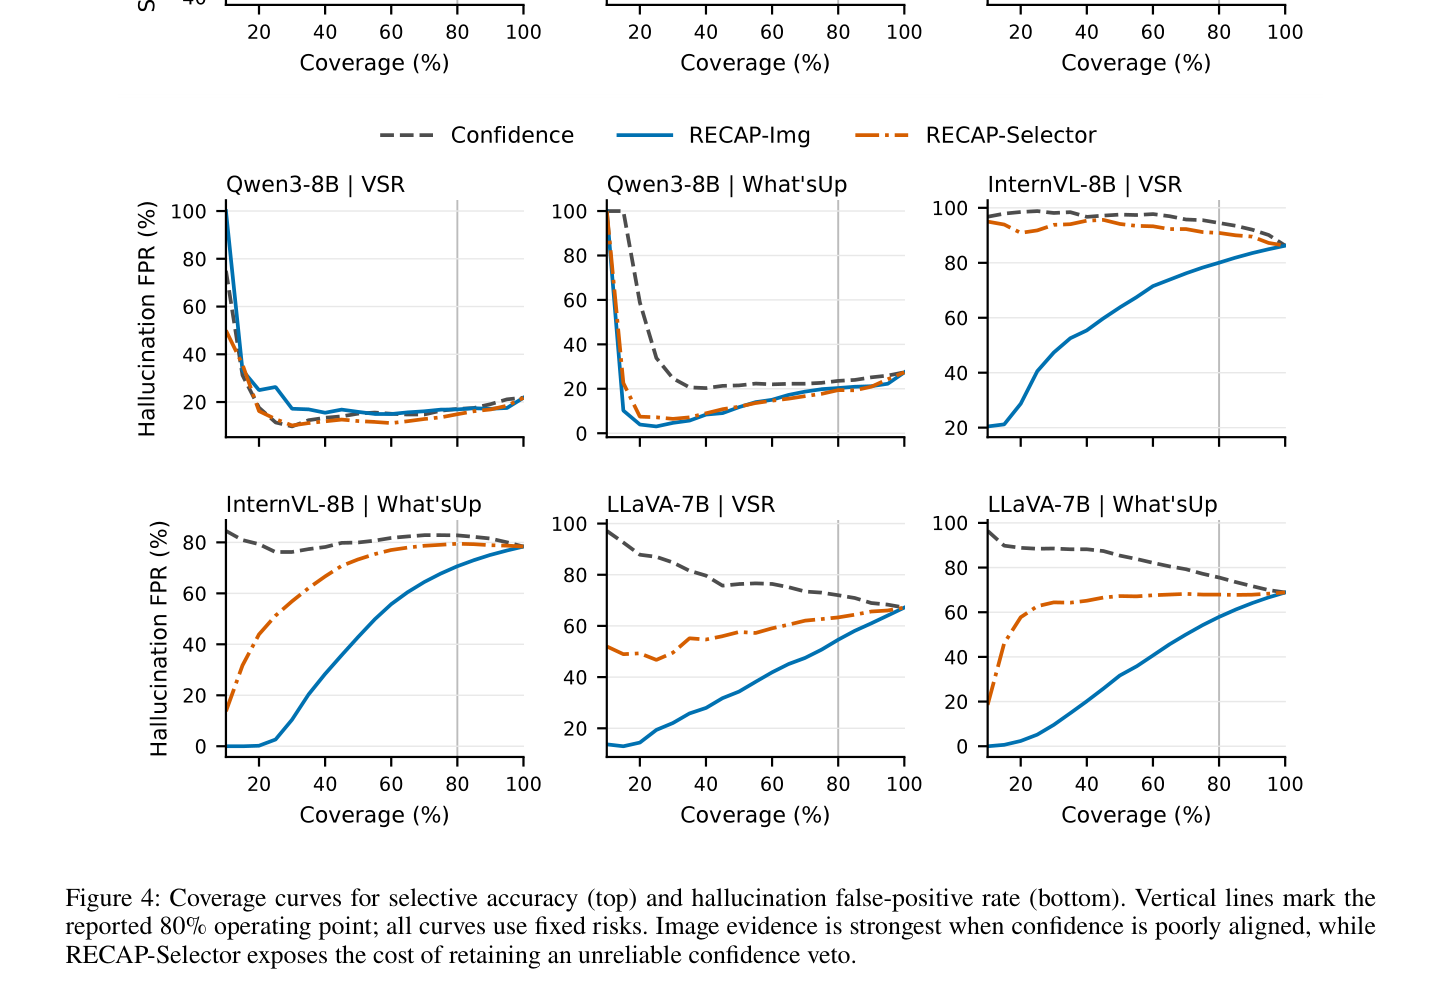
第 21 页的覆盖曲线。图注说明上排是选择准确率、下排是幻觉假阳率,竖线是报告用的 80% 工作点,曲线使用固定风险。这张 PNG 把上排裁掉大半,能读的是下排六个面板:Qwen、InternVL、LLaVA 各自的 VSR 与 What'sUp。图例中虚线是置信度,实线是 RECAP-Img,点划线是 RECAP-Selector。置信度偏离关系接地时,图像证据的假阳率曲线更低。Selector 贴近不可靠的置信度,说明把否决硬留下来要付代价。具体百分数以 Table 2 和 Table 9 为准,不要沿曲线估读。
实验如何设计?
- 主模型是 Qwen3-VL-8B、InternVL3.5-8B、LLaVA-1.5-7B。Qwen3-VL-2B 做尺度压力测试,LLaVA-OneVision-7B 做较新结构检查。直接答案是 yes/no 全续写负对数似然的 argmin。探测使用同一边际。公式和边在模型和数据上固定。
- VSR 官方随机测试有 2195 条陈述。评测前只按归一化关系族保留图能覆盖的 1249 条:左右 245、垂直 543、拓扑 169、深度 292。其余 946 条含邻近 225、交互 64、其他 657,全池部署时回退到置信度。受控 What'sUp 有 3280 条、820 个选择组。与两边主基准做图像 ID 去重后,GSR-Bench 去掉 9 张共有 COCO 图像上的 24 条,剩 544 张图、719 组、1438 条。迁移时只用 RGB 和问句,不用框、掩码或深度。
- 每个划分把约 20% 的选择组或图像放进校准,其余留出。种子由单元标识的 MD5 前八位能否被 5 整除决定,相关选项留在同一侧。报告 20 次划分的均值。阈值和 RECAP 模式只在校准上确定。聚类自助重采样整组或整图。
- 80% 覆盖是中等弃权点。Acc@80 是接受子集准确率。H-FPR 是被接受负例中的预测 yes 比例。Hall-AUC 把“预测 yes 且标签 no”当正类,Err-AUC 把任一错误答案当正类。同一全局阈值同时用于两个标签。对照共享冻结似然接口:置信度、四条释义加原问句的 Prompt-SC、干净对扰动的 VCD、答案身份逻辑回归,以及在同一批标注组上拟合的探针逻辑回归。
关键结果与论文证据
- 第 5 页 Table 2 是 20 次分组不相交划分的留出均值,单位为百分比。Qwen3-VL-8B 在 VSR 上,置信度 Acc@80 / H-FPR@80 / Err-AUC / Hall-AUC 为 85.6 / 16.8 / 74.1 / 69.6,VCD 为 84.6 / 20.7 / 68.5 / 58.5,部署 RECAP 为 85.3 / 14.8 / 74.3 / 72.9。What'sUp 上三者依次为 82.7 / 23.6 / 69.5 / 68.8,82.6 / 24.1 / 73.9 / 72.8,85.7 / 19.3 / 80.1 / 79.6。Qwen 的 VSR 准确率比置信度低 0.3 个点,H-FPR 低 2.0 个点。
- InternVL3.5-8B 的 VSR:置信度 62.1 / 94.6 / 62.1 / 60.3,VCD 61.5 / 84.3 / 57.5 / 58.2,RECAP 66.8 / 80.2 / 73.0 / 74.7。What'sUp:42.8 / 82.8 / 67.0 / 66.8,49.7 / 71.2 / 85.6 / 85.7,51.4 / 70.4 / 94.1 / 94.2。LLaVA-1.5-7B 的 VSR:64.4 / 72.5 / 57.6 / 52.3,67.0 / 63.8 / 64.2 / 62.8,70.2 / 54.6 / 71.6 / 77.1。What'sUp:46.0 / 75.8 / 52.3 / 51.1,55.3 / 60.7 / 78.5 / 77.9,58.6 / 58.0 / 90.7 / 90.9。相对 VCD,四个指标在六个设定里 RECAP 都更好。What'sUp 上 Acc@80 相对置信度提高 3.0、8.6、12.6 个点,Hall-AUC 提高 10.8、27.4、39.8 个点。摘要里的 10.8–39.8 就是这三档。InternVL 的 VSR 幻觉误接受仍有 80.2%。
- 第 4 页写明校准门控:Qwen 的 VSR 有 19/20 次划分保留置信度否决,What'sUp 为 20/20。InternVL 与 LLaVA 的每一次划分都改用纯图像证据。第 5 页全池 2195 条 VSR,图外回退置信度后,H-FPR@80 相对纯置信度下降 1.4 / 8.1 / 9.7 个点,Hall-AUC 上升 2.3 / 8.0 / 13.4 个点,顺序为 Qwen、InternVL、LLaVA。
- 第 6 页 Table 4,LLaVA-OneVision-7B:VSR 上置信度 68.9 / 80.8 / 69.1,VCD 73.8 / 62.1 / 78.2,RECAP 74.9 / 58.5 / 80.9,依次为 Acc@80、H-FPR@80、Hall-AUC。What'sUp 为 56.5 / 62.0 / 68.0,63.5 / 52.2 / 81.8,65.3 / 49.2 / 84.4。H-FPR 下降 22.3 与 12.8 个点,Hall-AUC 上升 11.8 与 16.4 个点。资格检验在两个数据集的 20 次划分里都拒绝置信度否决。
- 第 6 页 Table 3,同等 20% 标注预算。Qwen 的 What'sUp 上 Probe-Logit 的 Acc@80 / H-FPR 为 95.0 / 5.0,Conf-AnsLogit 为 94.0 / 6.3,固定的 RECAP-Img 为 85.1 / 20.4。其余五个设定里 RECAP-Img 的 Acc@80 和 H-FPR 好于 Probe-Logit。四个 InternVL 与 LLaVA 设定上,它的四项指标都好于 Conf-AnsLogit。有稳定答案偏置时,学习融合仍有优势。
- 第 5 页 Figure 2 按 Δ 的符号把 What'sUp 分成四态。正文给出的直接错误率:Qwen 的两个干净区只有 18% 和 3%;InternVL 在主张与反证同高或同低时达到 55%–74%;LLaVA 在这两个同号区都是 60%。条宽是样本占比,条内数字是错误率。同一答案方向可以对应不同的关系证据风险。
- 第 6 页 Table 7,GSR-Bench 在目标侧统一排到 80% 覆盖,模式只在源域校准上选定。置信度到所选图像证据模式:Qwen 的 Acc@80 从 91.5 到 91.2,H-FPR 从 2.5 到 0.6,Hall-AUC 从 81.0 到 94.9。InternVL 为 67.3 到 75.8、47.1 到 23.1、54.1 到 91.8。LLaVA 为 56.8 到 66.1、94.6 到 76.9、64.2 到 93.0。H-FPR 下降 1.9–24.0 个点,Hall-AUC 上升 13.9–37.7 个点。Qwen 的准确率略降。目标标签不参与选模式。
- 第 7 页 Table 9 底栏,误差 AURC:Qwen 的 VSR 两侧都是 9.3,What'sUp 从 11.5 到 8.1。InternVL 从 31.9 / 43.0 到 24.9 / 25.8。LLaVA 从 30.2 / 44.8 到 22.7 / 22.3。配对区间里 H-FPR 与 Hall-AUC 的增益都不含 0。Qwen/VSR 的 Acc@80 与 Err-AUC 统计上打平,安全向的增益仍为正。优化后的 RECAP-Img 平均 4.8–5.0 次似然调用,置信度 2 次,Prompt-SC 10 次,置信度优先的分阶段策略约 3.2 次。第 21 页 Figure 4 的曲线使用固定风险,竖线标在 80% 覆盖。
阅读时需要注意
- 第 7 页讨论写明:RECAP 是选择性审核器,不是答案改正系统,也不是安全证书。模型、数据域、关系图或提示一变,就要重新校准。
- 评测限于有序物体对和已经验证的关系词表。自由形式、多物体输出还需要关系抽取、指代消解和边可靠性测量。同模型探测会继承相关的感知错误,并且必须能读到似然。
- 图只覆盖 VSR 的 1249/2195 条,其余回退置信度。深度关系受视角、遮挡和尺度影响,是 Qwen 的边界情形。单条软支持整体增益很小。文本参照相减是可选的,而且随模型变化。
- Qwen 的 What'sUp 上,用同一批标签拟合的 Probe-Logit 明显好于固定公式。预印本未经同行评审。公开代码在 2026-08-04 创建并推送,核验时 0 star,还没有外部复现记录。
关联工作
- VSR、What'sUp 和 GSR-Bench 分别测自然图像验证、受控扰动和接地空间问句。RECAP 问的是已经生成的那一个答案够不够格被接受。
- 物体幻觉方法处理没有支撑的实体。关系错误可以在两个物体都被看见时发生。MMRel 与 Reefknot 暴露物体和关系的不一致。HALP 在隐藏状态上学习探测,RECAP 只用输出似然,不拟合检测器。
- VCD 对比原图和扰动图,OPERA 改解码,Woodpecker 改写输出。约束感知提示会重新生成空间答案。匹配的 VCD 和改答案对照用来把语义反证与像素敏感、提示不稳分开。
- 选择性预测用覆盖率换风险。SpatialTrust 从检测几何学习,那些标注在本文协议里不可用。BCEA 最接近,但分数决定是否断言主张。RECAP 在关系图上比较主张与矛盾似然,并把拒绝规则条件在冻结答案上。