快速导读:SAM-V 在掩码解码前融合冻结的 SAM 与 VGGT,并用相机 token 和提示位置的局部特征锚定稀疏点,从而一次前向预测跨视图的同一实例。
机器人换一个很大的视角之后,还要认出刚才点中的那一个物体。UIUC 与 Meta 的 SAM-V 不在二维掩码外面再做匹配,也不先把场景收成点云。它把冻结的 SAM 和前馈几何模型 VGGT 在解码前拼到一起,用相机 token 和提示位置的局部特征把稀疏点锚到具体视图,一次解码给出各帧掩码。
点提示评测在 Hypersim 的留出场景上对比 SAM2。全物体评测用 IGGT 三维跟踪基准的 ScanNet++ 与零样本 ScanNet,对照 SAM2、IGGT、PanSt3R、ODIN 和 Point-SAM。大视角下跨视图一致性更好,邻近视角则和 SAM2 接近。查询式基线更快。这是 arXiv:2609.25490 预印本,未经同行评审。代码 https://github.com/gong208/SAM-V 于 2026-09-21 创建并推送,核验时 0 star。
英文题目:SAM-V: Geometry-Aware Segment Anything for Multi-View Instance Segmentation
论文出处:arXiv 每日论文精选 · arXiv:2609.25490
原始论文:PDF / 论文页面
这篇论文解决什么问题?
单张图的可提示分割已经很强,跨视图保持同一个实例仍然难。视角、遮挡和尺度一大,外观连续的视频跟踪会跟丢,相似的椅子和杯子会串。Figure 1 把三种做法放在同一间办公室里:SAM 掩码加三维后处理会把关联做乱,SAM2 在后续视角打叉,SAM-V 把同一目标的绿色掩码留在各行视图上。
点云实例分割靠共享度量空间做关联,但受重建质量和稀缺的三维标注限制。另一路先逐帧出 SAM 掩码,再用投影、图优化或提示对齐做离线匹配,身份在帧间仍然含糊。IGGT 用前馈、实例相关的几何特征避开显式重建和离线关联,却没有用上二维基础模型的分割先验。
只融合稠密图像特征也不够。点打在某一帧上,解码器如果不知道它属于哪一张图、哪一个位置,预测会漂到旁边。第 4.3 节的消融对应这个失败。MV-SAM 把提示解到显式点图,SAM-V 把提示和输出都留在原来的二维视图里。
核心创新
- 在解码前融合 SAM 与 VGGT,而不是事后匹配各自产生的掩码。
- 用相机 token 和提示位置的局部几何特征,把单帧稀疏点锚到具体视图。
- 同一解码器既支持点提示,也支持由 SAM 提议驱动的全物体推断。
方法概览
N 帧图像分别经冻结 SAM 与 VGGT 编码,拼接后由 MLP 投回 SAM 通道,解码器联合注意全部视图。SAM 提示嵌入与该帧相机 token、提示所在块的局部 VGGT 特征做交叉注意力。可训练部分是融合 MLP、提示融合和从 SAM 初始化的掩码解码器。损失是 20 倍 focal 加 Dice,ScanNet++ 阶段再加 IoU 置信度损失。全物体推断用 SAM 提议采样点,再按多视图掩码重叠做抑制。
- 输入是同一场景的 N 张 RGB,目标由稀疏点 (u, v, 帧号) 指定,点可以来自一帧或多帧。输出是每帧掩码。目标在该帧不可见时,掩码应为全零。Figure 2 的左栏是输入视频,Frame 2 上的蓝点是用户点。雪花标在 SAM 图像编码器、VGGT 编码器和 SAM 提示编码器上,火焰标在融合 MLP、提示融合和 SAM 解码器上。
- 图像侧:冻结 SAM 与 VGGT 各自抽出 N 帧特征,沿通道拼接,再用 MLP 投回 SAM 的通道维。全部视图摊成一条 token,解码器联合注意。位置编码按被提示的那一帧对齐。
- 提示侧:冻结的 SAM 提示编码器先得到提示嵌入。每个点再取两样几何上下文。一是该帧的 VGGT 相机 token,用来说明点来自哪一张图。二是该点所在图像块的局部 VGGT 特征。精确坐标已经在 SAM 提示里,所以块级上下文够用。二者拼接后作为键和值,SAM 提示做查询,交叉注意力得到融合提示。
- 解码器吃融合后的图像 token 和稀疏提示,一次前向预测多视图掩码,再按视图拆开。训练冻结三个编码器,只优化融合 MLP、提示融合和从预训练 SAM 初始化的掩码解码器。
- 损失沿用 SAM:20 倍 focal 加 Dice。focal 处理前景背景不平衡,Dice 鼓励与真值重叠。ScanNet++ 微调再加 LIoU,即预测 IoU 与真实 IoU 的均方误差,供全物体推断时给候选掩码排序。附录给出三项权重 20:1:1。
- 全物体模式不改主干。每帧独立跑 SAM 自动掩码生成器得到提议,在提议内部采样点,连同全部帧送进 SAM-V。同一物体会从多帧冒出重复的多视图掩码,因为它们在各帧上大体重合,所以按掩码重叠做非极大值抑制。附录写明每帧最多保留 64 个提议,推断时每个提议采样 5 个点,每次解码调用放 8 组提示。
逐图理解论文
失败直觉
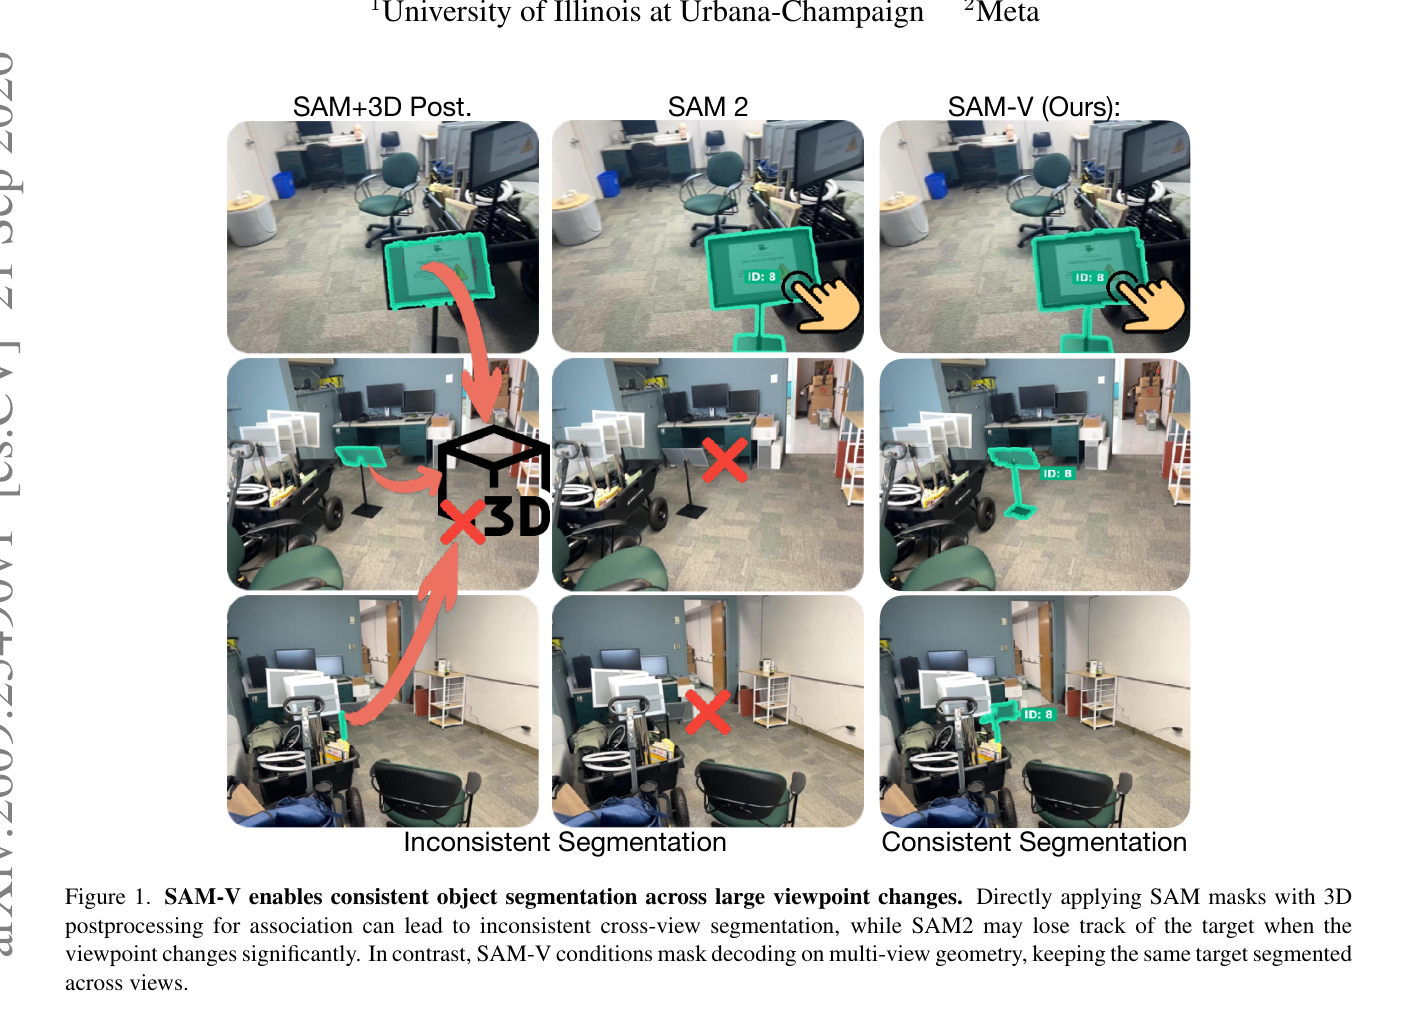
首页动机图,三列分别是 SAM 加三维后处理、SAM 2 和 SAM-V。同一间办公室从不同视角拍到。左列红箭头汇到一个带叉的三维标记,表示跨视图关联不一致。中列后两行打红叉,表示跟丢。右列绿色掩码和身份标记留在各行视图上,图注称之为一致分割。裁切里还带有 UIUC、Meta 的单位行和 arXiv 侧栏,那些不是实验结果。不要把这张图读成 Table 2 的分数。
方法贡献
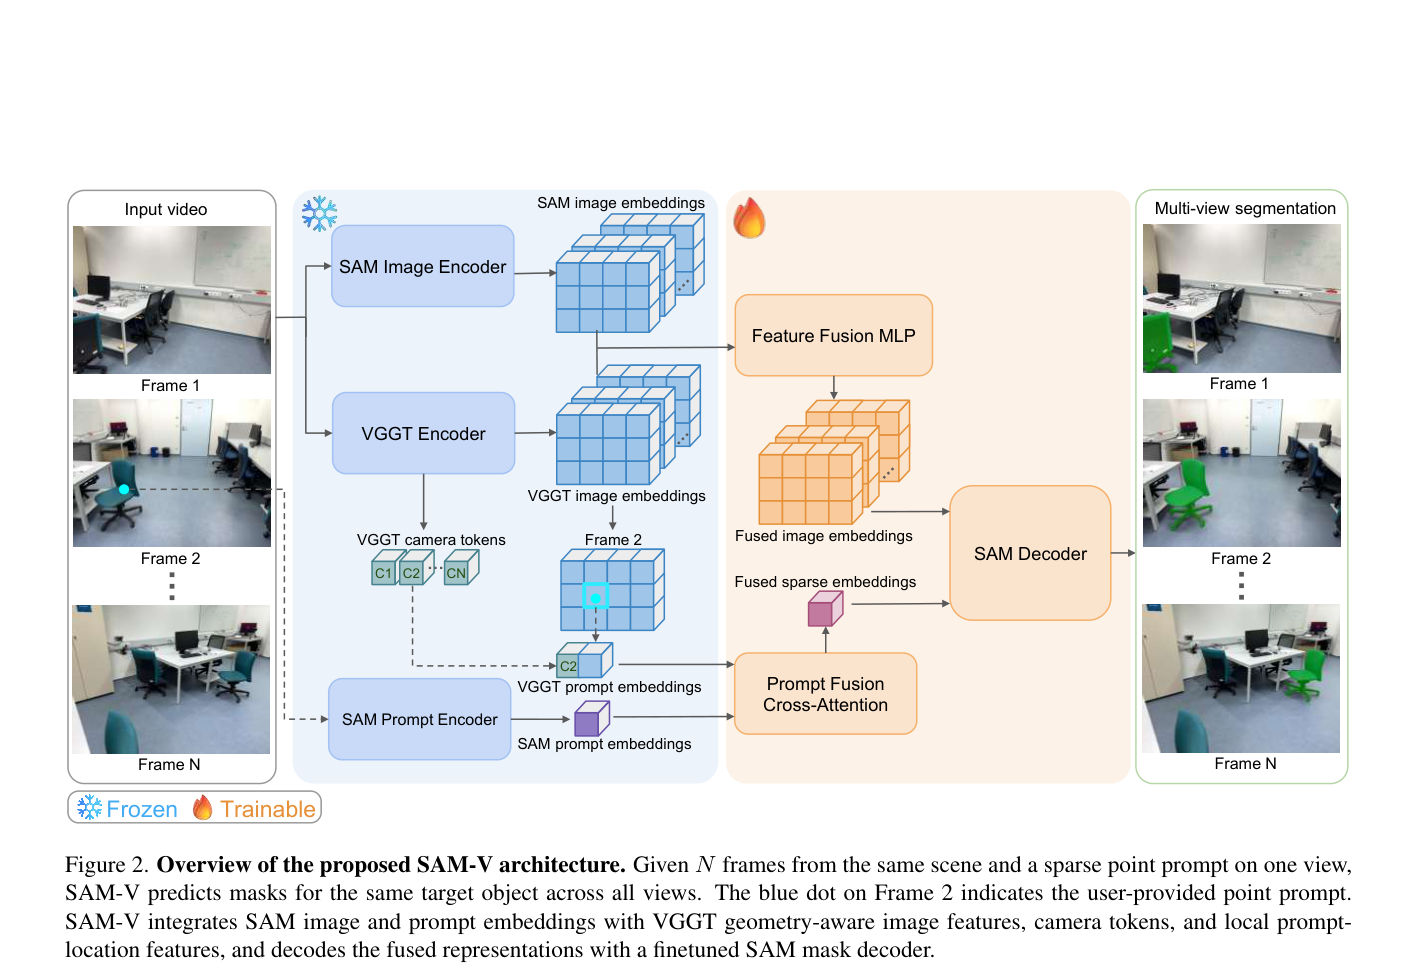
这是架构总览,适合做特色图。左栏输入视频,Frame 2 的蓝点是唯一的用户点。中间蓝色区域是冻结的 SAM 图像编码器、VGGT 编码器和 SAM 提示编码器,图例雪花表示冻结。VGGT 同时给出图像块、相机 token C1 到 CN,以及点所在块上的局部特征。右侧橙色区域是可训练的特征融合 MLP、提示融合交叉注意力和 SAM 解码器,图例火焰表示可训练。输出是各帧上同一把绿色椅子的掩码。点提示路径不在图外做掩码匹配。
对照结果
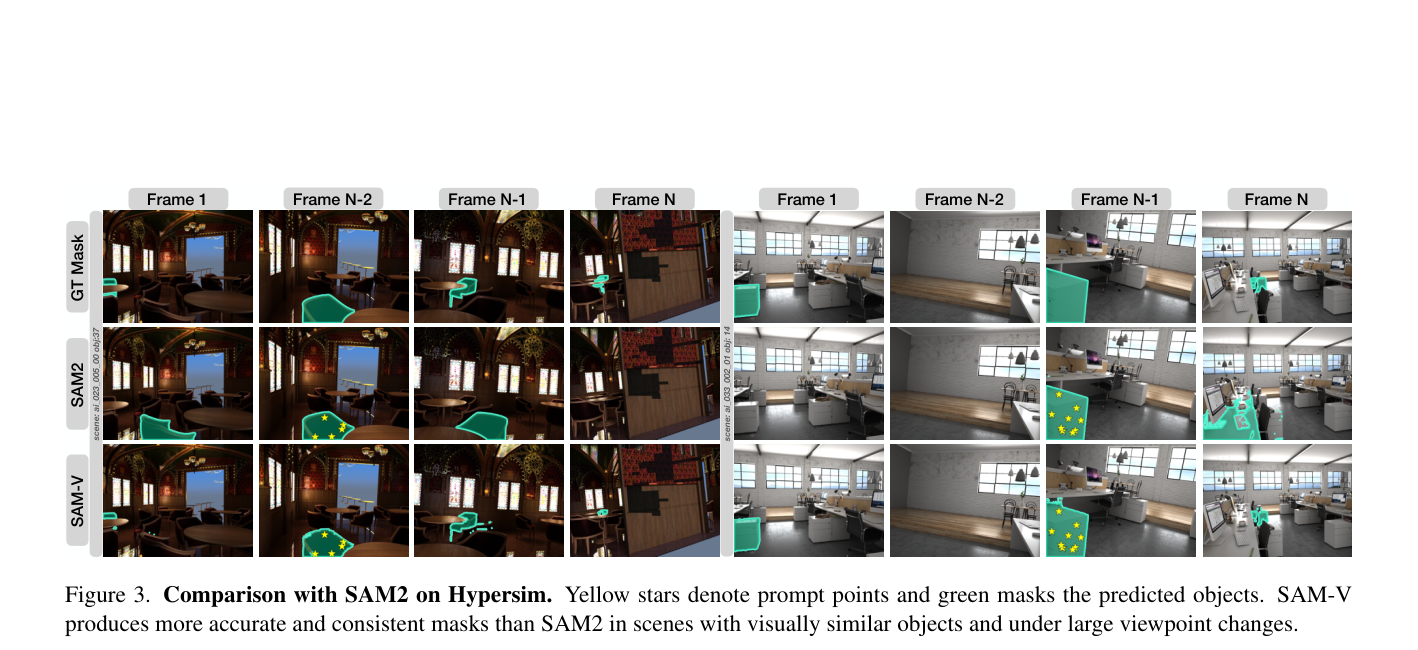
第 6 页与 SAM2 的 Hypersim 定性对比,左右两个场景,列是 Frame 1、Frame N-2、Frame N-1、Frame N。行是真值掩码、SAM2、SAM-V。黄星是提示点,绿色是预测物体。左场景里相似的桌椅会让 SAM2 分到旁边,右场景的大视角下 SAM2 的掩码会缩掉或跟丢。SAM-V 更接近首行真值。图内没有 O-IoU。对应数字在同页 Table 1,不要从掩码面积估分。
核心结论
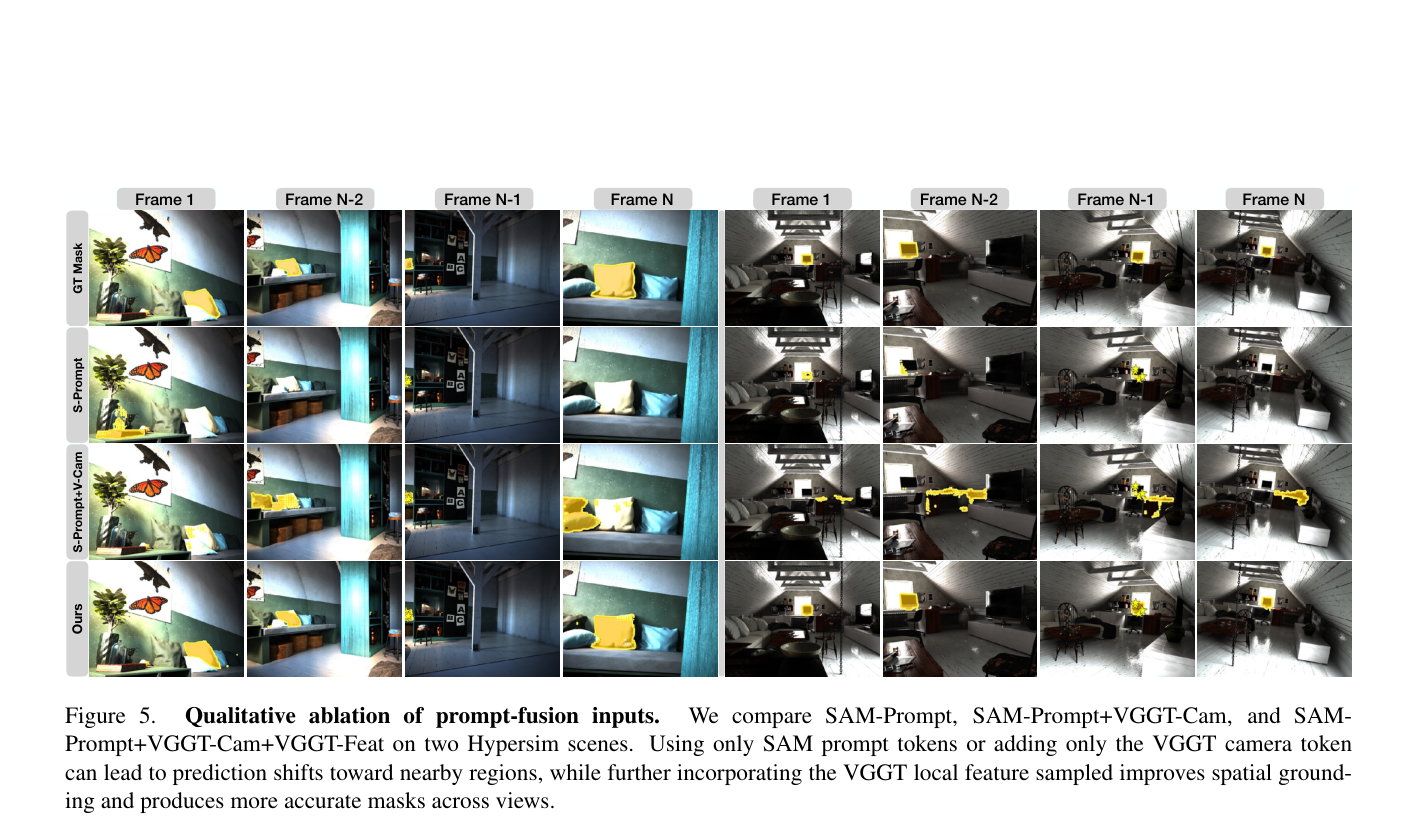
第 8 页提示融合的定性消融。两套阁楼或起居场景,行依次是真值、只有 SAM 提示、加上 VGGT 相机 token、完整模型。只有提示或只加相机 token 时,掩码会滑向枕头、窗帘或电视旁边的区域。加上提示位置的局部特征后,掩码更稳地盖住被点中的物体。定量的 21.3 到 64.2 等数字在同页 Table 3,不在这张图里。
实验如何设计?
- 训练分两段。Hypersim 提供渲染的多视图实例真值,ScanNet++ 再适应更噪的真实采集。每个样本 8 帧:4 帧目标可见,4 帧目标缺席,缺席帧要预测全零。正帧要求目标至少占图像面积 0.0025。Hypersim 前 70 个 epoch 从近视角、多帧提示逐渐过渡到远视角、单帧提示。
- 附录 Table A1:骨干为 SAM ViT-H,输入 1024×1024,AdamW,学习率 1×10⁻⁴,权重衰减 0.01,batch size 2,余弦退火。Hypersim 训练点固定 20 个,损失为 20 Lfocal + Ldice,614 个场景,212 个 epoch,取第 206 个验证最好的检查点,8 张 L40S。ScanNet++ 微调 20 个 epoch、856 个场景、14 张 L40S,每样本的点数从 3、4、5 里抽,并加上 LIoU。focal 在每帧抽样 112×112 个点。
- Hypersim 留出场景中,至少在 8 帧里超过面积阈值的实例有 1788 个。点提示评测对每个实例抽 8 张正帧和 8 张负帧,共 16 帧。正帧分两种:相机位姿最近邻的 continuous,和最远点采样的 diverse。两种方法都在随机一张正帧上收 10 个点。SAM2 以该帧为锚向前向后传播。
- 全物体评测沿用 IGGT 基准:ScanNet++ 58 个物体,ScanNet 66 个物体。ScanNet 为零样本,没有在 ScanNet 上微调。所有方法只吃 RGB,没有传感器深度或真值位姿。ODIN 和 Point-SAM 需要三维输入,因此喂入 VGGT 的点图。PanSt3R 和 ODIN 用场景级可学习查询,不能接受用户点。匹配用基于 O-IoU 的匈牙利算法。
- T-mIoU 只平均物体可见帧的每帧 IoU。O-IoU 把各帧掩码拼起来算一个整体 IoU,包含物体缺席的帧。P@50 与 R@50 的 IoU 阈值为 0.5。时间是单张 L40S 上每个场景 6 到 9 张图、从 RGB 到最终掩码的平均端到端秒数。SAM2、Point-SAM 和 SAM-V 含提议生成,ODIN 含从 VGGT 回归点。
关键结果与论文证据
- 第 6 页 Table 1。continuous:SAM2 的 O-IoU / R@50 为 63.5 / 76.8,SAM-V 为 64.2 / 75.5。diverse:SAM2 为 48.1 / 59.6,SAM-V 为 62.4 / 71.9。大视角下 O-IoU 提高 14.3 个点,R@50 提高 12.3 个点。邻近视角两者接近,SAM-V 的 R@50 还低 1.3 个点。Figure 3 的两行场景里,黄星是提示点,绿掩码是预测。相似物体和大幅度转角下,SAM2 会串到旁边或跟丢,SAM-V 更贴近真值掩码。
- 第 7 页 Table 2,ScanNet++:SAM-V 的 T-mIoU / O-IoU / P@50 / R@50 / 时间为 78.4 / 79.4 / 79.4 / 89.2 / 49.4 秒。PanSt3R 为 72.7 / 74.8 / 77.4 / 77.4 / 4.8 秒。正文说相对最强基线 PanSt3R,T-mIoU 高 5.7 个点,R@50 高 11.8 个点。O-IoU 之差是 79.4 减 74.8,等于 4.6,摘要把整体 IoU 说成约 5 个点、帧级召回约 12 个点。相对带星号的 IGGT 65.5 / 67.9 / 59.6 / 71.7,正文给出的增益是 12.9、11.5、19.8、17.5。星号表示这是作者自己的协议,与 IGGT 原文数字不同,并与原作者通信核对过。
- 同一张表的零样本 ScanNet:SAM-V 为 75.6 / 77.3 / 77.4 / 87.1 / 38.6 秒,四项质量指标都高于 PanSt3R 的 71.2 / 73.3 / 72.1 / 80.8 / 4.9 秒,也高于 SAM2 的 69.4 / 70.0 / 72.7 / 72.3 / 30.2 秒。ODIN 在 ScanNet++ 为 52.1 / 55.5 / 51.7 / 57.1 / 4.6 秒,Point-SAM 为 41.4 / 45.0 / 40.2 / 42.5 / 229.4 秒。SAM-V 比 IGGT 和 Point-SAM 快,仍比 PanSt3R、ODIN 慢一个数量级,因为时间里包含提议生成。
- 第 6 到 7 页正文指出查询式方法的失败形态:场景查询的粒度对不齐标注,常把放在椅子上的物体并进整把椅子。SAM-V 的提议来自 SAM,粒度跟 SAM 走。PanSt3R 和 ODIN 不能在推断时指定目标,SAM-V 同时支持点提示和全物体。Figure 4 用颜色和 ID 表示跨视图身份。这张定性图没有放进本次视觉资产,定量以 Table 2 为准。
- 第 8 页 Table 3,提示融合消融,列顺序为 O-IoU、P@50、R@50。continuous:只有 SAM 提示时 21.3 / 16.3 / 21.9,加上相机 token 为 35.5 / 29.9 / 34.5,再加局部特征为 64.2 / 69.3 / 75.5。diverse:23.0 / 17.4 / 23.5,32.2 / 25.9 / 29.9,62.4 / 65.1 / 71.9。完整设计的 continuous O-IoU 64.2 和 diverse O-IoU 62.4 与 Table 1 的 SAM-V 一致。只加相机 token 能选定视图,但位置仍会漂到邻近实例。
- Figure 5 在同一页给出两套 Hypersim 场景,行是真值、SAM 提示、SAM 提示加相机 token、完整模型。前两行变体的掩码会滑到枕头、沙发或电视附近的其他区域,完整模型更贴住被点中的那一块。图内没有印表格数字。
阅读时需要注意
- 第 8 到 9 页:目前只在室内数据 Hypersim 和 ScanNet++ 上训练,户外和以物体为中心的域没有测。
- 设定假设刚性物体和静态环境。可变形物体或动态场景需要额外的时空建模。
- 任务是点提示跟踪,不是开放词汇或语言引导分割。全物体模式还要先跑 SAM 提议,端到端时间因此远高于 PanSt3R 的约 5 秒。
- 预印本未经同行评审。代码仓库 2026-09-21 创建并推送,核验时 0 star。IGGT 数字带星号,不能和原文表格直接横比。
关联工作
- SAM 与 SAM2 提供可提示掩码和质量先验。SAM2 及视频物体分割依赖外观和时序连续,Table 1 的邻近视角说明这条路线在小幅运动下仍然强。SAM3 把提示扩展到概念,本文仍使用空间点。
- Mask3D、ODIN、Point-SAM 在点云或重建上做实例分割。Point-SAM 把可提示性带进三维,本文给它的是 VGGT 点图,而不是传感器深度。
- 离线关联包括投影、图割和把 SAM 提示放到三维。V2-SAM 把 SAM2 配上多提示专家做跨视图对应。SAM-V 在生成掩码之前注入几何,而不是只连接已经独立分好的掩码。
- IGGT、PanSt3R、FAST3DIS 在重建骨干上联合几何与实例。VGGT-Segmentor 在 VGGT 上另做分割头,并观察到提示不锚定时的投影漂移。SAM-V 不新训一个任务头,而是把几何送进 SAM 的图像特征和稀疏提示。