快速导读:Maum AI、SNU 与 Yonsei 提出无训练的 DeltaS,用门控 delta 循环状态的归一化漂移指导混合骨干全注意力 KV 淘汰,在六套长视频基准的有界设定上高于所列对照。
流式长视频理解要在有界内存里处理无限流。混合骨干把线性注意力的固定循环状态与全注意力的逐 token KV 缓存拼在一起:前者体积几乎不变,后者仍随流长增长,超时就要淘汰。问题是淘汰往往发生在问题到来之前,保留信号必须 query-agnostic。Taeyoun Kwon、Seungjin Kim、Hyeonyu Kim 与 Moon Hwan Kim 来自 Maum AI、首尔大学与延世大学,提出 DeltaS:用门控 delta 线性注意力状态的归一化漂移给视频块打分,决定全注意力层该留哪些 KV。论文是 arXiv:2609.27470 预印本。
代码仓库 https://github.com/MaumAI-Company/DeltaS 公开,撰写时约 1 star。作者报告:信号约占前向 1.9%,在六套长视频基准上相对最强无问题有界基线平均高 2.1 分,最长基准 LVBench 高 5.6 分;这些数字只覆盖 Qwen3.5-9B 与所列对照。
英文题目:DeltaS: Reading the Gated Linear Attention State for KV Cache Eviction in Streaming Video
论文出处:arXiv 每日论文精选 · arXiv:2609.27470
原始论文:PDF / 论文页面
这篇论文解决什么问题?
密集模型里 KV 是唯一随时间涨的记忆,淘汰分数只能从位置、注意力或键值表示里挖。注意力分数还常要代理查询或额外计算。混合骨干多了一份已经算好的循环状态:它在固定尺寸里跨多层、多时间尺度总结过去。
门控 delta 规则写入的是“输入相对状态已能检索内容”的残差,因此一块视频带来的新信息,会反映在状态变化幅度里。DeltaS 把这个变化量归一化成 state drift,优先保留漂移大的块对应的全注意力 KV。图 1 说明混合骨干涨得慢,但全注意力缓存仍会涨到需要 eviction;hybrid+KV eviction 才能把内存钉住。
设定要求训练免费、问题未知、预算固定。InfiniPot-V、StreamMem、HERMES 等属于同一赛道,但信号仍主要来自 KV 自身。DeltaS 的主张是:两份记忆可以协作——循环状态不只总结过去,还能指导 KV 留什么。
核心创新
- 把门控 delta 循环状态的归一化漂移用作无问题 KV 保留信号。
- 在共享预算与策略下证明该信号优于位置、注意力与键值基线。
- 用时间分桶缓解高漂移分偏向前段的问题,并保持极低额外开销。
方法概览
对每个视频块计算线性注意力状态的归一化漂移并赋分,保留 sink 与近窗后,按时间桶在剩余预算内取高分 token;答题前后保存/恢复流式状态以保持 query-agnostic。
- 骨干是冻结的 Qwen3.5-9B:24 层线性注意力与 8 层全注意力,约每三层线性插一层全注意力。所有线性层循环状态合计约 48 MiB;全注意力 KV 约每 token 增 32 KiB。淘汰只作用在全注意力层,预算 M 取 8192 或 16384 token。
- 视频按块到达。实验里 2 fps,每块两帧约一秒,约 98–112 个视觉 token 加 20 个时间戳 token。处理块前拷贝状态,prefill 后对每层状态算 Frobenius 范数差相对旧状态范数,再对层取平均得到块级 ∆S,赋给该块所有 token。
- 保留策略:固定留下前 ns=4 个 attention sink 与最近 nw=1024 token。剩余名额按到达时间划成 N=4 个等长时间桶,每桶按 ∆S 取 top。桶在每次淘汰时重算,不需要预知总时长;用原始到达时间而不是存活下标,避免反复淘汰后时间扭曲。存活 token 不重排位置下标,避免再旋转 key。
- 答题前保存流式状态,答完恢复,避免问题与回答写入污染后续淘汰,保持 query-agnostic。算法 1 总结整条循环。图 4 总览里,相似块 t170 的 ∆S 低被标灰淘汰,变化大的 t172 高分保留。
逐图理解论文
混合记忆仍要淘汰
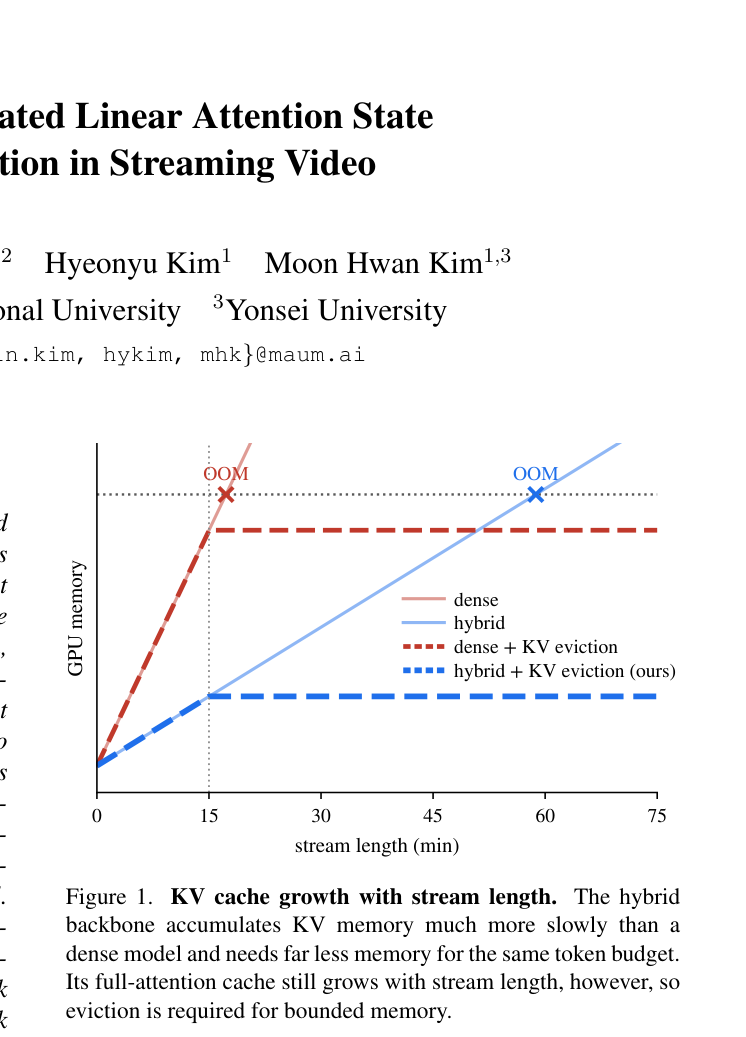
首页内存曲线。横轴流长(分钟),纵轴 GPU 内存。dense 很快触顶 OOM;hybrid 更慢但仍会 OOM;加 KV eviction 后两条虚线在预算处封顶,其中 hybrid+KV eviction(ours)封顶最低。裁切可能带作者与单位,不是图例。结论是:混合降低斜率,淘汰提供有界内存。
DeltaS
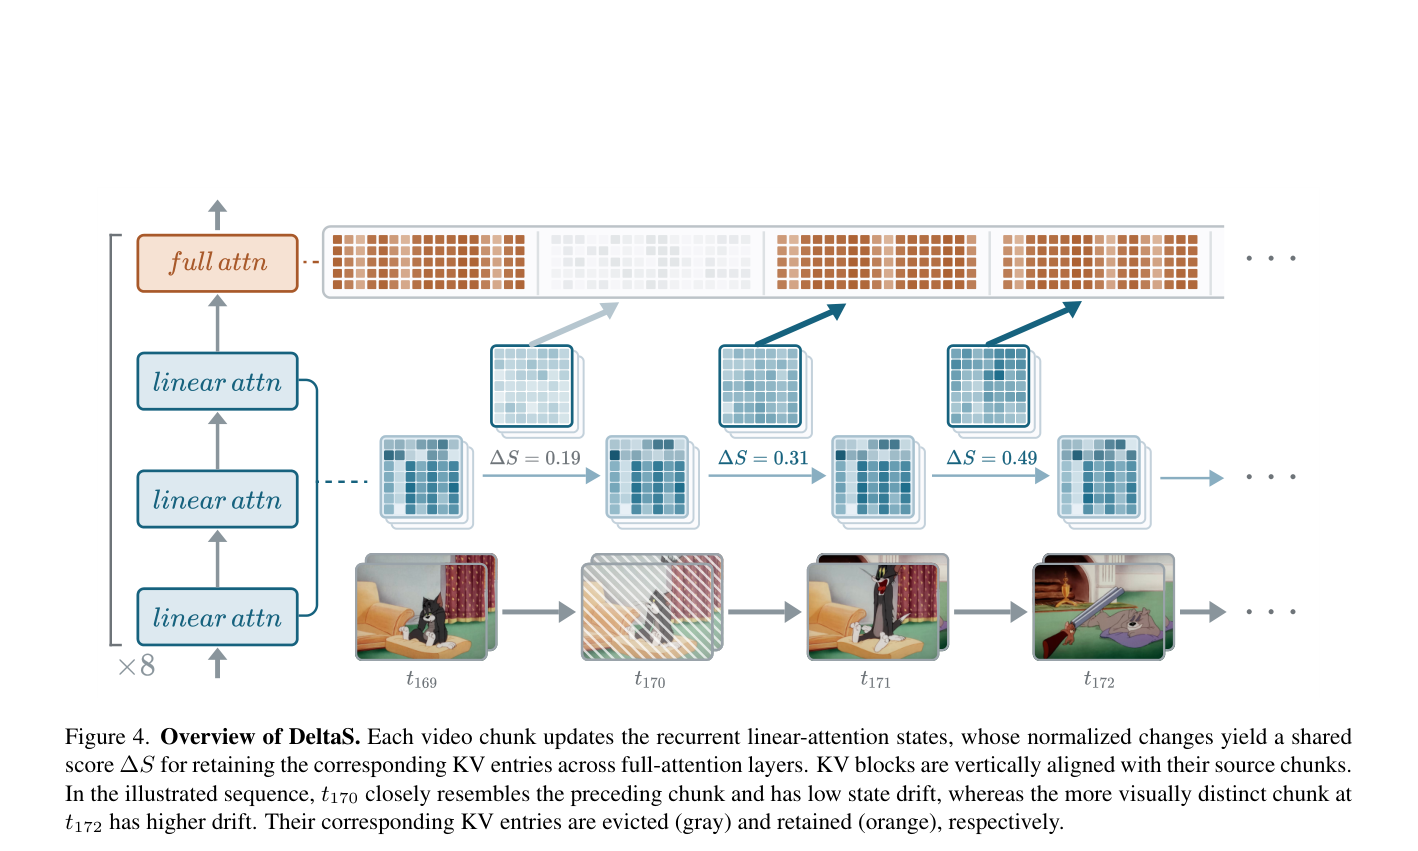
方法总览。左侧是线性注意力与全注意力交错的混合栈;右侧时间轴上 t169–t172 四块视频,中间蓝格是循环状态,标出 ∆S=0.19/0.31/0.49。上方全注意力 KV 条带与块对齐:低漂移的相似块被标灰淘汰,高漂移块标橙保留。用它理解“状态变化→共享保留分→各全注意力层共用排序”。猫与卡通帧是示意,不是某基准分数。
主结果
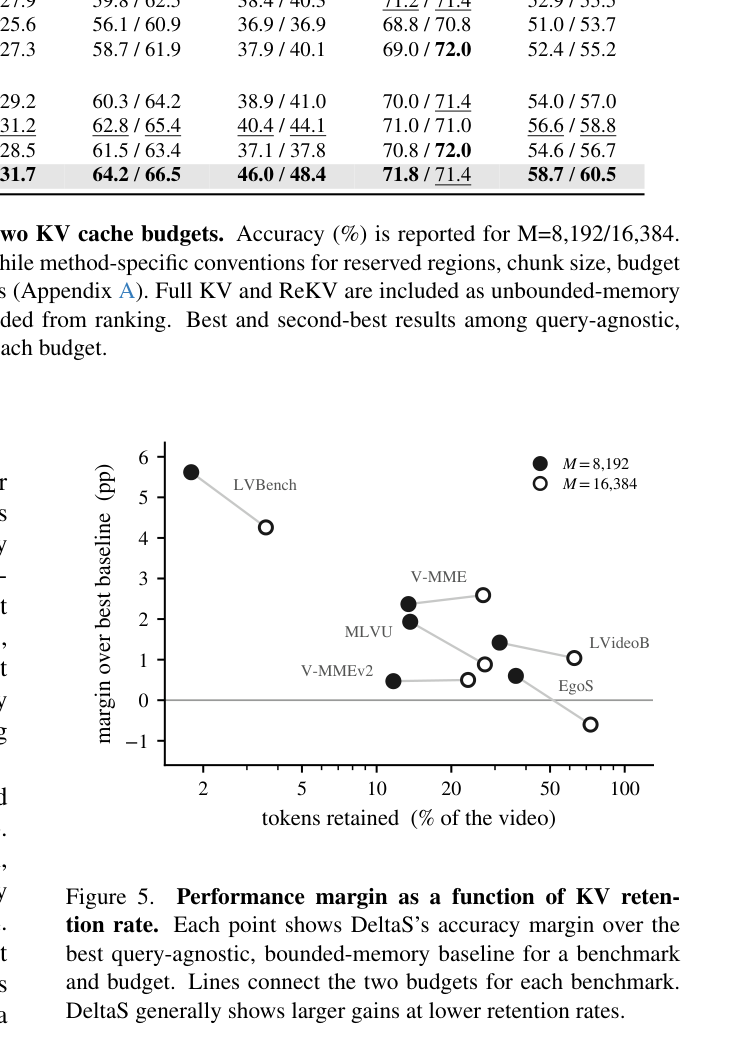
图 5:横轴保留率(对数),纵轴相对最强有界基线的百分点领先。实心/空心点对应 M=8192/16384,灰线连同一基准两点。LVBench 在低保留率端领先超过 5 分;高保留率端差距收窄。上沿可能裁到表 1 底行,读图时以坐标轴与点标为准,不要把残片正文当数据源。
实验如何设计?
- 六套基准:MLVU、Video-MME、Video-MME v2、LongVideoBench、LVBench、EgoSchema(公开 500 子集)。视频按时间块预填,问题只在最后一块之后给出。Video-MME 与 LongVideoBench 不用字幕。指标是准确率百分比。
- 有界无问题对照:InfiniPot-V、StreamMem、HERMES,外加 random/recency/uniform。另列 Full KV(不淘汰)与 query-aware 的 ReKV 作参考,不参与有界排名。各方法尽量保留原设计的块大小、预留区与头聚合,只改编混合骨干上无法直接套用的部分。
- 表 2 在共享预算 M=8192、相同 sink/window 与时间桶策略下,对比位置、注意力、键值与状态类信号。效率实验在单卡 A100 上对约 4730 秒 MLVU 视频流 600 步,报告发生淘汰时的中位额外延迟。
关键结果与论文证据
- 表 1:M=8192 时 DeltaS 在六套基准的有界无问题方法里全员第一,平均 58.7,比最强基线 StreamMem 的 56.6 高 2.1 分;该紧预算平均几乎贴上 StreamMem 在 M=16384 的 58.8。M=16384 时平均 60.5,仍在五套上第一,平均领先 1.7 分。
- LVBench 最长:M=8192 上 DeltaS 46.0,相对最强有界基线高 5.6;M=16384 高 4.3。较短的 EgoSchema 上差距收窄。图 5 把领先幅度对保留率作图:同一预算在不同基准上保留率从约 1.8%(LVBench)到 36.4%(EgoSchema),整体是保留越少、领先越大;Video-MME v2 例外,两边都大约只高 0.5。
- 表 2 控制变量:DeltaS 在 LongVideoBench/MLVU/LVBench 为 64.2/70.6/46.0,高于最强缓存内信号 VaN 的 63.4/68.9/44.0,也高于状态基线 β∥e∥ 的 63.6/69.4/44.9。说明归一化净状态变化比只看写入幅度更有用。
- 时间分桶把保留质量在时间轴上拉得更均匀;N=4 在三套基准平均增益最大。效率上状态漂移信号 2.07 ms,约等于参考块前向 107 ms 的 1.9%;含选择与淘汰总额外 6.4 ms,低于 InfiniPot-V 的 15.4 ms,也远低于若干注意力型方法。
阅读时需要注意
- 只在一个混合骨干 Qwen3.5-9B 上验证,换架构或尺度是否成立未证明。
- 对 state drift 的解释依赖门控 delta 的残差写入;其他状态更新规则是否同样好用需要另测。
- 一块共用一个分数,无法在块内区分更重要的空间区域;更细粒度打分是自然延伸。
- 部分流式基准上无记忆近窗甚至可高于 Full KV,说明总分不总能孤立长程保持能力;作者因此另报短上下文基线并分开分析需早先证据的任务。
关联工作
- 训练型流式方法与蒸馏长上下文属于另一条线;DeltaS 明确站在冻结模型、推理期有界内存。
- ReKV、LiveVLM、StreamKV 等可在问题到达后检索,超出本文的 query-agnostic 约束。
- HOLA 用 delta 写入幅度并改架构再训练;DLA 用归一化状态差切边界。DeltaS 不改记忆模块、不训练,只读现成循环状态来指导全注意力 KV。