快速导读:FAU Erlangen-Nürnberg 用辐射加深度的 VAE 先验,把室内光照解码成可微渲染可用的 2.5D 面光源,在合成探针与潜码拟合上高于远处环境图先验;预印本,代码待核验。
室内逆渲染要估计光照时,常见做法是把环境写成一张远处环境图。环境图只对方向编码,放两处不同位置的物体时,往往没法同时对上两边的外观。Andreea Ardelean 与 Bernhard Egger 来自 Friedrich-Alexander-Universität Erlangen-Nürnberg。他们提出 RoomLight:先用卷积 VAE 在真实室内全景上学习辐射加深度的联合潜空间,再把解码结果抬成 2.5D 面光源,接进可微渲染做分析—合成拟合。论文是 arXiv:2609.28300 预印本。
关键页给出 https://andreead-a.github.io/RoomLight 。PDF 没有独立代码仓库地址,开源状态待核验。作者在贡献与结论里强调:同一潜码同时约束外观与发射体几何,使室内光照恢复比远处环境图先验更贴合位置相关效果;表内数字只覆盖所评设定。
英文题目:RoomLight: A 2.5D Illumination Prior for Indoor Environments
论文出处:arXiv 每日论文精选 · arXiv:2609.28300
原始论文:PDF / 论文页面
这篇论文解决什么问题?
从有限视场图像恢复场景光照,是材质估计、重打光和物体插入的基础。几何、反射与光照在成像里耦合,问题本身不适定。任意表面点会从几乎所有方向接收光,很多来自相机视野外,动态范围又高。
主流表示是球面环境图:在单点按方向存入射辐射。它能保住高频镜面高光,但按构造是空间不变的,默认光源在无穷远。室外日光大致成立,室内不行:近处灯有视差,平方反比与遮挡都会让光照随位置变,一张环境图盖不住整个光场。
图形学用视差校正立方体贴图,把环境贴到球或盒子上,但代理几何对不上真实室内布局。作者改用深度:把 HDR 全景投影到由深度重建的网格上,得到 2.5D 面光源,也有工作叫 emissive mesh。多一个深度通道,发射体就从“只有方向的函数”变成空间里的面,光照自然随位置变。图 1 用两个金属兔子说明:再怎么换环境图捕捉点,也难同时复现两只兔子;2.5D 面光源可以。
2.5D 表示能进可微渲染,但从单图恢复比恢复环境图更欠约束:要估辐射也要估几何,多数方向又看不见。直接像素级优化容易过拟合成噪声。已有学习先验把无约束像素格换成紧凑潜空间,但这些先验仍然是方向型的,解码不出发射面有多远。缺口是:室内需要的表示没有先验,现有先验又表达不了它。
核心创新
- 为室内场景学习同时解码 HDR 辐射与径向深度的可优化潜空间先验。
- 把解码对抬成封闭 2.5D 面光源,使光照随位置变化并可直接接入可微渲染。
- 用 VENI+D 等对照把“加深度表示”与“先验结构”分开,展示潜码约束相对像素级平滑的增益。
方法概览
在 HDR 与对齐深度全景上训练卷积 VAE,潜码解码辐射与深度并抬成 2.5D 面光源。拟合时冻结解码器,优化 z 与曝光,经 Mitsuba 3 回传光度损失,并加发射体与场景的排斥项。训练损失含 L1、梯度金字塔、峰值尾部与退火 KL。
- RoomLight 在等距柱状 HDR 全景上训练 VAE,并额外加入对齐的径向深度通道。一个全局潜码 z 概括整间环境。解码得到辐射图与深度图,再按 Sec. 3.1 抬成带发射纹理的封闭三角网格。下游光照恢复时丢掉编码器、冻结解码器,只优化 z 与对数曝光 s,自由度是 512+1。
- 发射体构造:像素 (u,v) 对应方位角与极角,得到单位射线方向 ω,再用深度 D 得到顶点 p=D·ω。邻域像素连成四边形再三角化;极点附近用边界行质心补两个极点顶点,把网格封成封闭拓扑。辐射纹理贴在网格上,供 Mitsuba 3 一类可微渲染器直接当面积光。
- 编码器是卷积 stem 加四级步长残差下采样,GroupNorm 与 SiLU;特征投影成对角高斯后验,用重参数化采样 z。解码器对称上采样,并用 Adaptive Group Normalization 注入全局上下文。等距柱状拓扑上有两点:圆周用 circular padding,过极点时反射并滚动 W/2;输入再拼上 (cos θ, sin θ) 两个纬度通道,减轻平移等变卷积与纬度统计不匹配。
- 训练前把全景曝光校准到单位对数平均亮度,把尺度不变性放进数据而不是损失。辐射用 log(1+L),深度用 log D,再按数据集统计标准化。总损失是辐射与深度的 L1、四级金字塔上的 Scharr 梯度项、峰值亮度尾部的 Lpeak,以及退火的 KL。Lpeak 覆盖预测与真值最亮 0.5% 像素的并集,在对数域做 L1,约束漏掉或幻觉的强光源。β 从 0 线性升到 1e-3,warmup 1000 步。
- 拟合阶段:已知几何、材质与姿态时,用解码出的 2.5D 面光源渲染观测,光度损失在物体像素上算 L2 与对数 L2;饱和像素对渲染做审查,只提供下界约束。另加排斥项,防止发射网格穿进场景几何。更一般的真实照片设定里,几何来自单目深度网格,材质用统一的 albedo–roughness–metallic,与 z、s 一起优化。
逐图理解论文
远处假设的缺口
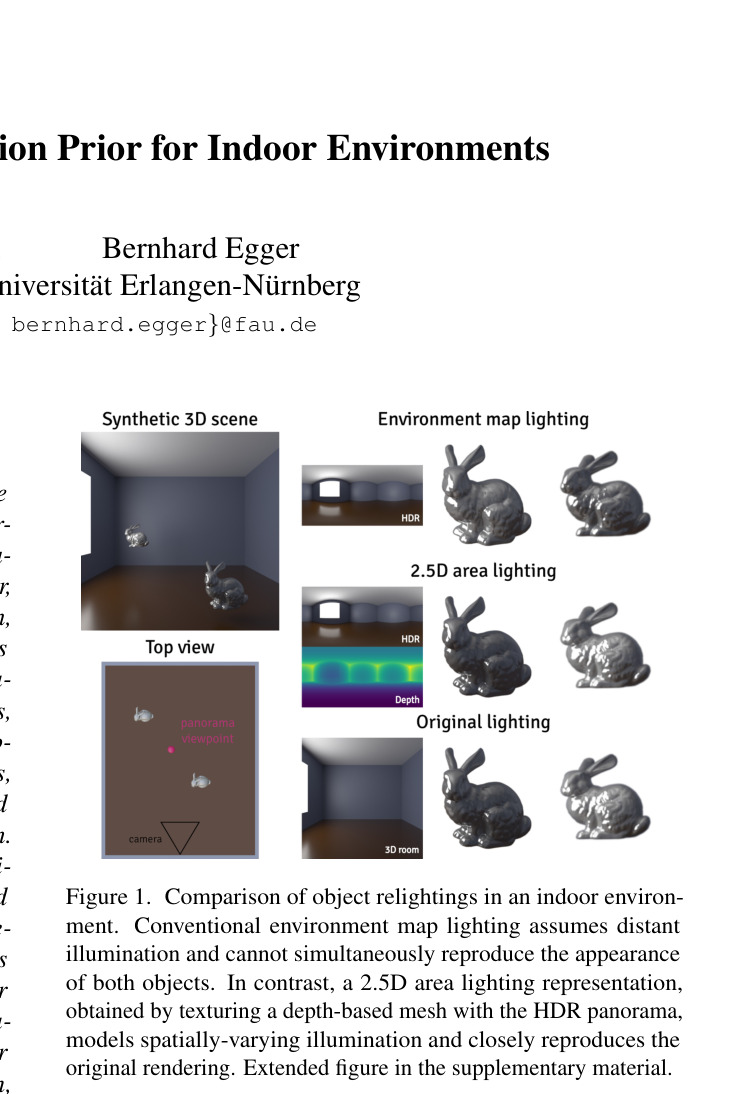
首页动机图。左侧室内两只金属兔子与俯视布局,红点是全景捕捉点。右侧三行:Environment map lighting 只有 HDR 条带,两只兔子外观几乎一样;2.5D area lighting 多了 Depth 热图,高光随位置分开;Original lighting 是完整三维房间真值。图注强调远处假设无法同时复现两物体,深度网格可贴出空间变化光照。裁切可能带作者行,不是实验分数。
2.5D 先验
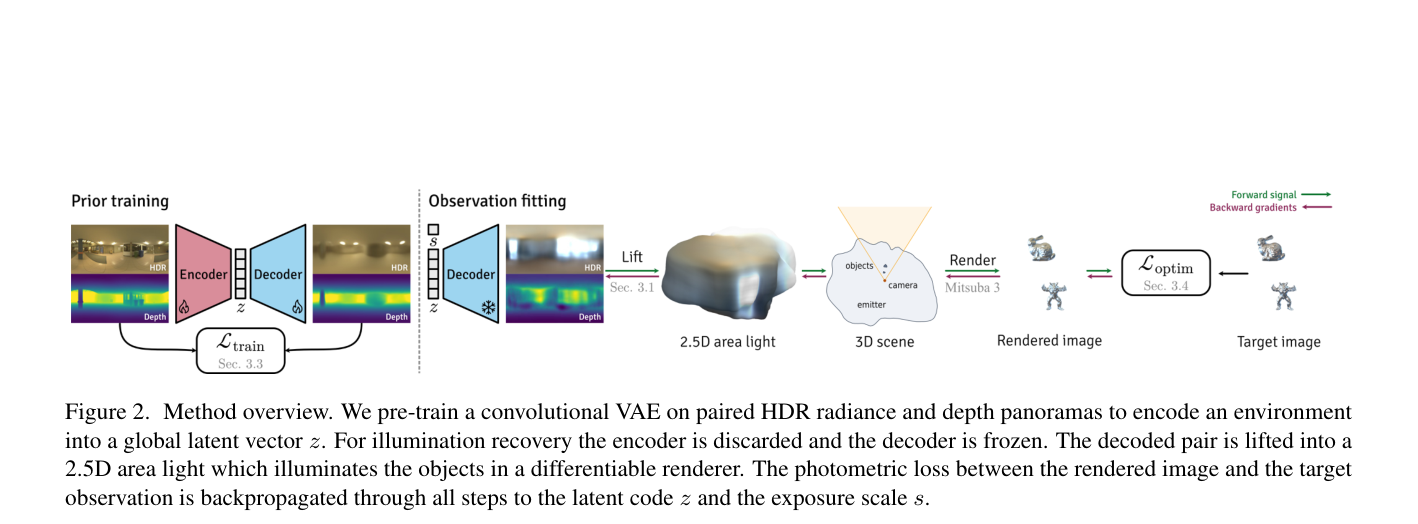
方法总图。左侧 Prior training:HDR 辐射与 Depth 全景进 Encoder,得到全局 z,Decoder 重建并对 L_train;火焰图标表示训练解码器。右侧 Observation fitting:只保留雪花图标的冻结 Decoder,输入可优化的 z 与曝光 s,解码后再 Lift 成 2.5D area light,经 Mitsuba 3 渲染,与 Target image 比 L_optim;绿箭头前向、红箭头回传梯度到 z 与 s。用它看清先验训练与观测拟合两段,不要把示意房间当成定量结果。
Figure 5
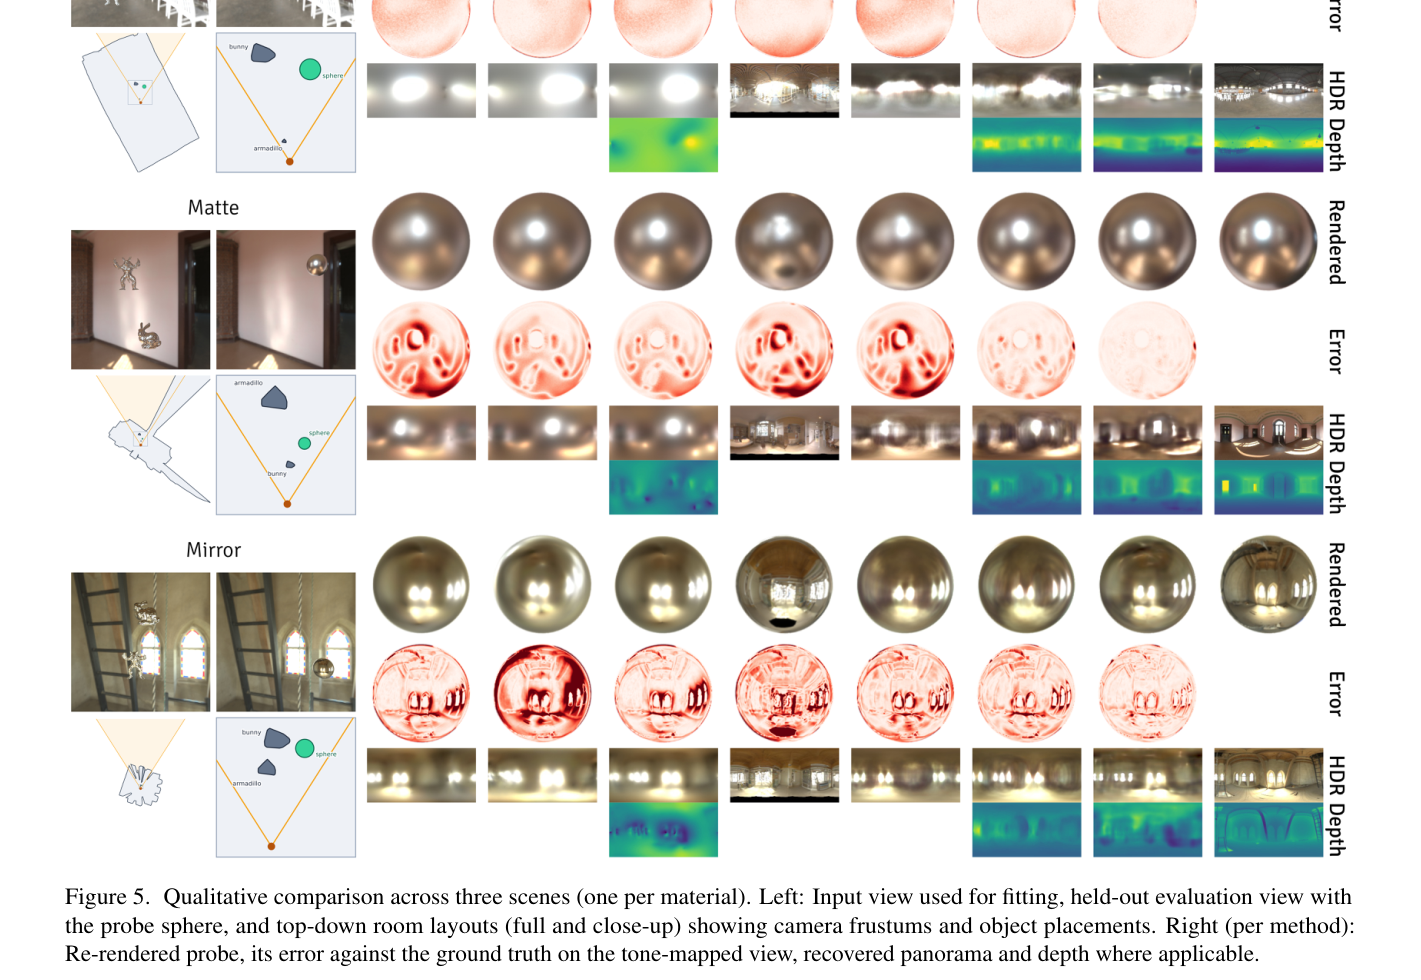
合成定性对比,三行对应不同材质探针。左侧是拟合输入视角、带探针的留出评价视角,以及相机锥与物体摆放的俯视图。右侧按方法列出示意渲染探针、相对真值的误差热图、恢复的 HDR 全景,以及有深度时的深度图。平滑方法常出现稀疏亮斑与无结构深度;靠右的数据驱动 2.5D 列反射更清晰、误差更白。图本身不印表 2 数字,列名需对照正文方法表。
实验如何设计?
- 训练数据来自 Laval Indoor HDR。作者用 LaMa 补 nadir 盲区,并用 MoGe-2 在多个切平面视角估计深度再融回全景,得到 2233 个训练样本。评测全景来自另一来源 Poly Haven 的 25 张室内 HDR,深度仍用同一估计流水线。
- 对照分三类。单图估计器 DepthLight 与 4D Lighting:输出是直接预测,没有可对观测优化的低维潜码。直接优化:在相同分辨率下优化辐射与深度像素(约 13 万参数),或换成固定半径球面代理、纯环境图,并用 NeRFactor 式平滑约束。可微渲染拟合的先验:DPI、在同一室内划分上训练的 VENI,以及作者自建的 VENI+D(给 VENI 加深度通道,共享 2.5D 发射体与拟合流程,只换先验结构)。
- 先验本身评测(表 1)报告 LDR 的 PSNR/SSIM/LPIPS、线性 HDR 的 PSNR,以及深度 AbsRel;协议分 Encoder 前向与冻结解码器的 Latent fit。逆渲染合成实验(表 2)用 25 场景 × 三种材质(灰漫反射、银哑光、银镜面)共 75 例;拟合用 bunny 与 armadillo,评测用探针球,指标是 tone-mapped PSNR、线性 RMSE 与每像素 RGB 角误差。真实照片实验只有定性:插入多处虚拟镜面探针,并在可估计材质时重渲染分割物体。
关键结果与论文证据
- 表 1 的 Latent fit:Ours 的 LDR PSNR 25.34、SSIM 0.751、LPIPS 0.422、HDR PSNR 37.12、AbsRel 0.045。VENI 为 21.37/0.701/0.526/33.16;VENI+D 为 21.92/0.713/0.520/33.64/0.092。Encoder 前向同样是 Ours 更高。Smoothness 与 DPI 没有紧凑瓶颈,分数只反映平滑强度或引导信号,不能当成紧凑表示的保真度。
- 表 2 探针球:Ours(2.5D AL)在漫反射/哑光/镜面的 LDR PSNR 为 33.63/30.41/22.85,RMSE 为 0.089/0.272/2.150。VENI+D 为 32.75/28.24/21.17 与 0.113/0.391/2.364。VENI 环境图明显更低。正文写近场建模带来实质增益;Ours 在几乎所有情形领先,角误差在漫反射与镜面上不是第一——角误差无尺度,可能颜色对但强度错,会在 RMSE/PSNR 上露馅。
- 图 5 定性三行材质:平滑先验的辐射常塌成少数亮斑,深度变成低频场;数据驱动先验更有房间结构。图 3 从标准正态采样,解码后的 2.5D 面光源能照出位置相关外观。图 6 真实照片上,环境图方法的探针处处同一辐射;2.5D 面光源随探针朝向反映不同房间区域。DepthLight 与 4D Lighting 也有位置相关探针,但光照不由物体外观联合约束,也不能与材质一起恢复。
- 补充材料表 3 量化表示上限:相对完整光传输,2.5D 面光源的探针 RMSE 约为环境图的二分之一到五分之一,但仍远高于渲染噪声地板。这界定了任何基于该表示的方法,包括 RoomLight,能恢复的上限。
阅读时需要注意
- 2.5D 面光源每个方向只有一个辐射和一个距离,深度间断会被三角片焊死前景与背景;站在物体之间的灯也无法正确表达。等距柱状采样在极点附近三角又密又小,赤道附近细节却可能不够。
- 拟合依赖排斥项避免发射体与场景相交;它需要一批场景点测间隙,治的是症状:完美恢复的环境本应包住场景而不相交。真实设定里几何与材质也是估出来的,量化指标不如合成表 2 干净。
- 训练深度是伪真值,来自单目估计器融合,不是激光真值。PDF 只给项目页,没有可核验的独立代码仓库,复现实验与权重加载状态待核验。
关联工作
- 低阶球谐与球面高斯紧凑但带宽有限;近期逆渲染常直接优化无约束环境图像素格,表达力上来,正则不足。RoomLight 用低维潜码换表达力与可优化性之间的折中。
- 学习环境图先验从卷积自编码器、变分自解码器到大规模 VAE 与 DPI 扩散后验,大多仍输出全局方向估计。室内空间变化路线包括逐像素 SH/SG、局部 HDR、体素 SH,以及探针修复或全景外绘再抬成发射网格;后者多为任务直出预测,不是可嵌进分析—合成回路的可优化先验。
- VENI+D 是作者为隔离“表示”与“先验结构”而造的对照:共享 2.5D 发射体与拟合,只换解码器家族。表 1 与表 2 里 Ours 仍高于 VENI+D,说明增益不只来自加深度通道。