快速导读:NVIDIA 相关作者组提出 TRACK:离线标定大/小去噪器逐步预测分歧,把低分歧步路由给小模型,Wan/Cosmos/Turbo/FastVideo 上报告 1.95×–2.73× 加速且聚合质量可比。
视频扩散每一步都要跑一遍大去噪器,即便做了步数蒸馏,留下的每一步仍昂贵。NVIDIA 相关作者组 Mustafa Munir、Huy Vu、Shreyas Misra、Rohit Jena、Sajad Norouzi、Ali Taghibakhshi(Project Lead)等提出 TRACK(TRajectory-Aware Capacity routing via top-K selection,arXiv:2609.30096,预印本):在共享潜空间与调度器的大/小检查点之间,用离线标定的逐步切换策略,把质量敏感步留给大模型、低分歧步路由到小模型;在线推理每步只评估一个去噪器,无需重训、改结构、改调度器,也不做在线双模型评估。
正文 Table 1 在同一 250 条提示上报告:Wan 2.1(30/50 步切小)加速 1.95×;Cosmos 3 Super/Nano 与 Super/Edge(24/35)分别为 2.04× 与 2.73×;TurboDiffusion(3/4)2.69×;FastVideo(2/3)2.17×,VBench 聚合质量与全大模型基线相当。文中未见独立公开代码仓库;本次解读将代码状态记为待核验,加速数字一律以正文表为准,不作外推夸大。
英文题目:Accelerating Video Diffusion via Training-Free Trajectory Routing
论文出处:arXiv 每日论文精选 · arXiv:2609.30096
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Wan 2.1、Cosmos 3 等系统能出高保真运动,但推理要对高维时空潜变量反复执行数十亿参数模型。同族通常还有更小检查点,更快但质量更弱,自然问题是:能否按步选择性结合小模型速度与大模型质量?
多数加速要么蒸馏减步数,要么在单次评估内做缓存/稀疏计算。步数定下来后,剩余评估仍被均匀分给同一模型。模型切换则降低剩余步的平均评估成本,可与减步互补;作者在三步 FastVideo 与四步 TurboDiffusion 上也验证了这一点。
朴素按时段永久切换或单调交接,抓不住轨迹上空间细节、相机运动与帧间一致性在具体步上的分歧。未标定的容量削减还可能改变结构承诺并塌缩样本多样性。因此需要在检查点对上做逐步可切换性识别。
核心创新
- 把大—小切换从单次永久交接推广为分歧标定、固定预算的逐步 Top-K 分配,支持非连续日程。
- 离线参考轨迹标定,在线零双模型评估,兼容多步与少步蒸馏管线。
- 等预算对照显示相对 First-K/Random-K 显著更好的多样性保留。
方法概览
TRACK 在标定集上滚全大参考轨迹,逐步对同一潜变量比较大小引导预测的归一化分歧,Top-K 低分歧步交给小模型;在线每步只评估一个去噪器,无重训与在线双模型。
- 兼容对需共享潜表示、输出形状、条件接口、预测目标与调度语义;例:Wan 族 14B 与 1.3B。TRACK 只改哪一个去噪器提供引导预测,不改时间步序列与调度器状态演化。
- 离线标定:在小标定集上用大模型滚出参考轨迹;每步更新前,对同一参考潜变量、时间步、条件与引导同时评估大小模型,记录归一化相对分歧(小模型预测相对大模型预测的 L2,再按大模型预测范数归一)。沿轨迹只让大模型推进,保证探测点始终在全大参考路径上。聚合各标定提示得到每步分歧分数 q_k。
- 固定切换预算 K 时,把 q_k 最低的 K 步分给小模型,其余留给大模型;这等价于约束轨迹分歧最小化的 Top-K 离散解。推理严格按离线策略执行,每步只跑一个检查点,在共享潜变量与调度器状态间切换。
- Fig.1 上半画离线标定与分歧聚合得到路由表,下半画在线推理:质量敏感步用绿(大),低分歧步用紫(小),可非连续,且每步单去噪器。
逐图理解论文
容量冗余
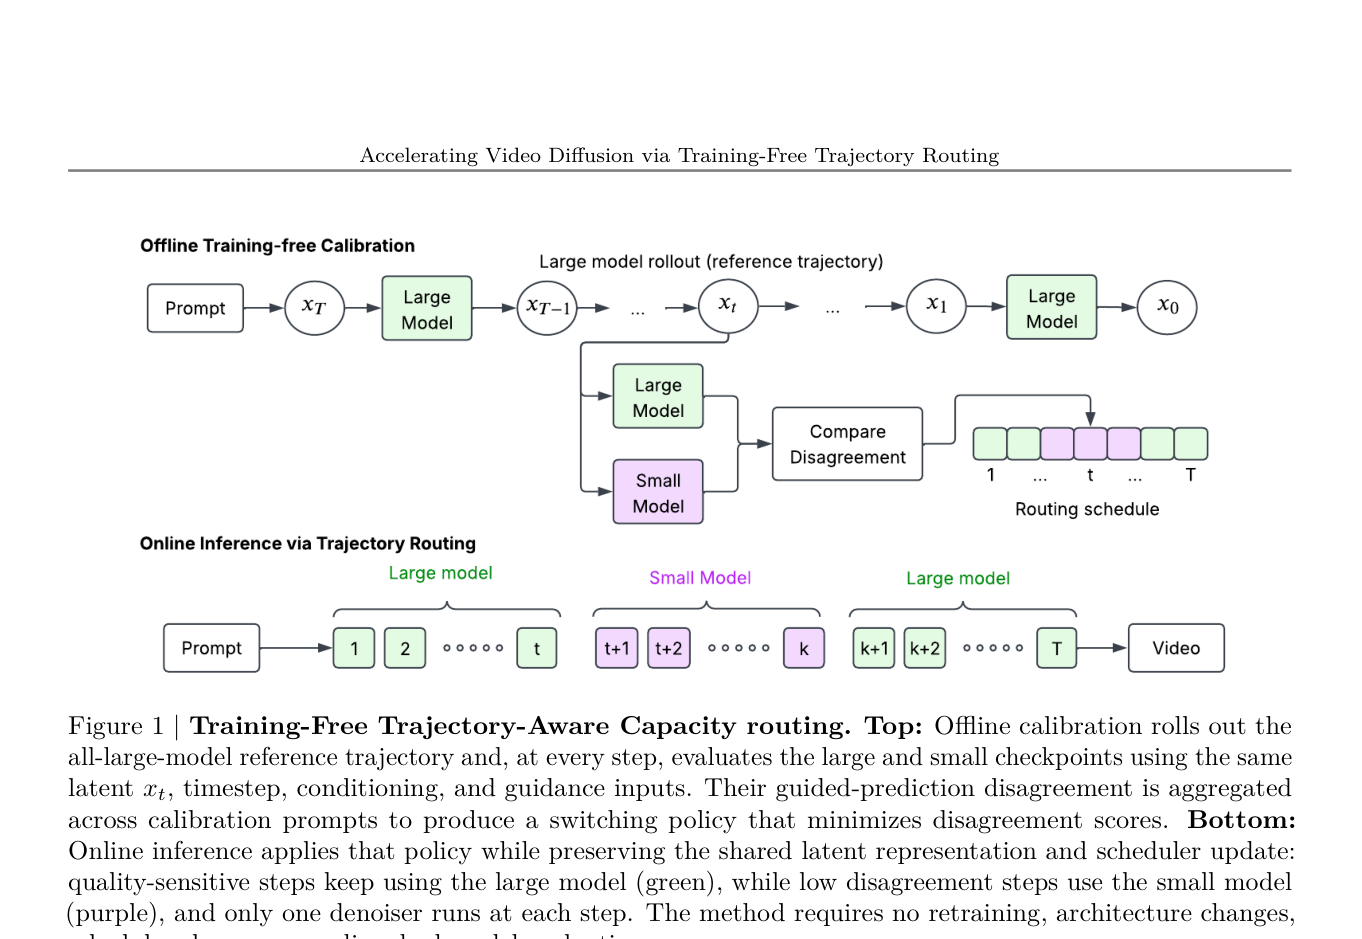
方法总览。上:Prompt 驱动大模型参考轨迹,逐步对同一 x_t 比较大/小预测分歧,聚合出绿/紫路由表。下:在线按表推理,质量敏感步用大、低分歧步用小,输出视频;强调无重训、每步单去噪器。适合做特色图。
主表加速
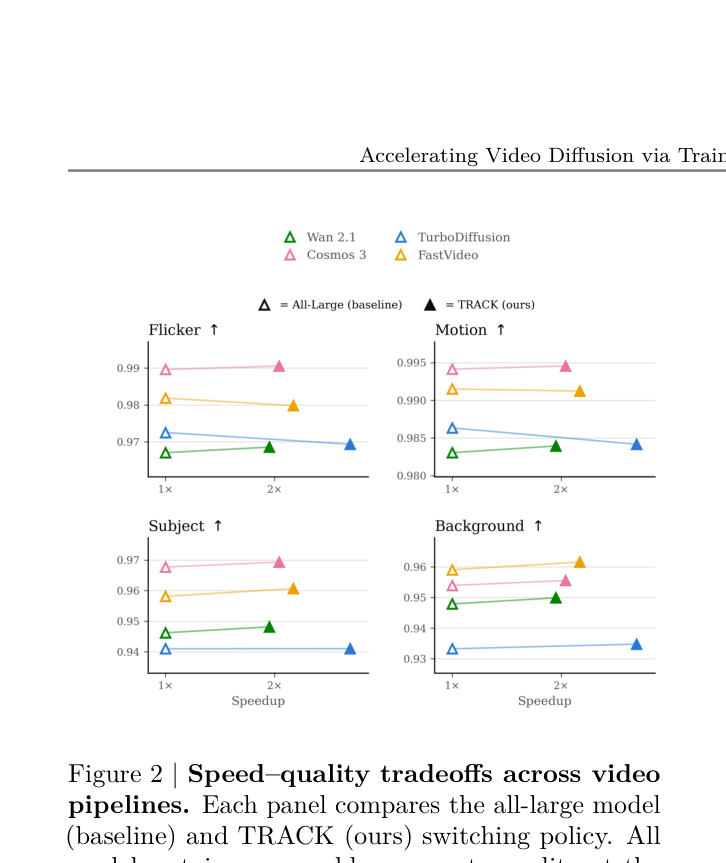
四宫格速度—质量图。空心三角为全大 1×,实心三角为 TRACK 加速点;颜色区分 Wan 2.1、Cosmos 3、TurboDiffusion、FastVideo。纵轴分别为 Flicker、Motion、Subject、Background(越高越好)。用来对照 Table 1 的加速区间与质量保持。
等预算对照
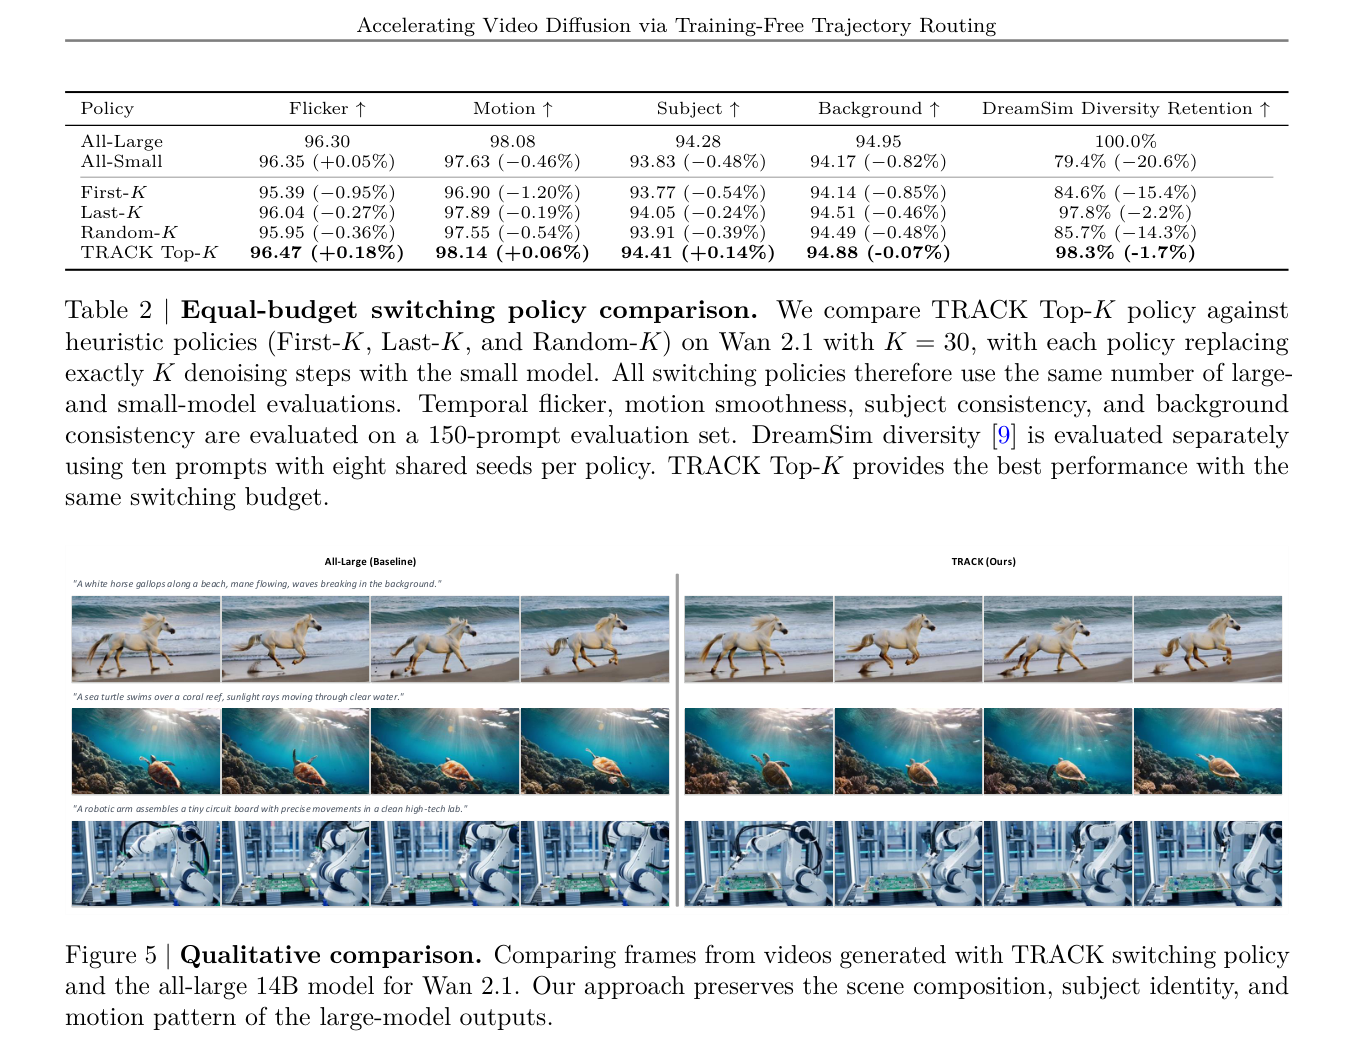
定性对比:Wan 2.1 上全大 14B 与 TRACK 在白马海边、珊瑚礁海龟、实验室机械臂三组提示上的帧序列。同页裁切上方还可见 Table 2 等预算切换数字(含 TRACK Top-K 多样性 98.3%);读图时区分表与定性帧,勿把表头误当成生成画面。
实验如何设计?
- 主表覆盖 Wan 2.1(50 步)、Cosmos 3(35 步,Super/Nano 与 Super/Edge)、TurboDiffusion(4 步)与 FastVideo(3 步);统一生成 81 帧、480×832 视频。质量用 VBench 的 temporal flicker、motion smoothness、subject consistency、background consistency,同一 250 提示。
- Table 2 在 Wan 2.1、K=30 等预算下对比 All-Large、All-Small、First-K、Last-K、Random-K 与 TRACK Top-K;质量在 150 提示集上评,DreamSim 多样性另用 10 提示×8 共享种子。Fig.5 给定性帧对比。
- 另有空间与潜时空频率分析解释可替换性的相位依赖,以及能耗估算;局限写明需同时驻留大小模型。
关键结果与论文证据
- Table 1:Wan TRACK 30/50 → 1.95×,Flicker/Motion/Subject/Background 为 96.86/98.39/94.81/94.99,相对全大 96.71/98.31/94.62/94.79 略升或持平。Cosmos Super/Nano 2.04×(99.06/99.46/96.93/95.55);Super/Edge 2.73×(98.33/98.98/97.24/95.04)。Turbo 3/4 → 2.69×;FastVideo 2/3 → 2.17×。勿把摘要区间误读成单一标称倍速。
- Table 2(K=30):TRACK Top-K Flicker 96.47、Motion 98.14、Subject 94.41、Background 94.88,DreamSim 多样性保留 98.3%(相对全大 -1.7%);First-K 多样性仅 84.6%,Random-K 85.7%。等预算下启发式切换明显更伤多样性。
- Fig.2 四条管线的速度—质量散点显示 TRACK 在约 2× 乃至更高加速处仍贴近全大指标带。Fig.5 白马、海龟、机械臂场景上,TRACK 与全大 14B 在构图、主体与运动模式上肉眼接近。
- 能耗讨论写 Cosmos Super/Edge 上可降能耗近 60%、每千条视频约省 35.41 kWh 等;属作者测量协议下的估算,解读不当作独立复现结果。
阅读时需要注意
- 与其他切换方法类似,部署需同时保存大小两个检查点,显存高于单模型流水线。
- 策略来自离线标定集上的分歧图,换硬件、分辨率或提示分布时可能要重标定。
- 兼容前提是同族可互换检查点;跨架构、跨潜空间不可直接套用。
- 文中未给出独立可核验的公开代码入口;加速与多样性数字均应回查 Table 1/2,勿二次夸大。
关联工作
- 步数蒸馏(FastVideo、TurboDiffusion 等)与缓存/稀疏计算降低单次评估成本;TRACK 保留目标采样器与步数,改平均模型容量,二者互补。
- T-stitch、SRDiffusion 等代表固定时段或启发式大—小交接;TRACK 用分歧标定做固定预算的逐步 Top-K 分配,允许非连续日程。
- 多专家或自适应计算常需特训或改结构;TRACK 强调训练免费、只换去噪器身份。