快速导读:FLIPDIR 从答案翻转对比对估计低秩翻转子空间,并在边际门控的解码步衰减该分量;VISFLIP 按模型与扰动构造恢复/保持评测组,在 18 个设定上平均抬高调和均值约 2.8 分。
视觉语言模型在科学推理、机器人场景和医学 VQA 上已经很强,但真实世界很少给你“干净原图”。轻微曝光、白平衡、JPEG、镜头污渍或医学窗宽变化,肉眼几乎无感,却能在长程生成里改写中间词,最终把答案翻掉。作者把这种现象叫做 answer flip:它不是经典对抗攻击,也不是明显坏图。
论文提出训练无关的推理期方法 FLIPDIR:用原图与致翻图的隐藏状态差做 SVD,得到低秩翻转子空间;解码时只在 top-2 边际变窄的不确定步,把当前状态在该子空间上的分量衰减掉。同时提出 VISFLIP,按目标模型把样本分成 clean / flip / non-flip,分别量保持与恢复,主看调和均值 H。
在 Qwen3-VL-8B 与 Gemma-3-12B 的 18 个设定上,FLIPDIR 相对最强基线平均提升约 2.8 个 H 分,最大约 6.3 分。作者声明将公开基准与代码,但本稿无独立仓库链接,公开状态待核验。预印本,机构含 KAIST、NAVER Cloud 等。
英文题目:Looks the Same, Answers Differently: Flip-Direction Steering for Robust Vision-Language Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2609.28851
原始论文:PDF / 论文页面
这篇论文解决什么问题?
可靠性研究常盯对抗、安全拒绝或明显损坏;日常管线里的细微视觉变化对长程视觉推理的影响仍被低估。Table 1 显示,即便 GPT-5.5、Claude Opus 4.8 在曝光扰动下也有可观翻转率,开源模型更高。
准确率会奖励“碰巧把错答改正”的扰动;固定集高一致性可能只因扰动太弱。要把稳健性说清楚,必须按该模型实际是否改答案来分组,并分开报告恢复与保持。
Figure 1 用 Robo2VLM 机械臂抓取题说明:几乎相同的图像下,Qwen3-VL-8B 在 a / another 处分叉,最终从 (A) 翻到 (E)。早期分叉局部仍通顺,难以及时发现该不该干预。
核心创新
- 把 answer flip 写成可估计的低秩激活子空间,而非再训练或改权重。
- 用 top-2 边际门控,只在不确定解码步衰减翻转分量,减少误伤稳定预测。
- 提出 VISFLIP:按模型与扰动构造评测组,分开报告恢复与保持。
方法概览
离线收集原图与致翻扰动的对比激活差 δ=h̃−h,SVD 取低秩基 U 作为翻转诱导子空间;推理时先看 top-2 token 概率边际,仅当门控打开时做 h′=h−αUU⊤h,否则保持原分布。VISFLIP 按目标模型把样本划为 clean / flip / non-flip 组,主指标为保持率与恢复率的调和均值 H。
- 离线校准:对冻结 VLM,搜集“同一问题 + 原图/致翻图”且最终答案改变的对比对,抽取成对提示激活,算 δ_i = h̃_i − h_i,堆叠后 SVD,取 top-K 右奇异方向组成 U,得到 S_flip = span(U)。估计一次,推理只存基。
- 在线转向:每步先做未编辑前向,读 top-2 概率边际 m_t。边际足够大则门控关闭,直接用原 next-token 分布;边际落入不确定区间则打开门控,令 h′ = h − α UU⊤ h,相当于削弱翻转平面内分量、推向正交补。
- 超参:秩 k、层 ℓ、强度 α 与门限在验证集上选;测试集只做最终报告。消融表明对比子空间与边际门控都有助于恢复—保持平衡。
- VISFLIP:选定模型、数据与扰动后,生成子图并按是否改变原预测划分 flip / non-flip;覆盖科学推理、机器人、医学三域共九种数据—扰动组合。主指标 H 为 C、N、F 的调和均值。
逐图理解论文
失败直觉
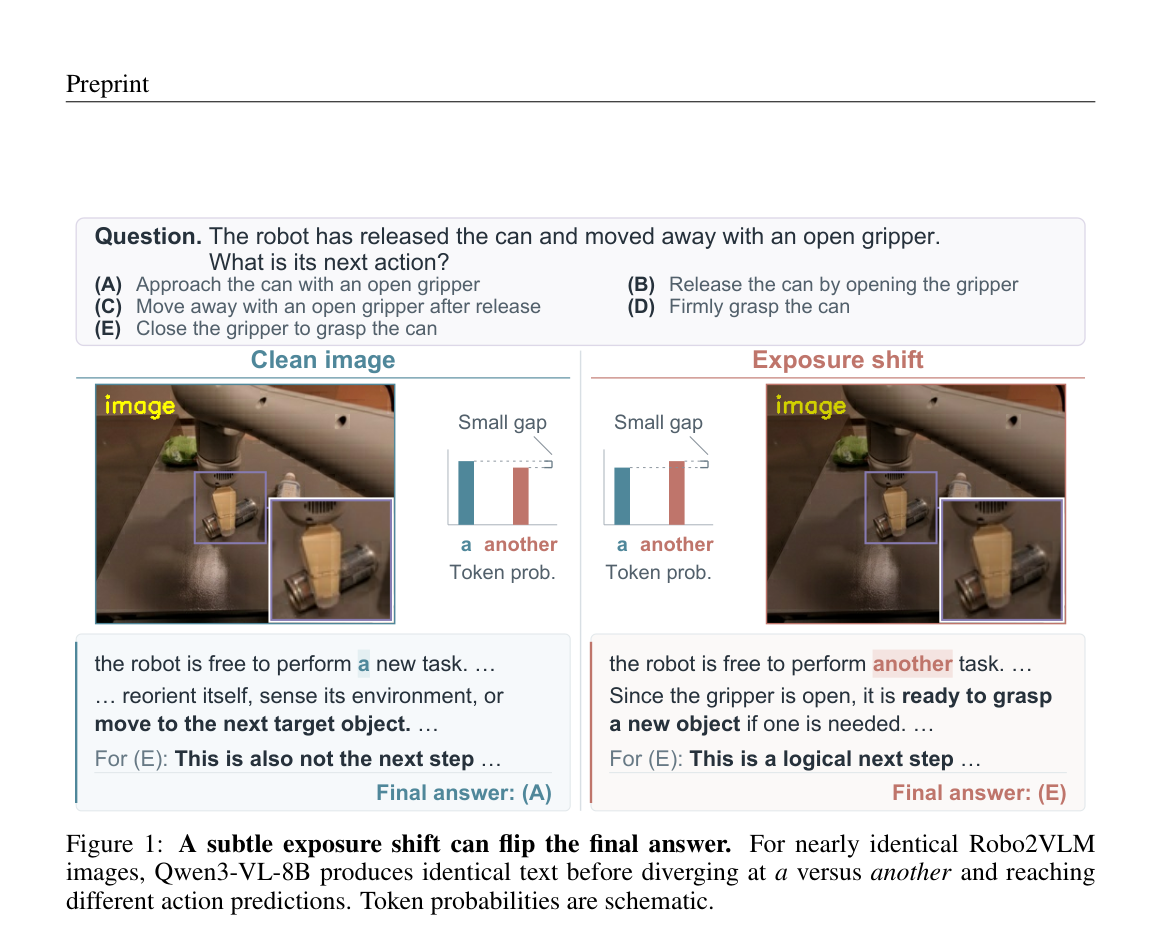
动机例子。Robo2VLM 选择题:机器人已放开罐子并张开夹爪离开后,下一步是什么。Clean 列在 a/another 的小概率间隙上偏向 a new task,最终答 (A);Exposure shift 列偏向 another task,最终答 (E)。中间推理大段相同,只在关键词分叉。注意图中 Token prob. 条为示意。
研究缺口
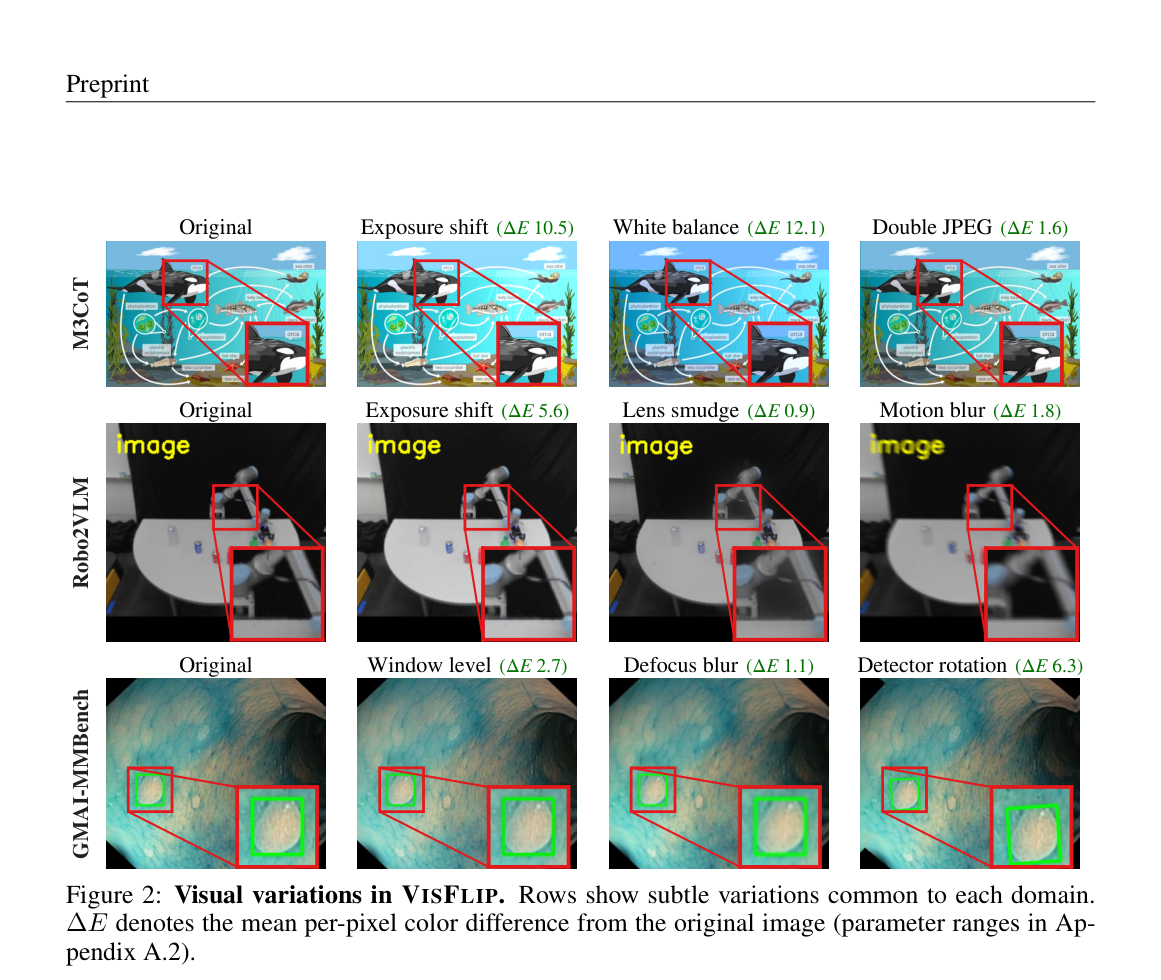
VISFLIP 扰动图鉴。三行分别是 M3CoT 海洋食物网、Robo2VLM 桌面机械臂、GMAI 内窥镜病灶;四列原图与域内常见细微变化,绿标 ΔE。医学行含窗宽与探测器旋转,机器人行含镜头污渍与运动模糊。用来说明评测扰动“强日常、弱对抗”。
方法贡献
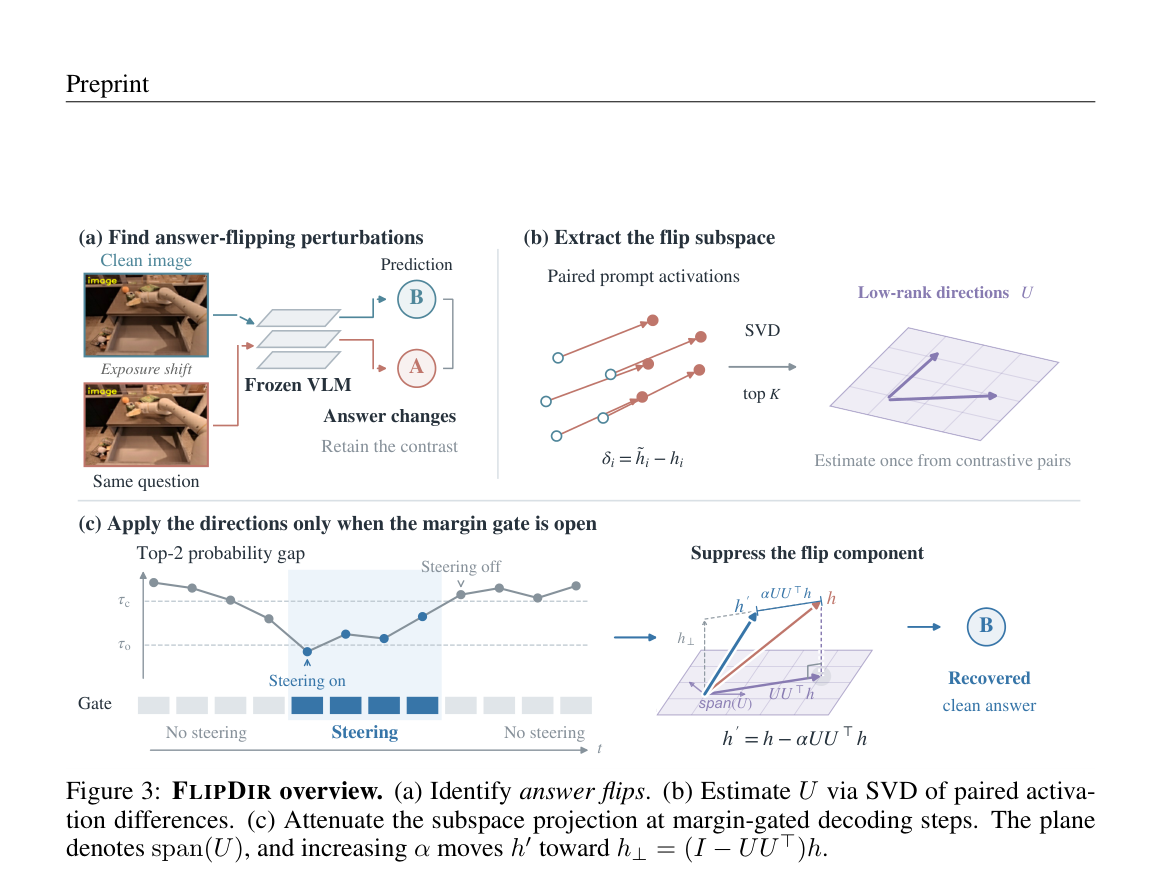
FLIPDIR 三步总览。(a) 同一问题下 clean 与曝光图送入冻结 VLM,答案从 B 翻到 A,保留对比。(b) 成对激活差 δ 做 SVD,取 top-K 得低秩方向 U。(c) 用 top-2 概率差曲线做门控:边际高则 Steering off;落入蓝区则 on,执行 h′=h−αUU⊤h,把状态推向正交补以恢复原答案。适合作为方法主图与特色图。
关键证据
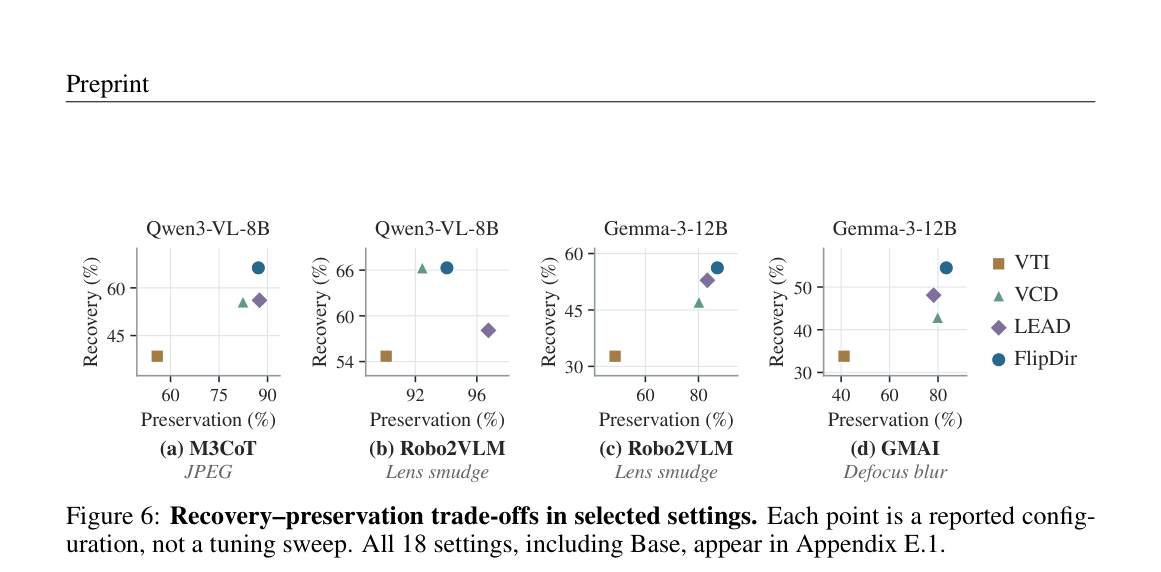
四个恢复—保持散点:Qwen 的 M3CoT-JPEG 与 Robo2VLM 污渍,Gemma 的 Robo2VLM 污渍与 GMAI 散焦。点为报告配置而非网格扫参。蓝圆 FlipDir 整体最靠右上;棕方 VTI 偏低;紫钻 LEAD 常保持高、恢复中等。读图时与 Table 3/4 的 H 增益对照。
实验如何设计?
- 开源可干预模型:Qwen3-VL-8B-Instruct、Gemma-3-12B-IT。基线:Base、VTI、VCD、LEAD。
- 九组合:M3CoT×{曝光,白平衡,双JPEG};Robo2VLM×{曝光,镜头污渍,运动模糊};GMAI-MMBench×{窗宽,散焦,探测器旋转}。父图数量见表 2。
- 报告 C/N/F/H,并画恢复—保持散点(Figure 6);另有子空间迁移、秩敏感与计算开销(约 1.08× 解码 FLOPs 量级,依设定)。
- 代码:摘要与结论写“将公开完整基准、构造框架与实验代码”,当前 PDF/abs 未见独立 GitHub/项目 URL,制作侧记为待核验。
关键结果与论文证据
- 动机层:细微扰动足以翻转前沿与开源 VLM 的最终答案;分叉可发生在看似无害的功能词上。
- 主表:FLIPDIR 在绝大多数设定取得最高或并列最高 H,相对最强基线平均 +2.8,峰值约 +6.3(Gemma + GMAI 散焦)。
- 权衡:Figure 6 显示 FlipDir 点更靠近右上(高恢复且高保持),VTI 常双低,LEAD 有时保持高但恢复不足。
- 机制:致翻能量集中在少量奇异方向;发散 token 的 top-2 边际系统性偏低,支撑“低边际才转向”。
- 局限实证:跨扰动单子空间仍难通用,说明门控与设定校准暂时必要。
阅读时需要注意
- 没有跨扰动通用的单一翻转子空间,全程强转向会伤稳定样本。
- 依赖隐藏状态,闭源聊天 API 不能直接挂载。
- U 的迁移与层选仍偏设定相关,部署前要验证集校准。
- 模型特定分组使跨模型样本量与难度不可硬比。
- 代码与数据发布声明待核验,复现需等待官方释出或自行按附录实现。
关联工作
- 自然损坏与采集偏移稳健性提供扰动谱,但目标多为准确率。
- 拒绝方向与多模态安全转向展示“行为可被低维方向介导”,FLIPDIR 把对象换成答案翻转。
- VCD/LEAD 等解码期抗幻觉方法是直接基线;VTI 是激活编辑近邻。
- 既有一致性或损坏基准不按模型划分 flip 组,难以同时惩罚过强干预与无力恢复。