快速导读:ViRDM 把图像侧表示分布匹配做成少步因果视频的生成器-only 后训练配方:用随机退出、分阶段 VJP 与轻量解码打通显存,再配因果 ODE 初始化与光流动力学正则,20 次更新达到 VBench 84.87。
少步自回归视频扩散能把流式生成压到低延迟,但主流后训练仍靠 DMD:生成器之外还要背一个大冻结教师和一个在线 critic,用噪声条件分数差间接估分布差距。蒸馏 Wan2.1-1.3B 时,常见配置还会叠一个 14B 教师,显存与步数成本都很高。
东北大学与 Adobe Research 的技术报告 ViRDM(arXiv:2609.28923,项目页 https://neu-vi.github.io/ViRDM/)问:能否去掉教师–评论家栈,只让生成器去匹配一份离线预计算的表示目标分布?作者把图像侧的表示分布匹配迁到少步因果视频,逐一打通显存路径、视频优化制度与动力学不足,最终用 20 次生成器更新、约 16 A100 GPU 小时把官方 VBench Total 做到 84.87,超过此前最强少步因果基线 0.36。
英文题目:ViRDM: Taming Representation Distribution Matching for Few-Step Causal Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.28923
原始论文:PDF / 论文页面
这篇论文解决什么问题?
因果视频扩散把视频切成有序帧或时间块,块内仍做扩散,以便 KV cache 与流式接口服务世界模型、游戏仿真与交互创作;但块内多步采样仍限制实时性(第1–2页)。
CausVid、Self Forcing、Causal Forcing 等路线用非对称 DMD 把双向教师压成少步因果学生:重加噪后用教师分数与 critic 分数之差更新。终端分布差并不直接算,而是经噪声条件分数间接推断,训练时通常同时驻留三套视频扩散网络(第2页)。
图像生成里的 RDM / FD loss 用冻结编码器离线对齐生成与参考分布,看起来可直接搬到视频:一步解码再匹配。但字面迁移甚至无法在目标分辨率完成一次更新,并暴露三条壁垒——梯度路径显存不可行、视频优化制度不同、表示分布对时序动力学约束不足(第2–3页)。
核心创新
- 把三网络 DMD 换成生成器-only 表示分布匹配,显著降显存与后训练时间。
- 随机退出 + 轻量解码 + 分阶段 VJP,使多步因果 rollout 上的 RDM 显存可行。
- 明确视频 RDM 的群体规模与因果初始化制度,并用流正则补表示目标对动力学的欠约束。
方法概览
ViRDM 只更新因果生成器,使其终端表示分布对齐固定离线参考。训练用一致性风格采样与随机退出缩短反向图,轻量 VAE 与分阶段 VJP 避免多模块共驻;默认因果 ODE 初始化与 B=64 生成群体;V-JEPA 2.1 作视频表示,并加单边光流动力学正则补足动力学。
- ViRDM 的目标是生成器-only 后训练:固定参考表示分布,对生成视频解码后的表征做匹配,不再维护在线教师与 critic(第1页,Figure 1)。
- 显存可行性三件套:一致性风格采样在每步预测干净端点并可再加噪;随机退出只在采样到的去噪步保留反向图;轻量 VAE 解码器加分阶段 VJP,避免生成器、解码器与表示编码器的反向图共驻(第6页,Figure 2,Table 1)。最终在 8×A100、81 帧 832×480 设定下把峰值显存压到约 48.3 GB/GPU。
- 生成侧群体规模 B 控制每次更新用来估生成分布的新视频数;作者取 B=64 作为质量–效率折中,再配合因果 ODE 初始化:先保证因果兼容,再靠少步特化抬高动力学工作点(第9–10页,Table 2–3,Figure 3)。
- 表示侧默认用 V-JEPA 2.1 视频表征而非 DINOv2 帧边缘分布;冻结动力学诊断表明图像边缘对时序几乎不敏感,视频表征能把生成推出近静态区,但对更高动力学信号变弱(第10–11页,Table 5,Figure 4)。
- 补洞用训练期单边流正则:RAFT 估光流幅度,仅当分数低于阈值 τ 时惩罚,默认 λ_dyn=5e-4,在抬高 Dynamic Degree 的同时把多项时序质量指标变化控制在约 0.18 内(第11、15页,式(6),Table 9)。
逐图理解论文
DMD 成本
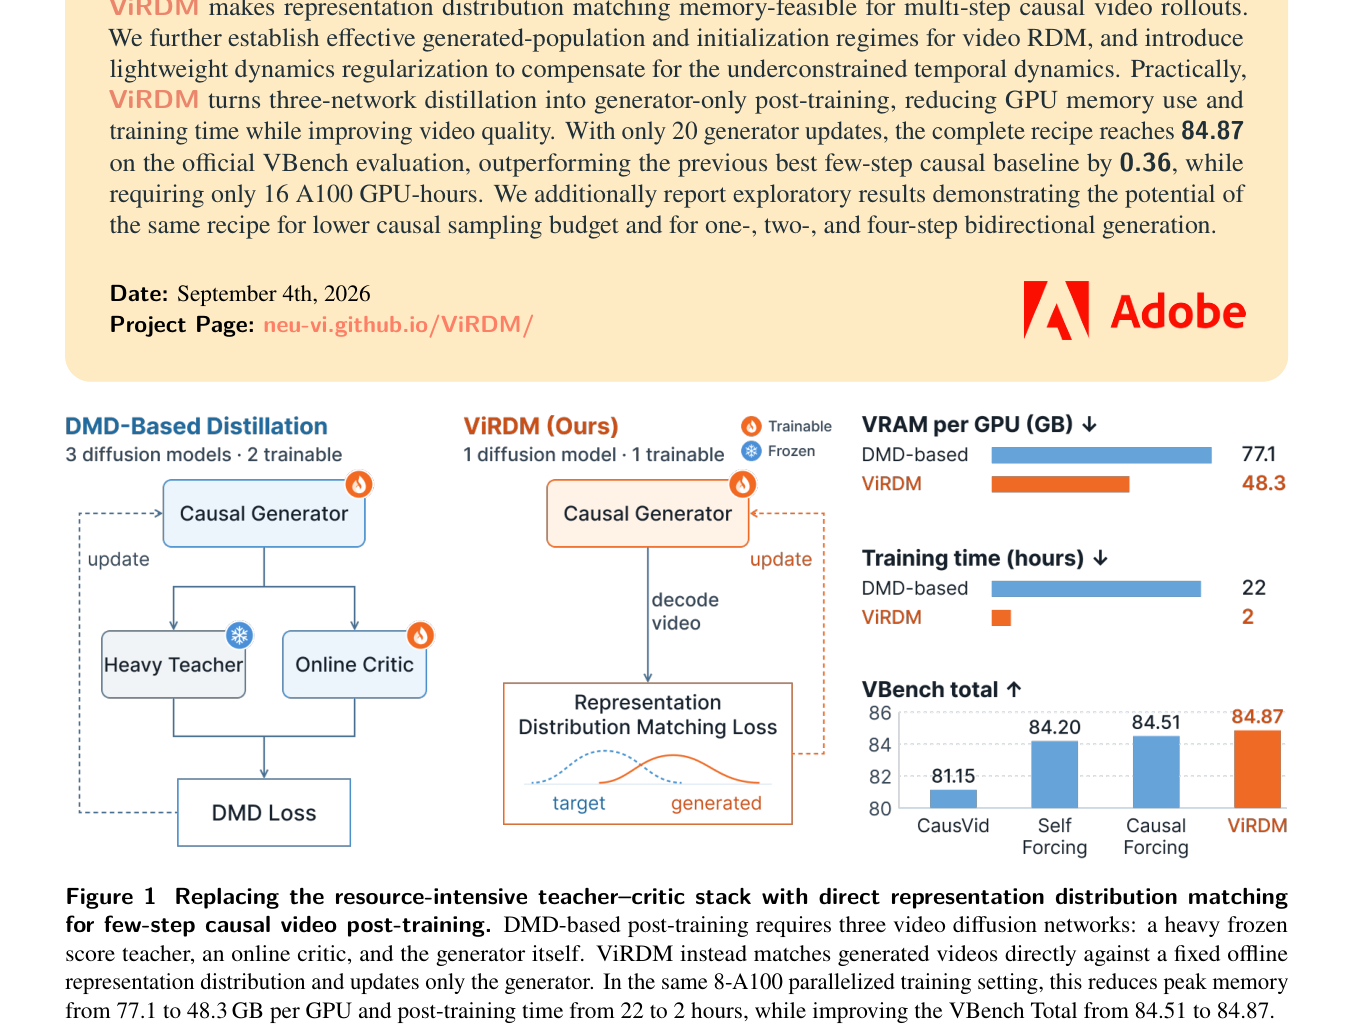
图1把 DMD 三网络栈与 ViRDM 单生成器匹配并置,右侧给出显存、训练时长与 VBench Total 三条对照。适合作为开篇动机图与特色图:一眼看到“去掉教师–critic、更快更省还略高分”。
显存路径
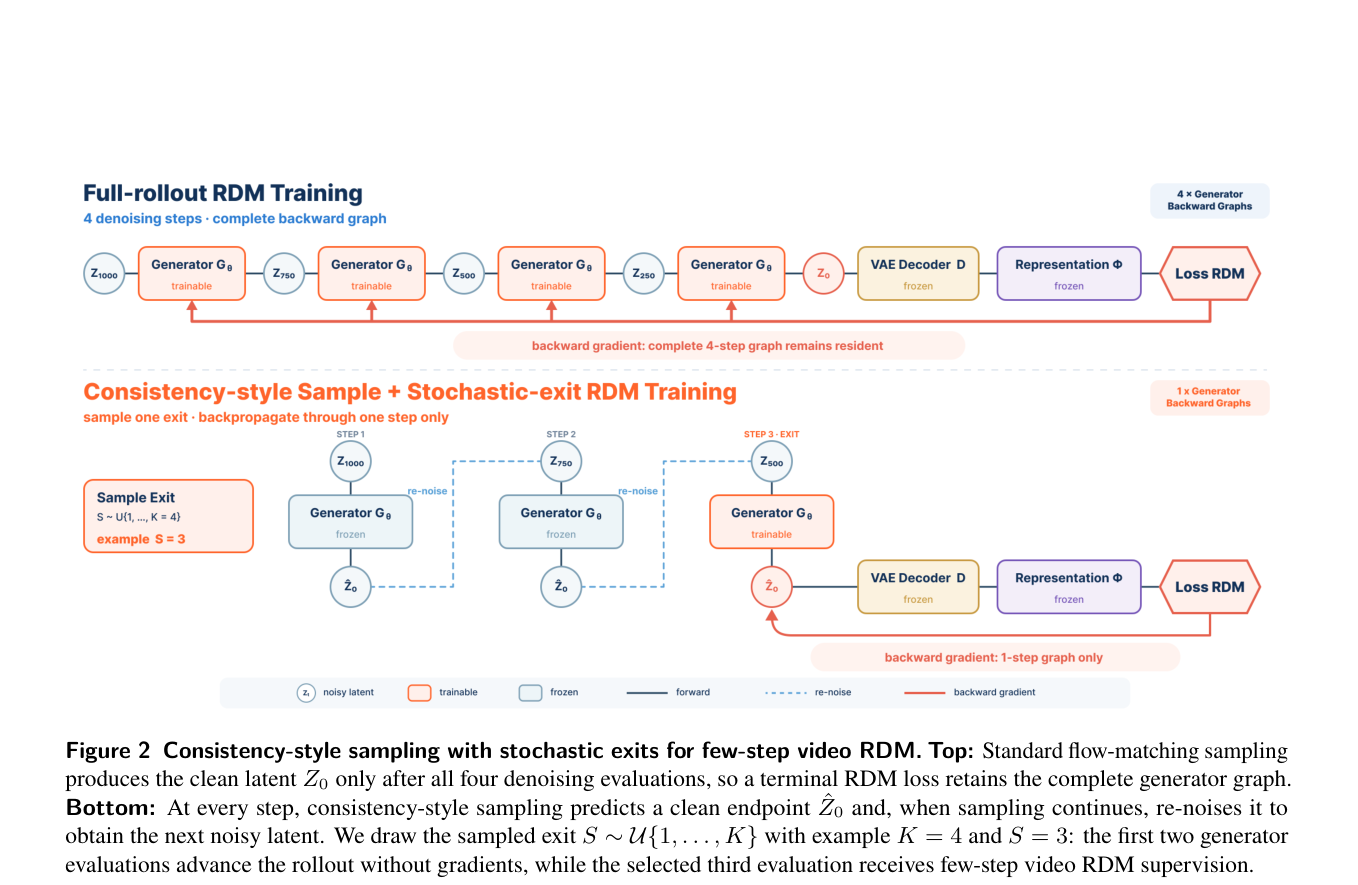
图2解释随机退出如何让一致性采样只在一个去噪步回传:上排全 rollout 保留完整四步反向图,下排示例 S=3 仅一步可训。这是显存可行性的关键结构图。
视频制度
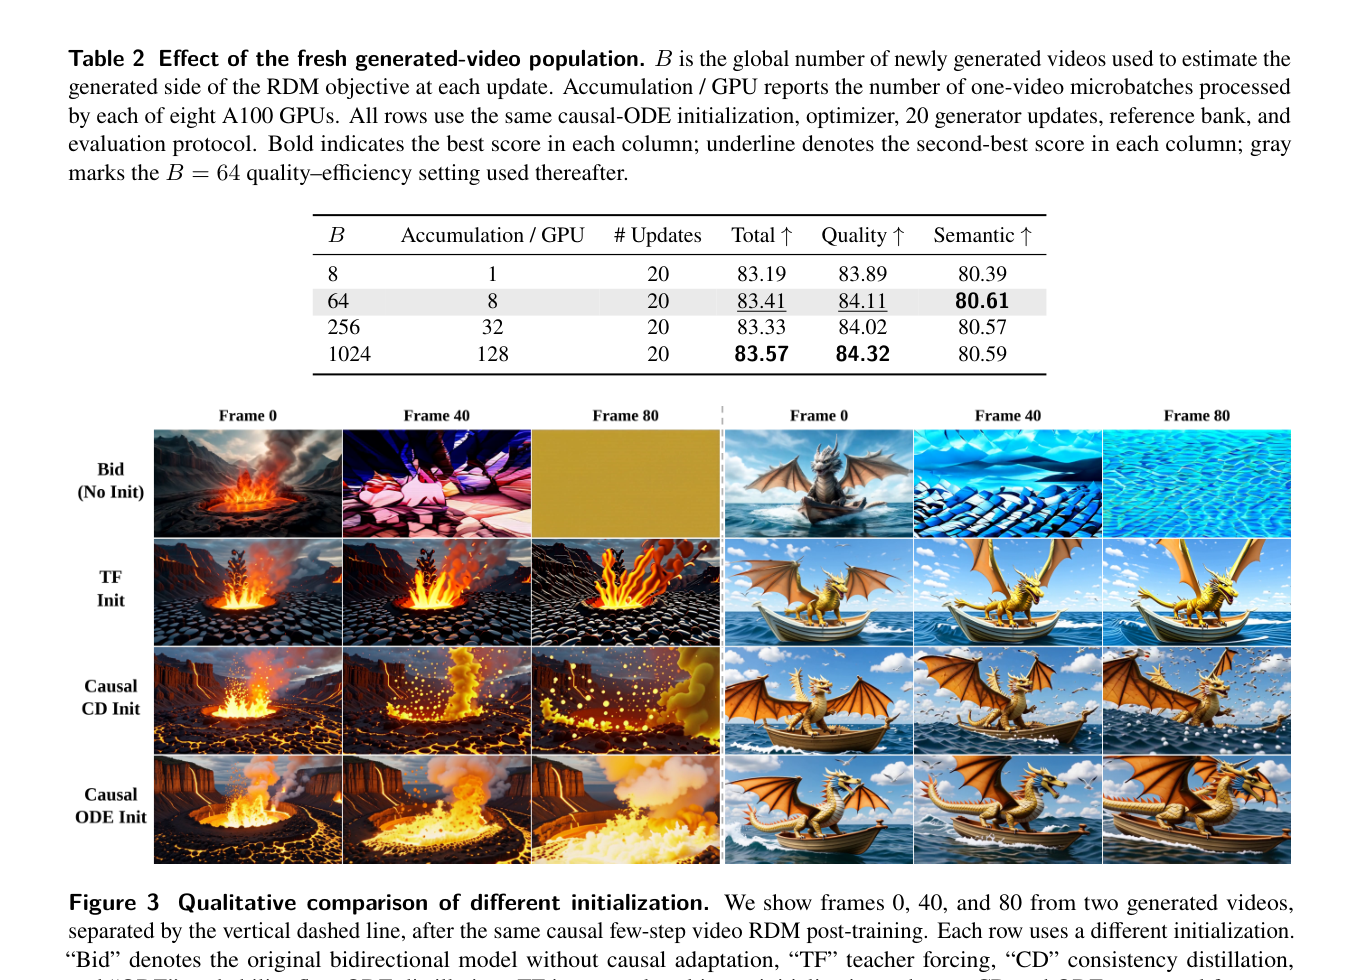
图3对照 Bid/TF/CD/ODE 初始化在帧 0/40/80 的生成:无因果适配会崩成噪声色块,教师强制保场景但动力弱,少步因果初始化兼顾连贯与演化,支撑“先因果兼容、再少步特化”的制度结论。
实验如何设计?
- 主设定:Wan2.1-1.3B 骨干、四步因果、81 帧、官方 VBench;同一生成接口对照 CausVid、Self Forcing、Causal Forcing(第14页,Table 8)。
- 消融覆盖:随机退出/轻量解码/分阶段 VJP 的显存;B 与初始化;有无动力学正则及权重扫描;图像 vs 视频表示(第6–15页)。
- 人评:25 人、30 prompts;20 条做四方法偏好,10 条对比有无动力学正则(第14–15页,Figure 6)。
- 扩展:后续块 1/2 步因果(FFE)以及 1/2/4 步双向生成,检验配方是否绑死在四步因果主设定(第16页,Table 10–11)。
关键结果与论文证据
- 完整配方 20 次更新达 VBench Total 84.87,相对 Causal Forcing 84.51 提升 0.36;Quality 85.82 为同组最强,Semantic 81.09 次强(第14页)。
- 同设定 8×A100 下,相对 DMD 栈峰值显存 77.1→48.3 GB/GPU,后训练时间 22→2 小时(第1页,Figure 1)。
- 无动力学正则时 Total w/o Dynamic Degree 已达 85.77,超过 Self Forcing 85.34 与 Causal Forcing 84.64,但 Dynamic Degree 仅 48.61;加正则后默认点把 Dynamic Degree 提到 72.02、Total 提到 84.87(第10、15页,Table 4、9)。
- 人评中 ViRDM 在文–视对齐与画质偏好份额最高(40.4% / 43.0%);相对无正则变体,动力学偏好 85.6%(第14–15页)。
- 因果兼容是硬门槛:双向无适配初始化后训仅 65.80 Total 且严重漂移;因果 ODE 初始化达 83.41 并保留更强动力学(第9页,Figure 3,Table 3)。
阅读时需要注意
- ViRDM 是后训练配方,不能在短程表示匹配里把双向权重可靠改造成因果生成器,必须先有因果兼容输送。
- 效果继承冻结表示编码器与固定参考群体的归纳偏置;主实验仍在 Wan2.1-1.3B、81 帧尺度,更大模型、更高分辨率与更长时域仍待验证。
- 动力学正则权重过大可能牺牲闪烁与主客体一致性;少步/双向扩展是探索结果,不是论文主对比口径。
关联工作
- Self Forcing、Causal Forcing、CausVid 构成少步因果 DMD 对照与初始化背景。
- 图像 RDM / FD loss 提供去掉教师–critic、直接匹配表示分布的灵感来源。
- ASD、One-Forcing、Causal Forcing++ 等出现在更少步因果扩展对照中;VBench 与 RAFT 光流分别服务总评与动力学代理。