ViRDM:驯服表示分布匹配以服务少步因果视频生成
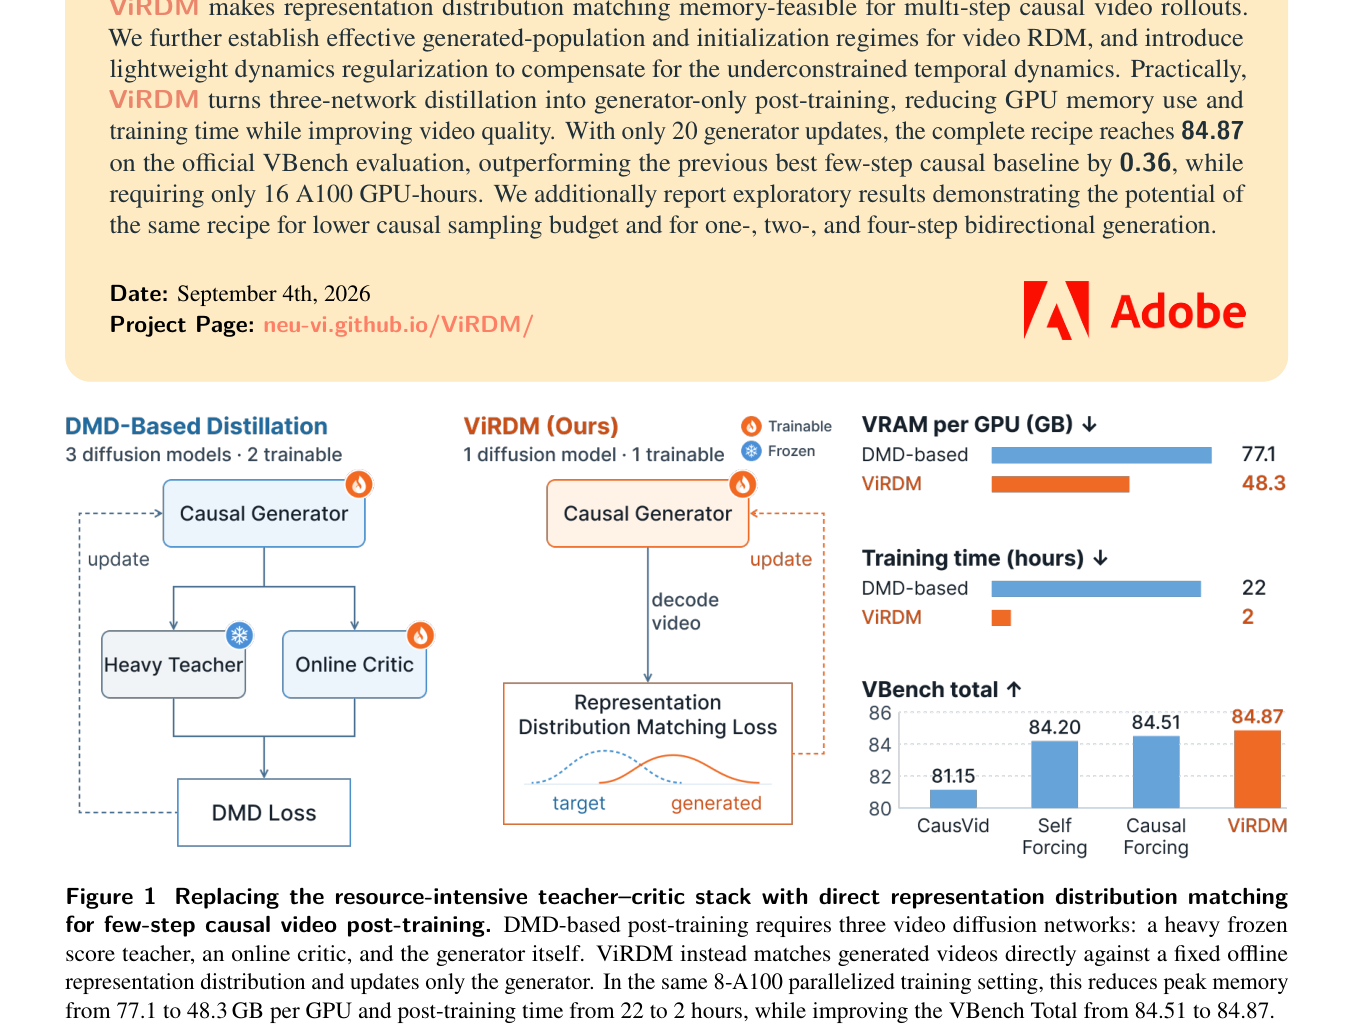
ViRDM 把图像侧表示分布匹配做成少步因果视频的生成器-only 后训练配方:用随机退出、分阶段 VJP 与轻量解码打通显存,再配因果 ODE 初始化与光流动力学正则,20 次更新达到 VBench 84.87。
ViRDM 把图像侧表示分布匹配做成少步因果视频的生成器-only 后训练配方:用随机退出、分阶段 VJP 与轻量解码打通显存,再配因果 ODE 初始化与光流动力学正则,20 次更新达到 VBench 84.87。
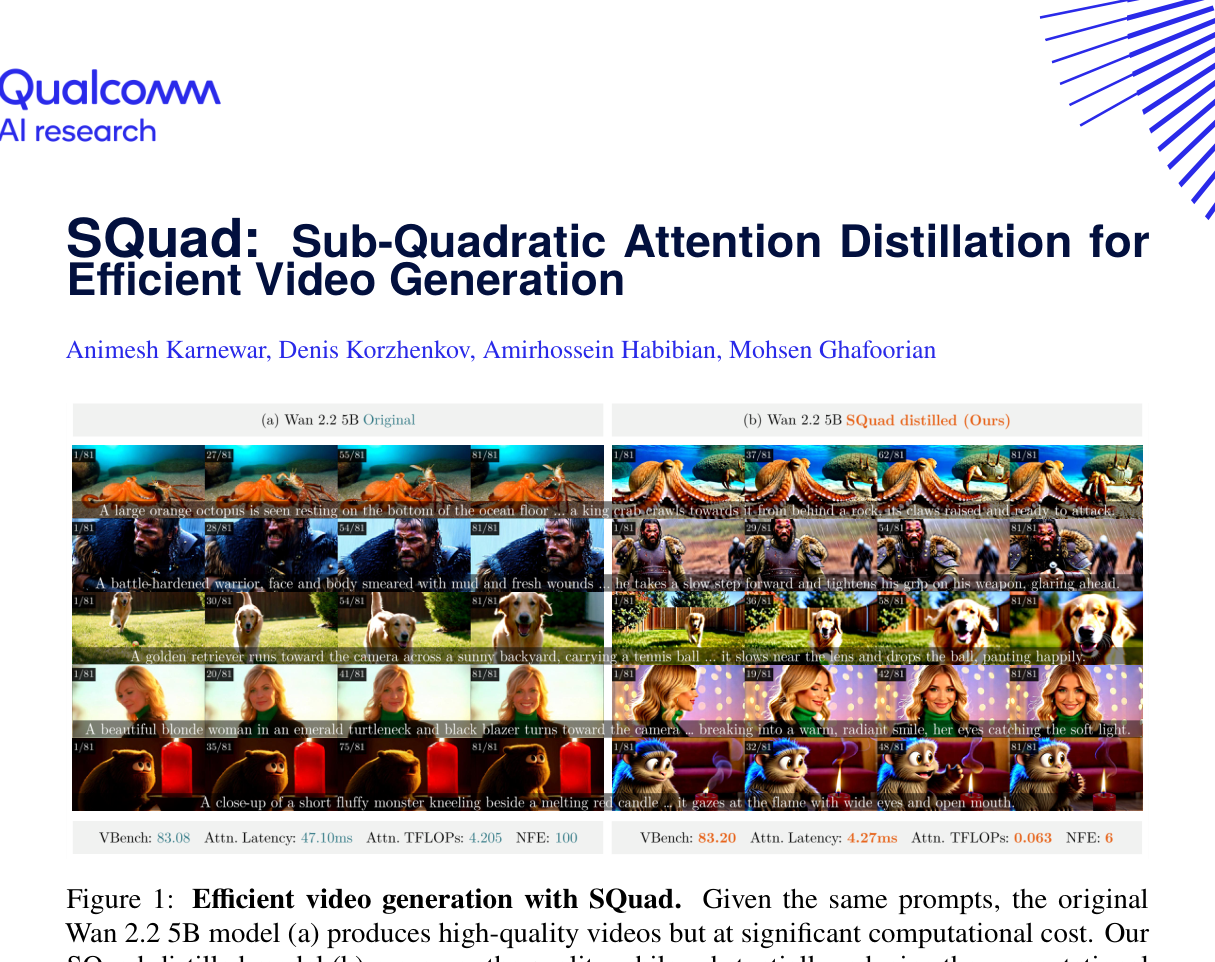
SQuad 将视频 DiT 中的全 softmax 自注意力分解为局部窗口内与跨窗口全局两次 softmax 注意力,以 O(n√n) 复杂度蒸馏预训练模型,在 Wan 2.2 5B 上以 6 NFE 匹配原模型 VBench 质量并大幅降低计算成本。
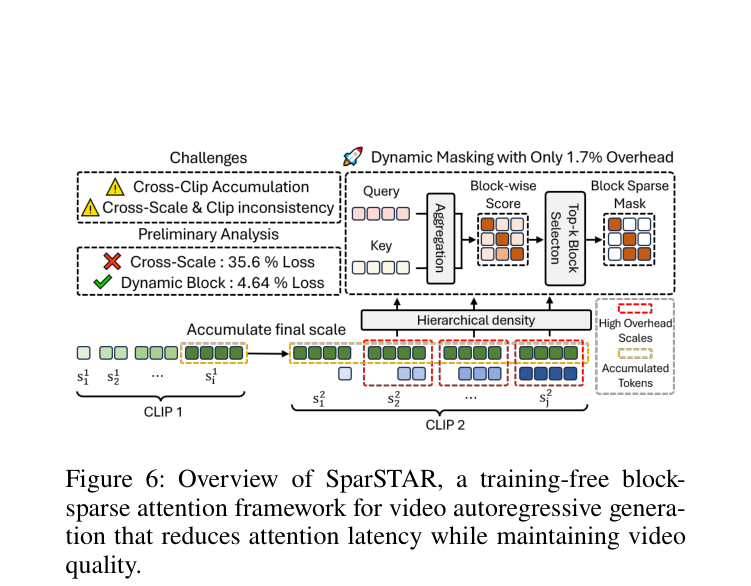
SparSTAR提出一种免训练的块稀疏注意力框架,在每个高成本尺度上动态构建per-head稀疏掩码,为InfinityStar视频自回归生成提供约1.6×端到端加速且保持VBench质量。