快速导读:IronViT 先把异构专家巩固进 softmax 能力桥,再渐进转到混合 softmax–linear 编码器,在通才迁移与高分辨率效率之间解耦优化。
通才视觉编码器希望在同一表示里同时吃语义、空间、语言对齐与动作相关线索,但今天最强骨干背后的 softmax 注意力一旦拉高分辨率就很贵。一个直觉做法是把多个专家教师直接蒸馏进高效架构;小鹏 Robotics Foundation Model Team 的 IronViT(arXiv:2609.29252 )发现:能力异构与 token-mixing 架构切换若绑在一起优化,学生会两边都吃力,表示质量反而下降。
IronViT 的原则很干脆:先巩固能力,再约束算力。它先把互补专家蒸馏进 softmax 注意力 capability bridge,再渐进把统一表示转到混合 softmax–linear 编码器;同时用专用数据管线提高蒸馏语料的信息密度与域覆盖。识别、检索、稠密预测、多模态理解与机器人学习上整体可竞争;softmax 桥在多模态与机器人聚合指标上最强,混合编码器在保留迁移性的同时让高分辨率效率优势随分辨率放大。
英文题目:IronViT: Toward Efficient Generalist Visual Representation Learning
论文出处:arXiv 每日论文精选 · arXiv:2609.29252
原始论文:PDF / 论文页面
这篇论文解决什么问题?
通用视觉骨干既要“什么都会一点”,又要在高分辨率下算得起。现有强模型多为专才:自监督擅长空间,对比语言对齐擅长检索与零样本,生成式语言–图像或专用蒸馏各有侧重,但很少在统一接口上同时服务 VLM 与机器人控制(第1–4页)。
直接把多教师目标塞进线性/混合注意力学生,等于让模型同时完成两件难事:调和异质教师目标,又在不同 token-mixing 算子上复现它们。作者把这写成耦合目标 L_direct,并指出其会损害表示质量(式6,第8–9页)。
因此需要把“能力巩固”与“架构适应”解耦:先在 softmax 桥上把教师能力合成统一表示,再冻结桥、只教混合注意力学生,而不是一步到位硬压效率。
核心创新
- 提出 consolidate-before-constrain:能力巩固与架构适应两阶段解耦。
- 用 softmax 能力桥吸收语言对齐、自监督空间与全局判别三类教师。
- 渐进跨架构蒸馏得到混合注意力部署骨干,高分辨率效率优势随分辨率增长。
- 专用蒸馏数据管线提升信息密度与域覆盖。
方法概览
Stage I:冻结 QwenViT、DINOv3、PE-Core-G14,训练 softmax capability bridge 与对齐接口;Stage II:冻结桥,把表示蒸馏到保留 9 个 softmax、替换 18 个线性块的 Hybrid 学生,并配数据管线与多阶段课程。
- 数据侧:过滤去重→语义聚类与簇内剪枝→层次平衡采样→语义富集,形成约 40.0M 候选预训练池 Dpre,再富集到约 46.4M 精炼语料 Dref,提高信息密度与域覆盖(Fig.2–5,第5–10页)。
- Stage I 教师:QwenViT(Qwen3-VL-8B 视觉塔)给语言对齐稠密 patch;DINOv3 ViT-H+/16 给自监督空间稠密特征(丢弃 CLS/register);PE-Core-G14 给全局 ℓ2 归一化嵌入监督 MAP 全局头。教师全部冻结,桥为从零训练的 softmax ViT,隐藏维 d=1152,Nr=8 register(第9–10页)。
- 对齐:每个教师有接口 Ak 与通道标准化 Φk;稠密教师用 0.9 余弦 + 0.1 smooth-ℓ1,全局教师用余弦(式7–8)。课程 Phase I-A 固定 384×384、576 patch;Phase I-B 原生纵横比、最多约 3920 merged tokens(Table 1)。
- Stage II:学生保留桥的 patch 嵌入、token 布局与输出接口,但把 27 块中的 18 块换成线性 mixer,保留 9 块 softmax 做精确全局交互;兼容参数从桥继承(第12页)。
- 架构迁移目标:先对替换块做局部注意力对齐 LattnII,再对最终 patch/全局特征做 LarchII 匹配桥输出(式9–10)。课程 II-A 只训线性 mixer → II-B 固定分辨率全模型 → II-C 原生分辨率精炼(Table 2)。
逐图理解论文
问题背景
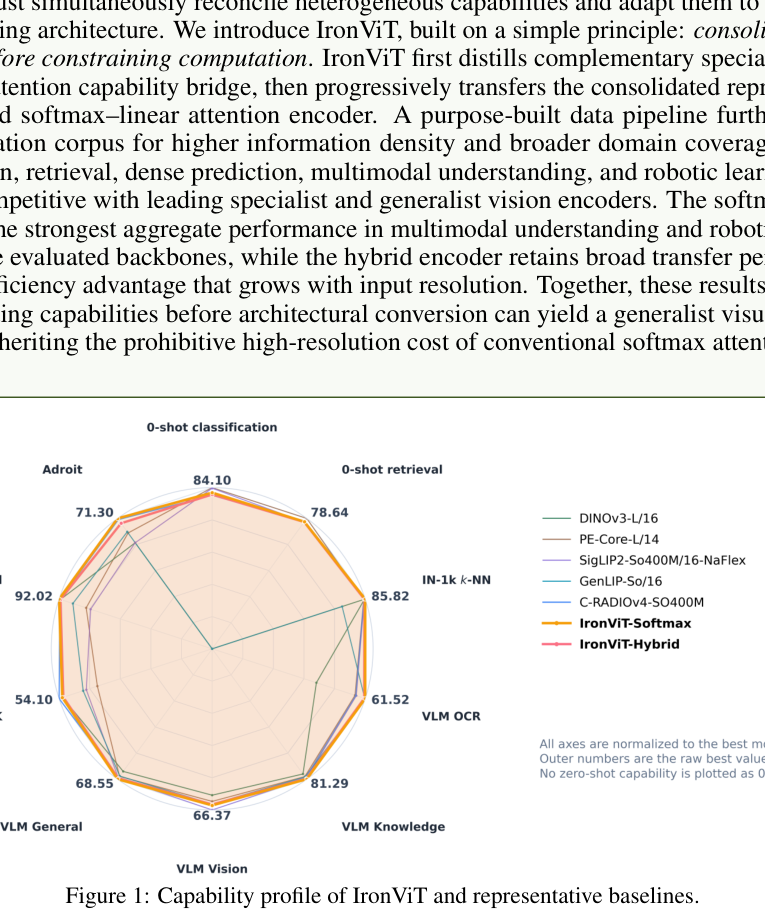
Fig.1 雷达能力画像:对比 IronViT-Softmax/Hybrid 与 DINOv3、PE-Core、SigLIP2、GenLIP、C-RADIO 在零样本分类/检索、k-NN、VLM 四族与机器人等轴上的轮廓。橙/粉线整体更外扩,适合开场建立“通才+效率”印象。
两阶段方法
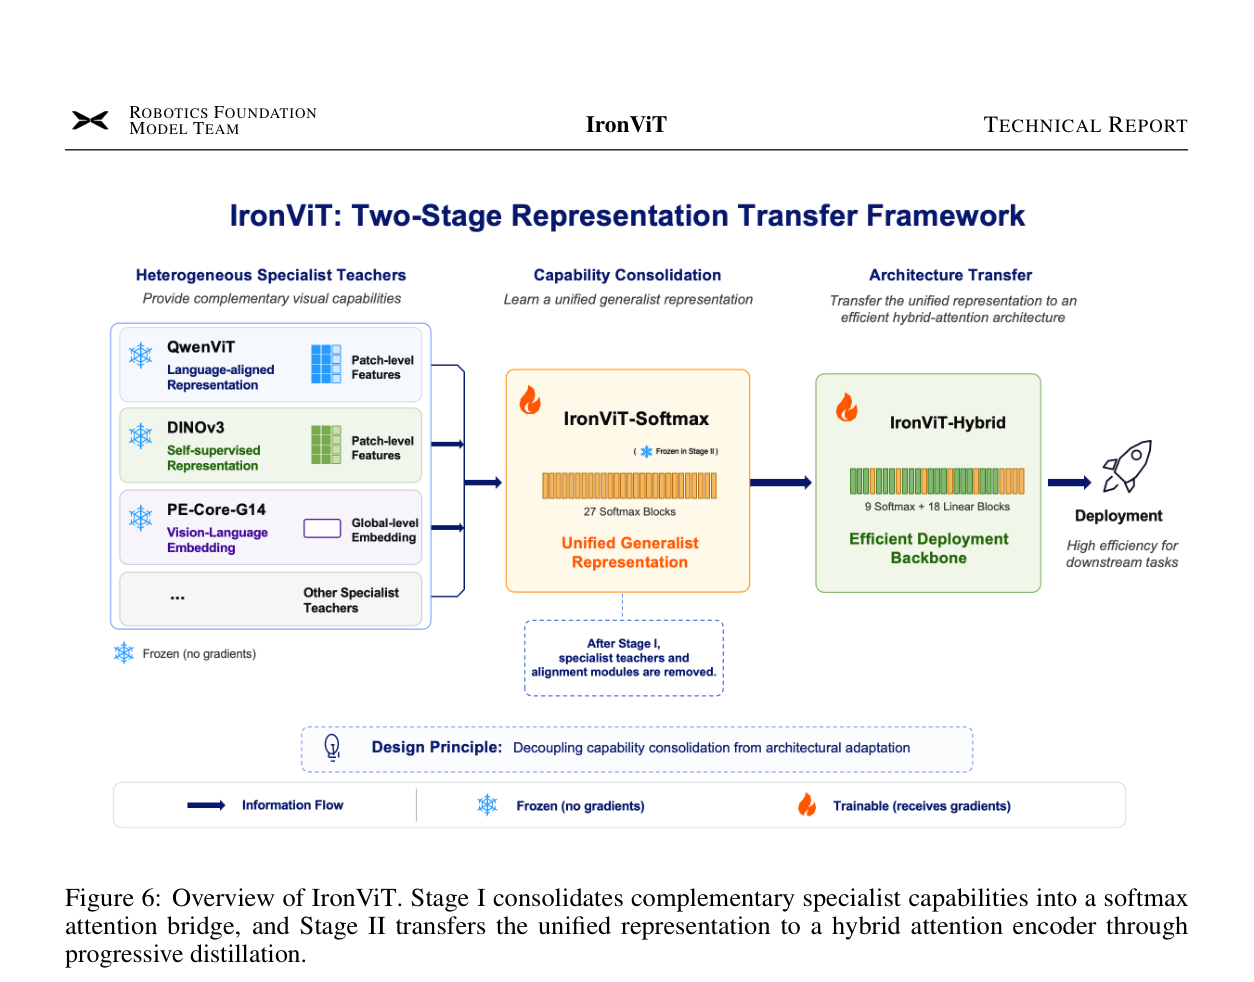
Fig.6 方法总图:左列冻结教师 QwenViT/DINOv3/PE-Core → Stage I 可训 Softmax 桥(27 softmax blocks)巩固统一表示 → Stage II 冻结桥、蒸馏到 Hybrid(9 softmax + 18 linear)→ 部署。核心标注 Decoupling capability consolidation from architectural adaptation。适合做方法主图与特色图。
数据与课程
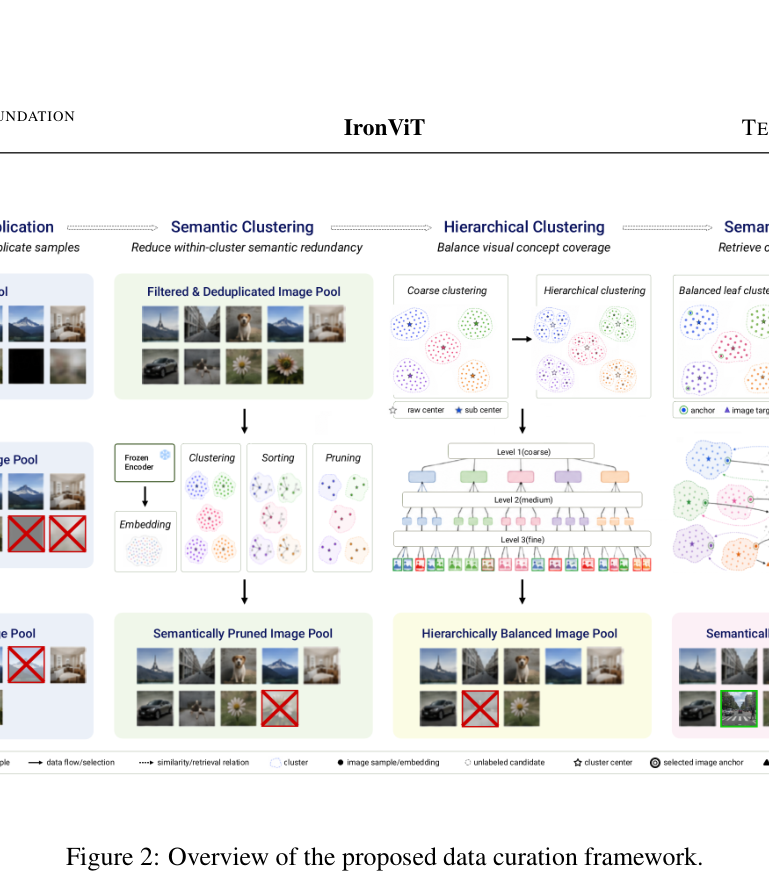
Fig.2 数据管线总览:过滤去重、语义聚类与簇内剪枝、层次平衡采样与语义富集,解释 Dpre/Dref 如何提高蒸馏语料密度与覆盖,承接“能力巩固也要好数据”。
实验如何设计?
- 同尺度对照:DINOv3-L/16、PE-Core-L/14、SigLIP2-So400M-NaFlex、GenLIP-So/16、C-RADIOv4-SO400M(约 0.30–0.42B)。评测 IronViT-Softmax 与 IronViT-Hybrid。
- 识别:ImageNet-1k 及 V2/R/A/Sketch 零样本,线性探测与 k-NN。检索:COCO / Flickr30k R@1。稠密:ADE20K mIoU、NYUv2 RMSE。
- VLM:受控 LLaVA-NeXT + Qwen2.5-7B-Instruct,22 项基准四族均值。机器人:CortexBench(Adroit 2 + Meta-World 5),Theia 式冻结特征行为克隆。
- 效率:512–2048 分辨率前向 FLOPs 与 batch-1 延迟,对照 Softmax 自身与 SigLIP2。另做数据管线、两阶段分解、课程消融。
关键结果与论文证据
- 识别(Table 3):Softmax 零样本均值 81.50,k-NN 85.82(第一),线性探测 87.35(第二);Hybrid 零样本 80.53、k-NN 85.37,大体保住;相对 C-RADIOv4 零样本均值高约 1.37 点。
- 检索(Table 4):Softmax 平均 R@1 76.66,略高于 C-RADIOv4 的 76.50;Hybrid 76.48,I→T 方向更敏感。稠密(Table 5):Softmax ADE20K 52.97 / NYUv2 0.339;Hybrid 52.6 / 0.343,空间结构基本保留。
- 多模态(Table 6):Softmax 22 项总均 66.44 第一,并在 OCR、知识图解、通用理解三族领先;Hybrid 66.05,仅降 0.39。相对教师 QwenViT,Softmax 总均 66.44 vs 66.12,知识/视觉中心/通用略优,OCR 仍有缺口(Table 8)。
- 机器人(Table 7):Softmax 七任务均成功率 86.10 第一;Hybrid 84.74,约保留 Softmax 的 98.4%。高分辨率效率(Fig.7):2048² 上 Hybrid 相对 Softmax 约少 45% FLOPs、约 1.75× 加速,优势随分辨率增长。
阅读时需要注意
- 相对 PE-Core-G14,零样本分类尤其分布偏移仍有差距;蒸馏对齐视觉表征但未与文本塔联合优化。
- OCR/文档理解相对 QwenViT 教师仍是最难保留的一块。
- Hybrid 在部分检索方向与深度估计上有小幅回退;线性块替换比例是效率–精度权衡。
- 训练成本高(Stage I/II 多阶段 H200 GPU-hours),公开对照尺度未覆盖全部超大教师部署场景。
关联工作
- DINOv3、PE-Core、SigLIP2、GenLIP、C-RADIO 代表自监督、对比 VL、生成式与多教师蒸馏对照。
- ViT-AdaLA 提供混合注意力与跨架构对齐思路;EUPE 的特征标准化影响对齐接口。
- LLaVA-NeXT / CortexBench-Theia 分别是受控多模态与机器人评测协议。