R2-WAM:世界动作模型需要怎样的视觉表征
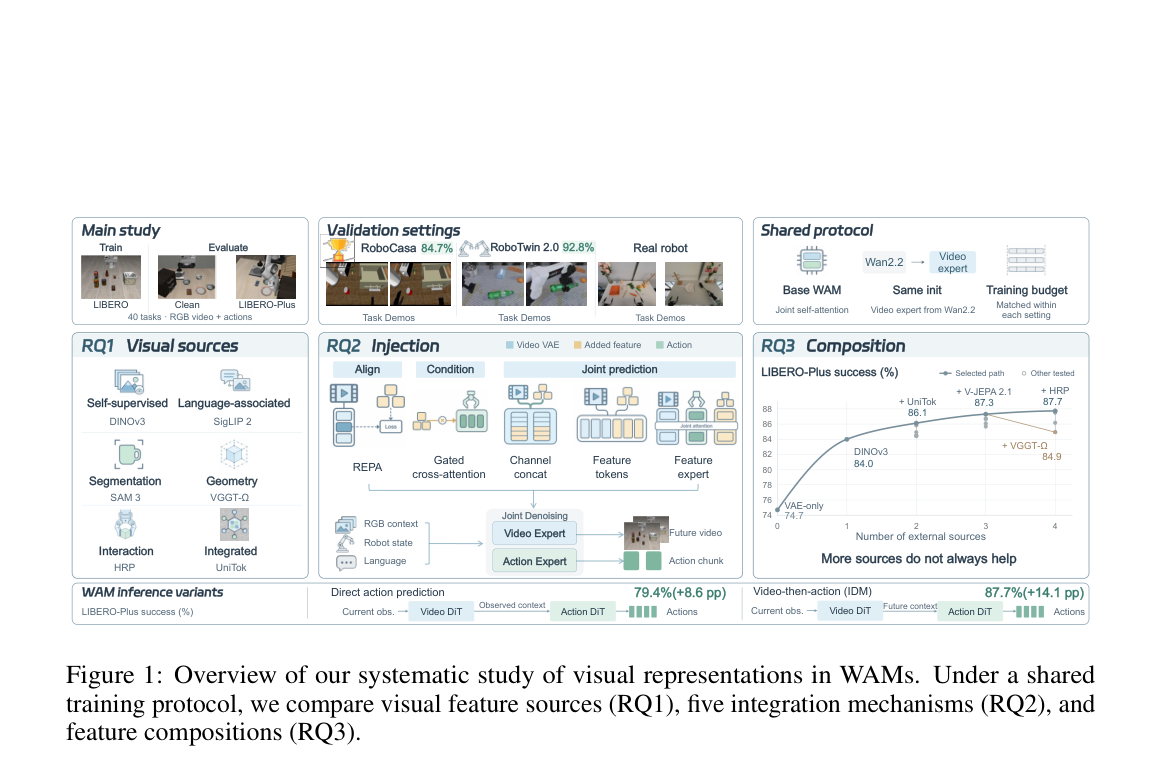
在共享训练协议下比较十三种视觉来源、五种注入机制与多源组合,得到以通用表征和通道拼接为核心的 Representation Recipe,并实例化为 R2-WAM。
在共享训练协议下比较十三种视觉来源、五种注入机制与多源组合,得到以通用表征和通道拼接为核心的 Representation Recipe,并实例化为 R2-WAM。
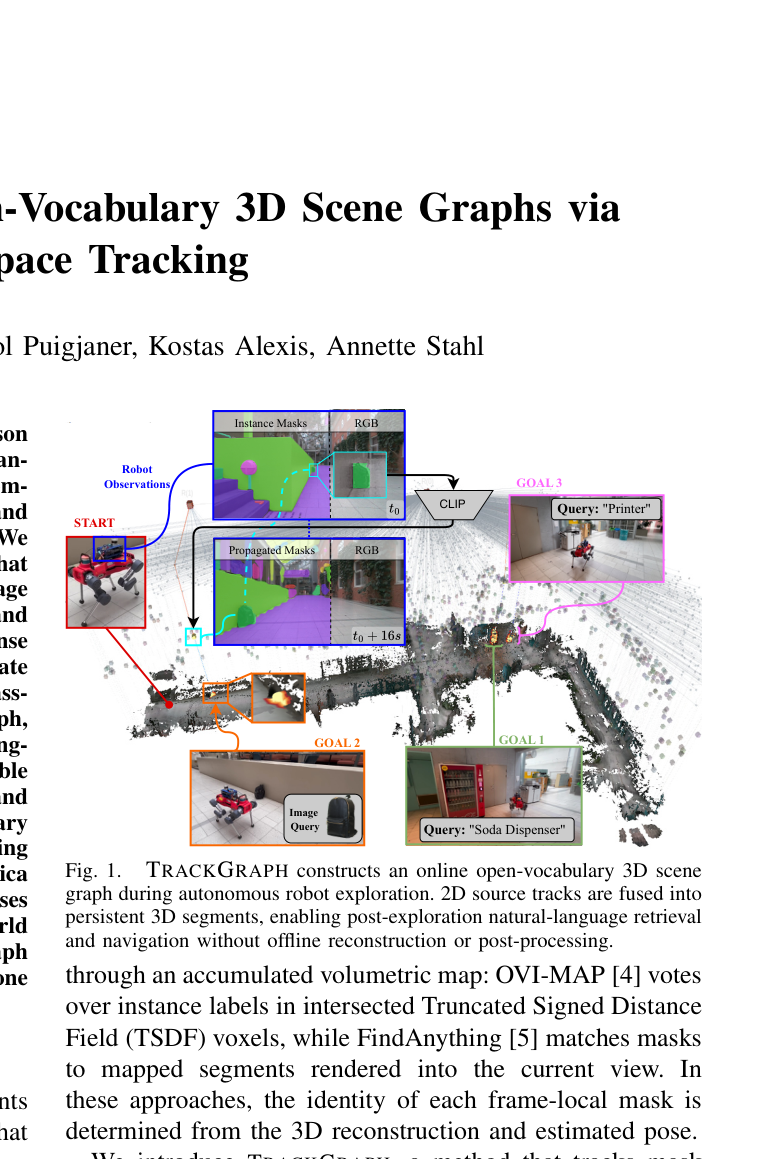
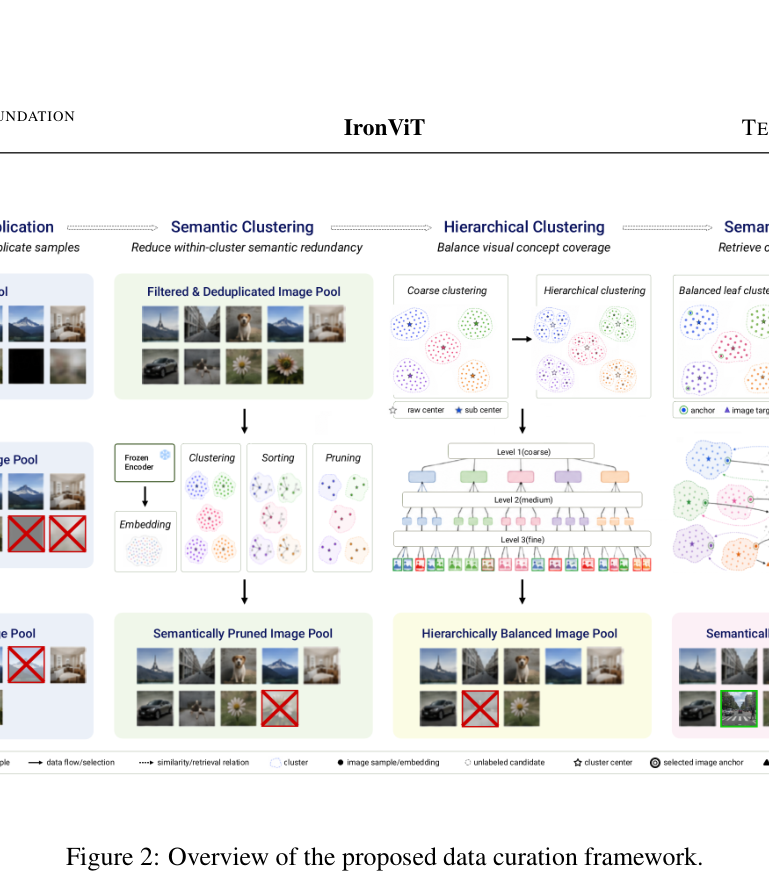
TRACKGRAPH 先在图像空间用 DINOv3 传播稀疏 FastSAM 掩码形成 source track,再融合进层次化场景图的类无关三维段,并以多视角 CLIP 库支持在线开放词汇检索与导航。
UltraBench 2 用统一下载、划分与评测协议覆盖十余项超声分类/分割任务,复盘显示病理任务仍最难,通用 DINOv3 已在分割上追平超声专项模型。
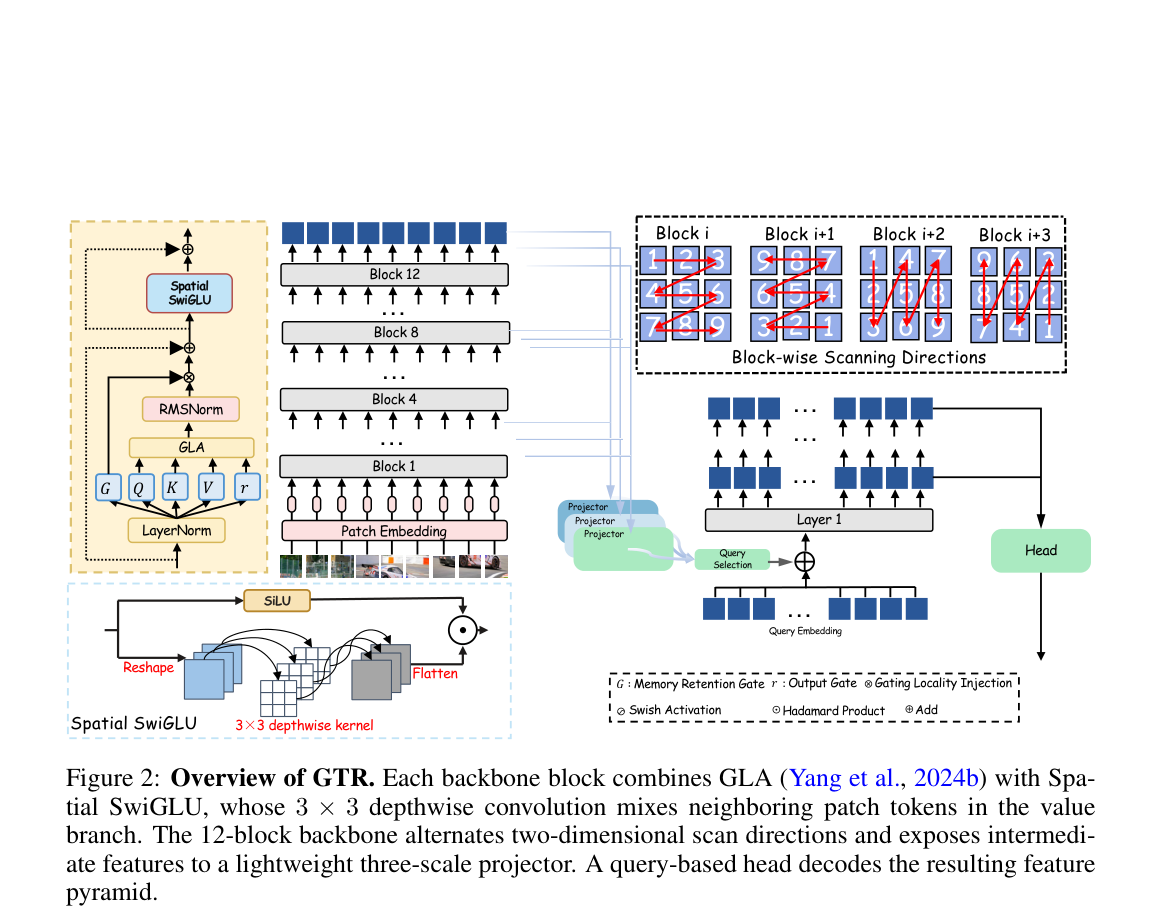
GTR 用无 softmax 的门控线性递推、四方向扫描和 Spatial SwiGLU 做单尺度骨干,只蒸馏教师最后一层 patch 特征,再换任务头覆盖六种密集预测。
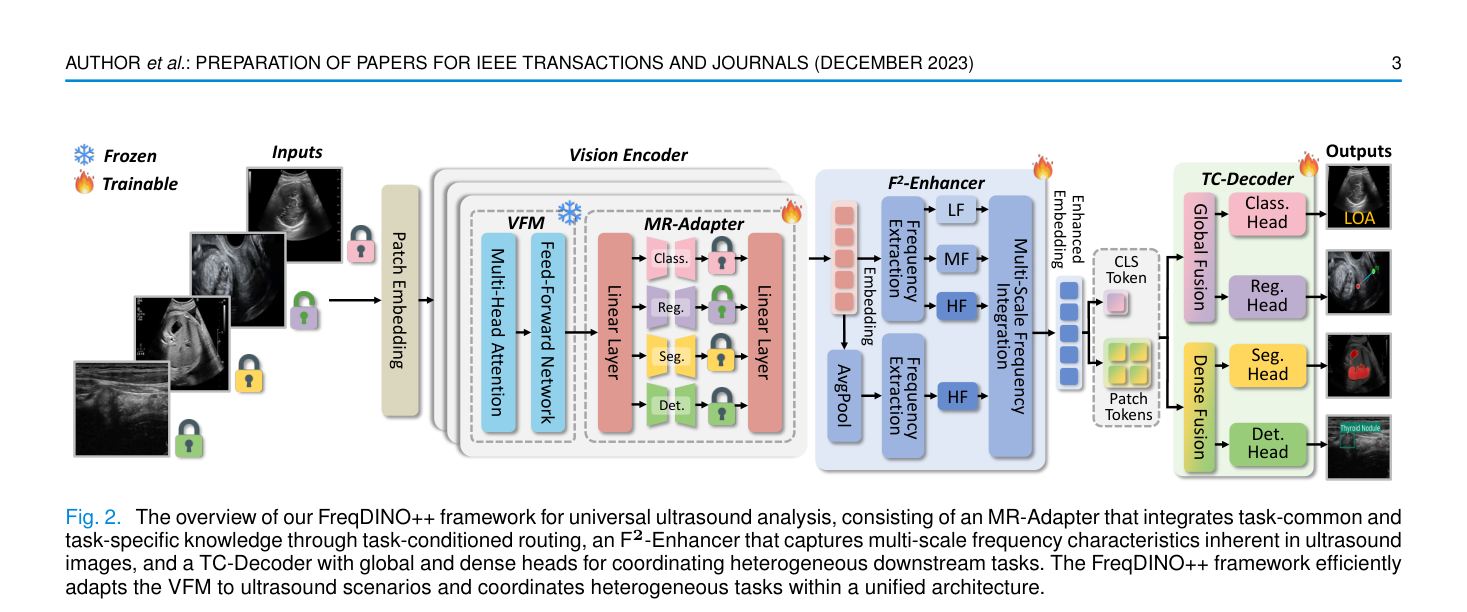
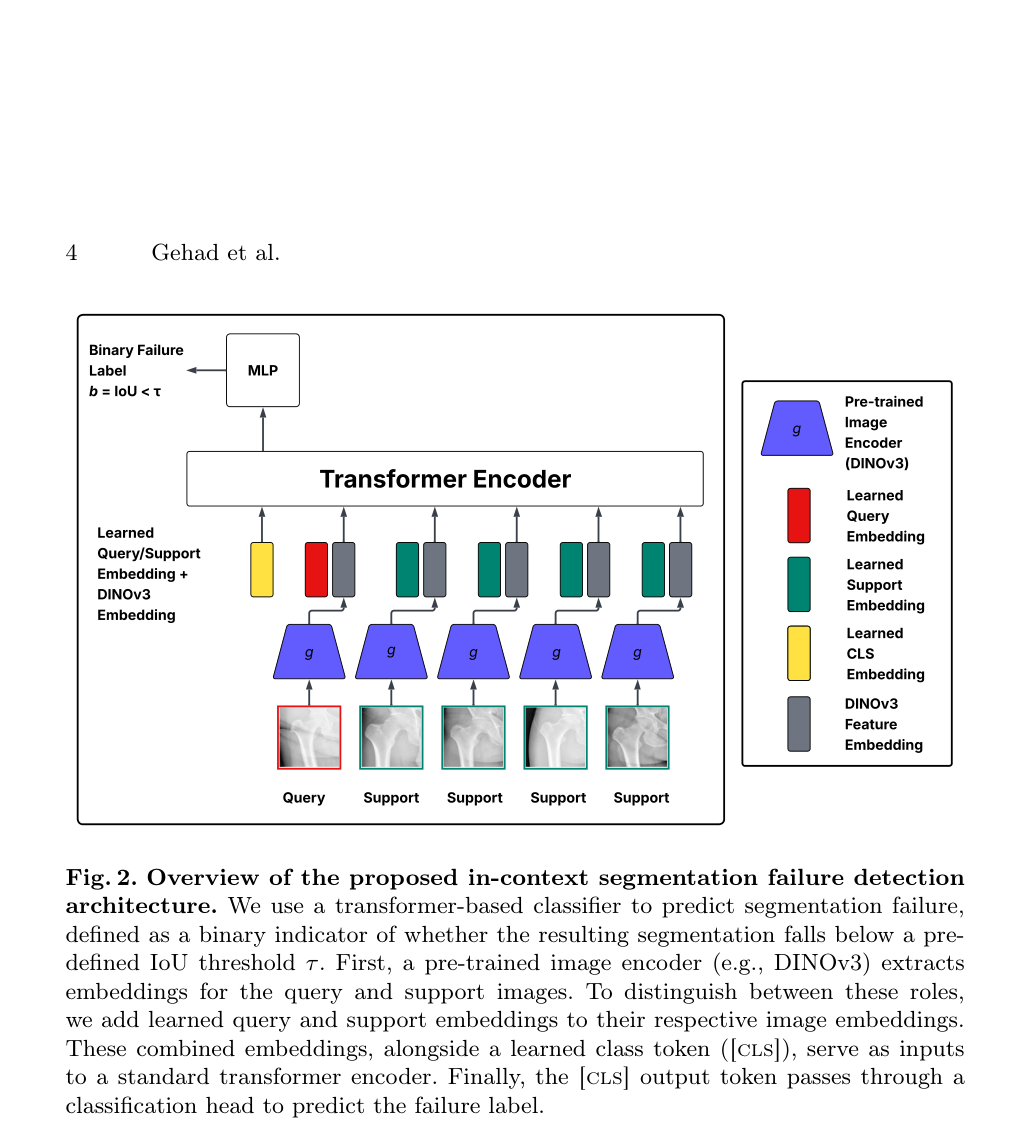
FreqDINO++ 在冻结 DINOv3 上用 MR-Adapter、F2-Enhancer 与 TC-Decoder 把分割、分类、检测和回归收进同一套超声框架。
本文提出了 Spot-the-shift 基准,用于评估多模态大模型(MLLMs)在真实驾驶场景中检测、描述并定位长期结构性变化的能力,并展示了一种通过合成数据微调以提升模型性能且保持通用能力的方法。
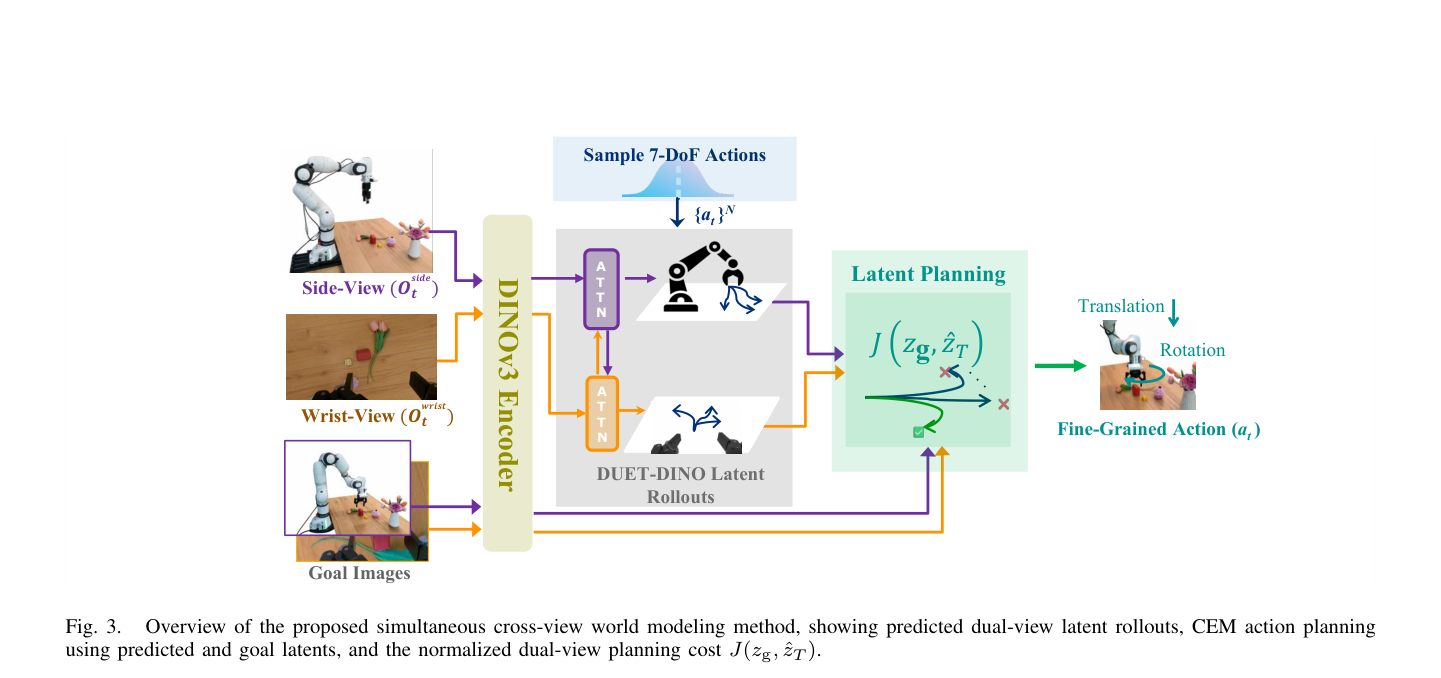
本文提出 DUET-DINO,一种通过跨视角注意力机制联合建模侧视和腕视相机观测的潜在世界模型,实现了全 7-DoF 末端执行器动作的零样本目标条件规划,并在多种操作任务中显著优于单视角基线。