快速导读:DepthEvidence 是约 4B 参数模型:用相机条件解码器预测稠密度量深度,经稠密到语言接口转成对象对齐的连续几何令牌,让回答直接条件于自身深度证据。
带度量约束的空间问答不只是“谁更近”,还要在厘米级深度区间里正确绑定对象与绝对尺度。稠密深度模型给出像素测量,空间 VLM 能谈对象关系,但若预测深度不进入答句条件,模型仍可能把区间外干扰物一并选中。
DepthEvidence(arXiv:2609.31103 ,Alibaba Token Hub / 北邮)给出约 4B 的统一方案:相机条件解码器先预测全分辨率度量深度,再经稠密到语言接口把深度与解码器特征编码为对象对齐的连续几何令牌,让 Level-0 稠密预测、Level-1 实例度量与 Level-2 组合推理共用同一 VLM。
英文题目:DepthEvidence: Unifying Metric Depth Prediction and Geometric Reasoning in Multimodal Language Models
论文出处:arXiv 每日论文精选 · arXiv:2609.31103
原始论文:PDF / 论文页面
这篇论文解决什么问题?
如图 1(a) 所示:选出柜子右侧且平均相机深度落在 1.30–1.33 m 的对象,必须同时满足空间过滤与数值区间。没有对象对齐的度量证据,模型容易把 1.35 m、1.48 m 的枕头一起选进答案。
现有深度感知 VLM 已能做像素查询或并行稠密输出,但“能预测深度”不等于“答案条件于该深度场”。答案监督只盯最终文本时,中间几何表示的数值内容可能在语言交互中被冲淡。
因此需要显式接口与几何监督:测量必须来自正确图像区域,并与正确引用保持关联;数值内容还要在投影到语言侧后仍可恢复。
核心创新
- 对象对齐的稠密到语言接口:把自身稠密深度转成连续几何令牌,并在语境交互前后做几何监督。
- 统一 4B 模型:相机条件稠密预测 + 实例级深度指令微调,贯通 Level-0/1/2。
- Depth-VQA 基准:区分对象度量、相对比较与空间-数值联合决策。
- 九数据集平均稠密 δ1 与双轨推理 Overall Acc 在评测方法中领先,同时大体保留通用 VQA。
方法概览
以 Qwen3.5-4B 为骨干。Stage-1:相机条件解码器融合多尺度视觉特征与高分辨率 RGB refinement,监督稠密度量深度。Stage-2:稠密到语言接口在引用区域内池化深度与解码器特征,编码为锚定对象标识的连续几何令牌;用 Lraw/Lctx 等几何目标保持语境交互前后度量可恢复,并用排序目标监督对象远近。令牌经缓存续写进入答句生成。配套 Depth-VQA,覆盖 Level-1 实例度量与 Level-2 相对/度量组合推理。
- 骨干为 Qwen3.5 语言模型。视觉编码器提供多尺度特征;相机条件深度解码器结合高分辨率 RGB refinement 输出度量深度图,对应 Stage-1 的稠密监督。
- 稠密到语言接口在引用 mask/框内池化预测深度与解码器特征,生成锚定对象标识符的连续几何令牌。辅助深度目标分别在进入语言语境前(Lraw)与交互后(Lctx)约束度量可恢复,排序目标(Lrank)监督对象远近。
- 答句生成采用缓存续写:图像与问题前缀只编码一次,几何令牌以续写方式注入,避免对每个对象重复跑完整前缀。训练上 Stage-2 打开接口与实例级指令数据,覆盖测量与组合推理。
- 评测体系把能力拆成 Level-0 稠密 δ1、Level-1 实例度量、Level-2 相对轨(排序/集合)与度量轨(间隙、区间、裕度决策),并引入 Depth-VQA 以检查几何证据是否真正进入语言答案。
逐图理解论文
证据鸿沟
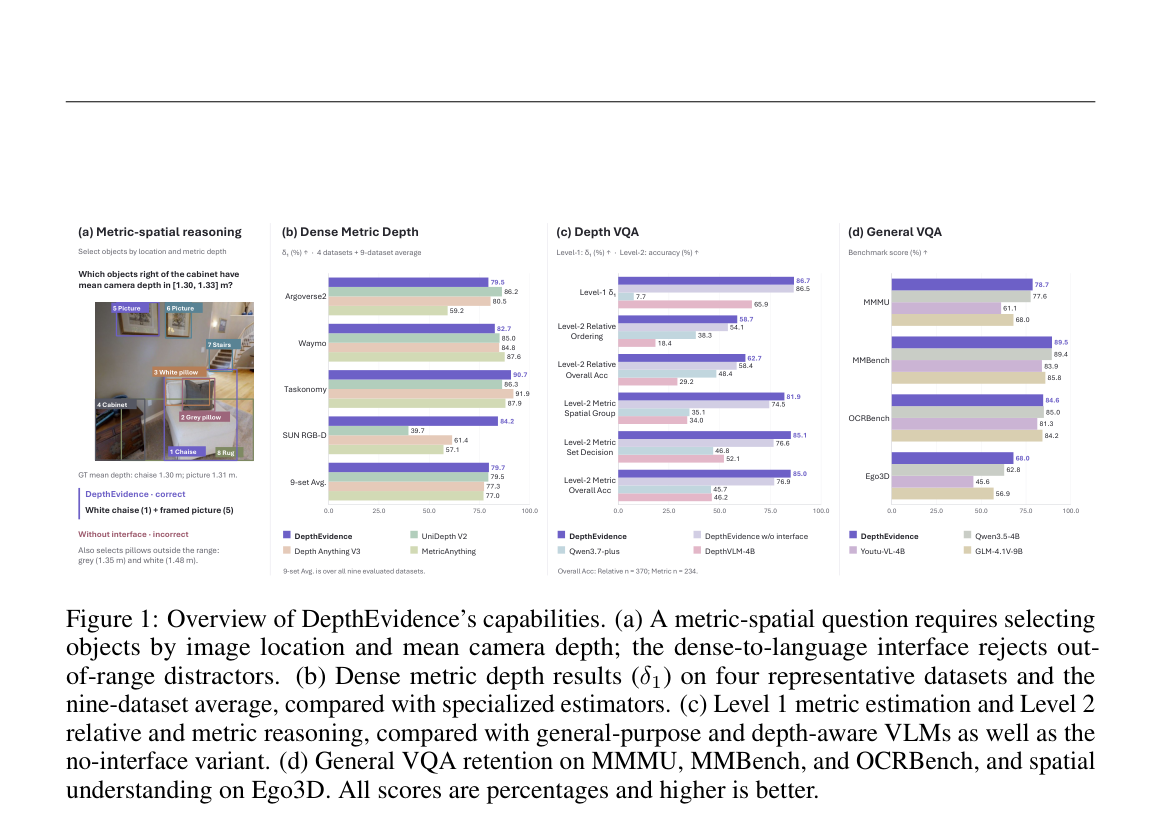
图1四宫格总览能力:(a) 柜子右侧 1.30–1.33 m 的度量空间题,有接口选中躺椅与画框,无接口误收区间外枕头;(b) 稠密 δ1 与九集平均约 79.7%;(c) Level-1/2 Depth-VQA;(d) 通用 VQA 与 Ego3D。适合开篇总览。
接口机制
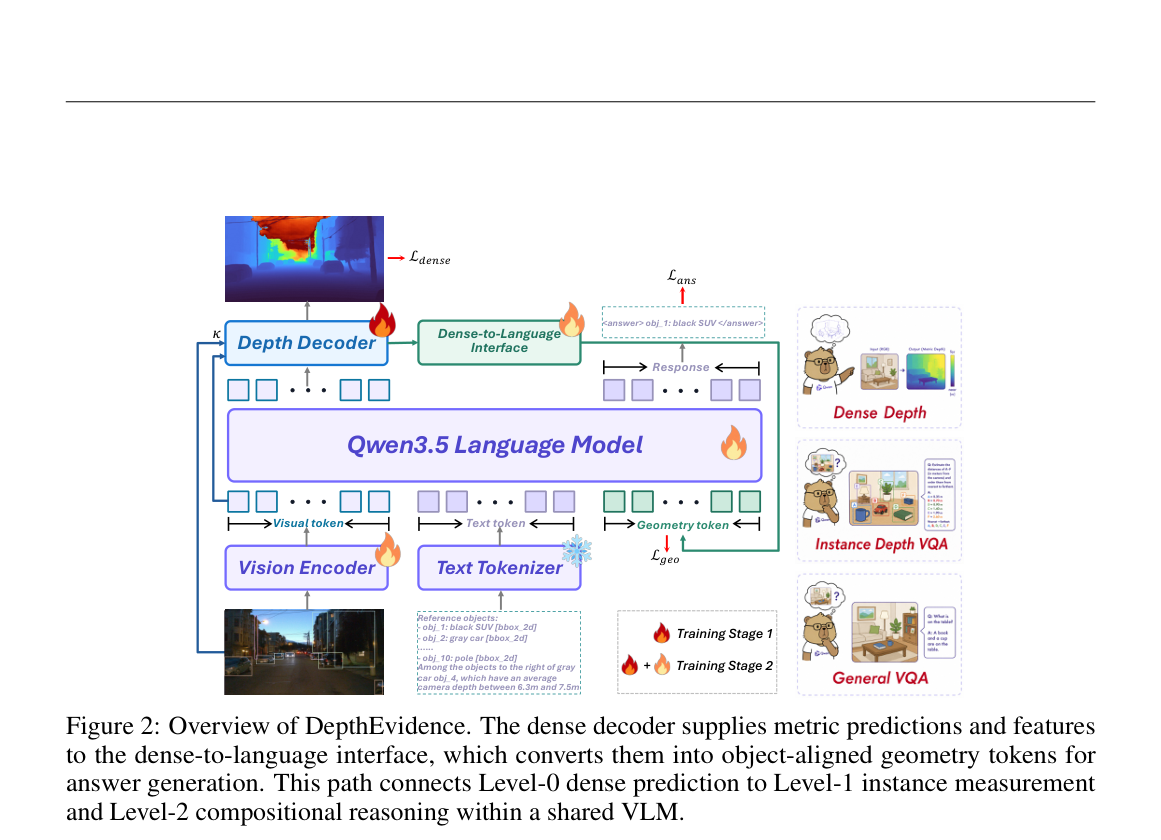
图2是方法主图:视觉/文本进入 Qwen3.5,深度解码器输出稠密深度,稠密到语言接口生成几何令牌回流语言模型并产生答案;右侧标明 Level-0/1/2。宜作特色图。
Figure 4: Representative Level-2 cases corrected by the dense-to-language interface
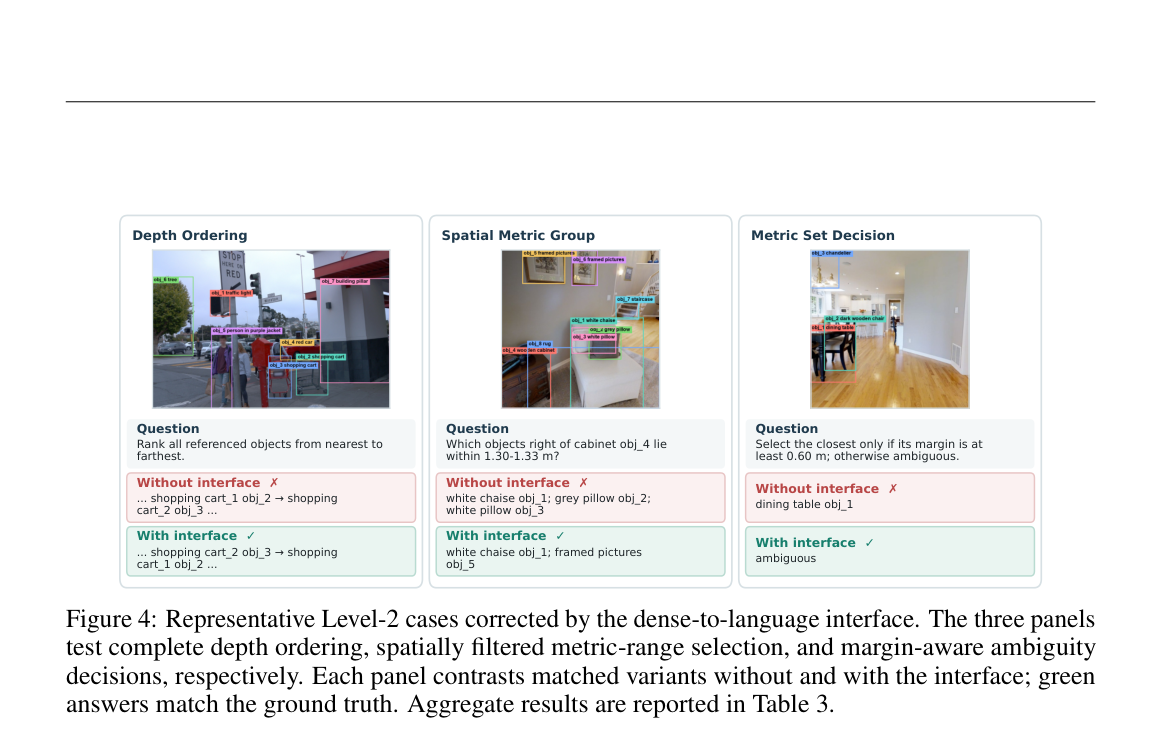
图4给出三类 Level-2 纠错对照:完整排序、空间度量组选择、裕度感知集合决策;红叉无接口、绿勾有接口,是接口必要性的直观证据。
实验如何设计?
- 稠密:Argoverse2、Waymo、NuScenes、DDAD、ScanNet++、HyperSim、Taskonomy、SUN RGB-D、Booster 等九集,主看 δ1 未加权平均。
- 实例与推理:Depth-VQA;Relative Overall Acc 聚合 370 题,Metric Overall Acc 覆盖以准确率计分的 234 题,数值间隙另报 δ1。
- 通用/空间:MMMU、MMBench、OCRBench、Ego3D 等,对比基座 Qwen3.5-4B 与其他开源/商业 VLM。
- 消融:去掉接口、只加度量语言监督、SSI/HR 解码器项、接口监督项组合,以及推理时延/显存。
关键结果与论文证据
- Level-0:九集平均 δ1 达到 0.7972,略高于 UniDepth V2 的 0.7945,并大幅高于对照的深度感知 VLM;SUN RGB-D 上 δ1 约 0.8420,优势更明显(页7,图1b)。
- Level-1:δ1=0.8666、RMSE=8.6062、AbsRel=0.1629,领先所评方法;相对无接口,δ1 几乎不动但 RMSE/AbsRel 明显下降,说明大误差更少(页7–8)。
- Level-2:Relative/Metric Overall Acc 为 0.6270/0.8504;相对 DepthVLM-4B 提升约 33.51/38.89 个百分点,也高于 Seed-2.1-Turbo 与 Gemini-3.1-Pro-Preview 的报告口径(页7–8)。
- 图4 的匹配对照显示:完整深度排序、空间过滤后的窄区间选择、以及“裕度不足则判 ambiguous”的决策,都因接口而从错误改为正确;聚合上相对无接口 Relative/Metric Overall Acc 分别 +4.32/+8.12 个百分点(页8)。
- 通用 VQA 相对基座大体保持或小幅波动,Ego3D 准确率升、RMSE 约降 48.1%,说明度量几何证据可改善空间理解而不必牺牲通用能力(页8,图1d)。
阅读时需要注意
- 依赖相机内参与显式对象引用;标定、定位或深度误差会在窄区间问题上放大。
- 几何令牌增加推理时延与显存;对象数上升时成本更明显。
- 未来需检验更噪声内参、更弱引用,并把接口扩展到其他几何证据模态。
关联工作
- DepthLM、DepthVLM 代表深度感知 VLM 的像素/稠密输出路线。
- UniDepth、Metric3D、Depth Anything 系列构成专用稠密估计对照。
- SpatialVLM、SpatialRGPT、G2VLM 等则从空间问答或几何重建侧逼近同一问题。