快速导读:LongTake 用真实长视频上的 Long-Horizon TF 直接初始化自 rollout DMD,并可选 Hybrid DMD 延长后期监督,以在长程生成中稳住动态与画质。
世界模型、游戏模拟和长镜头创作都要求场景在几十秒甚至更久里持续演化:人物继续走、镜头继续动,而不是开头精彩、后半段发呆或糊掉。自回归视频扩散天然适合接龙,但多数模型只在约五秒片段上训练,一拉长就容易近静态或画质崩坏;更麻烦的是,一致性指标还可能给“不动但清晰”的视频打高分。
LongTake(arXiv:2609.38562 ,KAIST / Georgia Tech)提出两阶段管线:先在策展真实长视频上做 Long-Horizon Teacher Forcing,让模型在长前缀条件下学会后续动态;再用该权重直接初始化自 rollout 的分布匹配蒸馏(DMD),并可选 Hybrid DMD 把监督延伸到更晚帧。项目页 https://bw-park.github.io/LongTake/ 。
英文题目:LongTake: Learning to Sustain Dynamics in Long-Horizon Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.38562
原始论文:PDF / 论文页面
这篇论文解决什么问题?
长程失败常表现为运动衰减、重复循环或曝光/纹理崩坏。短时程教师强制只直接监督训练窗口内的预测,当前缀变长、sink 帧与近期帧时间跨度变大时,模型要靠泛化去填“教师空白”,而这正是长镜头最需要的能力。
标准少步 AR 视频扩散常走“短 TF → 中间 few-step 蒸馏 → 自 rollout DMD”三阶段。作者发现:若第一阶段就用长视频长前缀监督,得到的初始化足以让第二阶段在学生自 rollout 上生效,从而跳过中间蒸馏。
于是问题变成两个可操作目标:如何构造覆盖长时程关系的 TF 监督;以及如何在蒸馏阶段继续给后期帧有效教师信号,而不牺牲初始窗的联合分布匹配。
核心创新
- Long-Horizon TF:在真实长视频长前缀上监督后续帧,覆盖 sink 与近期帧的大时间跨度。
- 该 TF 权重可直接初始化自 rollout DMD,无需标准三阶段中的中间 few-step 蒸馏。
- Hybrid DMD 把双向联合监督与长程 AR 条件监督组合,拉长有效监督到更晚帧。
- 在 30s/60s rollout 上处于动态—美学帕累托前沿,Hybrid 动态程度最高。
方法概览
LongTake 两阶段训练:阶段一在策展真实长视频上做 Long-Horizon TF,让模型在长前缀 KV-cache(含 sink retention)条件下预测后续窗口,直接得到长程 AR 教师;阶段二用该权重初始化 few-step 学生,做短窗自 rollout 的联合 DMD,跳过标准管线中的中间 few-step 蒸馏。可选 Hybrid DMD:双向教师继续联合监督初始窗,长程 AR 教师对更晚帧做条件 DMD。骨干 Wan2.1-T2V-1.3B。项目页 https://bw-park.github.io/LongTake/ 。
- 图1左侧是 Long-Horizon TF:从真实长视频采样前缀,经 sink / earlier / recent 组成有界 KV-cache,对后续短窗口做教师强制,训练出 Long-horizon AR teacher。右侧是 Self-rollout DMD:该教师直接初始化 few-step 学生;联合 DMD 用冻结双向教师监督初始窗,Hybrid DMD 再让 AR 教师对更晚帧做条件监督。
- 关键实现细节包括并行缓存预填(可配合 sink retention 与 FIFO)、在真实长视频集(约 43K 对,含 OpenVidHD 等)上监督至约 30 秒,以及用 Wan2.1-T2V-1.3B 在 832×480、16 FPS、每 chunk 三潜变量帧、四步去噪设定下训练。
- 与短 TF 初始化对比(图5):同样 5 秒自 rollout DMD、评 30 秒时,Long TF 显著抬高动态程度并保持接近的美学质量,说明“更强 TF 初始化”本身就能支撑长程,而不必先插入独立的 few-step 蒸馏阶段。
逐图理解论文
两阶段训练
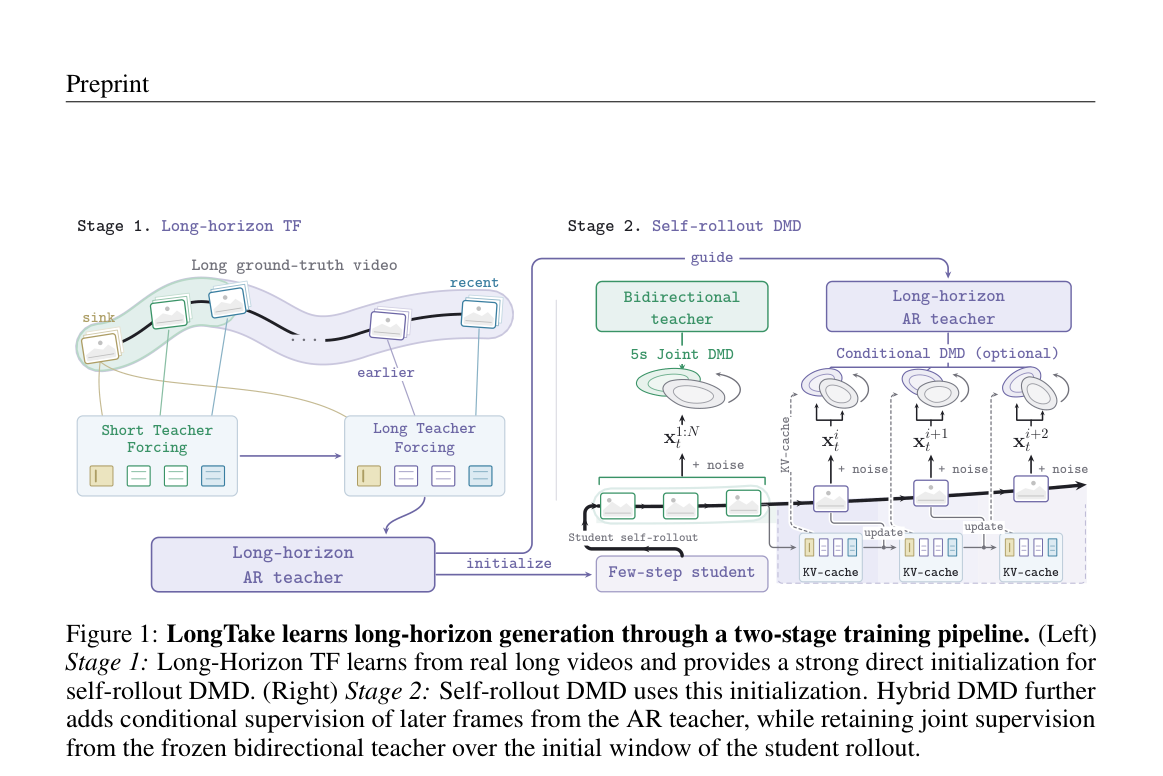
图1是两阶段总览:左为真实长视频上的 Long-Horizon TF 与长程 AR 教师;右为学生自 rollout DMD,双向教师做初始窗联合监督,AR 教师可选条件监督更晚帧。宜作特色图。
初始化收益
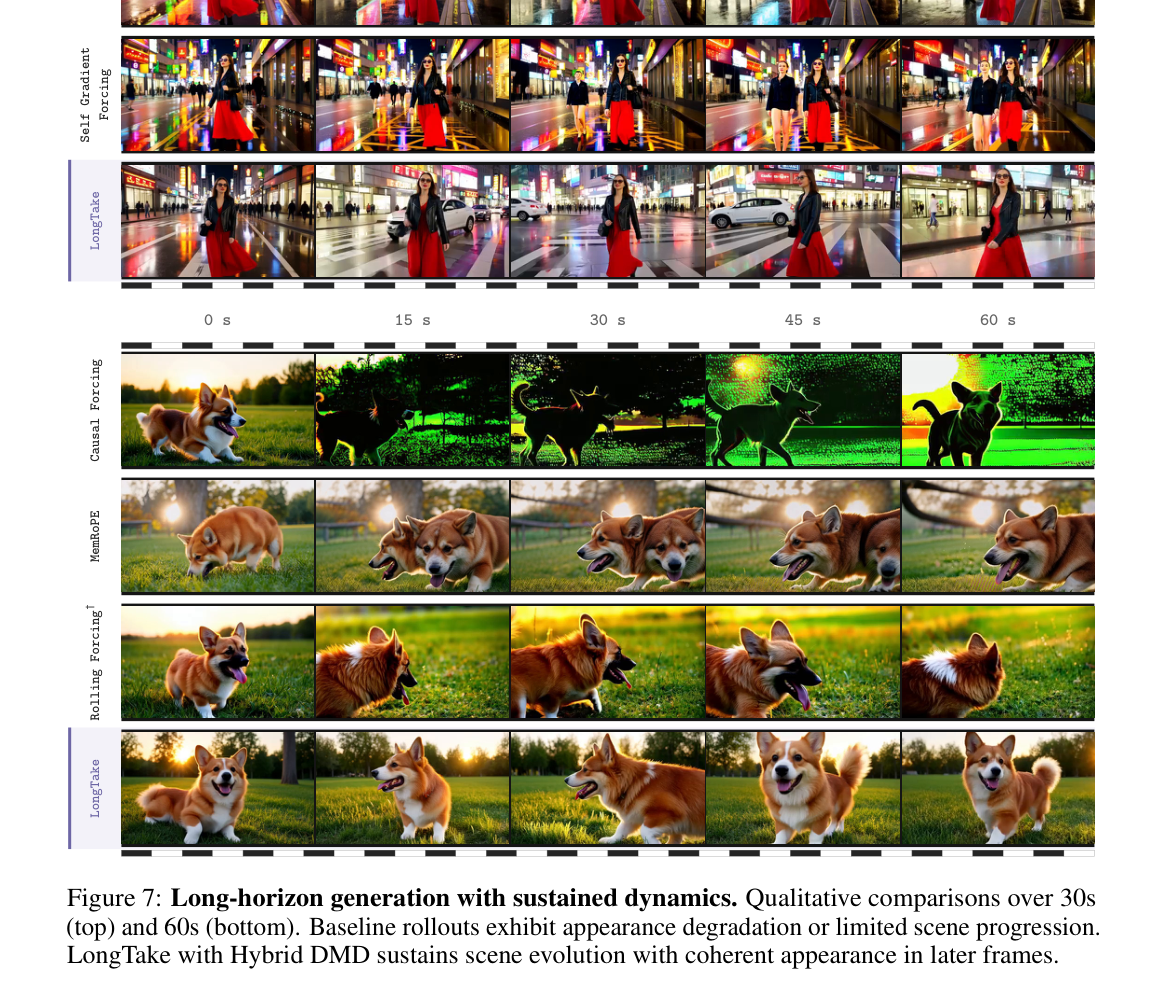
图7定性对比 30s 与 60s:基线后期易崩坏或停摆,LongTake(Hybrid DMD)在东京步行与柯基奔跑等场景中更持久地保持动态与外观。
关键证据
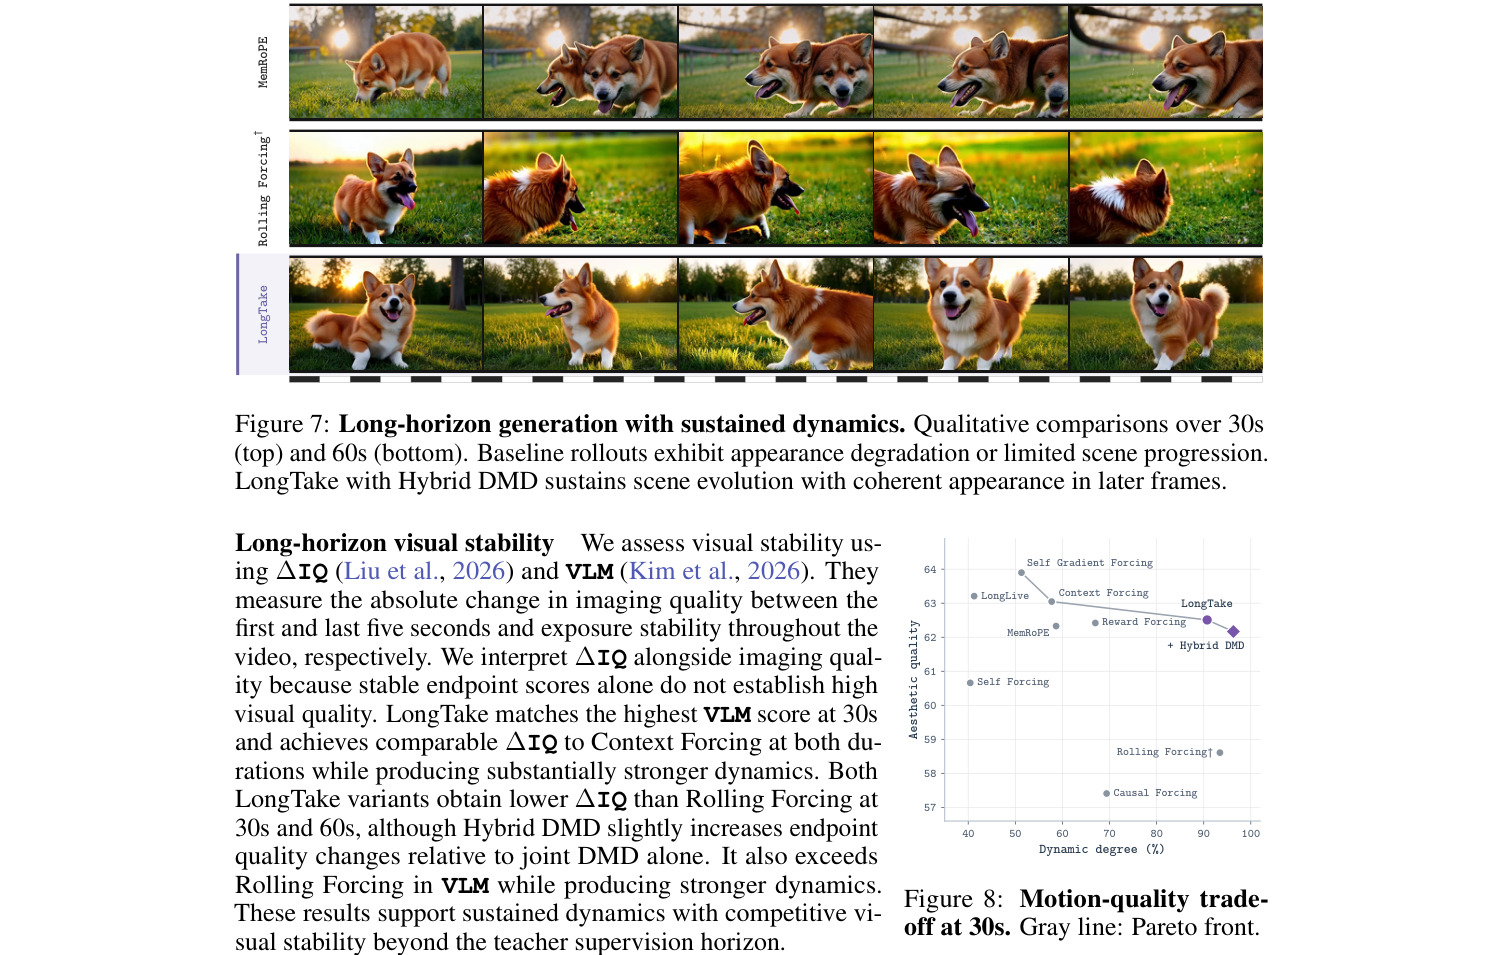
图8是 30s 动态程度对美学质量散点,灰线为帕累托前沿;LongTake 与 Hybrid DMD 位于右上,体现“高动态且美学可竞争”的权衡位置。
实验如何设计?
- 主表评 30s 与 60s AR rollout,报告 Subject Consistency、Dynamic Degree、Aesthetic、聚合 Quality,以及稳定性指标 ∆IQ 与 VLM。
- 基线覆盖 Self/Causal/Reward/Rolling Forcing、LongLive、MemRoPE、Context Forcing、Self Gradient Forcing 等;LongTake 为 Long-Horizon TF + 5s joint DMD,另报 Hybrid DMD(λ=0.2)。
- 消融扫描 Short vs Long TF、Hybrid 的 λ,并给出东京街景 30s、柯基田野 60s 等定性对照(图7)以及动态—美学散点(图8)。
关键结果与论文证据
- Table 1:LongTake 在 30s 达到 Dyn 90.73、Aesth 62.51、Quality 85.79;60s 为 Dyn 94.72、Quality 85.96。Hybrid DMD 进一步把 30s/60s 动态推到 96.30 / 97.36,并在 30s 取得最高 Quality 之一。
- 图8显示 LongTake 变体落在 30s 动态—美学帕累托前沿:比它更美的方法动态多停在约 58 及以下,而动态极高的部分基线美学明显更低。
- 定性上(图7),基线在长程中出现外观崩坏、主体分裂或场景停摆;LongTake+Hybrid 在 30s/60s 仍保持场景推进与外观连贯。
- 稳定性方面,LongTake 在 30s 匹配最高 VLM 分,∆IQ 可比 Context Forcing 且优于 Rolling Forcing,说明高动态并非靠牺牲稳定性硬换。
阅读时需要注意
- Hybrid 提高动态时,主体一致性与美学可能略降,需按目标时长在联合/Hybrid 间取舍。
- 依赖策展长视频与长前缀训练,复制成本高于短视频配方。
- 主结果基于特定 1.3B 骨干与分辨率,更大模型与交互式控制场景仍待验证。
关联工作
- Self/Causal Forcing 代表短监督或因果强制长生成基线。
- Context Forcing 代表另一类长视频监督对照。
- Rolling Forcing / MemRoPE 则从上下文与位置编码侧稳定长程。