快速导读:ATW 按场景与问题自适应地建模可执行世界,再用 PolyWorld 探测取证,从而做跨材料通用物理推理。
看一段台球、流体或布料视频,再问“如果拿掉某个物体,哪些碰撞不会发生”,模型既要读懂观测,又要推断看不见的物性与因果。纯 VLM 直推常在物理一致性上翻车;反过来,写死仿真工具链又很难跨材料、跨问题泛化。
Asking the World(ATW,arXiv:2609.39135 ,清华大学)提出通用智能体:先按场景与问题做 World Modeling,把视频校准成可执行世界;再进入 World Probing,用 PolyWorld Engine 查询、仿真与干预,最后凭执行证据作答。方法免训练,基座为 Gemini-3-Flash。
英文题目:Asking the World: Generalist Physical Reasoning through Agentic World Modeling and Probing
论文出处:arXiv 每日论文精选 · arXiv:2609.39135
原始论文:PDF / 论文页面
这篇论文解决什么问题?
物理推理的难点不在“认出物体”,而在潜在参数、未来演化与反事实干预——证据往往不在画面里,而在一个可运行的动力学账户中。CLEVRER 侧重刚体因果,ContPhy 引入流体、布料等连续介质,要求系统切换表示而不是套同一管线。
现有路线大致两极:VLM 靠宽泛先验,但评测反复暴露物理不一致;物理接地方法虽能仿真,却常提前承诺特定表示与推理程序。缺的是一个能“决定如何建模、如何探测”的通用智能体,并把世界当作主动实验工作区。
因此 ATW 把流程改成两阶段自适应闭环:建模阶段纠正掩膜、跟踪、动力学与材料假设;探测阶段对已提交世界做问题导向实验,阶段内可修订决策,但世界一旦提交即单向进入探测。
核心创新
- 把通用物理推理拆成自适应的世界建模与世界探测两阶段,操作由场景与问题决定而非预写死管线。
- 提出 PolyWorld Engine,用可编程多物理仿真把世界变成可干预的执行工作区。
- 阶段内反馈纠错(如刚体改软体、纠正干预目标),并以 CEM 恢复任务相关动力学。
- 在 CLEVRER、ContPhy 与真实场景上相对强 VLM 与 PhysMind 取得显著增益。
方法概览
Asking the World(ATW)分两阶段:World Modeling 从视频校准任务相关可执行世界(掩膜、位姿跟踪、表示选择、CEM 系统辨识);World Probing 对世界查询、仿真与干预,基于执行证据作答。PolyWorld Engine 提供刚体、软体、布料、绳子、流体及耦合交互的可编程多物理后端。阶段内反馈可修正错误假设,但建模向探测单向提交。免训练,以 Gemini-3-Flash 为基座 VLM。
- 系统总览(图2)以台球反事实为例:输入视频与选择题后,建模智能体发现黄球掩膜缺失并修订,执行刚体位姿跟踪,拟合逆动力学(示例误差约 0.0025 m),确认资产就绪后提交可执行世界;探测智能体移除棕色球、查询未来数秒碰撞事件,再汇总证据选出不会发生的选项。
- 图3强调阶段内反馈:建模时若看到球体明显形变,智能体把刚体假设改成软体;探测时若干预目标 ID 与选项颜色不一致,则改探青色墙。反馈改变的是阶段内决策,而不是把探测结果倒灌回去重建模。
- PolyWorld Engine 面向智能体提供高层语义接口,覆盖刚体、软体、布料、绳子、流体及耦合;World Modeling 中用 CEM 做任务相关系统辨识,只恢复解题所需动力学,而不是重建整城物理。智能体按问题选择表征与工具调用,避免强制统一重建。
逐图理解论文
先验与管线困境
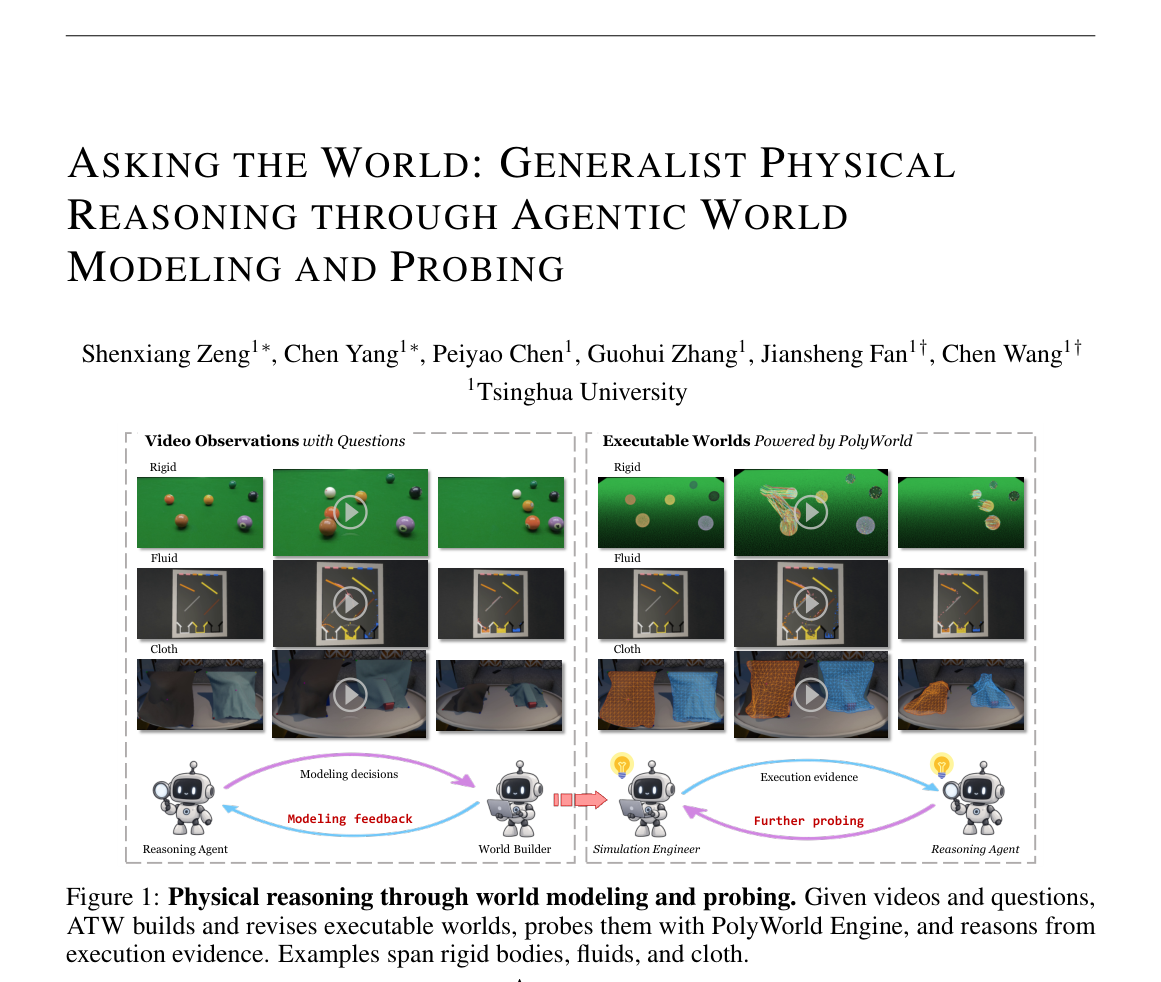
图1给出总览:左侧是刚体、流体、布料视频观测与问题,右侧是 PolyWorld 驱动的可执行世界;下方 Reasoning Agent、World Builder 与 Simulation Engineer 形成“建模决策—建模反馈—进一步探测—执行证据”闭环。宜作特色图。
建模与探测
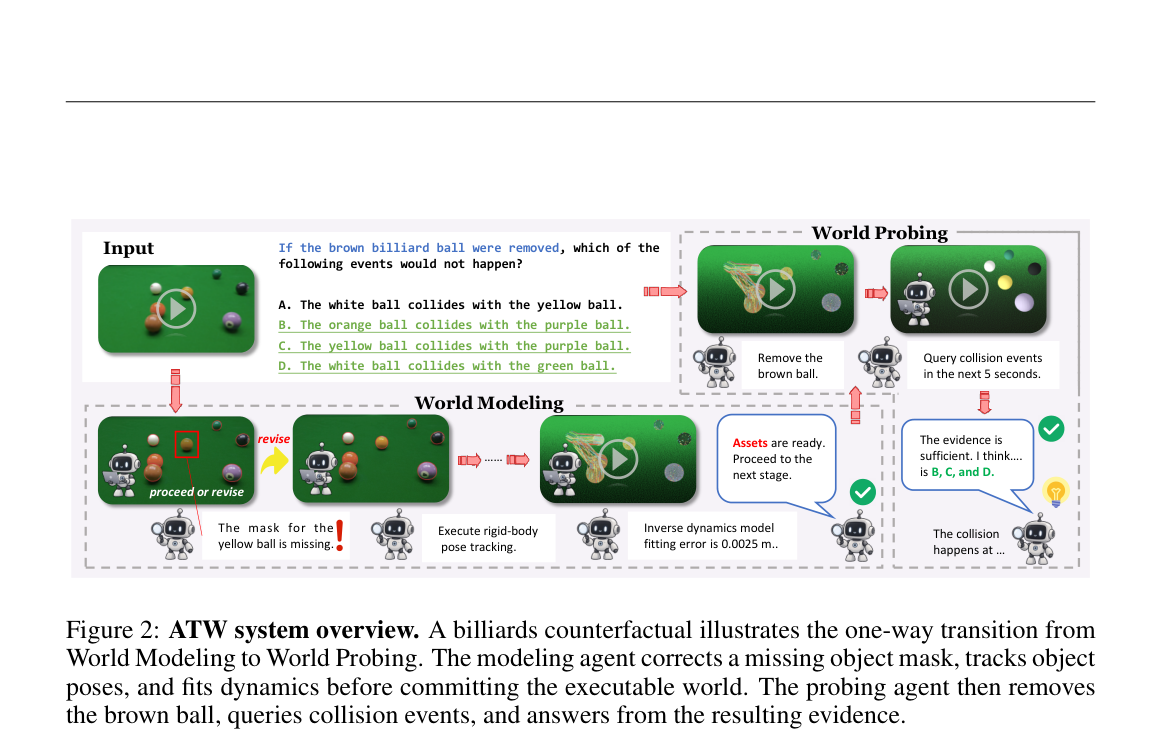
图2用台球反事实走查系统:建模阶段补掩膜、跟踪位姿、拟合动力学后提交世界;探测阶段移除棕色球、查询碰撞并基于证据作答,展示建模到探测的单向过渡。
阶段内纠错
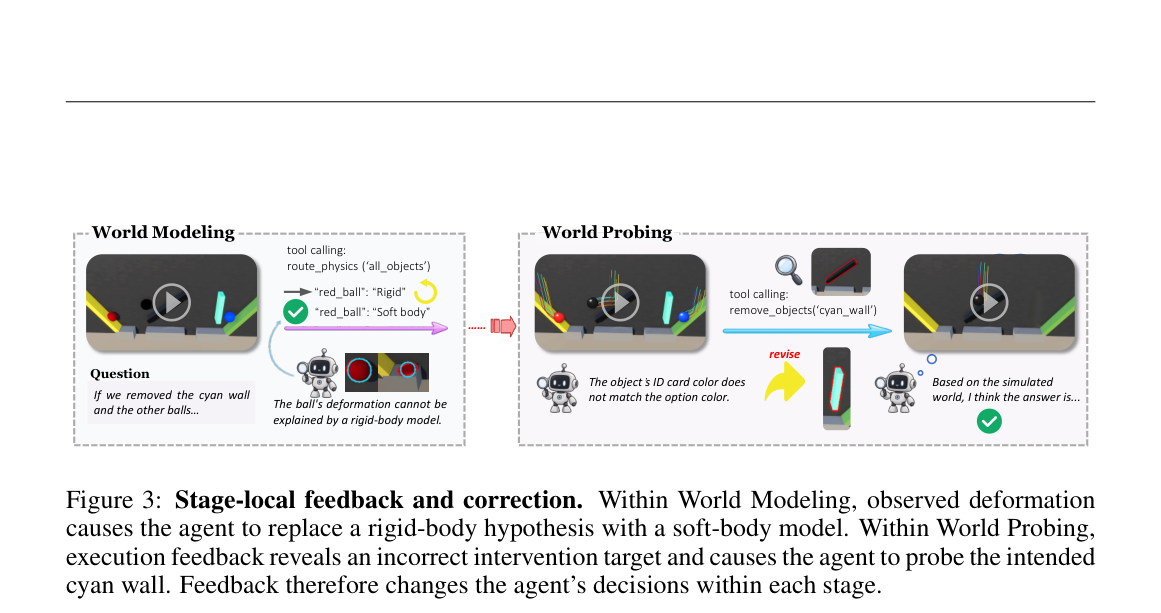
图3说明阶段内纠错:建模时因形变把刚体改软体;探测时纠正错误干预目标到青色墙,强调反馈改变阶段内决策而非双向重写世界。
实验如何设计?
- CLEVRER 验证子集:1000 视频、4280 问题,分解释/预测/反事实,主指标为 per-question(全部选项正确才算对)。ContPhy:600 视频、1950 问题,分属性、预测、反事实、目标驱动。另有三类真实场景共 60 题。
- 基线含 Gemini-3-Flash、GPT-5.5、Qwen3-VL、PhysMind、STAR、VideoAgent 以及若干训练式视频推理模型。ATW 不在基准上微调;Gemini 基线吃视频,部分模型吃均匀采样帧。
- 消融对比去掉自适应推理、替换/关闭系统辨识与物理后端,以及把 ATW 接到不同基础模型上的增益(图6、图8 等)。
关键结果与论文证据
- CLEVRER 上 ATW 总体 per-question 80.82%,相对 Gemini-3-Flash +46.50、GPT-5.5 +13.58、PhysMind +8.27;解释/预测/反事实分别为 83.87%、88.60%、75.16%,反事实相对 GPT-5.5 约 +23.83 点(页6–7,Table 2)。
- ContPhy 总体 70.56%,相对 Gemini-3-Flash +28.10、GPT-5.5 +3.53;属性与预测增益更明显,反事实仍落后 GPT-5.5 约 6.46 点,说明执行取证并非全类别无条件领先(Table 3)。
- 真实三场景总体约 71.67%,高于 GPT-5.5 约 28.33 点;定性上可看到台球/玩具车等从分割、跟踪到动力学重建再探测的完整链路(图1、图5)。
- 消融表明自适应世界推理与系统辨识对精度关键;跨模型接入 ATW 后,开放与闭源 VLM 都能获得百分点级提升(图6、图8)。
阅读时需要注意
- 依赖基座 VLM 的感知与工具调用,错误掩膜或错误材料假设可能污染后续仿真。
- 真实评测规模有限,开放世界鲁棒性仍需更大样本验证。
- ContPhy 反事实未全面超越最强 VLM,探测策略与证据充分性仍有改进空间。
- 墙钟成本包含仿真与 CEM,不宜直接与纯前馈 VLM 比延迟。
关联工作
- PhysMind 代表强训练无关物理推理基线。
- STAR / VideoAgent 代表工具调用与 Agent 式视频推理。
- 直接 VLM 推理则对应无显式世界执行的先验路线。