快速导读:AD-Memo 让驾驶 VLA 以思维链扩展写出可解释语言记忆,并用半闭环 RL 算法 Da Capo 改善记忆信用分配与驾驶轨迹。
驾驶 VLA 很强,但一张图很贵:短时窗视觉历史往往撑不起“谁先到全向停车路口”“刚才被牌子挡住的行人还在不在”这类记忆依赖决策。隐向量记忆能塞进交叉注意力,却既不好读、也不好塞给别的模型。
AD-Memo(arXiv:2609.38641 ,UIUC / NVIDIA)把语言记忆写成 CoT 扩展:周期性记录影响驾驶的周边对象,并作为后续输入。训练上先做驾驶/问答/记忆写入的多任务 SFT,再用半闭环 RL 算法 Da Capo 缓解自生成记忆的曝光偏差。项目页 https://kaiyan289.github.io/projects/ad-memo/ 。
英文题目:Vision-Language-Action Autonomous Driving Agent with Language-based Memory
论文出处:arXiv 每日论文精选 · arXiv:2609.38641
原始论文:PDF / 论文页面
这篇论文解决什么问题?
论文用算例说明:多相机高频输入时,把历史从零点几秒扩到数秒,token 与二次注意力代价会急剧上升。于是系统不得不砍历史,却在全向停车次序、遮挡物与更长时场景理解上吃亏。
既有方案大致两类:隐向量记忆(不可解释、难移植)与跨 episode 的语言示例检索(缺少当前片段内的对象级事件账本)。
目标因此很具体:记忆要短、要可读、要能在同一 episode 内接力,并且最好能作为即插笔记帮助其他模型。
核心创新
- 面向驾驶的 episode 内语言记忆:可解释、可复用、可插入其他模型输入。
- Da Capo 半闭环 RL:开环控制 + 闭环记忆,并按 token 类型做异构优势分配。
- 面向记忆依赖场景的数据管线:全向停车与通用驾驶,兼顾驾驶与 VQA。
- 自评与迁移实验显示记忆既改善轨迹,也能作为即插即用笔记增强其他模型。
方法概览
AD-Memo 在驾驶模式中于 CoT 内写出格式化语言记忆,并作为后续关键帧输入;另支持基于记忆的 MCQ 场景问答与独立记忆写入。训练分两阶段:多任务 SFT,以及 Da Capo 半闭环 RL——控制开环回放真值状态,记忆闭环使用自身历史记忆;驾驶 token 用逐步优势,记忆/问答 token 用轨迹级优势。数据来自 Physical-AV 上构建的全向停车与通用驾驶记忆依赖集。
- 智能体在关键帧切换驾驶与 VQA 模式。驾驶时输出 CoT、其中的格式化记忆,以及未来轨迹;记忆进入后续关键帧的语言输入。片段末用累计记忆回答关于关键物体的 MCQ,逼模型在驾驶过程中把该记的东西写下来。
- SFT 联合三类任务:带记忆的驾驶、基于记忆的问答、以及单帧记忆写入。随后进入 Da Capo:视觉与过去轨迹开环回放专家状态,记忆则闭环使用模型自身历史,从而在不必做昂贵环境仿真的前提下缓解曝光偏差。
- 信用分配上,驾驶 token 因开环而不影响后续状态,采用逐步优势;记忆与问答 token 会影响后续,采用轨迹级优势,并配合组内标准化处理不同奖励量纲。
逐图理解论文
语言记忆机制
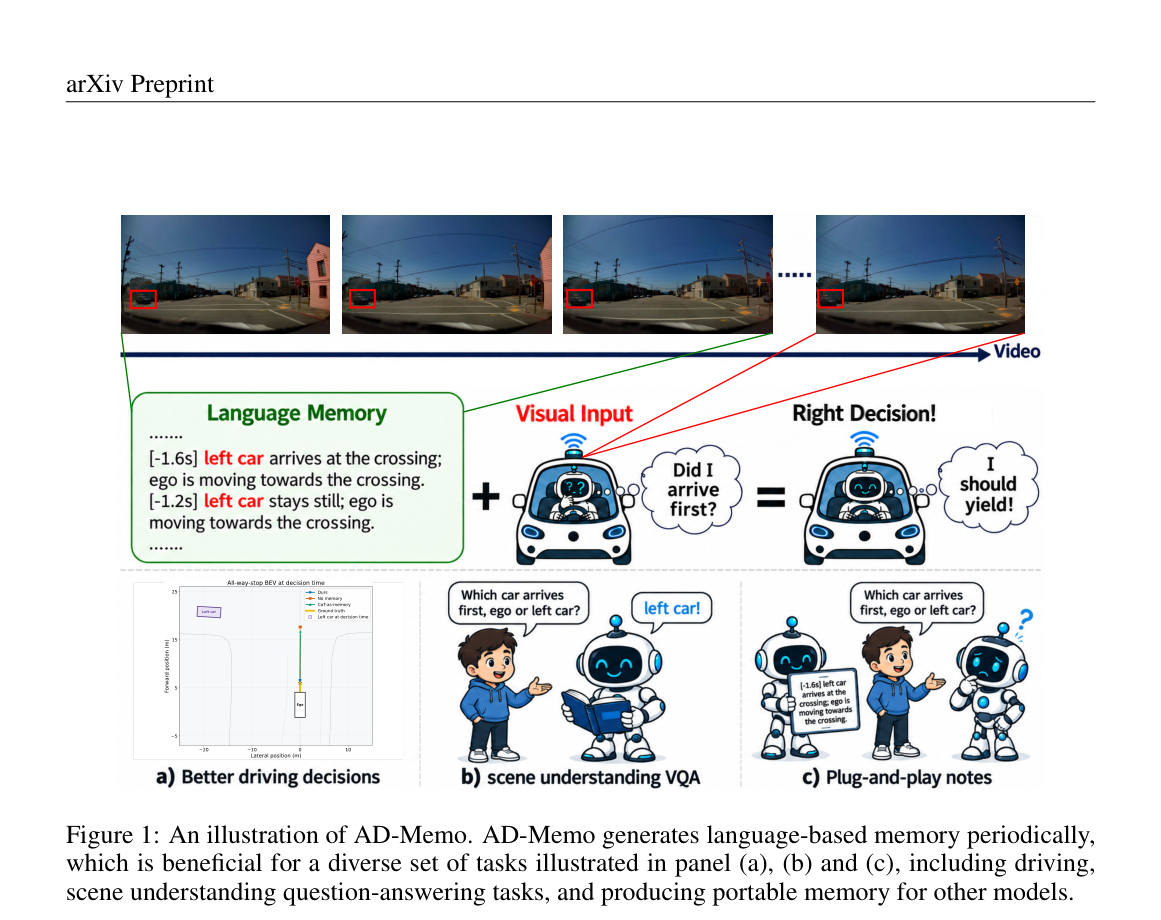
图1总览 AD-Memo:周期性语言记忆与当前视觉融合,支持更好驾驶决策、场景问答,以及把记忆当作即插笔记传给其他模型。宜作特色图。
Da Capo 训练
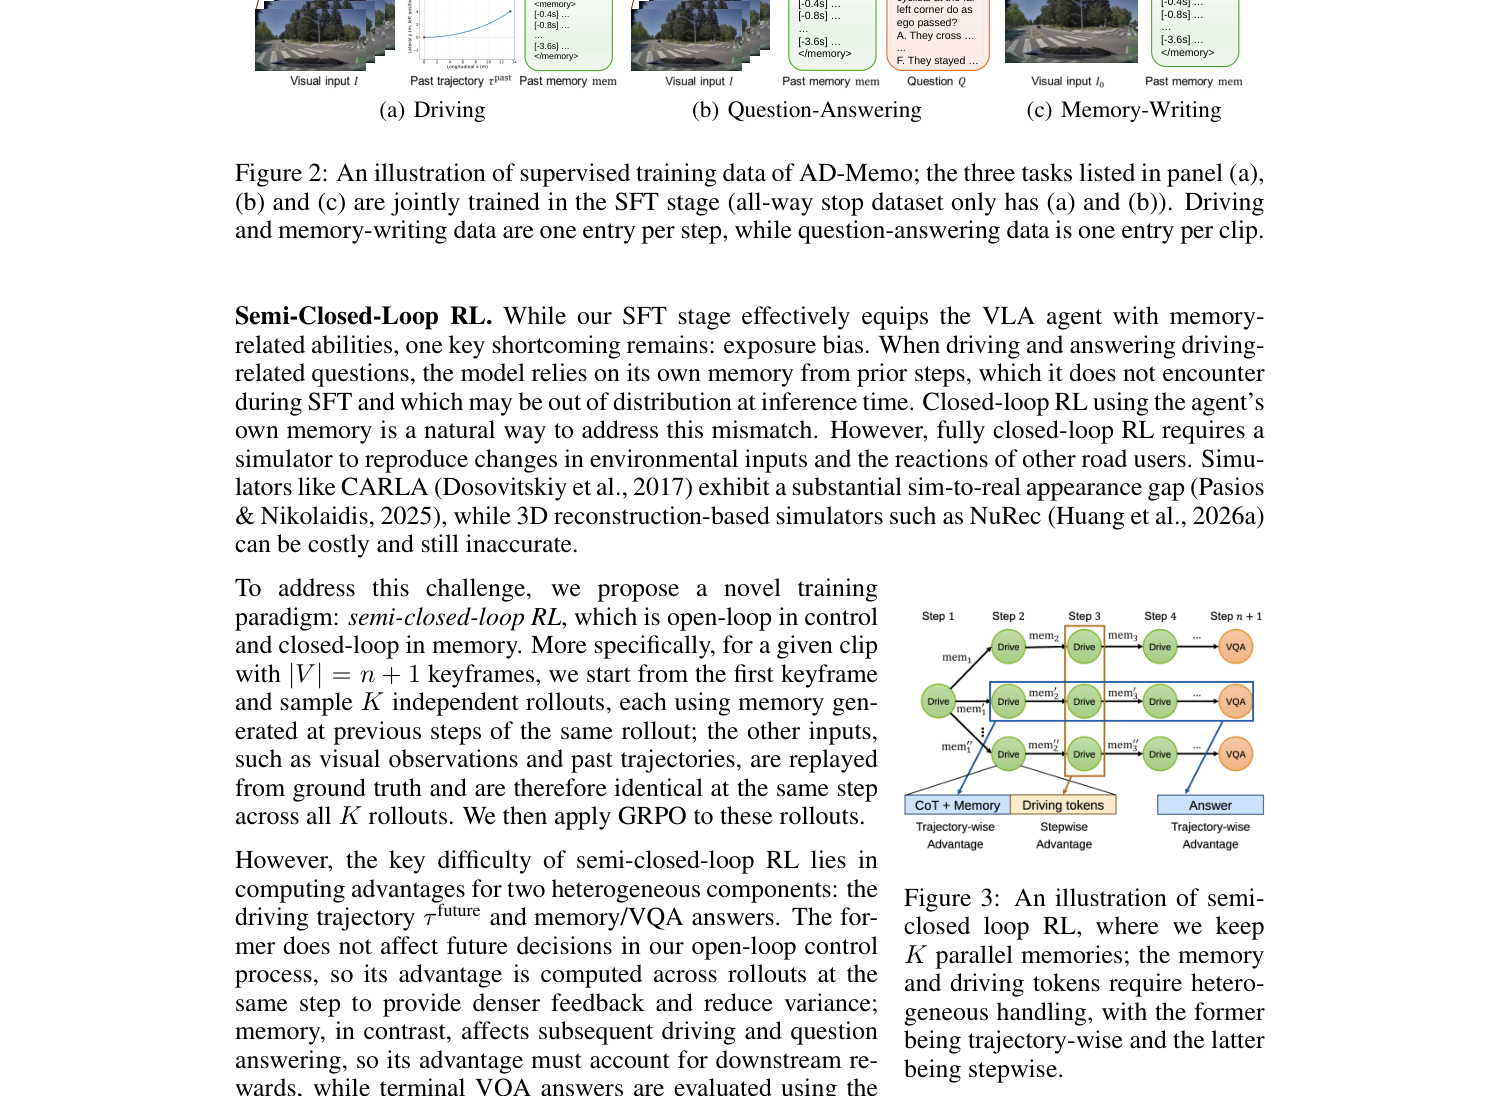
图3示意 Da Capo:K 条并行记忆 rollout,驾驶用逐步优势,记忆/问答用轨迹级优势,体现“控制开环、记忆闭环”。
关键证据
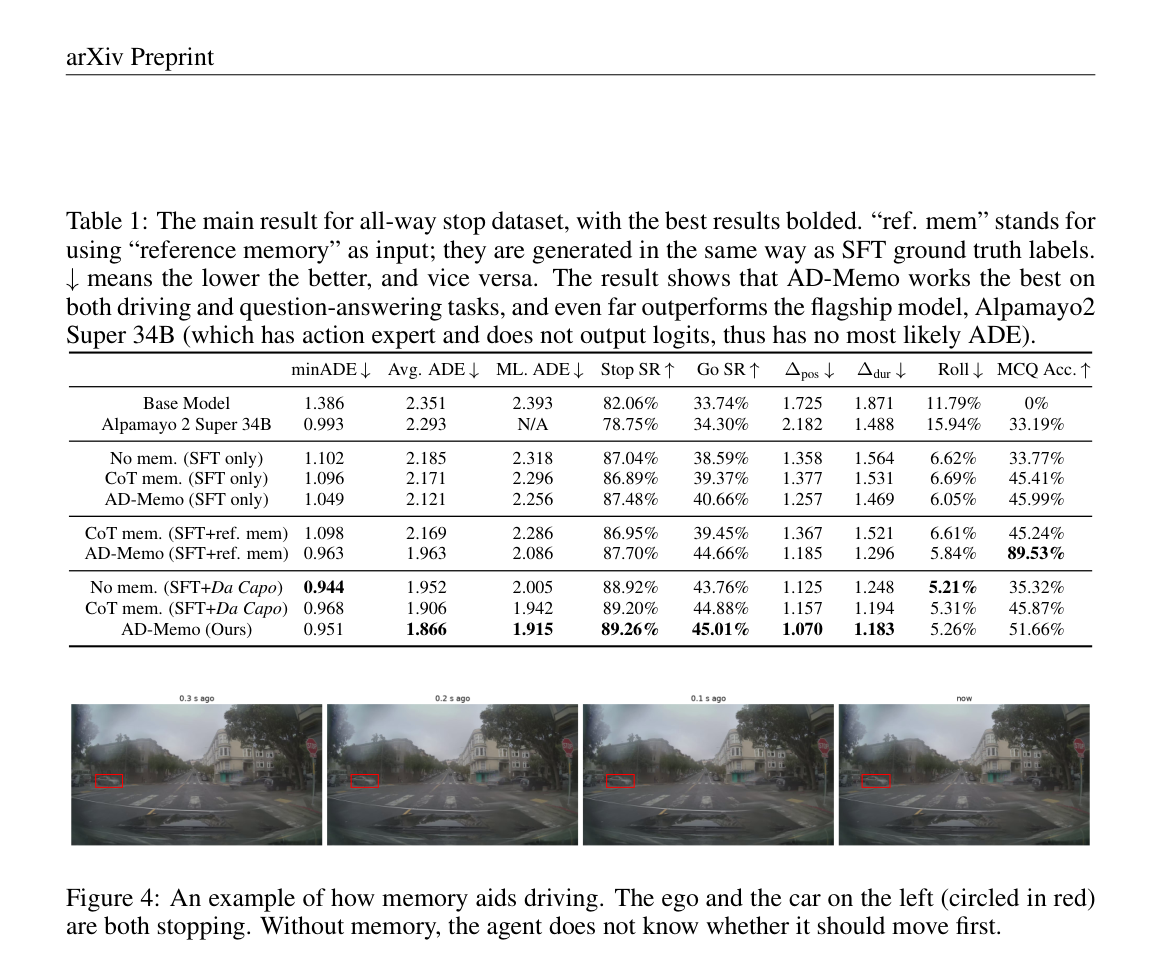
图4给全向停车例子:自车与左侧车都在停,仅看当前帧无法判断谁先到;需要记忆记录到达次序才能决定是否礼让。
实验如何设计?
- 骨干默认是约 2B、单相机中心的 Alpamayo 2 检查点;对照还包括无记忆、把过去 CoT 当记忆,以及 flagship Alpamayo 2 Super 34B。
- 全向停车与通用驾驶两套自建记忆依赖数据均按约 3:1:1 划分 SFT/RL/测试;全向停车测试覆盖 2479 clips 与停前关键帧统计。
- 指标覆盖轨迹 ADE/FDE、任务成功率与滚行率,以及场景 MCQ;另把记忆接到外部模型评 WaymoQA/LingoQA。
关键结果与论文证据
- Table 1:AD-Memo 在全向停车上取得最佳 Avg./ML. ADE 与停/走成功率,MCQ 51.66%;参考记忆可把 MCQ 推到 89.53%,说明高质量语言记忆仍有很大空间,也解释了为何需要 RL。
- 定性上,左右车同时停住时,没有记忆就难判断先手;记忆写入“左侧车更早到达”后,轨迹更贴近应让行的专家行为。
- Table 3:通用驾驶上 AD-Memo 仍取得最佳 Avg.ADE/FDE 与有竞争力的 MCQ,显示方法不止绑定单一路口任务。
- Table 4:合并后的可移植记忆相对“仅末帧”提升 WaymoQA/LingoQA;未合并、重复陈述的记忆反而可能误导外部模型。
阅读时需要注意
- 当前记忆视野大约覆盖十余秒量级,更长期规约未作为主评测。
- 结果建立在研究数据集与开环协议上,不能直接等同真实道路部署表现。
- 自生成记忆相对参考记忆仍有明显 MCQ 差距,记忆压缩与去噪仍关键。
关联工作
- 隐向量记忆 VLA 强调效率,但牺牲可解释与可移植性。
- CoT-as-memory 证明“有文本历史”有帮助,但更偏自我动作描述。
- 开环 RL 在驾驶里常见,因其避免高成本仿真;Da Capo 试图只把闭环用在记忆上。