快速导读:MindWorldBench 用零动作提示与反事实设计,检验图生视频模型能否从感知、信念与欲望推出正确行为,并暴露全知偏置。
图生视频模型已经能做出流畅、物理上说得通的短视频,但真实人类动作往往由看不见的感知、信念与欲望驱动。若评测只给“男人打开蓝盒子”这类显式动作指令,模型很容易靠文本动词对齐视觉先验,却未必理解虚假信念或主观目标。
MindWorldBench(arXiv:2609.39147 ,北大 / 北理工 / NTU 等,MM ’26)把任务形式化为心理状态到行为推理:只给初始图像与心理约束,不给目标动作(Zero-Action Prompting),并用反事实配对隔离因果。项目页 https://richard2049-lee.github.io/MindWorldBench/ 。对 11 个模型的评测显示:画面好看,意图对齐仍普遍偏弱,并暴露全知偏置。
英文题目:MindWorldBench: Evaluating Mental-State-to-Behavior Reasoning in Image-to-Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.39147
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有基准大致两类:一类考显式动作执行,一类考客观物理续写。二者都停留在可观察运动学,难以检验模型是否按角色“以为的世界”行动。
心智理论(ToM)在语言与视觉理解里已有虚假信念等任务,但生成侧把潜在心理状态合成为可见行为的评测几乎空白。
因此需要分层心理变量空间、不泄露答案动作的提示协议,以及能区分“做对动作”与“保持世界状态”的诊断指标。
核心创新
- 提出心理状态到行为推理范式,把视频生成从显式指令推进到主观推理。
- Zero-Action Prompting 与反事实设计隔离心理变量因果效应。
- 基于 BDI-P 的分层 taxonomy 覆盖感知、信念与欲望细粒度维度。
- 诊断出 Omniscient Bias:模型常按客观真相而非角色主观信念行动。
方法概览
MindWorldBench 形式化为心理状态到行为推理:给定初始世界状态图像与潜变量集合(感知/信念/欲望),模型须隐式推断意图与动作并生成视频,提示不显式给出目标动作(Zero-Action Prompting)。基准含 744 条专家设计提示,覆盖 3 主维、12 次级、34 细粒度子维,并用反事实配对固定图像、改心理条件。自动评测管线报告视觉质量、常识合理性、意图准确率与世界状态保持;共评 11 个前沿模型。
- 因果上,初始世界状态 Wt 与心理集合 M⊆{P,B,D} 共同决定潜在意图 I 与动作 A,再生成视频 V;评测要求模型隐式完成这条链,而不是读取显式动作文本。
- Taxonomy 依 BDI-P:Perception(环境/规则/社会线索)、Belief(物理/时间/空间/可行性/社会信念)、Desire(即时偏好/工具目标/社会动机/跨时目标),共 3 主维、12 次级、34 细粒度。
- 数据由五位专家先设计认知图,双人复核;视觉锚点来自公开库或 AIGC 并过滤可识别正面人脸;提示由图像与图变量合成且扣留真实意图。最终 744 条提示,配合反事实配对。
- 自动评测用 Gemini 等多步裁判,报告视觉质量、常识合理性、意图准确率(IA)与世界状态保持(WS);另做动作实现、条件正确率与反事实一致性诊断。
逐图理解论文
显式动作的捷径
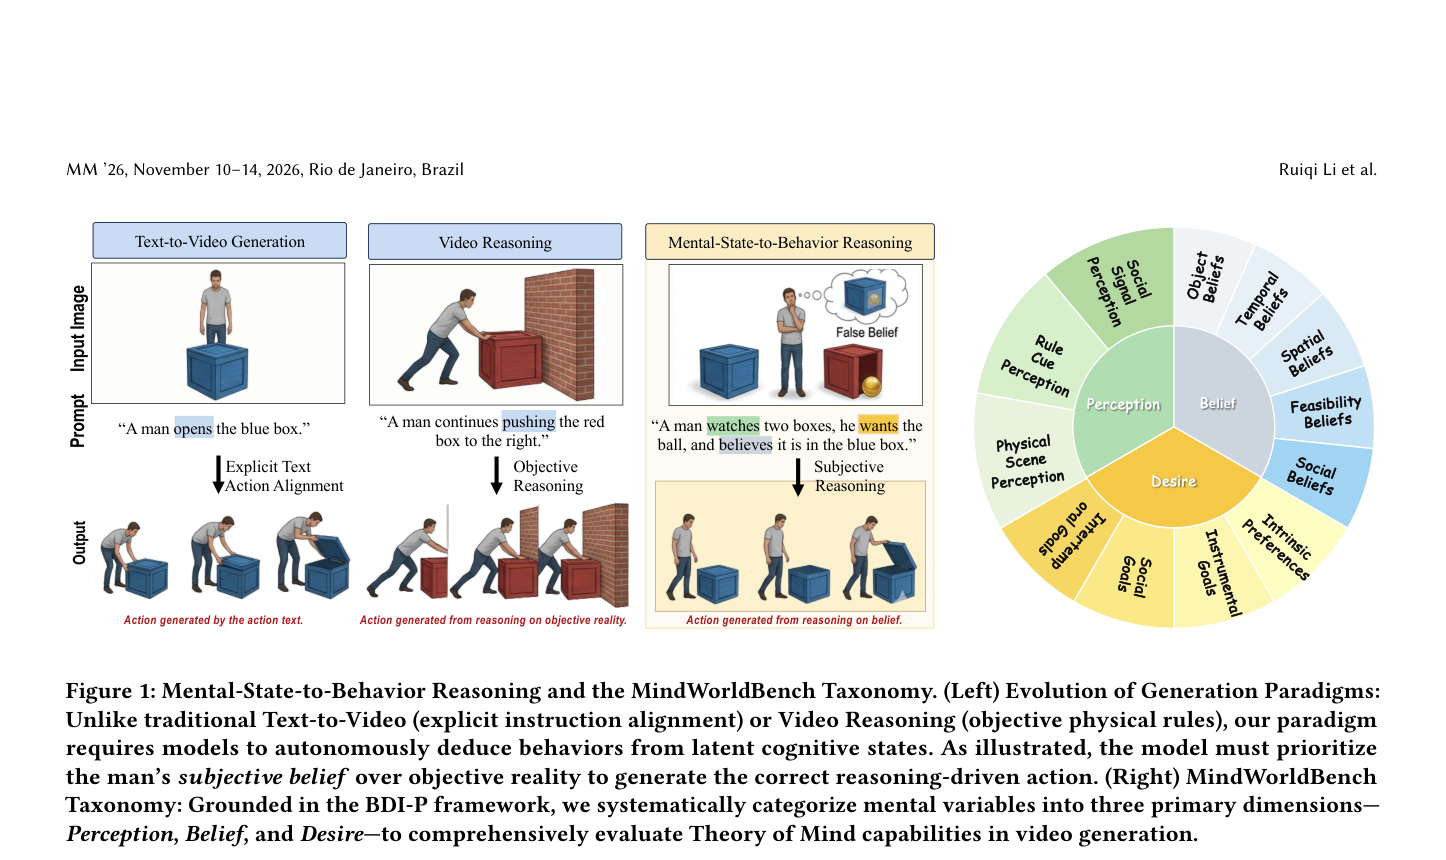
图1左侧对比三种范式:显式文生视频、客观物理推理、以及需要按虚假信念打开空盒子的心理状态到行为推理;右侧太阳图给出 Perception/Belief/Desire taxonomy。宜作特色图。
好看不等于想对
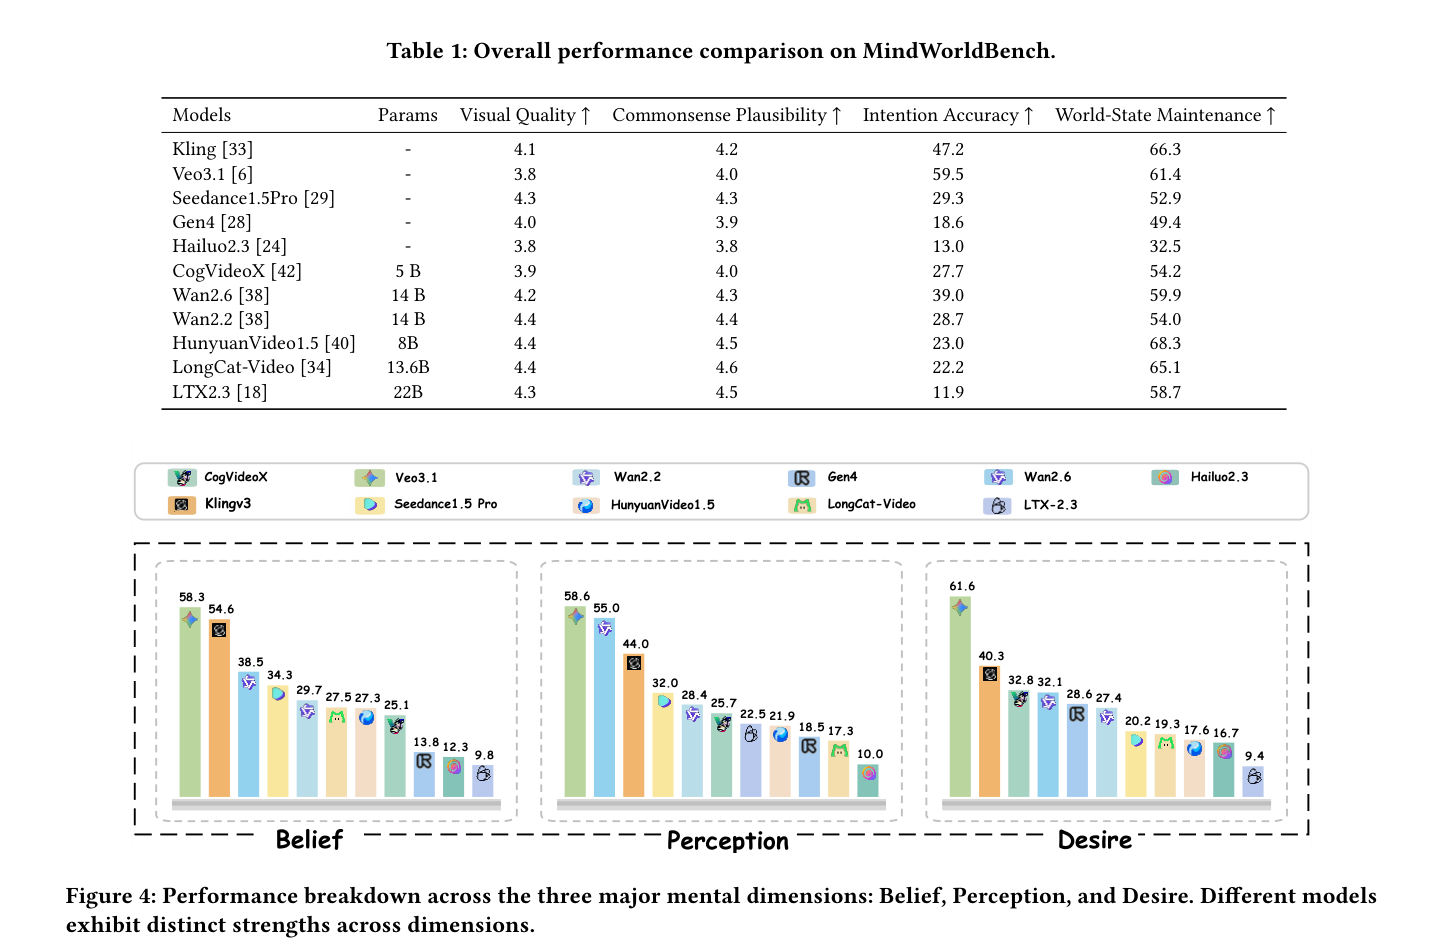
图4(及同页总表)显示各模型在 Belief/Perception/Desire 上的意图准确率柱状对比:Veo3.1 三项领先,其余模型落差大,说明总分会掩盖维度短板。
Figure 2: Causal Graph of Mental-State-to-Behavior Gener- ation
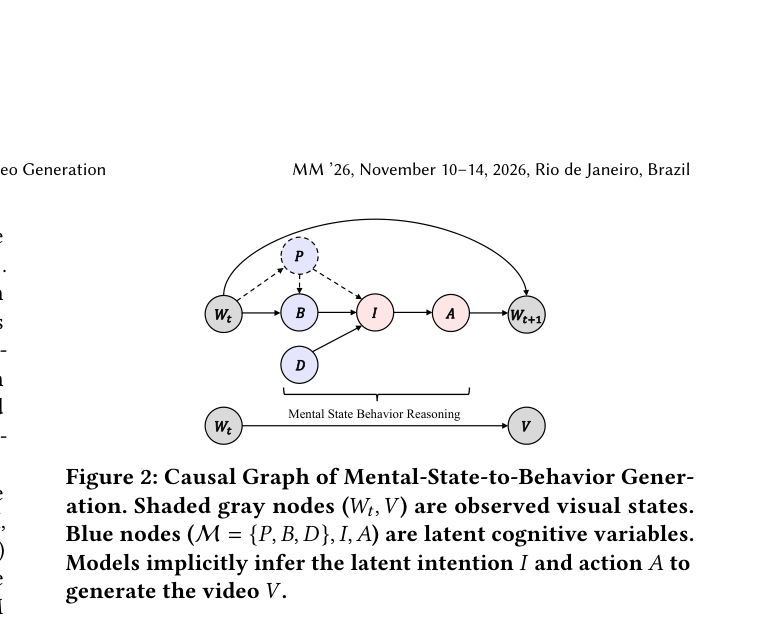
图2给出因果图:灰色为可观察 Wt/V,蓝色为潜变量 P/B/D 与意图 I、动作 A;底部把端到端生成概括为 (Wt,M)→V,强调模型必须隐式推断意图与动作。
实验如何设计?
- 评测模型含 Kling、Veo3.1、Seedance1.5Pro、Gen4、Hailuo2.3、CogVideoX、Wan2.6/2.2、HunyuanVideo1.5、LongCat-Video、LTX2.3 等 11 个系统。
- 主表比较四指标;图4按 Belief/Perception/Desire 拆 IA;图5–6做失败模式与动作完成—条件正确权衡。
- 另在 100 条生成视频上对照 10 位人类专家聚合判断,检查自动管线一致性。
关键结果与论文证据
- Table 1:视觉与常识分数挤在高位(约 3.8–4.6),但 IA 仅 11.9%–59.5%,WS 32.5%–68.3%,说明“好看”远不等于“想对”(页5)。
- Veo3.1 以 59.5% IA 领先,Kling 47.2% 次之;LTX2.3 仅 11.9%。HunyuanVideo1.5 WS 最高 68.3%,但 IA 只有 23.0%,两能力可分离(页5)。
- 图4:Veo3.1 在 Belief/Perception/Desire 分维均为最高(58.3/58.6/61.6),聚合 IA 会掩盖模型在不同心理维上的不均衡(页5)。
- 诊断上,作者总结关键失败模式为 Omniscient Bias:模型常按客观真相行动,而不是角色主观信念;反事实配对中双条件都正确的比例仍有限(页6)。
阅读时需要注意
- 基准诊断能力缺口,本身不提供新的生成训练算法。
- LMM 自动裁判与专家设计覆盖仍有偏置风险。
- 场景与心理图复杂度受数据构建流程约束,难一次覆盖全部社会互动。
关联工作
- VBench 等代表感知与对齐导向的视频生成评测。
- 指令跟随式 I2V 评测容易奖励捷径学习。
- ToM/BDI 与视觉理解 ToM 为本文生成侧评测提供认知框架。