快速导读:CASE 把纵向医疗推理改写成患者环境中的自主取证,用 RSFT 加 agentic RL 训练紧凑视觉语言策略,并在 UK Biobank 基准上超过若干前沿模型。
多数医学基准把证据预先塞进上下文,再考模型会不会答;可纵向临床推理的难点恰恰在于:证据散落在病历、测量与跨随访多序列 MRI 里,智能体必须先决定检查哪些访视、器官、模态和切片,才能下结论。固定上下文问答测不到这种“先取证、再综合”的能力。
CASE(arXiv:2609.39566 ,Durham / 阿里达摩院等)提出角色化 Clinical Agents for Seeking Evidence:共享紧凑视觉语言策略,在患者级工具环境中自主取证,并用 RSFT + agentic RL(OPSD 与量规 RLAIF)在 UK Biobank 纵向基准上训练。请注意:这是研究基准与策略学习,明确不是可部署临床诊断产品。
英文题目:From Given to Gathered Evidence: Agentic Learning for Longitudinal Medical Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2609.39566
原始论文:PDF / 论文页面
这篇论文解决什么问题?
纵向推理要求比较同一患者环境中的不同取证路径:只看报告、只看基线、或跨访视对照,结论可能完全不同。若评测始终给出“正确答案所需的那几张图”,模型可以背答案模式,却学不会调查策略。
相关工作里,静态医学 QA 提供文本或图像;交互式基准引入记录操作与信息收集;多智能体系统则常靠编排固定专科。缺口是把跨访视多模态取证定义成可学习策略,并让紧凑模型在自身交互中超越教师模仿。
因此需要:患者特异环境、可调用专科工具、角色分工,以及不规定工具序列却能强化证据到结论逻辑的训练信号。
核心创新
- 把纵向医疗推理重定义为交互式证据寻求,而不是固定上下文问答。
- 用共享策略+角色提示与工具注册表,实现放射、解剖、会诊三类取证工作流。
- 在自身环境交互上用 OPSD 与量规 RLAIF 超越教师模仿,训练证据到结论综合。
- 构建 UK Biobank 纵向多模态基准,使跨访视取证路径可比较、可学习。
方法概览
CASE 用共享 Qwen3-VL-8B 策略实例化 Anatomist、Radiologist、Consultant 三角色,在患者级工具环境中交替取证与观察。先以 14,734 条前沿模型轨迹做 RSFT 初始化,再在自身轨迹上做 agentic RL:正确性与格式奖励之外,加入特权在线自蒸馏 OPSD 与外部裁判量规 RLAIF,强化证据到结论的综合,而不规定工具序列。基准基于 UK Biobank,含 4,739 名参与者、50,401 道 ICD-10 驱动临床题,并链接基线与随访多序列 MRI。本文为研究基准与策略学习,明确不是可部署临床产品。
- 基准基于 UK Biobank:4,739 名参与者、50,401 道由真实 ICD-10 诊断衍生的临床题;每题绑定含基线与随访多序列 MRI 的患者环境,智能体自行选择访视、器官、模态、切片与工具。
- 训练两阶段。RSFT:从前沿模型交互中筛选约 14,734 条轨迹,蒸馏到 Qwen3-VL-8B-Instruct,快速学会如何当智能体调用工具。Agentic RL:策略在自身环境交互上优化,奖励含正确性与格式,并加入 OPSD(用答案特权视图对整条轨迹重排,强化综合质量)与外部非祖先裁判的量规 RLAIF(洞察有效性)。
- 执行上,同一共享策略通过角色提示与工具注册表实例化为三种工作流:Radiologist 选序列并对比访视影像;Anatomist 用分割测量与叠加评估纵向变化;Consultant 结合 MedGemma 报告、证据核验与技能记忆。通用循环按 P1 计划→P2 基线→P3 变化→P4 洞察→P5 作答推进。
- 特权信息只用于训练期给完成轨迹打分,从不直接规定工具序列,从而让策略学习“找什么”和“如何从找到的证据说话”。
逐图理解论文
给定证据的盲区
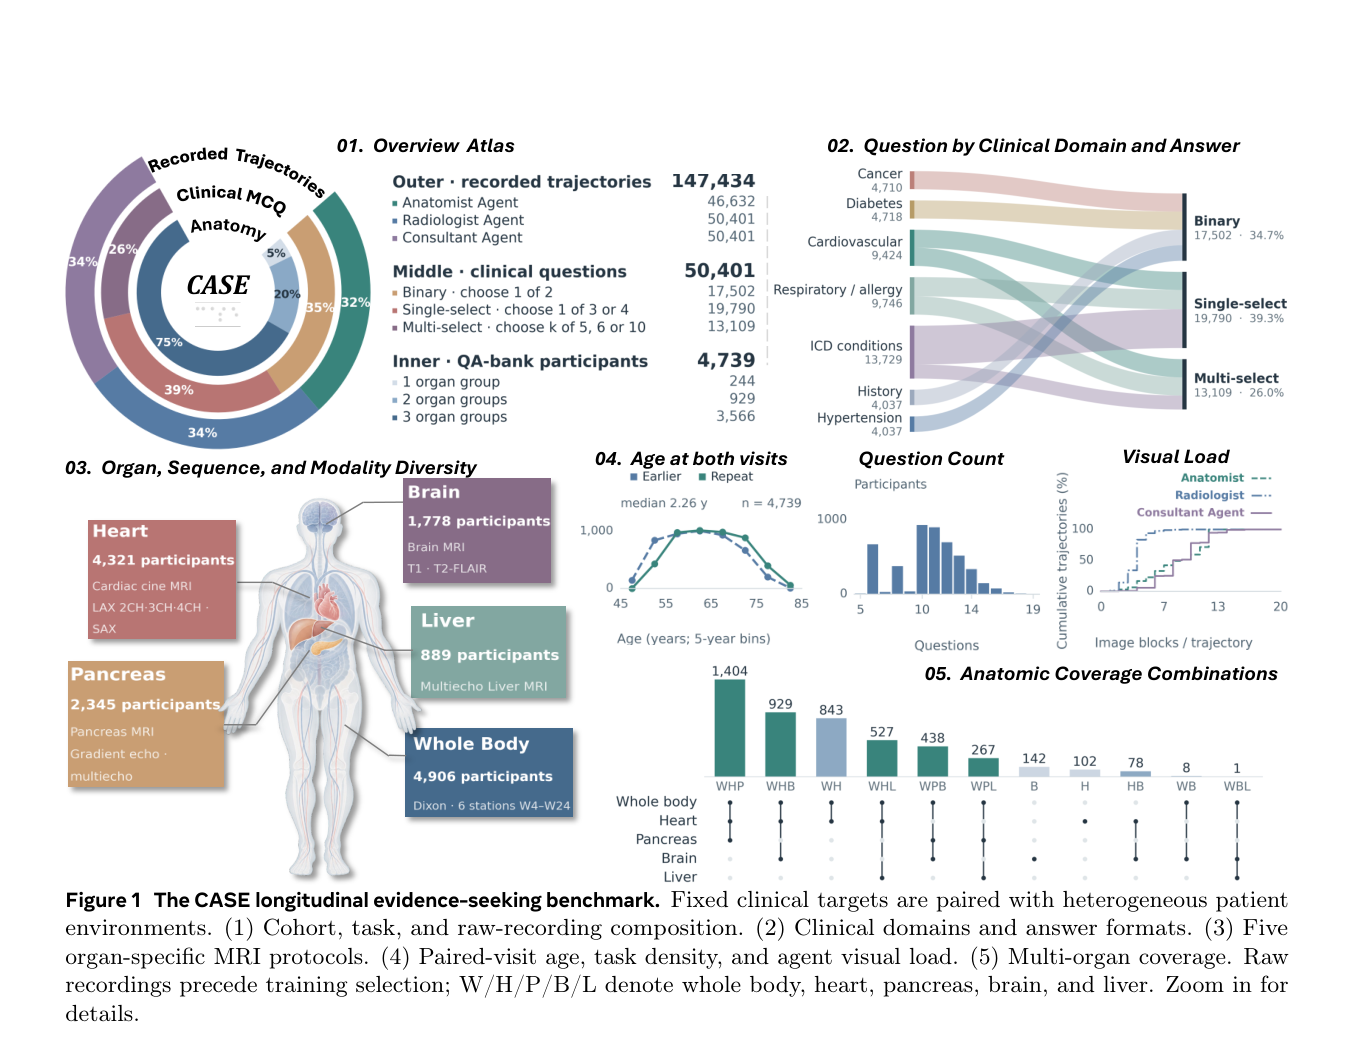
图1是纵向取证基准总览:环形图给出约 4,739 参与者、50,401 题与三角色轨迹规模;Sankey 连接临床域与答题格式;解剖图覆盖脑/心/肝/胰/全身 MRI;并展示双访视年龄间隔(中位约 2.26 年)与器官组合。宜说明评测不是单图问答。
CASE 取证框架
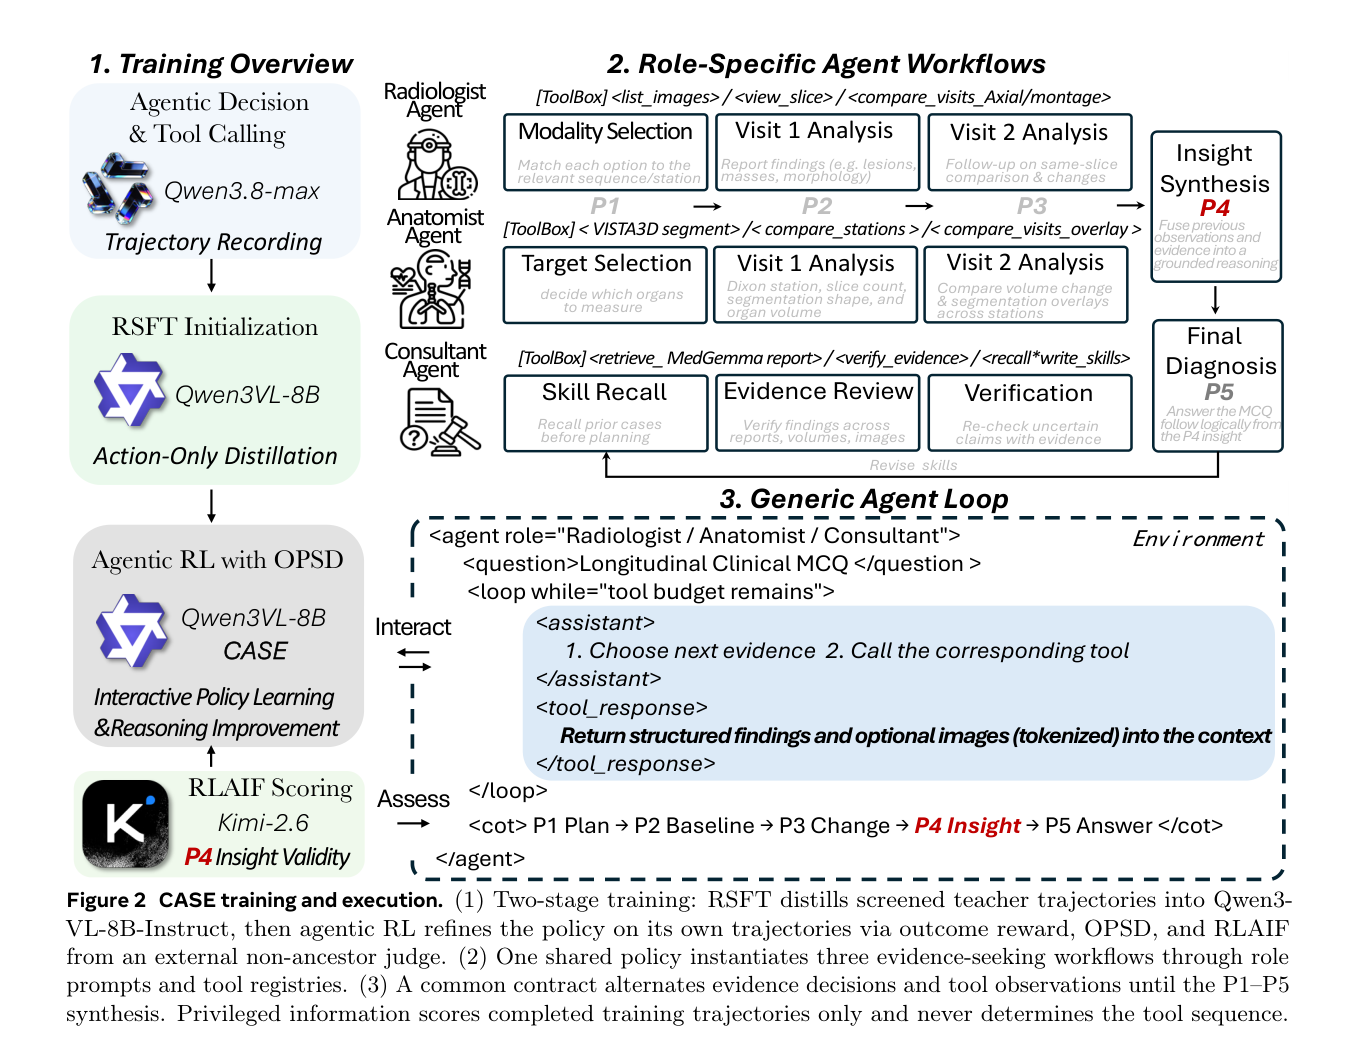
图2是方法与执行主图:左侧 RSFT 再 agentic RL(OPSD+RLAIF);右上三角色工具箱与工作流汇入 P4 洞察与 P5 作答;右下通用取证循环。宜作特色图。
关键证据
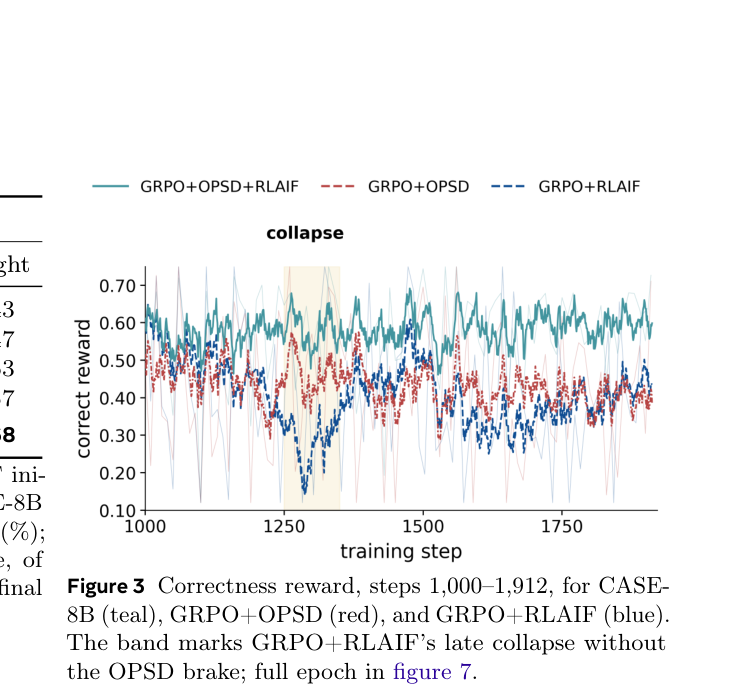
图3对比 CASE-8B、GRPO+OPSD 与 GRPO+RLAIF 在约 1000–1912 步的正确性奖励;高亮带标出无 OPSD 时 RLAIF 后期坍塌,支撑“两信号需一起用”的消融结论。
实验如何设计?
- 主表在癌症、糖尿病、心血管、高血压、ICD 条件与病史等层域上报告三角色平均的 Binary/Single/Multi-select 准确率,以及 Micro/Macro 聚合;对照医学专用模型与 Kimi、Qwen、Gemini、GPT-5.4、Claude Opus 4.8 等。
- 消融从共享 RSFT 初始化出发,比较 GRPO、RLAIF、OPSD 的组合;另用固定外部裁判报告 insight 分,并用训练曲线观察无 OPSD 时的坍塌。
- 补充证据依赖(限制可及证据或去掉 MRI/随访/报告)与交互效率(回合数、截断、无效 JSON),以确认收益来自取证而非更大预算或格式投机。
关键结果与论文证据
- Table 1:CASE-8B Micro 76.1 / Macro 75.1,高于 GPT-5.4(65.3/65.7)与 Claude Opus 4.8(68.6/65.8);摘要称在匹配评测下相对提升分别超过约 16% 与 10%(页9)。
- 相对未训练 Qwen3-VL-8B(46.0/47.1)提升巨大,说明取证策略学习远超“原样 8B 问答”。
- Table 2:RSFT 单独 65.7/65.0,逐步加入 GRPO、RLAIF、OPSD 后到 76.1/75.1,Insight 0.43→0.68,显示两信号互补(页10)。
- 图3:无 OPSD 的 GRPO+RLAIF 在后期 correct reward 明显坍塌,CASE-8B 保持高位,说明 OPSD 充当量规优化的刹车(页10)。
- 定性轨迹中,Consultant 会质疑过度报告并补动脉期/洗脱证据后再拒答错误印象,把聚合增益落到可解释调查行为。
阅读时需要注意
- 部分标签可能无法由可用影像观察到;生成证据与裁判仍会出错。
- 队列外泛化、更广工具集与效率仍待验证。
- 再次强调:本文交付的是研究框架与基准,不是临床产品或诊疗建议系统。
关联工作
- 静态医学 QA 代表“给定证据再答题”的评测范式。
- 交互式临床智能体基准引入信息收集,但少有纵向多序列 MRI 取证策略学习。
- 特权/在线蒸馏与 GRPO 系方法提供训练信号设计背景;CASE 强调轨迹级综合质量重排。