快速导读:MEMORIZON让训练样本覆盖任意长跨度,却只对尾部chunk计分,并用每chunk共视检索的有界记忆库代替把历史全部tokenize。
流式世界模型若要在多次到访时把同一处画成同一处,监督信号就必须同时覆盖第一次看见和后来返回。这类真正的重访在语料里往往跨十几秒到数分钟:作者测得最短真实返回约13.25秒,更严定义会超过28秒。可一旦把整段都拿去算稠密注意力,代价随上下文二次增长,三十秒窗口大约要三倍于十秒的激活内存,而语料里只有约3.8%的三十秒窗口真的含一次返回。
MEMORIZON(arXiv:2610.00544,MBZUAI / IFM)把“样本要覆盖多长”和“Transformer要看多长”拆开:每个训练样本仍可抽任意长度的跨度,但只对末尾k个chunk计分;中间历史并不tokenize,而是让每个计分chunk按相机共视检索自己的top-K潜变量,再把这些请求的并集收成共享记忆库B。库大小被kK封顶,最短跨度时配方退化为常规训练。项目页https://tingtingliao.github.io/memorizon。
英文题目:Memorizon: Training World Models Beyond Their Context Window
论文出处:arXiv 每日论文精选 · arXiv:2610.00544
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有互动世界模型已经能生成一分钟以上的漫游,训练却常被注意力成本卡在十几秒的短clip。若相机离开再回来的时间长于训练clip,没有任何样本同时含两次到访,损失函数也就无法把它们绑在一起。循环状态、压缩摘要、检索库可以在推理时把历史带出窗口,但模型会不会用这段记忆,仍取决于训练样本里到底有没有第一次到访。
直接加长窗口并不解决问题:稀疏注意力和历史压缩能降低每个token的成本,却不改变一对到访能否出现在同一样本里。Context-as-Memory对整段做一次检索,等于让视角不同的chunk读同一组帧;作者证明这会丢掉检索的大部分收益。WorldMem按位姿邻近抽取记忆帧,但主要在Minecraft上训练。还缺两件事:当同一样本里多个计分chunk看向不同地方时,检索该如何组织;以及跨度要多长,检索结果里才会真正含有第一次到访。
因此MEMORIZON把跨度当成按样本抽取的变量,而不是固定clip长度,并用“每chunk自己的top-K + 共享并集库 + 有界注意力掩码”把序列长度与历史长度解耦。
核心创新
- 把监督跨度与注意力长度解耦:样本可任意长,序列由共享检索库封顶,最短跨度等于常规训练。
- 每chunk按相机共视取top-K,并集成库再靠掩码各读各的,避免整段一次检索。
- 库条目共享RoPE索引,使位置不随历史变长,10秒训练也能在推理时读取更老的帧。
方法概览
按样本抽取跨度m,只对最后k个chunk计分;历史不进序列。每个计分chunk按视锥重叠减相对位姿距离检索top-K,并集构成共享库B(≤kK)。注意力为chunk内双向、跨chunk因果,首帧作sink,每块最多注意1+K+(r+1)c个位置;库条目共享RoPE索引。最短跨度退化为常规训练。骨干为Wan2.2-TI2V-5B+PRoPE,diffusion forcing训练后再Self Forcing蒸馏。
- 样本覆盖首帧A与其后m个chunk,m从[mmin, mmax]均匀抽取。末尾k个chunk为计分块T,其前r个为近期块R,更早的η=m−k−r为历史,历史永不进序列。Transformer实际读取[A | B | R | T],槽位数L=1+|B|+rc+kc;|B|不超过k·K。文中取c=4、k=10、r=1、K=6,于是每个计分chunk最多注意1+K+(r+1)c=15个潜变量,与跨度无关。m=k时近期块与历史皆空,恰为常规训练。
- 注意力在chunk内双向、跨chunk因果;Tj只看见自己与前r个chunk组成的滑动窗,首帧A作attention sink。超出窗口后,Tj按式(2)在窗口之前已完成的内容里取自己的top-K:视锥重叠O减去λ倍相对位姿距离D,λ=0.2,平移单位为语料尺度(1单位约4米),转15°大约等价于移动1单位。已在序列里的候选通过掩码就地读取,不占库槽。库是各Tj对历史top-K的并集,前向之前一次形成、全体共享,再靠逐chunk掩码让每块只读自己的条目。RoPE上首帧为0、库条目共享索引1、近期与计分块连续编号,因此位置既不随历史变长,也不在推理时越出训练见过的范围。
- 检索规则用960个计分chunk相对真值可达成增益来打分:重叠单独约47.4%,位姿距离约55.9%(几乎全靠朝向项,仅用相机中心只有19.8%),混合分O−0.2D达到57.2%,与λ=0.1的57.3%在标准误内持平。训练从Wan2.2-TI2V-5B初始化并加PRoPE相机分支,按diffusion forcing做分块因果扩散,6000步、32张H200、每卡一样本。为缓解训练时库与近期块是干净真值、推理时却是自身生成的暴露偏差,作者再用Self Forcing与分布匹配蒸馏把因果模型蒸成四步生成器,共1000步。
逐图理解论文
窗口耦合成因
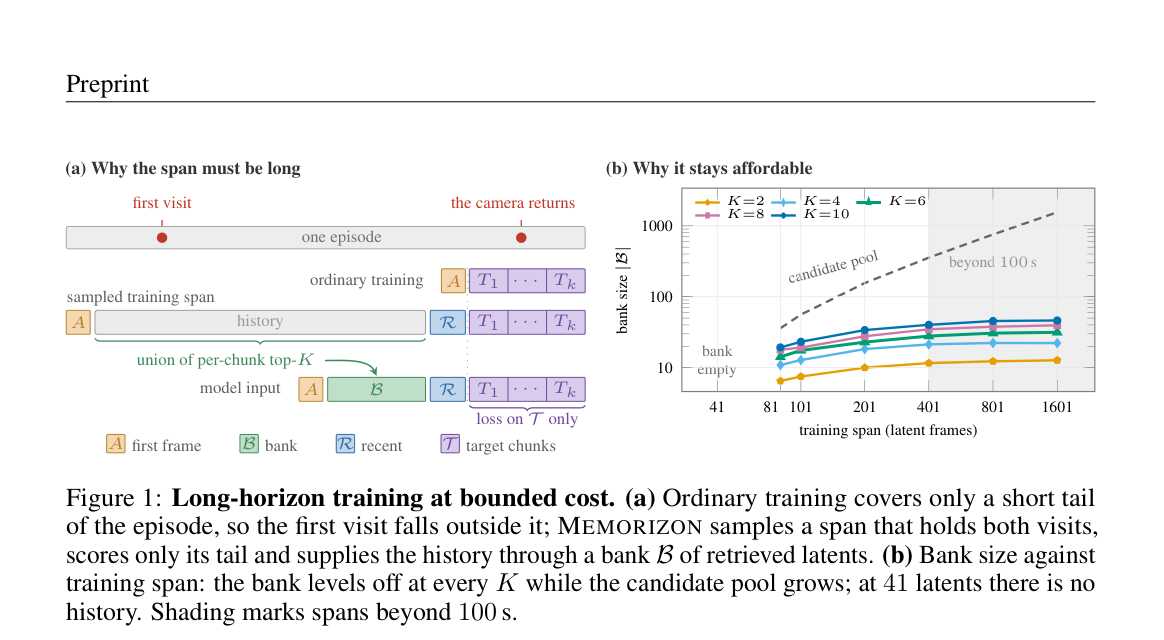
图1是问题与代价总览,宜作特色图。(a)一条episode时间轴上标出首次到访与相机返回;常规训练只覆盖尾部的A与T1…Tk,第一次到访落在窗口外。MEMORIZON抽样能同时含两次到访的跨度,历史不进序列,而由各chunk top-K的并集构成绿色记忆库B,模型输入为A|B|R|T,损失只落在紫色计分块T。(b)对数坐标下候选池随跨度几乎直线上升,各K的|B|在约100秒后趋于平台;41个潜变量处库为空,灰色阴影标出超过100秒的跨度。
有界记忆库
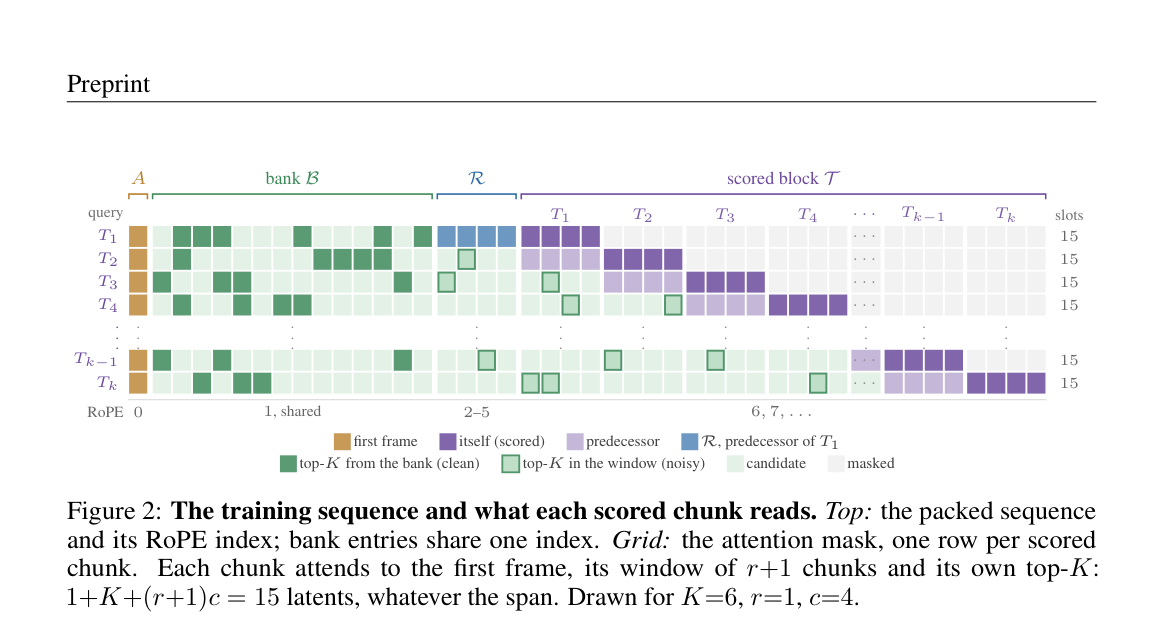
图2给出打包序列与注意力掩码。顶栏从左到右是首帧A、共享库B、近期R与计分块T;RoPE上A为0、库共享索引1、R占2–5、T随后连续编号。网格每一行对应一个计分chunk,深棕为首帧、深绿为该chunk从库中取的干净top-K、蓝/紫为窗口内自身与前驱,浅色为被掩码的候选。在K=6、r=1、c=4时每行固定15个槽,与跨度无关。
关键证据
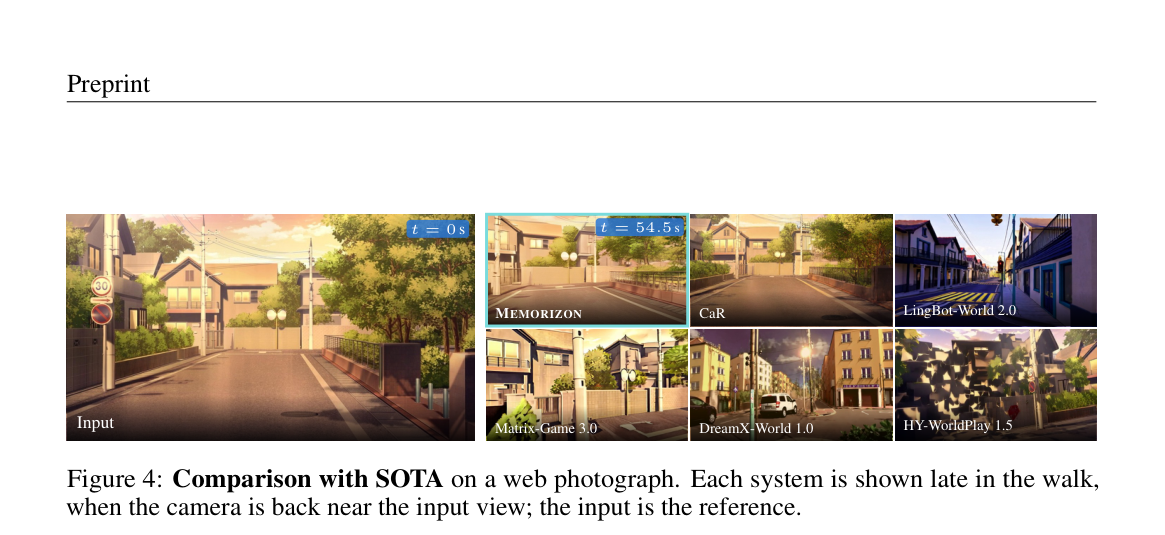
图4在一张黄昏郊区街景网络照片上对比开源世界模型。左侧输入为t=0秒的同一条路;右侧均在约t=54.5秒走回路口附近。青框中的MEMORIZON仍保持原房屋、路灯与暖色天空;CaR布局接近但更冲;LingBot-World 2.0变成两侧蓝楼的另一条街;Matrix-Game 3.0房屋还在但光线与树墙已偏;DreamX-World 1.0变成夜景与白色面包车;HY-WorldPlay 1.5变成挂灯笼的暗巷。用来对照表1的记忆列,而不是VBench邻帧分。
结论与局限
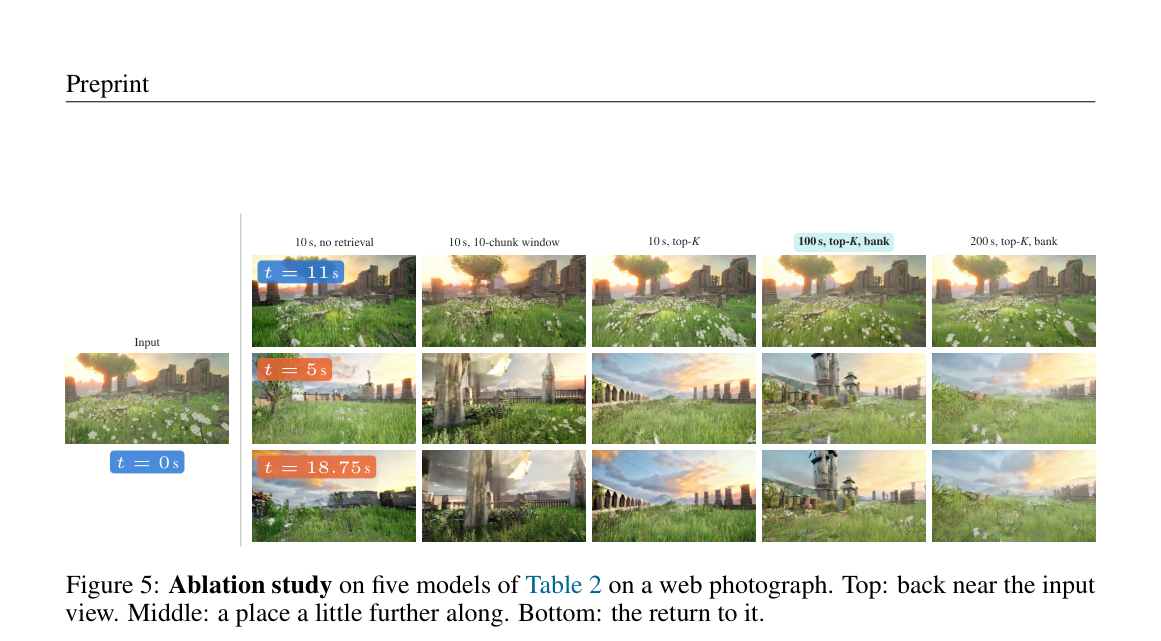
图5把表2的五种配方摆在同一张废墟草原照片上。左列为输入t=0秒;三行分别是回到输入附近(t=11秒)、稍远处(t=5秒)以及对该处的返回(t=18.75秒)。无检索与加宽窗口列在返回时结构与曝光明显漂移;10秒top-K已能保住石砌废墟轮廓;青标的100秒top-K+库与200秒列在三行上都更接近输入的草地与远塔关系,用来支撑“检索先起作用、覆盖首次到访的跨度再加一截”的消融叙事。
实验如何设计?
- 评测对每个模型平均五个rollout种子,20步去噪、CFG=4。集合含训练场景中20条60秒clip、四个留出场景的16条clip,以及20张网络照片;后两路rollout到400秒,主表只报前60秒。两次到访定义为相机在0.5单位与15°内、至少相隔8秒且中间离开过。Revisit是两端生成帧的Pearson相关;Gain再减去同等间隔但相机不同的对照相关;DINO列改用DINO ViT-B/16特征余弦。回到起始位姿的返回可由首帧服务,中途返回才真正需要记忆库。有渲染真值时另报PSNR/LPIPS,并用VBench看邻帧一致性与成像质量。
- 开源对照包括LingBot-World 2.0、DreamX-World 1.0、HY-WorldPlay 1.5、Matrix-Game 3.0、Infinite-World与CaR,均从同一组照片沿同一路径走60秒。消融按行只加一味:10秒无检索、加宽到整段窗口、10秒top-K无库、100秒整段一次检索、100秒有序库、100/200/400秒共享索引的top-K库。
关键结果与论文证据
- 表1在网络照片上,MEMORIZON与CaR是仅有两个呈现明确记忆的系统。MEMORIZON起始位姿Revisit 0.365、Gain 0.230,中途Revisit 0.447、Gain 0.329;CaR对应0.350/0.220与0.450/0.312。其余基线中途Gain最高仅0.089,LingBot起始Gain甚至为−0.006,说明它们在返回处画出的内容几乎不比普通时间间隔帧对更高。图4在t=54.5秒回到输入街景时,MEMORIZON仍保持同一排房屋、路灯与黄昏光线,CaR接近但更冲,其余基线改成夜景、另一条街或灯笼巷(页6–7)。
- 表2显示检索本身已经把记忆抬起来:未见场景上10秒无检索Revisit 0.311、Gain 0.049,加上top-K后到0.503/0.255;网络照片从0.183/0.060到0.359/0.227。把窗口加宽却不检索,在网络照片上反而把Revisit降到0.134。整段一次检索(Context-as-Memory式)在100秒跨度上网络照片Revisit仅0.302,低于共享索引的0.434。跨度加到200秒时未见Revisit 0.623、网络照片0.467,再加到400秒回落到约100秒水平;作者把跨度解释为覆盖设置而非越大越好,100/200/400秒分别覆盖语料中64%/84%/93%返回潜变量的首次到访(页8)。
- 代价也写在表里:VBench成像质量并不领先,HY-WorldPlay主体/背景一致性0.839/0.908高于本文0.778/0.857,多条基线成像列到0.761而本文100秒跑为0.705。附录把质量损失归因于推理时对生成帧(尤其经记忆库)条件化,而不是生成器本身变弱。把库换成另一集的内容会使重访相关下降约83%,随机同历史帧也会让中途Revisit从0.440掉到0.207,空库更低,说明模型确实在读库里的东西。100秒到400秒的步时只增加约12%,K=6时库在100秒约28条、400秒约31.5条,而候选池增大一个数量级(图1b)。
阅读时需要注意
- 评测主要针对静态场景:除相机外几乎没有物体运动,返回处“应看起来一样”才成立;若场景本身在两次到访间改变,一致性必须对照“该变的部分”。
- 图像质量损失来自训练用干净真值填库、推理用自身生成填库的暴露偏差;Sec. 3.4的蒸馏把Self Forcing用到库上,但还没有量化它能收回多少缺口。
- 检索只靠位姿共视,不考虑遮挡和沿光轴运动;超长跨度(400秒)并不继续提高记忆,却改变了模型对库的依赖。
关联工作
- Infinite-World用无位姿层次记忆压缩历史,并在重访密集数据上训练;MEMORIZON则让返回不必再塞进注意力窗口。
- Context-as-Memory按视场重叠为整段检索干净帧;本文改为每chunk自己的top-K并共享并集,避免“一个检索服务所有视角”。
- WorldMem在因果窗口里按位姿邻近插入记忆帧,主要在Minecraft验证;本文在渲染场景与网络照片上比较开源世界模型。CaR压缩历史并经视点编码隐式检索,是表1里唯一能与MEMORIZON比记忆列的系统。